
운영체제(OS) - Disk Management & Scheduling (10)
본 글은 (KOCW) 운영체제, 이화여자대학교 반효경 교수님의 강의를 듣고 내용을 요약 및 정리했습니다. 개인 공부에 목적이 있으며, 자세한 사항은 http://www.kocw.or.kr/home/cview.do?mty=p&kemId=1046323에 참고하시면 됩니다.
Chapter 11.
- Disk Management & Scheduling 1 - 35분
- Disk Management & Scheduling 2 - 9분

이 글은 디스크의 물리적 구조를 출발점으로, 디스크 스케줄링 알고리즘들이 헤드 이동을 어떻게 줄이는지, 그리고 디스크 관리와 스왑 공간, 부트 블록, RAID로 이어지는 저장장치 관리의 흐름을 정리한다. 각 알고리즘은 동일한 요청 큐를 두고 헤드 이동량으로 비교한다.
이 글에서 다루는 것
- 디스크의 논리 블록·섹터와 접근 시간의 구성 요소를 살펴본다.
- FCFS·SCAN·C-SCAN 등 디스크 스케줄링 알고리즘의 동작과 이동량을 비교한다.
- low-level formatting·partitioning·logical formatting·booting으로 이어지는 디스크 관리 과정을 짚는다.
- 스왑 공간 관리와 부트 블록의 역할을 정리한다.
- RAID의 사용 목적과 level 분류를 살펴본다.
Disk Structure
디스크는 외부에서는 1차원 주소 공간으로 보이지만, 물리적으로는 섹터와 실린더로 구성된다 — 이 이중 구조가 이후 스케줄링의 무대가 된다.
- logical block
- 디스크의 외부에서 보는 디스크의 단위 정보 저장 공간들
- 주소를 가진 1차원 배열처럼 취급
- 정보를 전송하는 최소 단위
- Sector
- Logical block이 물리적인 디스크에 매핑된 위치
- Sector 0은 최외곽 실린더의 첫 트랙에 있는 첫 번째 섹터이다.
Disk Scheduling
디스크 스케줄링의 목표는 seek time 최소화다 — 그 기준으로 알고리즘들을 비교하기 위해, 먼저 접근 시간이 무엇으로 구성되는지 뜯어본다.

- Access time의 구성
- Seek time : 장치 arm이 헤드(head)를 움직이는 데, 특정 실린더(cylinder)의 특정 섹터(sector)로 움직이는 데 걸리는 시간
- Seek time = seek distance
- Rotational latency : 헤드가 원하는 섹터에 도달하기까지 걸리는 회전지연시간
- Transfer time : 실제 데이터의 전송 시간
- Seek time : 장치 arm이 헤드(head)를 움직이는 데, 특정 실린더(cylinder)의 특정 섹터(sector)로 움직이는 데 걸리는 시간
- Disk bandwidth : 단위 시간 당 전송된 바이트의 수
- Disk Scheduling : seek time을 최소화하고, 데이터 전송의 대역폭(bandwidth)을 최대화하는 것이 목표
결국 헤드를 얼마나 덜 움직이느냐의 싸움이다.
접근 시간의 구성 요소를 알았으니, 다음은 디스크를 실제로 어떻게 포맷하고 나누는지다.
Disk Management
디스크를 사용 가능한 저장장치로 만드는 과정은 물리 포맷에서 부팅까지 이어진다.
- physical formatting (Low-level formatting)
- 디스크를 컨트롤러가 읽고 쓸 수 있도록 섹터들로 나누는 과정
- 각 섹터는 header + 실제 data(보통 512 bytes) + trailer로 구성
- header와 trailer는 sector number, ECC (Error-Correcting Code) 등의 정보가 저장되며 controller가 직접 접근 및 운영
- Partitioning
- 디스크를 하나 이상의 실린더 그룹으로 나누는 과정
- OS는 이것을 독립적 disk로 취급 (logical disk)
- Logical formatting
- 파일시스템을 만드는 것
- FAT, inode, free space 등의 구조 포함
- Booting
- ROM에 있는 “small bootstrap loader”의 실행
- sector 0 (boot block)을 load하여 실행
- sector 0은 “full Bootstrap loader program”
- OS를 디스크에서 load하여 실행
Disk Scheduling Algorithm
같은 요청 큐를 놓고, 각 알고리즘이 헤드를 어떤 순서로 움직여 요청을 처리하는지 비교한다.
- 큐에 다음과 같은 실린더 위치의 요청이 존재하는 경우 디스크 헤드 53번에서 시작한 각 알고리즘의 수행 결과는? (실린더 위치는 0-199)
- 다시 말해, 큐에 읽는 순서가 있다면, 실린더를 찾기 위해 헤드를 몇 번이나 움직이는가?
- 큐(queue) : 98, 183, 37, 122, 14, 124, 65, 67
FCFS (First Come First Service)

- 큐(queue) : 98, 183, 37, 122, 14, 124, 65, 67
- 헤드의 총 이동은 640 실린더이다.
- (98-53)+(183-98)+(183-37)+(122-37)+(122-14)+(124-14)+(124-65)+(67-65) = 640
정리하면, FCFS는 요청이 도착한 순서를 그대로 따르므로, 큐의 순서가 나쁘면 헤드가 불필요하게 왕복한다.
SCAN
- disk arm이 디스크의 한쪽 끝에서 다른 쪽 끝으로 이동하며 가는 길목에 있는 모든 요청을 처리한다.
- 다른 한쪽 끝에 도달하면 역방향으로 이동하며 오는 길목에 있는 모든 요청을 처리하며 다시 반대쪽 끝으로 이동한다.
- Cons
- 실린더 위치에 따라 대기 시간이 다르다.

- 헤드가 만약 0으로 움직인다면, 그림은 위와 같다.
주의: 헤드의 총 이동 거리는 어느 방향으로 먼저 움직이는지에 따라 달라진다.
- 큐(queue) : 98, 183, 37, 122, 14, 124, 65, 67
- 헤드의 총 이동은 236 실린더이다.
- (53-37)+(37-14)+(14-0)+(65-0)+(67-65)+(98-67)+(122-98)+(124-122)+(183-124) = 236
C-SCAN (Circular-SCAN)
- 헤드가 한쪽 끝에서 다른 쪽 끝으로 이동하며 가는 길목에 있는 모든 요청을 처리한다.
- 다른 쪽 끝에 도달했으면 요청(서비스)을 처리하지 않고 곧바로 출발점으로 다시 이동한다.
- SCAN보다 균일한 대기 시간을 제공한다.

- 큐(queue) : 98, 183, 37, 122, 14, 124, 65, 67
- 헤드의 총 이동은 183 실린더이다. (끝은 199이다.)
- (65-53)+(67-65)+(98-67)+(122-98)+(124-122)+(183-124)+(199-183)+(14-0)+(37-14) = 183
정리하면, C-SCAN은 끝에 도달하면 요청을 처리하지 않고 출발점으로 돌아오기 때문에, SCAN보다 균일한 대기 시간을 제공한다.
Other Algorithms
- N-SCAN
- SCAN의 변형 알고리즘
- 일단 arm이 한 방향으로 움직이기 시작하면 그 시점 이후에 도착한 job은 되돌아올 때 service
- LOOK and C-LOOK
- SCAN이나 C-SCAN은 헤드가 디스크 끝에서 끝으로 이동
- LOOK과 C-LOOK은 헤드가 진행 중이다가 그 방향에 더 이상 기다리는 요청이 없으면 헤드의 이동방향을 즉시 반대로 이동한다.
차이는 되돌아올 때 드러난다.
알고리즘의 동작을 봤으니, 이제 어떤 것을 선택할지가 남는다.
Disk-Scheduling Algorithm의 결정
디스크 입출력이 많은 시스템에서 어떤 알고리즘이 효율적인지, 그리고 무엇이 선택에 영향을 주는지 정리한다.
- SCAN, C-SCAN 및 그 응용 알고리즘은 LOOK, C-LOOK 등이 일반적으로 디스크 입출력이 많은 시스템에서 효율적인 것으로 알려져 있음
- File의 할당 방법에 따라 디스크 요청이 영향을 받음
- 디스크 스케줄링 알고리즘은 필요할 경우 다른 알고리즘으로 쉽게 교체할 수 있도록 OS와 별도의 모듈로 작성되는 것이 바람직하다.
Swap-Space Management
Swap space는 메모리가 부족할 때 디스크를 메모리의 연장으로 쓰는 공간이다 — 일반 파일시스템과 무엇이 다른지가 핵심이다.
- Disk를 사용하는 이유
- memory의 volatile한 특성 -> file system
- 프로그램 실행을 위한 memory 공간 부족 -> swap space (swap area)
- Swap-space
- Virtual memory system에서는 디스크를 memory의 연장 공간으로 사용
- 파일시스템 내부에 둘 수도 있으나 별도 partition 사용이 일반적
- 공간효율성보다는 속도 효율성이 우선
- 일반 파일보다 짧은 시간만 존재하고 자주 참조됨
- 따라서, block의 크기 및 저장 방식이 일반 파일시스템과 다름

Boot Block
컴퓨터 전원을 켰을 때 실행할 초기 프로그램을 어디에 두고 어떻게 불러오는지, 그 최소한의 뼈대를 다룬다.
- 컴퓨터를 실행하기 위한 것으로, 전원을 키면 실행할 초기 프로그램을 반드시 가진다.
- bootstrap loader는 NVM 플래시 메모리에 저장되고, 잘 알려진 메모리 위치에 매핑된다.

RAID
여러 디스크를 묶어 속도와 신뢰성이라는 두 목표를 동시에 노리는 방식이 RAID다 — 그 목적과 level 분류를 살펴본다.
- RAID (Redundant Array of Independent Disks)
- 여러 개의 디스크를 묶어서 사용한다.
- RAID의 사용 목적
- 디스크 처리 속도 향상을 위해서다.
- 여러 디스크에 블록의 내용을 분산 저장하는데,
- 병렬적(parallel)으로 읽어 온다.(interleaving(중간에 끼워넣는), striping)
- bit level striping : 각 바이트의 비트를 분할한다.
- block level striping : 드라이버 수에 대한 일반화
- 신뢰성 (reliability) 향상을 위해서다.
- 동일 정보를 여러 디스크에 중복 저장
- 하나의 디스크가 고장(failure) 시 다른 디스크에서 읽어옴 (Mirroring, shadowing)
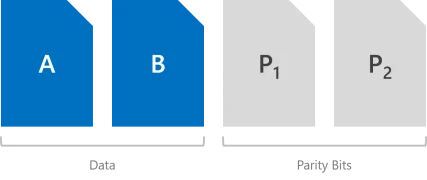
- 단순한 중복(redundancy) 저장이 아니라 일부 디스크에 parity를 저장하여 공간의 효율성을 높일 수 있다.
- 디스크 처리 속도 향상을 위해서다.
출처: Fault tolerance and storage efficiency on Azure Local and Windows Server clusters (Microsoft Learn) (https://learn.microsoft.com/en-us/windows-server/storage/storage-spaces/fault-tolerance), CC BY 4.0

- RAID level : 비용과 성능의 trade-off에 따른 스키마들을 분류


핵심 정리
- seek time이 스케줄링의 핵심 변수다. 디스크 스케줄링은 seek time을 최소화하고 대역폭을 최대화하는 것을 목표로 한다.
- 알고리즘마다 헤드 이동 경로가 다르다. 같은 요청 큐에서도 FCFS는 도착 순서를, SCAN·C-SCAN은 끝에서 끝으로의 이동을 따른다.
- C-SCAN은 대기 시간을 균일하게 만든다. 다른 쪽 끝에 도달하면 요청을 처리하지 않고 곧바로 출발점으로 돌아온다.
- 디스크는 물리 포맷·파티셔닝·논리 포맷·부팅의 순서로 준비된다. 그 시작점에는 boot block과 bootstrap loader가 있다.
- RAID는 속도와 신뢰성을 함께 노린다. striping으로 병렬성을, mirroring·parity로 중복성을 확보한다.
댓글남기기