
운영체제(OS) - CPU Scheduling (4)
본 글은 (KOCW) 운영체제, 이화여자대학교 반효경 교수님의 강의를 듣고 내용을 요약 및 정리했습니다. 개인 공부에 목적이 있으며, 자세한 사항은 http://www.kocw.or.kr/home/cview.do?mty=p&kemId=1046323에 참고하시면 됩니다.
Chapter 5.
- CPU Scheduling 1 - 1시간 5분
- CPU Scheduling 2 / Process Synchronization 1 - 1시간 7분
(+) 인프런의 주니온 박사님의 운영체제 공룡책 강의를 듣고 내용을 보충했습니다. 자세한 사항은 여기를 참고하시면 됩니다.
CPU 스케줄링은 ready 상태의 프로세스 중 이번에 CPU를 줄 프로세스를 고르는 작업이다. 이 글은 CPU와 I/O 버스트의 개념, 스케줄링 성능 척도, FCFS·SJF·Priority·Round Robin·Multilevel Queue 등 주요 스케줄링 알고리즘과 Algorithm Evaluation을 정리한다.
이 글에서 다루는 것
- CPU 버스트와 I/O 버스트로 프로그램 실행 구조를 이해한다
- 스케줄링 성능 척도(이용률·처리량·소요·대기·응답 시간)를 구분한다
- FCFS·SJF·Priority·Round Robin·Multilevel Queue 알고리즘을 비교한다
- 다중 프로세서·실시간·스레드 스케줄링의 쟁점을 살펴본다
- Algorithm Evaluation으로 성능을 평가하는 방법을 정리한다


CPU and I/O Bursts in Program Execution
프로세스는 CPU를 쓰는 구간과 I/O를 기다리는 구간을 번갈아 오간다. 이 글의 출발점은 그 버스트 구조를 이해하는 것이다.

- CPU와 I/O가 번갈아가면서 실행한다.
- 프로그램은 CPU burst와 I/O burst의 연속이다. 하지만, 프로그램의 종류에 따라 각 버스트들의 빈도 및 길이가 다르다.
- 여러 종류의 job(=process)이 섞여 있기 때문에 CPU 스케줄링이 필요하다.
CPU-burst Time의 분포
프로그램 종류마다 CPU 버스트 길이의 분포가 다르고, 그 분포가 스케줄링 정책의 근거가 된다.

- 여러 종류의 job(=process)이 섞여 있기 때문에 CPU 스케줄링이 필요하다.
- Interactive job에게 적절한 response 제공 요망
- CPU와 I/O 장치 등 시스템 자원을 골고루 효율적으로 사용
프로세스의 특성 분류
버스트 분포는 결국 프로세스가 I/O 위주인지 CPU 위주인지에서 갈린다.
- 프로세스는 그 특성에 따라 다음 두 가지로 나눔
- I/O-bound process
- CPU를 잡고 계산하는 시간보다 I/O에 많은 시간이 필요한 job
- (many short CPU bursts)
- CPU-bound process
- 계산 위주의 job
- (few very long CPU bursts)
- I/O-bound process
결국 스케줄링은 이 둘을 함께 달래는 일이다.
CPU Scheduler & Dispatcher
스케줄링은 ‘누구를 고를 것인가’와 ‘고른 프로세스로 어떻게 넘길 것인가’의 두 단계로 나뉜다.
- 시스템은 프로세스 이용률을 극대화하고 사용자는 편리하고 융통성있길 원한다.
- CPU Scheduler : Ready 상태의 프로세스 중에서 이번에 CPU를 줄 프로세스를 고른다.
- 스케줄러는 많은 요소를 고려하여 스케줄링을 수행한다.
- performance, throughput, priority, fairness, realtime-ness, workload adaptation

- 스케줄러는 많은 요소를 고려하여 스케줄링을 수행한다.
- Dispatcher : CPU의 제어권을 CPU scheduler에 의해 선택된 프로세스에게 넘긴다. (위 그림 참조) 이 과정을 context switch (문맥 교환)라고 한다.
- 실행 중인 프로세스를 전환하려면 시스템이 현재 프로세스의 상태(state)를 저장하고 다음 프로세스의 상태를 로드해야 한다.
- context switch는 오버헤드(overhead)이다.
- CPU 스케줄링이 필요한 경우는 프로세스에게 다음과 같은 상태 변화가 있는 경우이다.
- Running -> Blocked (ex. I/O 요청하는 시스템 콜)
- Running -> Ready (ex. 할당시간만료로 timer interrupt)
- Blocked -> Ready (ex. I/O 완료후 인터럽트)
- Terminate
- 1,4에서의 스케줄링은 nonpreemptive (비선점형) (=강제로 빼앗지 않고 자진 반납)
- All other scheduling is preemptive (선점형) (=강제로 빼앗아 context switch를 시행한다.)
주의: nonpreemptive와 preemptive의 차이는 ‘CPU를 누가 회수하느냐’다. 프로세스가 자진 반납하면 전자, 강제로 빼앗으면 후자다.
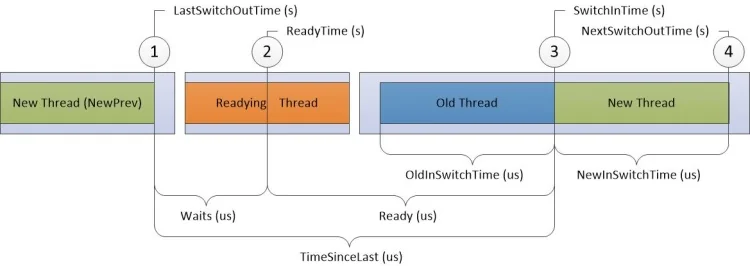
출처: CPU Analysis - Windows Performance Toolkit (Microsoft Learn) (https://learn.microsoft.com/en-us/windows-hardware/test/wpt/cpu-analysis), Microsoft Learn 문서 라이선스(CC BY 4.0) 1
이 타임라인에서 Ready 구간은 새 스레드가 ready queue에서 기다린 시간, Waits 구간은 이전 스레드가 CPU를 놓기 전까지 기다린 시간에 대응한다. 다음 절의 대기·응답 시간 척도가 실제 실행 기록에서 어디에 나타나는지 보여준다.
Scheduling Criteria (성능 척도)
좋은 스케줄링인지 판단하려면 기준이 필요하다 — 여기서는 다섯 가지 척도를 쓴다.
- CPU utilization (이용률) : 전체 시간 중 CPU가 놀지 않고 일한 비율
- Throughput (처리량) : 주어진 시간동안 과연 몇 개의 작업을 처리했느냐
- Turnaround time (소요시간, 반환시간) : [고객 입장] CPU를 얻어서 쓰고 나갈 때까지의 시간
- Waiting time (대기 시간) : [고객 입장] CPU를 쓰기 위해 기다린 시간
- Response time (응답 시간) : [고객 입장] : 처음으로 CPU를 얻기까지의 시간
이 다섯 척도가 기준이라면, 다음 질문은 그 순서를 어떻게 정할 것인가다. 이제 실제 알고리즘으로 넘어간다.
Scheduling Algorithms
지금부터는 실제 알고리즘이다. 각 알고리즘이 위 척도에서 어떤 강점과 약점을 갖는지 비교한다.
FCFS (First-Come First-Served)
- 먼저 온 순서대로 처리한다.
- 스케줄 순서를
Gantt Chart로 나타내면 다음과 같다. - FCFS는 앞에 어떤 프로세스가 버티냐에 따라서 기다리는 시간에 많은 영향을 끼친다.
- FCFS 알고리즘은 non-preemptive(비선점형)이다.
- Convoy effect : 긴 프로세스 앞에 놓인 짧은 프로세스가 있을 때
- 다른 모든 프로세스는 하나의 큰 프로세스가 CPU에서 벗어날 때까지 기다린다.
주의: FCFS는 비선점형이라 실행 중인 프로세스가 자진 반납할 때까지 CPU를 빼앗지 않는다.

- Waiting time for $P_1$ = 0; $P_2$ = 24; $P_3$ = 27
- Average waiting time : (0 + 24 + 27)/3 = 17
정리하면, FCFS의 대기 시간은 앞선 프로세스의 버스트 길이에 그대로 좌우된다.
SJF (Shortest-Job-First)
- 각 프로세스의 다음번 CPU burst time을 가지고 스케줄링에 활용한다.
- CPU burst time이 가장 짧은 프로세스를 제일 먼저 스케줄
- Two schemes:
- Nonpreemptive : 일단 CPU를 잡으면 이번 CPU burst가 완료될 때까지 CPU를 선점(preemption)당하지 않음
- Preemptive : 현재 수행중인 프로세스의 남은 burst time보다 더 짧은 CPU burst time을 가지는 새로운 프로세스가 도착하면 CPU를 빼앗김
- 이 방법을 Shortest-Remaining-Time-First (
SRTF)이라고도 부른다.
- 이 방법을 Shortest-Remaining-Time-First (
- SJF is optimal
- 주어진 프로세스들에 대해
minimum average waiting time을 보장한다.3
- 주어진 프로세스들에 대해
평균 대기 시간을 최소로 만드는 건 SJF뿐이다.

- Waiting Time for $P_1$=3, $P_2$=16, $P_3$=9, $P_4$=0
- Average Waiting Time: (3+16+9+0)/4=7
- 다만 SJF의 최적성에는 전제가 붙는다. 다음 CPU 버스트 길이를 미리 알아야 하는데, 실제로는 정확히 알 수 없어 과거 버스트의 지수 평균(exponential averaging)으로 예측해 스케줄링에 쓴다.
- 예측이 실제 버스트와 어긋나면 평균 대기 시간이 최소라는 보장도 깨진다.
- 선점형 SRTF는 새 프로세스가 도착할 때마다 남은 burst time을 비교하므로, nonpreemptive 방식보다 구현·계산 부담이 크다.
정리하면, 버스트가 짧은 작업을 앞세울수록 평균 대기 시간이 줄어들지만, 그 순서를 정하려면 버스트 길이를 예측해야 한다는 부담이 따른다.
Priority Scheduling (우선순위 스케줄링)
- 각 job은 우선순위(priority)가 있다.
- 우선순위 스케줄링이라고 하는데, highest priority를 가진 프로세스에게 CPU 할당한다.
- smallest integer = highest priority
SJF는 일종의 priority scheduling이다.priority= predicted next CPU burst time
- 문제점 : (Starvation) 낮은 우선순위 프로세스는 절대로 실행되지 않는다.
- 해결 : (Aging) 오래 기다리면 우선순위를 높여준다.
Round Robin (RR)
- 각 프로세스는 동일한 크기의 할당 시간(time quantum)을 가진다.
- time quantum : 일반적으로 10-100 milliseconds4
- 할당 시간이 지나면 프로세스는 선점당하고 ready queue의 제일 뒤에 가서 다시 줄을 선다.
- n개의 프로세스가 ready queue에 있고 할당 시간이 q time unit인 경우 각 프로세스는 최대 q time unit 단위로 CPU 시간의 1/n을 얻는다.
- 어떤 프로세스도 (n-1)q time unit 이상 기다리지 않는다.
- Performance
- q large -> FCFS
- q small -> context switch 오버헤드가 커진다.
- RR 스케줄링 알고리즘은 preemptive이다.
- 프로세스의 CPU 버스트가 1회 퀀텀을 초과하면 해당 프로세스가 우선 처리되고 다시 준비 대기열에 들어간다.

- Waiting Time for $P_1$=10−4=6, $P_2$=4, $P_3$=7
- Average Waiting Time: (6+4+7)/3=5.66
Multilevel Queue

- Ready queue를 여러 개로 분할
- foreground (interactive)
- background (batch - no human interaction)
- 각 큐는 독립적인 스케줄링 알고리즘을 가진다.
- foreground - RR
- background - FCFS
- 큐에 대한 스케줄링이 필요
- Fixed priority scheduling
- serve all from foreground then from background
- Possibility of starvation
- Time slice
- 각 큐에 CPU time을 적절한 비율로 할당
- ex. 80% to foreground in RR, 20% to background in FCFS
- Fixed priority scheduling
Multilevel Feedback Queue

- 프로세스가 다른 큐로 이동 가능
- 에이징(aging)을 이와 같은 방식으로 구현할 수 있다.
- Multilevel-feedback-queue scheduler를 정의하는 파라미터들
- Queue의 수
- 각 큐의 scheduling algorithm
- Process를 상위 큐로 보내는 기준
- Process를 하위 큐로 내쫓는 기준
- 프로세스가 CPU 서비스를 받으려 할 때 들어갈 큐를 결정하는 기준
결국 큐 사이를 오갈 수 있느냐가 유연함의 차이다.
Multiple-Processor Scheduling
- CPU가 여러 개인 경우 스케줄링은 더욱 복잡해진다.
- load balancing은 워크로드를 균등하게 분산하려는 시도이다.
- Homogeneous processor인 경우
- Queue에 한줄로 세워서 각 프로세서가 알아서 꺼내가게 할 수 있다.
- 반드시 특정 프로세서에서 수행되어야 하는 프로세스가 있는 경우에는 문제가 더 복잡해진다.
- Load sharing
- 일부 프로세서에 job이 몰리지 않도록 부하를 적절히 공유하는 메커니즘 필요하다.
- 별개의 큐를 두는 방법 vs. 공동 큐를 사용하는 방법
- Symmetric Multiprocessing (SMP)
- 각 프로세서가 각자 알아서 스케줄링(self-scheduling) 결정
- 각 peer CPU 프로세서가 모든 일을 처리

- Asymmetric multiprocessing
- 하나의 프로세서(=master node)가 시스템 데이터의 접근과 공유를 책임지고 나머지 프로세서는 거기에 따른다.
- 각 프로세서는 특정한 작업에 할당한다.
지금까지는 일반 프로세스의 스케줄링이었다. 마감 시간이 걸린 작업은 다른 기준이 필요하다.
Real-Time Scheduling
- Hard real-time systems : Hard real-time task는 정해진 시간 안에 반드시 끝내도록 스케줄링해야 한다.
- Soft real-time computing : Soft real-time task는 일반 프로세스에 비해 높은 우선순위를 갖도록 해야 한다.
Thread Scheduling
Local Scheduling: User level thread의 경우 사용자 수준의 thread library에 의해 어떤 thread를 스케줄할지 결정Global Scheduling: Kernel level thread의 경우 일반 프로세스와 마찬가지로 커널의 단기 스케줄러가 어떤 thread를 스케줄할지 결정
Algorithm Evaluation
알고리즘을 만들었다면 이제 성능을 평가할 차례다. 평가 방식은 크게 세 가지로 나뉜다.
Queueing models: 확률 분포로 주어지는 arrival rate와 service rate 등을 통해 각종 performance index 값을 계산Implementation (구현) & Measurement (성능 측정): 실제 시스템에 알고리즘을 구현하여 실제 작업(workload)에 대해서 성능을 측정 비교Simulation (모의 실험): 알고리즘을 모의 프로그램을 작성 후 trace를 입력으로 하여 결과 비교
정리하면, Queueing model·구현/측정·시뮬레이션은 각각 수식·실측·모의 실험으로 성능을 비교한다는 점에서 갈린다.
핵심 정리
- 프로그램은 버스트의 연속. CPU 작업과 I/O 작업이 번갈아 나타나고, 그 분포가 스케줄링 필요성을 만든다.
- 성능 척도의 중심은 대기 시간. 이용률·처리량과 함께 소요·대기·응답 시간을 고객 입장에서 본다.
- SJF가 평균 대기 시간의 최적. FCFS는 앞선 버스트에, Round Robin은 할당 시간 q에 성능이 좌우된다.
- 우선순위와 큐의 유연성. Priority는 starvation을, Multilevel Queue는 큐 간 이동 제약을 각각 Aging과 피드백 큐로 다룬다.
- 평가는 세 갈래. Queueing model·구현/측정·시뮬레이션으로 성능을 비교한다.
References
-
CPU Analysis - Windows Performance Toolkit (Microsoft Learn) ↩
-
https://dev.to/nagasaisriya/operating-systems-scheduling-algorithms-made-easy-fcfs-51nm ↩
-
Operating System Concepts, 10th Edition (Silberschatz, Galvin, Gagne) 공식 컴패니언 사이트 ↩
-
(KOCW) 운영체제 - 이화여자대학교 반효경 교수, 강의 페이지 : http://www.kocw.or.kr/home/cview.do?mty=p&kemId=1046323 ↩
댓글남기기