
[Spark] 빅데이터와 아파치 스파크란
 [Spark The Definitive Guide - BIG DATA PROCESSING MADE SIMPLE] 책을 중심으로 스파크를 개인 공부를 위해 요약 및 정리해보았습니다. 다소 복잡한 설치 과정은 도커에 미리 이미지를 업로드해 놓았습니다. 즉, 도커 이미지를 pull하면 바로 스파크를 사용할 수 있습니다.
- 도커 설치 및 활용하는 방법 : [Spark] 빅데이터와 아파치 스파크란 - 1.2 스파크 실행하기
- 도커 이미지 링크 : https://hub.docker.com/r/ingu627/hadoop
- 예제를 위한 데이터 링크 : FVBros/Spark-The-Definitive-Guide
예제에 대한 실행 언어는 파이썬으로 했습니다. 스칼라는 추후에 다루겠습니다.
기본 실행 방법
- 예제에 사용 될 데이터들은 도커 이미지 생성 후
spark-3.3.0안의 하위 폴더data를 생성 후, 이 폴더에 추가합니다.- 1.1 데이터와 도커 설치 및 활용하는 방법은 위에 링크를 남겼습니다.
- 프로그램 시작은
cd spark-3.3.0후,./bin/pyspark명령어를 실행하시면 됩니다.
아파치 스파크는 통합 컴퓨팅 엔진이며 클러스터 환경에서 데이터를 병렬로 처리하는 라이브러리 집합이다. 이 글은 스파크의 철학과 실행 방법, 기본 아키텍처와 DataFrame·트랜스포메이션·액션 같은 핵심 개념을 정리한다.1
1. 아파치 스파크란
- 아파치 스파크(spark)는 통합 컴퓨팅 엔진이며 클러스터 환경에서 데이터를 병렬로 처리하는 라이브러리 집합이다.
- 스파크는 파이썬, 자바, 스칼라, R을 지원하며 SQL뿐만 아니라 스트리밍, 머신러닝에 이르기까지 넓은 범위의 라이브러리를 제공한다.
- 스파크는 단일 노트북 환경에서부터 수천 대의 서버로 구성된 클러스터까지 다양한 환경에서 실행할 수 있다.
- 이런 특성을 활용하면 단일 노트북 환경에서 시작해 수천 대 서버 규모의 클러스터까지 확장해나갈 수 있다.

- Figure 1-1은 스파크에서 제공하는 전체 컴포넌트와 라이브러리이다.
1.1 아파치 스파크의 철학
통합
- 스파크는 “빅데이터 애플리케이션 개발에 필요한 통합 플랫폼을 제공하자”는 핵심 목표를 가지고 있다.
- 스파크는 간단한 데이터 읽기에서부터 SQL 처리, 머신러닝 그리고 스트림 처리에 이르기까지 다양한 데이터 분석 작업을 같은 연산 엔진과 일관성 있는 API로 수행할 수 있도록 설계되어 있다.
컴퓨팅 엔진
- 스파크는 저장소 시스템의 데이터를 연산하는 역할만 수행할 뿐 영구 저장소 역할은 수행하지 않는다.
- 그 대신 클라우드 기반의 Azure Storage, Amazon S3, 분산 파일 시스템인 Apache Hadoop, 키/값 저장소인 Apache Cassandra, 메시지 전달 서비스인 Apache Kafka 등의 저장소를 지원한다.
- 스파크는 내부에 데이터를 오랜 시간 저장하지 않으며 특정 저장소 시스템을 선호하지도 않는다.
라이브러리
- 스파크는 엔진에서 제공하는 표준 라이브러리와 오픈소스 커뮤니티에서 서드파티 패키지 형태로 제공하는 다양한 외부 라이브러리를 지원한다.
- 스파크는 SQL과 구조화된 데이터를 제공하는 스파크 SQL, 머신러닝을 지원하는 MLlib, 스트림 처리 기능을 제공하는 스파크 스트리밍과 정형 스트리밍, 그래프 분석 엔진인 GraphX 라이브러리를 제공한다.
- 기본 라이브러리 외에 다양한 저장소 시스템을 위한 커넥터부터 머신러닝을 위한 알고리즘까지 다양한 외부 오픈소스 라이브러리로 존재한다.
1.2 스파크 실행하기
- 만약 윈도우10 내 리눅스(wsl2)를 설치하고 싶다면 아래 링크를 참고해보길 바란다.
- 먼저, 윈도우10 또는 우분투에서 도커를 설치한다.
- 스파크 설치 과정을 줄이기 위해 미리 도커 이미지를 업로드해놓았다.
- 명령어 창에
docker pull ingu627/hadoop:spark3.3.0를 실행한다.docker pull ingu627/hadoop:pyspark으로 실행해도 된다. pyspark는 아나콘다 및 pyspark가 설치된 버전이다.
- 그 후,
docker run -it -d -h spark -p 8080:8080 --privileged=true --name spark ingu627/hadoop:spark3.3.0 /sbin/init명령어를 통해 컨테이너를 실행해준다.
1.2.1 스파크 대화형 콘솔 실행하기
-
사용자는 다양한 언어를 지원하는 스파크의 대화형 셸을 실행할 수 있다.
- 파이썬 콘솔 실행하기
- 홈 디렉토리에서 다음 명령을 실행한다.
./spark-3.3.0/bin/pyspark- 대화형 콘솔에서 나가기 명령은
exit()를 실행해주면 된다.
-
실행결과

- 스칼라 콘솔 실행하기
- 홈 디렉토리에서 다음 명령을 실행한다.
./spark-3.3.0/bin/spark-shell- 대화형 콘솔에서 나가기 명령은
sys.exit또는:quit를 실행해주면 된다.
-
실행결과

- SQL 콘솔 실행하기
- 홈 디렉토리에서 다음 명령을 실행한다.
./spark-3.3.0/bin/spark-sql- 대화형 콘솔에서 나가기 명령은
quit;또는exit;를 실행해주면 된다.
-
실행결과

2.1 스파크의 기본 아키텍처
- 컴퓨터 클러스터(cluster)는 여러 컴퓨터의 자원을 모아 하나의 컴퓨터처럼 사용할 수 있게 만든다. 하지만, 컴퓨터 클러스터를 구성하는 것만으로는 부족하며 클러스터에서 작업을 조율할 수 있는 프레임워크가 필요한데 스파크가 바로 그런 역할을 한다.
- 스파크가 연산에 사용할 클러스터는 스파크 standalone 클러스터 매니저, 하둡 YARN, Mesos 같은 클러스터 매니저에서 관리한다.
- 사용자는 클러스터 매니저에 스파크 애플리케이션을 제출(submit)한다.
- 이를 제출받은 클러스터 매니저는 애플리케이션 실행에 필요한 자원을 할당하며 우리는 할당받은 자원으로 작업을 처리한다.
2.1.1 스파크 애플리케이션

- 스파크 애플리케이션 드라이버(driver) 프로세스와 다수의 익스큐터(executor) 프로세스로 구성된다.2
- 애플리케이션 : API를 써서 스파크 위에서 돌아가는 사용자 프로그램
- 드라이버 프로세스는 클러스터 노드 중 하나에서 실행되며 main() 함수를 실행한다.
- 이는 스파크 애플리케이션 정보의 유지 관리, 사용자 프로그램이나 입력에 대한 응답, 전반적인 익스큐터 프로세스의 작업과 관련된 분석, 배포 그리고 스케줄링 역할을 수행하기 때문에 필수적이다.
-
드라이버 프로세스는 애플리케이션의 수명 주기 동안 관련 정보를 모두 유지한다.
- 익스큐터(executor)는 드라이버 프로세스가 할당한 작업을 수행한다.
- 즉, 드라이버가 할당한 코드를 실행하고 진행 상황을 다시 드라이버 노드에 보고하는 2가지 역할을 수행한다.
- 클러스터 매니저는 스파크 standalone 클러스터 매니저, 하둡 YARN, 메소스(Mesos) 중 하나를 선택할 수 있으며 하나의 클러스터에서 여러 개의 스파크 애플리케이션을 실행할 수 있다.
- 사용 가능한 자원을 파악하기 위해 클러스터 매니저를 사용한다.
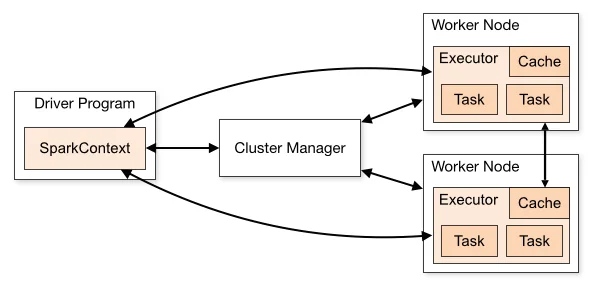 출처: Apache Spark Documentation - Cluster Mode Overview, Apache License 2.0
2.2 스파크의 다양한 언어 API
- 스파크의 언어 API를 이용하면 다양한 프로그래밍 언어로 스파크(spark) 코드를 실행할 수 있다.
- 언어 : 스칼라, 자바, 파이썬, SQL, R

- 사용자는 스파크 코드를 실행하기 위해 SparkSession 객체를 진입점으로 사용할 수 있다.
- 스파크는 사용자를 대신해 파이썬이나 R로 작성한 코드를 익스큐터의 JVM에서 실행할 수 있는 코드로 변환한다.
2.3 스파크 시작하기
- 다양한 언어로 스파크를 사용할 수 있는 이유는 스파크가 기본적으로 2가지 API를 제공하기 때문이다.
- 하나는 저수준의 비정형(unstructured) API이며, 다른 하나는 고수준의 정형(structured) API이다.
- 대화형 모드로 스파크를 시작하면 스파크 애플리케이션을 관리하는 SparkSession이 자동으로 생성된다.
- 하지만 standalone 애플리케이션으로 스파크를 시작하면 사용자 애플리케이션 코드에서 SparkSession 객체를 직접 생성해야 한다.
2.4 SparkSession
- 스파크 애플리케이션은 SparkSession이라 불리는 드라이버 프로세스로 제어한다.
- SparkSession 객체는 스파크 코어 기능들과 상호 작용할 수 있는 진입점을 제공하며 그 API로 프로그래밍을 할 수 있게 해주는 객체이다.
- 하나의 SparkSession은 하나의 스파크 애플리케이션에 대응한다.
- 스칼라와 파이썬 콘솔을 시작하면 spark 변수로 SparkSession을 사용할 수 있지만 스파크 애플리케이션에서는 사용자가 SparkSession 객체를 생성해서 써야 한다.
-
실행결과

- 다음은 일정 범위의 숫자를 만드는 작업을 수행하는 코드이다.
- 생성한 DataFrame은 한 개의 컬럼과 1000개의 로우(row)로 구성되며 각 로우에는 0부터 999까지의 값이 할당되어 있다.
- 이 숫자들은 분산 컬렉션(distributed collection)을 나타낸다.
- 클러스터 모드에서 코드 예제를 실행하면 숫자 범위의 각 부분이 서로 다른 익스큐터에 할당된다.
myRange = spark.range(1000).toDF("number")
-
실행결과

2.5 DataFrame
- DataFrame은 가장 대표적인 정형 API이다.
- DataFrame은 테이블의 데이터를 로우와 컬럼으로 단순하게 표현한다.
- 컬럼과 컬럼의 타입을 정의한 목록을 스키마(schema)라고 부른다.

- 스프레드시트와의 차이점으로, 스프레드시트는 한 대의 컴퓨터에 있지만, 스파크 DataFrame은 수천 대의 컴퓨터에 분산되어 있다.
- 여러 컴퓨터에 데이터를 분산하는 이유는 데이터가 너무 크거나 계산에 너무 오랜 시간이 걸릴 수 있기 때문이다.
2.5.1 파티션
- 스파크는 모든 익스큐터가 병렬로 작업을 수행할 수 있도록 파티션(partition)이라 불리는 청크(chunk) 단위로 데이터를 분할한다.
- 파티션(partition) : 클러스터의 물리적 머신에 존재하는 로우의 집합을 의미한다.
- DataFrame의 파티션은 실행 중에 데이터가 컴퓨터 클러스터에서 물리적으로 분산되는 방식을 나타낸다.
- DataFrame을 사용하면 파티션을 수동 혹은 개별적으로 처리할 필요가 없다.
- 물리적 파티션에 데이터 변환(transformation)용 함수를 지정하면 스파크가 실제 처리 방법을 결정한다.
2.6 트랜스포메이션
- 스파크의 핵심 데이터 구조는 불변성(immutable)을 가진다.
- 즉, 한번 생성하면 변경할 수 없다.
- DataFrame을 ‘변경’하려면 원하는 변경 방법을 스파크에 알려줘야 한다.
- 이 때 사용하는 명령을 트랜스포메이션(transformation)이라 부른다.
- 다음 코드는 DataFrame에서 짝수를 찾는 간단한 트랜스포메이션 예제이다.
divisBy2 = myRange.where("number % 2 = 0")
- 위 코드를 실행해도 결과는 출력되지 않는다.
-
추상적인 트랜스포메이션만 지정한 상태이기 때문에 액션(action)을 호출하지 않으면 스파크는 실제 트랜스포메이션을 수행하지 않는다.
- 트랜스포메이션에는 2가지 유형이 있다.
- 하나는 좁은 종속성(narrow dependency)이고 다른 하나는 넓은 종속성(wide dependency)이다.

- 좁은 종속성을 가진 트랜스포메이션은 각 입력 파티션이 하나의 출력 파티션에만 영향을 미친다.
- Figure 2-4에서 볼 수 있듯이 하나의 파티션이 하나의 출력 파티션에만 영향을 미친다.

- 넓은 종속성을 가진 트랜스포메이션은 하나의 입력 파티션이 여러 출력 파티션에 영향을 미친다.
- 스파크는 클러스터에서 파티션을 교환하는 셔플(shuffle)을 수행한다.
- 다만 셔플은 파티션 데이터를 디스크에 쓰고 네트워크로 다시 읽는 과정을 동반하므로, 좁은 종속성만으로 구성된 실행 계획보다 비용이 크다. 같은 로직이라도 파티션 수와 데이터 크기 같은 실행 조건에 따라 잡에 걸리는 시간이 크게 달라진다. 또 스파크는 연산 엔진일 뿐 영구 저장소가 아니므로, 결과를 오래 보관하려면 S3나 HDFS 같은 외부 저장소에 따로 기록해야 한다.
2.6.1 지연 연산
- 지연 연산(lazy evaluation)은 스파크가 연산 그래프를 처리하기 직전까지 기다리는 동작 방식을 의미한다.
- 스파크는 특정 연산 명령이 내려진 즉시 데이터를 수정하지 않고 원시 데이터에 적용할 트랜스포메이션의 실행 계획(plan)을 생성한다.
-
스파크는 코드를 실행하는 마지막 순간까지 대기하다가 원형 DataFrame 트랜스포메이션을 간결한 물리적 실행 계획으로 컴파일한다.
- 스파크는 이 과정을 거치며 전체 데이터 흐름을 최적화하는 강점을 가지고 있다.
- DataFrame의 조건절 푸시다운(predicate pushdown)이 한 예가 될 수 있다.5
- 아주 복잡한 스파크 잡(job)이 원시 데이터에서 하나의 로우만 가져오는 필터를 가지고 있다면 필요한 레코드 하나만 읽는 가장 효율적이다.
- 스파크는 이 필터를 데이터소스로 위임하는 최적화 작업을 자동으로 수행한다.
2.7 액션
- 사용자는 트랜스포메이션을 사용해 논리적 실행 계획을 세울 수 있다.
- 하지만 실제 연산을 수행하려면 액션(action) 명령을 내려야 한다.
- 액션(action)은 일련의 트랜스포메이션으로부터 결과를 계산하도록 지시하는 명령이다.
divisBy2.count()
# 500
-
count 외에도 다음 3가지 유형의 액션이 있다.
- 콘솔에서 데이터를 보는 액션
- 각 언어로 된 네이티브 객체에 데이터를 모으는 액션
- 출력 데이터소스에 저장하는 액션
- 액션을 지정하면 스파크 잡(job)이 시작된다.
- 잡(job) : 스파크 액션에 대한 응답으로 생성되는 여러 태스크로 이루어진 병렬 연산
- 태스크(task) : 스파크 익스큐터로 보내지는 작업 실행의 가장 기본적인 단위
- 스파크 잡은 필터(좁은 트랜스포메이션)를 수행한 후 파티션별로 레코드 수를 카운트(넓은 트랜스포메이션)한다.
- 그리고 각 언어에 적합한 네이티브 객체에 결과를 모은다.
2.8 스파크 UI
- 스파크 UI는 스파크 잡의 진행 상황을 모니터링할 때 사용한다.6
- 스파크 UI는 드라이버 노드의 4040 포트로 접속할 수 있다.
127.0.0.1:4040

- 스파크 UI에서 스파크 잡의 상태, 환경 설정, 클러스터 상태 등의 정보를 확인할 수 있다.
- 스파크 UI는 스파크 잡을 튜닝하고 디버깅할 때 유용하다.
References
-
Karau, Holden & Warren, Rachel. Spark: The Definitive Guide. O’Reilly Media, 2018. ↩
-
Apache Spark Documentation - Cluster Mode Overview (https://spark.apache.org/docs/latest/cluster-overview.html), Apache License 2.0 ↩
-
Apache Spark Documentation - RDD Programming Guide, Shuffle Operations (https://spark.apache.org/docs/latest/rdd-programming-guide.html#shuffle-operations), Apache License 2.0 ↩
-
Apache Spark Documentation - Parquet Files,
spark.sql.parquet.filterPushdown(https://spark.apache.org/docs/latest/sql-data-sources-parquet.html), Apache License 2.0 ↩ -
Apache Spark Documentation - Web UI, Monitoring and Instrumentation (https://spark.apache.org/docs/latest/monitoring.html), Apache License 2.0 ↩
댓글남기기