
맥 m1 환경에서 하둡(Hadoop), 스파크(Spark) 설치 및 환경설정하기
MacBook Pro (M1) 로컬 환경에서 하둡(Hadoop)과 스파크(Spark)를 설치하고 의사 분산(Pseudo-distributed) 모드로 구동하는 과정을 정리한다. JDK 설치부터 SSH 설정, HDFS/YARN 기동 확인, Spark 연동까지 4단계로 진행한다.
| 구성 요소 | 버전 |
|---|---|
| Java (JDK) | 19.0.1 |
| Hadoop | 3.3.4 |
| Spark | 3.3.0 |
| 환경 | macOS (Apple Silicon arm64) |

1. 자바(JDK 19) 설치
- 하둡은 자바 기반의 오픈 소스 프레임워크이므로, 자바를 먼저 설치해줘야 한다.
- [ORACLE JAVA 19] 링크로 가
Arm 64 DMG Installer를 다운로드한다. -
스크린샷

- 또는 Azul의 Zulu OpenJDK도 맥 m1칩용을 제공한다. 둘 중 아무거나 받아도 상관없다.
- [AZUL Java 19(STS)] 링크로 가 macOS arm64버전을 다운로드한다.
-
스크린샷

- 그 후
vi ~/.zshrc명령어를 통해 파일을 연 뒤, 아래처럼 java 경로를 export 해준다.- 또는
~/.bashrc
- 또는
- 완료 후,
source ~/.zshrc명령어를 통해 파일을 실행한다.
export JAVA_HOME="/Library/Java/JavaVirtualMachines/zulu-19.jdk/Contents/Home"
export CLASSPATH=.:$JAVA_HOME/lib/tools.jar
export PATH=${PATH}:$JAVA_HOME/bin
-
java -version명령어로 아래처럼 나오면 정상적으로 설치가 됐다.
2. ssh 설정
- 하둡은 네임(마스터) 노드에서 여러 개의 데이터(워커) 노드와 서버 접속이 가능하게 해야 되기 때문에 ssh 통신에 사용할 키 교환을 수행해야 한다.
ssh localhost명령어를 통해 ssh 설치 여부를 확인할 수 있다.- 키 생성은 다음과 같다.
- 인증키를 미리 생성해서 ssh에 로그인할 때 비밀번호 대신 사용하는 방식이다.
$ ssh-keygen -t rsa -P '' -f ~/.ssh/id_rsa
$ cat ~/.ssh/id_rsa.pub >> ~/.ssh/authorized_keys
$ chmod 0600 ~/.ssh/authorized_keys
3. 하둡 설치
- 맥에서 brew를 통해 쉽게 설치가 가능하지만, 나중에 리눅스 등 다른 OS에서도 원활히 설치하기 위해 하둡 홈페이지에서 설치를 진행해본다.
- 마찬가지로, 해당 [Apache Hadoop - Download] 링크로 가
binary파일을 다운받는다. -
스크린샷

- 보통
Downloads경로에 다운로드 받아지므로 이를 root 경로로 변경해준다. -
mv hadoop-3.3.4 ~/hadoop-3.3.4 - 자바 경로처럼 하둡도
~/.zshrc로 가 경로를 설정해준다.- 이는 하둡을 실행하기 전에 자바가 설치된 위치를 하둡에 알려주어야 하기 때문이다.
- 하둡 데몬을 실행하는 스크립트는
sbin디렉토리에 있다. 하둡 데몬을 로컬 컴퓨터에서 실행하려면 이 디렉토리를 PATH에 추가해줘야 한다.
export HADOOP_HOME="/Users/hyunseokjung/hadoop-3.3.4"
export PATH=$PATH:$HADOOP_HOME/bin:$HADOOP_HOME/sbin
export HADOOP_CONF_DIR=$HADOOP_HOME/etc/hadoop
설정 파일을 만들기 전에, 하둡 데몬이 HDFS 안에서 어떤 역할을 맡는지 공식 문서의 도식으로 확인해두자.
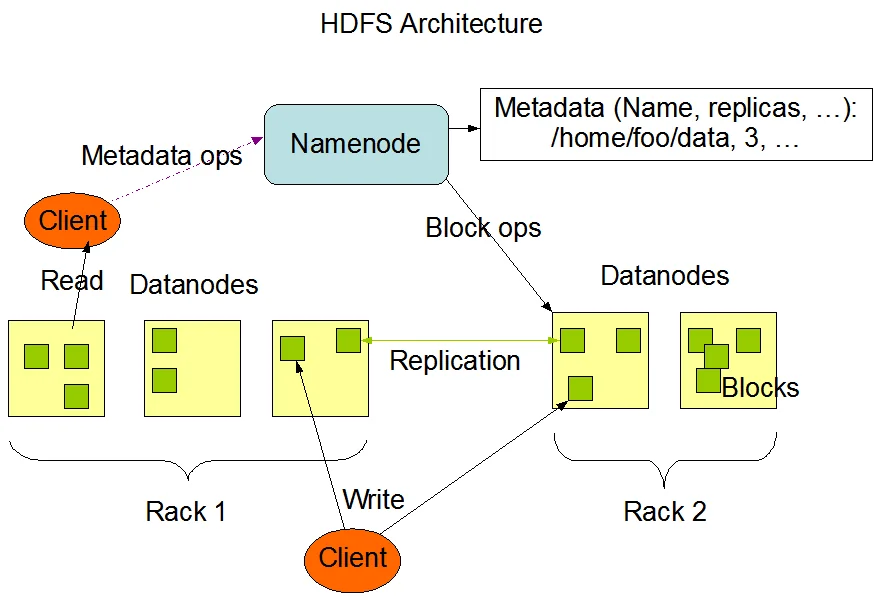
출처: HDFS Architecture (https://hadoop.apache.org/docs/r3.3.4/hadoop-project-dist/hadoop-hdfs/HdfsDesign.html)
3.1 그 외 환경설정
- 하둡의 각 구성요소에 대한 설정은 XML 파일을 이용한다.
- etc/hadoop/core-site.xml : 공통 속성
- etc/hadoop/hdfs-site.xml : HDFS 속성
- etc/hadoop/mapred-site.xml : 맵리듀스 속성
- etc/hadoop/yarn-site.xml : YARN 속성
- 가상 분산(Pseudo-Distributed) 모드는 모든 하둡 데몬을 로컬 머신에서 실행하는 방법이다. 지금은 이 모드를 사용해본다.
- 하둡 데몬을 여러 대의 머신으로 구성된 클러스터에서 실행하는 방법은 추후에 쓰겠다.
-
etc/hadoop디렉토리에 다음 내용이 담긴 환경 설정 파일을 만든다. - core-site.xml
<configuration>
    <property>
        <name>fs.defaultFS</name>
        <value>hdfs://localhost:9000</value>
    </property>
</configuration>
- hdfs-site.xml
<configuration>
    <property>
        <name>dfs.replication</name>
        <value>1</value>
    </property>
</configuration>
- mapred-site.xml
<configuration>
  <property>
      <name>mapreduce.framework.name</name>
      <value>yarn</value>
  </property>
  <property>
    <name>mapred.job.tracker</name>
    <value>localhost:8021</value>
  </property>
</configuration>
- yarn-site.xml
<configuration>
    <property>
        <name>yarn.nodemanager.aux-services</name>
        <value>mapreduce_shuffle</value>
    </property>
</configuration>
3.2 HDFS 파일시스템 포맷하기
- HDFS를 사용하기 전에 먼저 파일시스템을 포맷해줘야 한다.
$ bin/hdfs namenode -format
3.3 데몬 시작과 중지
- HDFS, 맵리듀스, YARN 데몬을 각각 구동하기 위한 명령어는 다음과 같다.
$ sbin/start-dfs.sh ## HDFS
$ sbin/mr-jobhistory-daemon.sh start historyserver ## 맵리듀스
$ sbin/start-yarn.sh ## YARN
http://localhost:9870웹 UI를 통해 데몬 프로세스를 확인할 수 있다.-
결과

-
또한, 자바의
jps명령어를 사용해 데몬 동작 여부를 파악할 수 있다. - 데몬 중지는 다음과 같다.
$ sbin/stop-dfs.sh ## HDFS
$ sbin/mr-jobhistory-daemon.sh stop historyserver ## 맵리듀스
$ sbin/stop-yarn.sh ## YARN
3.4 사용자 디렉토리 생성
- 다음 명령어를 통해 홈 디렉토리를 생성한다.
$ hadoop fs -mkdir -p /user/hyunseokjung
4. 스파크 설치
- 스파크(Apache Spark)는 빅데이터 처리를 위한 오픈 소스 분산 시스템이다.
- 하둡과 마찬가지로 [Apache Spark Homepage - Download] 링크로 가 최신 버전을 설치해준다.
-
스크린샷

- 보통
Downloads경로에 다운로드 받아지므로 이를 root 경로로 변경해준다. mv spark-3.3.0-bin-hadoop3 ~/spark-3.3.0- 그리고
~/.zshrc로 가 spark에 대한 환경설정을 해준다.
export SPARK_HOME="/Users/hyunseokjung/spark-3.3.0"
export PATH=$PATH:$SPARK_HOME/bin:$SPARK_HOME/sbin
export SPARK_LOCAL_HOSTNAME=localhost
그 외 스파크에 대한 자세한 내용은 Category - SPARK 링크로 가 참조하면 된다.
5. 한계와 트레이드오프
- 공식 단일 노드 문서는 이 구성을 “간단한 작업을 빠르게 수행”하기 위한 것으로 소개한다. 노드 한 대에 모든 데몬을 올린 구성이므로 내결함성, 노드 수에 따른 확장성, 클러스터 규모의 처리량은 여기서 재현되지 않는다.
dfs.replication을 1로 두었으므로 블록의 복제본이 하나뿐이다. 디스크가 손상되면 해당 블록은 복구할 수 없다.fs.defaultFS를hdfs://localhost:9000으로 고정했으므로 다른 호스트에서는 이 클러스터에 접속할 수 없다.- 공식 지원 매트릭스는 Hadoop 3.3 이상에 대해 Java 8과 Java 11(런타임)을 명시한다(Hadoop Java Versions). 이 글의 JDK 19 조합은 문서가 보증하는 범위 밖이므로, 버전을 바꿔 설치할 때는 동작 차이를 확인해야 한다.
- 단일 노드 문서는 GNU/Linux와 Windows를 대상으로 서술한다. macOS(Apple Silicon) 설치는 문서에 명시되지 않은 경로이므로 배포판별 차이는 각자 확인해야 한다.
댓글남기기