
[Spark] 정형 API: DataFrame의 transformation 다루는 방법
 [Spark The Definitive Guide - BIG DATA PROCESSING MADE SIMPLE] 책을 중심으로 스파크를 개인 공부를 위해 요약 및 정리해보았습니다. 다소 복잡한 설치 과정은 도커에 미리 이미지를 업로드해 놓았습니다. 즉, 도커 이미지를 pull하면 바로 스파크를 사용할 수 있습니다.
- 도커 설치 및 활용하는 방법 : [Spark] 빅데이터와 아파치 스파크란 - 1.2 스파크 실행하기
- 도커 이미지 링크 : https://hub.docker.com/r/ingu627/hadoop
- 예제를 위한 데이터 링크 : FVBros/Spark-The-Definitive-Guide
예제에 대한 실행 언어는 스칼라(scala)로 했습니다. 앞으로 스파크와 관련된 내용은 딥러닝 부분을 제외하고 스칼라로 진행될 예정입니다.
기본 실행 방법 1. 예제에 사용 될 데이터들은 도커 이미지 생성 후
spark-3.3.0안의 하위 폴더data를 생성 후, 이 폴더에 추가합니다. 1.1 데이터와 도커 설치 및 활용하는 방법은 위에 링크를 남겼습니다. 2. 프로그램 시작은cd spark-3.3.0후,./bin/spark-shell명령어를 실행하시면 됩니다.
1. DataFrame의 트랜스포메이션

- DataFrame을 다루는 방법은 다음과 같은 작업으로 나눌 수 있다.
- 로우나 컬럼 추가
- 로우나 컬럼 제거
- 로우를 컬럼으로 변환하거나 그 반대로 변환
- 컬럼값을 기준으로 로우 순서 변경
- 가장 일반적인 트랜스포메이션은 모든 로우의 특정 컬럼값을 변경하고 그 결과를 반환하는 것이다.
2. DataFrame 생성하기
val df = spark.read.format("json"
    ).load("./data/flight-data/json/2015-summary.json")
df.createOrReplaceTempView("dfTable") // dfTable은 객체명을 의미
- Row 객체를 가진 Seq 타입을 직접 변환해 DataFrame을 생성할 수도 있다.
import org.apache.spark.sql.Row
import org.apache.spark.sql.types.{StructField, StructType, StringType, LongType}

val myManualSchema = new StructType(Array(
    new StructField("some", StringType, true),
    new StructField("col", StringType, true),
    new StructField("names", LongType, false)
))

val myRows = Seq(Row("Hello", null, 1L))
val myRDD = spark.sparkContext.parallelize(myRows) // 로컬 컬렉션을 배포하여 RDD를 형성
val myDf = spark.createDataFrame(myRDD, myManualSchema) // RDD(data)와 스키마부터 DataFrame 생성

myDf.show()
-
실행결과

3. select와 selectExpr
select와selectExpr메서드를 사용하면 데이터 테이블에 SQL을 실행하는 것처럼 DataFrame에서도 SQL을 사용할 수 있다. 1
df.select("DEST_COUNTRY_NAME").show(2)
-- SQL
SELECT DEST_COUNTRY_NAME FROM dfTable LIMIT 2
-
실행결과

-
같은 형태의 쿼리로 여러 컬럼을 선택할 수 있다. 여러 컬럼을 선택하려면 select 메서드에 원하는 컬럼명을 추가한다.
df.select("DEST_COUNTRY_NAME", "ORIGIN_COUNTRY_NAME").show(2)
-
실행결과

-
같은 의미로 컬럼을 참조하는 다양한 방법들이 있다.
import org.apache.spark.sql.functions.{expr, col, column}

df.select(
    df.col("DEST_COUNTRY_NAME"),
    col("DEST_COUNTRY_NAME"),
    column("DEST_COUNTRY_NAME"),
    'DEST_COUNTRY_NAME,
    $"DEST_COUNTRY_NAME",
    expr("DEST_COUNTRY_NAME")
).show(2)
- select 메서드에 expr 함수를 사용하는 패턴을 자주 사용한다.
- 스파크는 이런 작업을 간단하고 효율적으로 할 수 있는
selectExpr메서드를 제공한다.
df.selectExpr("DEST_COUNTRY_NAME as newColumnName", "DEST_COUNTRY_NAME").show(2)
-
실행결과

-
select 표현식에는 DataFrame의 컬럼에 대한 집계 함수를 지정할 수 있다.
df.selectExpr("avg(count)", "count(distinct(DEST_COUNTRY_NAME))").show(2)
-
실행결과

4. 스파크 데이터 타입으로 변환하기
- 때로는 새로운 컬럼이 아닌 명시적인 값을 스파크에 전달해야 한다.
- 이때 리터럴(literal)을 사용하는데, 리터럴은 프로그래밍 언어의 리터럴값을 스파크가 이해할 수 있는 값으로 변환한다. 2
- 어떤 상수나 프로그래밍으로 생성된 변숫값이 특정 컬럼의 값보다 큰지 확인할 때 리터럴을 사용한다.
import org.apache.spark.sql.functions.lit

df.select(expr("*"), lit(1).as("One")).show(2)
-- SQL
-- SQL에서 리터럴은 상숫값을 의미한다.
SELECT *, 1 as One FROM dfTable LIMIT 2
-
실행결과

5. 컬럼 추가하기
- DataFrame에 신규 컬럼을 추가하는 방법은 DataFrame의
withColumn메서드를 사용하는 것이다.- 메서드 :
DataFrame.withColumn(colName, col)3
- 메서드 :
df.withColumn("numberOne", lit(1)).show(2)
-
실행결과

-
withColumn메서드로 컬럼명을 변경할 수도 있다.
df.withColumn("Destination", expr("DEST_COUNTRY_NAME")).columns // columns : DataFrame 컬럼에 접근
-
실행결과

6. 컬럼명 변경하기
withColumnRenamed메서드로 컬럼명을 변경할 수 있다. 4- withColumnRenamed 메서드는 첫 번째 인수로 전달된 컬럼명을 두 번째 인수의 문자열로 변경한다.
df.withColumnRenamed("DEST_COUNTRY_NAME", "dest").columns
-
실행결과

7. 예약 문자와 키워드
- 공백(space)이나 하이픈(
-, dash)같은 예약 문자(reserved characters)는 컬럼명에 사용할 수 없다. - 예약 문자를 컬럼명에 사용하려면 백틱(`) 문자를 이용해 이스케이핑해야 한다.
import org.apache.spark.sql.functions.expr

val dfWithLongColName = df.withColumn(
    "This Long Column-Name",
    expr("ORIGIN_COUNTRY_NAME")
)

dfWithLongColName.selectExpr(
    "`This Long Column-Name`",
    "`This Long Column-Name` as `new col`"
).show(2)
-
실행결과

8. 대소문자 구분
- 기본적으로 스파크는 대소문자를 가리지 않는다.
9. 컬럼 제거하기
drop메서드를 사용해 DataFrame의 컬럼을 제거할 수 있다. 5
df.drop("ORIGIN_COUNTRY_NAME").columns
-
실행결과

10. 컬럼의 데이터 타입 변경하기
cast메서드로 데이터 타입을 변환할 수 있다. 6- 다음은 count 컬럼을 Integer 데이터 타입에서 String 데이터 타입으로 형변환하는 예제이다.
df.withColumn("count2", col("count").cast("string")).printSchema
-
실행결과

11. 로우 필터링하기
- 로우를 필터링하려면 참과 거짓을 판별하는 표현식을 만들어야 한다. 그러면 표현식의 결과가 false인 로우를 걸러낼 수 있다.
- DataFrame의
where메서드나filter메서드로 필터링할 수 있다.
df.filter(col("count") < 2).show(2)
df.where("count < 2").show(2)
-
실행결과

12. 고유한 로우 얻기
- DataFrame의 모든 로우에서 중복 데이터를 제거할 수 있는
distinct메서드를 사용해 고윳값을 찾을 수 있다.- distinct 메서드는 중복되지 않은 로우를 가진 새로운 DataFrame을 반환한다. 7
df.select("ORIGIN_COUNTRY_NAME", "DEST_COUNTRY_NAME").distinct.count()
// 결과 : 256
13. 무작위 샘플 만들기
- DataFrame에서 무작위 샘플 데이터를 얻으려면 DataFrame의
sample메서드를 사용한다. - DataFrame에서 표본 데이터 추출 비율을 지정할 수 있으며, 복원 추출이나 비복원 추출의 사용 여부를 지정할 수도 있다.
val withReplacement = false
val fraction = 0.5
val seed = 5
df.sample(withReplacement, fraction, seed).count()
// 결과 : 138
14. 임의 분할하기
- 임의 분할(random split)은 원본 DataFrame을 임의 크기로 분할할 때 유용하게 사용된다.
val dataFrames = df.randomSplit(Array(0.25, 0.75), seed)
15. 로우 합치기와 추가하기
- DataFrame은 불변성(immutable)을 가진다.
- 그러므로 DataFrame에 레코드를 추가하는 작업은 DataFrame을 변경하는 작업이기 때문에 불가능하다.
- DataFrame에 레코드를 추가하려면 원본 DataFrame을 새로운 DataFrame과 통합(union)해야 한다.
- 통합(union)은 2개의 DataFrame을 단순히 결합하는 행위이다.
- 통합하려는 2개의 DataFrame은 반드시 동일한 스키마와 컬럼 수를 가져야 한다.
=!=: 컬럼 표현식과 문자열을 비교할 때 사용 (notEqual 개념)===: 컬럼 표현식과 문자열을 비교할 때 사용 (Equal 개념)
import org.apache.spark.sql.Row

val schema = df.schema

val newRows = Seq(
    Row("New Country", "Other Country", 5L),
    Row("New Country 2", "Other Country 3", 1L)
)

val parallelizedRows = spark.sparkContext.parallelize(newRows)
val newDF = spark.createDataFrame(parallelizedRows, schema)

df.union(newDF // df와 newDF를 합치는데
    ).where("count = 1" // 조건은 이러하고
    ).where($"ORIGIN_COUNTRY_NAME" =!= "United States" // =!= : notEqual
    ).show()
-
실행결과

16. 로우 정렬하기
sort와orderBy메서드를 사용해 DataFrame의 최댓값 혹은 최솟값이 상단에 위치하도록 정렬할 수 있다.- 두 메서드 모두 컬럼 표현식과 문자열을 사용할 수 있으며 다수의 컬럼을 지정할 수 있다.
df.orderBy("count", "DEST_COUNTRY_NAME").show(5)
-
실행결과

- 정렬 기준을 명확히 지정하려면
asc나desc함수를 사용한다. 8 - 또한
asc_nulls_first,desc_nulls_first,asc_nulls_last,desc_nulls_last메서드를 사용하여 정렬된 DataFrame에서 null 값이 표시되는 기준을 지정할 수 있다.
import org.apache.spark.sql.functions.{desc, asc}

df.orderBy(desc("count"), asc("DEST_COUNTRY_NAME")).show(5)
-
실행결과

- 트랜스포메이션을 처리하기 전에 성능을 최적화하기 위해 파티션별 정렬을 수행하기도 한다.
sortWithinPartitions메서드로 파티션별 정렬을 한다. 9
spark.read.format("json").load("./data/flight-data/json/*-summary.json"
    ).sortWithinPartitions("count")
17. 로우 수 제한하기
limit메서드를 사용해 추출할 로우 수를 제한할 수 있다.
df.orderBy(expr("count desc")).limit(6).show()
-
실행결과

18. repartition과 coalesce
repartition메서드를 호출하면 무조건 전체 데이터를 셔플한다. 10- 향후에 사용할 파티션 수가 현재 파티션 수보다 많거나 컬럼을 기준으로 파티션을 만드는 경우에만 사용해야 한다.
df.rdd.getNumPartitions
// 결과 : 1

df.repartition(5)
- 특정 컬럼을 기준으로 자주 필터링한다면 자주 필터링되는 컬럼을 기준으로 파티션을 재분배하는 것이 좋다.
df.repartition(col("DEST_COUNTRY_NAME"))
- 선택적으로 파티션 수를 지정할 수도 있다.
df.repartition(5, col("DEST_COUNTRY_NAME"))
coalesce메서드는 전체 데이터를 셔플하지 않고 파티션을 병합하려는 경우에 사용한다. 11- 다음은 목적지를 기준으로 셔플을 수행해 5개의 파티션으로 나누고, 전체 데이터를 셔플 없이 병합하는 예제이다.
df.repartition(5, col("DEST_COUNTRY_NAME")).coalesce(2)
19. 드라이버로 로우 데이터 수집하기
- 스파크는 드라이버에서 클러스터 상태 정보를 유지한다.
- 로컬 환경에서 데이터를 다루려면 드라이버로 데이터를 수집해야 한다.
collect메서드는 전체 DataFrame의 모든 데이터를 수집하며,take메서드는 상위 N개의 로우를 반환한다. 12show메서드는 여러 로우를 보기 좋게 출력한다.
val collectDF = df.limit(10)
collectDF.take(5)
collectDF.show()
collectDF.show(5, false)
collectDF.collect()
-
실행결과

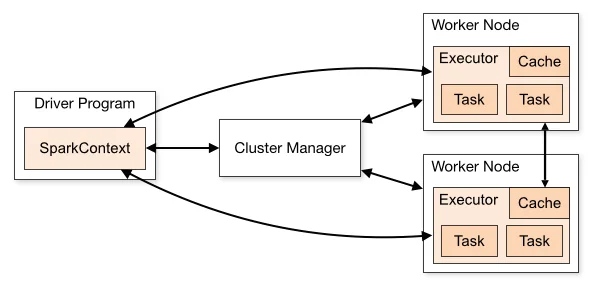
출처: Apache Spark Documentation, “Cluster Mode Overview” (https://spark.apache.org/docs/latest/cluster-overview.html) — Apache License 2.0
toLocalIterator메서드는 이터레이터(iterator)로 모든 파티션의 데이터를 드라이버에 전달한다.
collectDF.toLocalIterator()
20. 한계와 트레이드오프
repartition은 항상 전체 셔플을 동반한다 : 파티션 수를 늘리든 줄이든 전체 데이터를 다시 섞으므로 네트워크·디스크 비용이 크다. 파티션 수를 늘릴 필요가 없고 데이터 쏠림도 감수할 수 있는 경우에만coalesce를 쓰는 편이 저렴하다. 10coalesce는 파티션 수를 늘리지 못한다 : 전체 셔플 없이 기존 파티션을 합치기만 하므로 파티션 수를 줄일 수는 있어도 늘릴 수 없고, 데이터가 파티션에 고르게 재분배된다는 보장도 없다. 11sortWithinPartitions는 전역 정렬이 아니다 : 파티션 내부만 정렬하므로 DataFrame 전체의 순서를 보장하지 않는다. 전역 순서가 필요하면orderBy/sort로 셔플 정렬을 해야 한다. 9distinct·collect는 결과를 모으는 비용이 크다 :distinct는 전체 로우를 셔플해 중복을 제거하므로 7,collect는 전체 결과를 드라이버 메모리에 한꺼번에 모으므로 결과가 크면 드라이버 OOM으로 이어진다.toLocalIterator는 파티션을 하나씩(미리 읽기 포함 최대 2개) 순회하므로 드라이버 메모리 사용량은 가장 큰 파티션 크기에 좌우되지만, 순회하며 결과를 누적해 두면 결국 전체 크기만큼의 메모리가 필요하다. 이때는limit·take·show로 필요한 만큼만 가져오는 편이 안전하다. 12- 트랜스포메이션은 지연 평가된다 :
select·withColumn같은 변환은 호출 시점에 실행되지 않고 계획만 쌓이므로, 존재하지 않는 컬럼명 같은 오류가 변환 호출 시점이 아니라 뒤따르는 액션 호출 시점에 드러날 수 있다. 13
References
-
pyspark.sql.DataFrame.withColumn - Apache Spark Documentation ↩
-
pyspark.sql.DataFrame.withColumnRenamed - Apache Spark Documentation ↩
-
pyspark.sql.DataFrame.distinct - Apache Spark Documentation ↩ ↩2
-
pyspark.sql.DataFrame.sortWithinPartitions - Apache Spark Documentation ↩ ↩2
-
pyspark.sql.DataFrame.repartition - Apache Spark Documentation ↩ ↩2
-
pyspark.sql.DataFrame.coalesce - Apache Spark Documentation ↩ ↩2
-
pyspark.sql.DataFrame.collect - Apache Spark Documentation ↩ ↩2
-
RDD Programming Guide (지연 평가) - Apache Spark Documentation ↩
댓글남기기