
Vector Search Systems: 인덱싱 알고리즘(HNSW·IVF-PQ)과 프로덕션 검색 엔진 비교 분석
생성형 AI와 검색 증강 생성(RAG, Retrieval-Augmented Generation) 아키텍처가 발전하면서 비정형 데이터(텍스트, 이미지, 코드)를 고차원 밀집 벡터(Dense Vector)로 변환하여 검색하는 벡터 검색 시스템(Vector Search System)이 핵심 인프라로 자리 잡았다1.
그러나 고차원 벡터 공간에서 쿼리 벡터와 가장 유사한 상위 $k$개의 항목을 찾는 문제는 전통적인 관계형 데이터베이스의 B-Tree 인덱스로는 해결할 수 없다. 고차원 공간에서는 모든 데이터 포인트 간의 거리가 거의 균일해지는 차원의 저주(Curse of Dimensionality)가 발생하며, $N$개의 $d$차원 벡터에 대해 모든 항목과의 거리를 빠짐없이 계산하는 정확한 $k$-NN(Exact $k$-Nearest Neighbors) 검색은 $O(N \cdot d)$의 시간 복잡도를 요구하므로 수백만 건 이상의 대규모 환경에서 실시간 쿼리가 불가능하다.
이러한 한계를 극복하기 위해 벡터 데이터베이스는 약간의 재현율(Recall) 손실을 감수하는 대신 쿼리 지연시간을 수 밀리초(ms) 단위로 단축하는 근사 최근접 이웃(ANN, Approximate Nearest Neighbor) 알고리즘을 사용한다. 이 글에서는 대표적인 ANN 알고리즘들의 수학적 원리, 메모리 및 성능 트레이드오프, 메타데이터 필터링 방식, 그리고 주요 벡터 검색 엔진들의 프로덕션 아키텍처를 심층 분석한다.
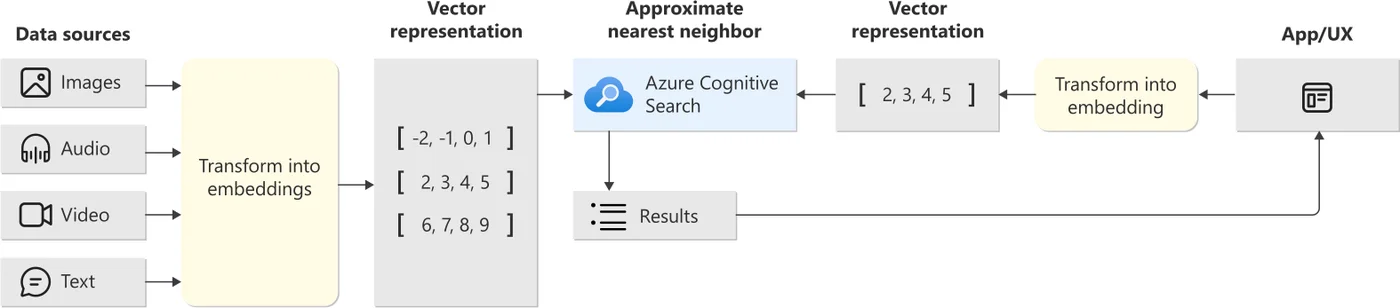
출처: Vector Search Overview - Azure AI Search, Microsoft Learn (https://learn.microsoft.com/en-us/azure/search/vector-search-overview)
1. ANN 인덱싱 알고리즘 심층 분석
ANN 알고리즘은 크게 그래프 기반(Graph-based), 양자화 기반(Quantization-based), 트리/해시 기반(Tree/Hash-based), 그리고 최근 부상한 디스크 최적화(Disk-optimized) 방식으로 나뉜다.
주요 ANN 알고리즘 군집 비교:
┌─────────────────┬──────────────────────────┬──────────────────────────┬──────────────────────────┐
│ 알고리즘        │ HNSW                     │ IVF-PQ                   │ DiskANN (Vamana)         │
├─────────────────┼──────────────────────────┼──────────────────────────┼──────────────────────────┤
│ 주요 원리       │ 계층적 Skip-list 그래프  │ Voronoi 분할 + 직교 압축 │ 디스크 랜덤 I/O 최적 그래프│
│ 메모리 점유     │ 높음 (전체 그래프 RAM)   │ 매우 낮음 (코드북 압축)  │ 낮음 (압축 벡터만 RAM)   │
│ 재현율 (Recall) │ 95% ~ 99%+ (최상급)      │ 85% ~ 95% (중상급)       │ 95% ~ 98% (상급)         │
│ 빌드 속도       │ 느림 ($O(N \log N)$)     │ 보통 (k-means 클러스터링)│ 중간                     │
│ 주 권장 환경    │ 실시간 고정밀 서빙      │ 수천만~수억 건 대규모 RAM│ 단일 노드 억 단위 대규모 │
└─────────────────┴──────────────────────────┴──────────────────────────┴──────────────────────────┘
1.1 HNSW (Hierarchical Navigable Small World)
HNSW는 현재 프로덕션 환경에서 가장 널리 사용되는 그래프 기반 알고리즘 중 하나다. 확률적 스킵 리스트(Skip-list)의 아이디어를 클라인버그의 작은 세상(Small World) 네트워크에 접목했다.
HNSW 계층 구조:
Layer 2 (최상위, 듬성듬성):  [Node A] ───────────────────────────> [Node Z] (원거리 고속 스킵)
                                │                                     │
Layer 1 (중간 계층):        [Node A] ───────> [Node G] ──────> [Node Z]
                                │                 │                   │
Layer 0 (최하위, 모든 노드): [Node A] ─> [B] ─> [G] ─> [M] ─> [P] ─> [Z] (국소 탐색, 정밀 수렴)
- 계층 구조 탐색 메커니즘:
- 최상위 레이어는 적은 수의 노드와 긴 간선(Long-range Edge)으로 구성되어 쿼리 벡터 근처로 빠르게 점프한다.
- 각 레이어에서 탐색 빔(Greedy Search)을 통해 로컬 최적 노드를 찾으면 아래 레이어로 내려가며 점진적으로 정밀도를 높인다.
- 최하위 Layer 0은 모든 노드가 촘촘한 $k$-NN 그래프로 연결되어 있어 최종 $k$개의 이웃을 수렴 탐색한다.
- 핵심 튜닝 파라미터와 트레이드오프:
- $M$ (노드당 최대 간선 수): 값이 클수록 재현율이 높아지지만, 메모리 점유율과 인덱스 빌드 시간이 선형 증가한다 (통상 16~64).
- $efConstruction$ (인덱스 빌드 시 동적 탐색 리스트 크기): 값이 클수록 최적의 간선이 연결되어 쿼리 재현율이 상승하지만 빌드 시간이 길어진다 (통상 100~400).
- $efSearch$ (런타임 쿼리 시 탐색 리스트 크기): 지연시간과 재현율 사이의 즉각적인 런타임 조율 레버다.
HNSW의 최대 병목은 RAM 사용량이다. 원본 벡터뿐만 아니라 각 노드의 간선 리스트 포인터까지 모두 메모리에 상주해야 하므로, 1536차원 FP32 벡터 1천만 개를 서빙할 때 벡터 본체만 약 61GB에 달하고, 여기에 그래프 간선과 인덱스 오버헤드가 더해져 100GB 이상의 고가 RAM이 필요하다. 실제 요구량은 데이터 분포와 $M$, $efConstruction$ 설정에 따라 달라진다.
1.2 IVF-PQ (Inverted File with Product Quantization)
메모리 제약이 극심한 대규모 환경에서는 벡터를 압축하는 양자화 기법이 필수적이다.
- IVF (Inverted File, 역색인):
- 전체 벡터 공간을 $k$-means 클러스터링을 통해 $C$개의 보로노이 셀(Voronoi Cells)로 분할한다.
- 쿼리가 들어오면 가장 가까운 $nprobe$개의 센트로이드(Centroid)에 속한 인버티드 리스트만 선별 탐색하여 탐색 공간을 $1/C$ 수준으로 축소한다.
- PQ (Product Quantization, 곱 양자화):
- $d$차원 벡터를 $m$개의 저차원 서브벡터($d/m$차원)로 쪼갠다.
- 각 서브공간에서 별도의 $k$-means(통상 $k^*=256$)를 수행하여 256개의 센트로이드 코드북(Codebook)을 구축한다.
- 원본 벡터는 각 서브공간의 센트로이드 인덱스(8비트 = 1바이트) $m$개로 압축된다. 결과적으로 1536차원 FP32(6144바이트) 벡터를 $m=64$ 바이트로 약 96배 압축할 수 있다.
- 비대칭 거리 계산(ADC, Asymmetric Distance Computation):
- 쿼리 벡터는 비압축(FP32) 상태를 유지하고, DB 내의 압축된 PQ 코드와의 거리를 코드북 룩업 테이블(LUT)을 통해 사전 계산된 거리들의 합으로 $O(m)$ 시간에 초고속 산출한다.
1.3 DiskANN: SSD 기반 단일 노드 억 단위 서빙
Microsoft에서 제안한 DiskANN은 고가의 RAM 대신 대용량 NVMe SSD의 고속 랜덤 읽기 능력을 활용하는 Vamana 그래프 알고리즘 기반 시스템이다. 압축된 벡터(PQ 코드)만 RAM에 올려 대략적인 빔 서치를 수행하고, 최종 재정렬 단계에서 필요한 원본 벡터와 이웃 간선 리스트만 SSD에서 직접 비동기 I/O로 로드한다. 이 구성에서 단일 서버로 1억 개 이상의 벡터를 95% 이상의 재현율과 10ms 이하의 지연시간으로 서빙할 수 있다고 보고되며(수치는 데이터셋·하드웨어·튜닝 조건에 따라 달라진다), 원본 벡터를 전부 RAM에 상주시키는 구성 대비 TCO(총소유비용)를 낮춘다. 다만 지연시간이 SSD 랜덤 읽기 성능에 직접 의존하므로, 디스크 처리량이 낮은 환경에서는 재현율 목표를 낮추거나 병렬 I/O 튜닝이 필요하다.
2. 메타데이터 필터링 전략: Pre vs. Post vs. Single-stage
엔터프라이즈 RAG에서는 순수한 유사도 검색만 단독으로 쓰이지 않는다. user_id == 123이거나 created_at >= 2025-01-01인 문서 중에서만 벡터 유사도를 계산해야 하는 메타데이터 필터링(Metadata Filtering)이 필수적이다.
메타데이터 필터링 3대 전략:
1. Pre-filtering:
   [Metadata Filter] ──> 후보군 추출 (1,000만건 중 50건) ──> [Exact KNN] (HNSW 인덱스 무용지물)
   * 문제: 필터 결과가 많으면 풀스캔 비용 발생, 적으면 인덱스 우회로 느림.

2. Post-filtering:
   [HNSW ANN Search] ──> Top-100 반환 ──> [Metadata Filter] (조건 검사) ──> 남은 결과 0건!
   * 문제: 조건이 엄격할 때 Top-k에 필터 통과 문서가 없어 재현율이 0으로 급락.

3. Single-stage (Iterative / In-graph Filtering):
   [HNSW 탐색 루프] ──> 노드 방문 시점에 비트셋(Bitset)으로 메타데이터 검사 ──> 유효 노드만 탐색
   * 장점: HNSW 그래프의 연결성을 유지하면서도 정확한 Top-k 수렴 보장 (현대 표준).
현대 고성능 엔진(Milvus, Qdrant)은 Roaring Bitmap을 활용하여 쿼리 시작 시 필터 조건을 만족하는 문서 ID 집합을 비트셋으로 생성한 후, HNSW 탐색 과정에서 비트 연산으로 유효성을 실시간 판정하는 Single-stage Iterative Filtering 방식을 채택한다.
3. 하이브리드 검색과 순위 융합: Dense + Sparse
밀집 임베딩(Dense Vector)은 의미적 맥락(Semantic Similarity)을 훌륭히 포착하지만, 고유명사, 제품 품번, 전문 약어와 같은 정확한 키워드 매칭(Lexical Match)에서는 오답을 낼 위험이 있다. 이를 해결하기 위해 전통적인 역색인 기반 BM25(또는 학습 기반 Sparse 임베딩인 SPLADE)와 Dense 벡터를 결합하는 하이브리드 검색(Hybrid Search)이 프로덕션 표준으로 채택된다.
두 이종 검색 결과 점수의 스케일이 상이하므로, 단순 가중치 합산 대신 순위 기반 융합 알고리즘인 RRF(Reciprocal Rank Fusion)를 적용한다.
\[RRF(d) = \sum_{m \in M} \frac{1}{k + r_m(d)}\]여기서 $r_m(d)$는 검색 시스템 $m$에서의 문서 $d$의 순위(1부터 시작)이며, $k$는 극단적인 최상위 순위의 독점을 완화하는 스무딩 상수(통상 $k=60$)다. RRF는 점수 정규화(Normalization) 과정 없이도 안정적으로 결합 순위를 산출하며, 이후 Cross-Encoder 기반의 Reranker 모델로 최종 Top-$N$을 선별한다.
4. 주요 프로덕션 벡터 데이터베이스 아키텍처 비교
프로덕션 엔진별 아키텍처 매트릭스:
┌──────────────┬──────────────────┬──────────────────────────┬──────────────────┬────────────────────────────┐
│ 엔진         │ 구현 언어        │ 스토리지 아키텍처        │ 메타데이터 처리  │ 최적 프로덕션 시나리오     │
├──────────────┼──────────────────┼──────────────────────────┼──────────────────┼────────────────────────────┤
│ Pinecone     │ Rust/C++         │ 서버리스 스토리지 분리   │ 단일 단계 통합   │ 인프라 관리 없는 클라우드  │
│ Milvus       │ Go/C++           │ 컴퓨트-스토리지 분리(K8s)│ 분산 세그먼트    │ 1억 건 이상 초대형 분산 RAG│
│ Qdrant       │ Rust             │ 세그먼트 기반 로컬/분산  │ 페이로드 페이징  │ 메모리 효율, 필터링 위주   │
│ pgvector     │ C (Postgres ext) │ PostgreSQL MVCC 힙 테이블│ RDBMS SQL 네이티브│ 기존 PG 기반 단일 스택     │
└──────────────┴──────────────────┴──────────────────────────┴──────────────────┴────────────────────────────┘
- Pinecone:
- 인덱스 노드와 저장 계층을 완전히 분리한 클라우드 네이티브 서버리스 아키텍처를 제공한다.
- 데이터 용량에 따라 인덱스가 자동 스케일링되며 인프라 운영 오버헤드가 제로에 가깝지만, 온프레미스 배포가 불가능하고 벤더 락인이 발생한다.
- Milvus:
- etcd(메타데이터), Apache Pulsar/Kafka(로그 브로커), MinIO/S3(오브젝트 스토리지)를 결합한 마이크로서비스 기반 분산 아키텍처다2.
- 쿼리 노드(Query Node), 인덱스 노드(Index Node), 데이터 노드(Data Node)가 철저히 분리되어 있어 페타바이트급 데이터에서 독립적인 수평 확장이 가능하다.
- Qdrant:
- Rust로 개발되어 메모리 안전성과 CPU 효율을 겨냥한다.
- Payload(메타데이터) 기반 필터링 처리가 빠르고, 메모리 맵(mmap) 파일을 지원하여 RAM 비용을 절감할 수 있다3.
- pgvector:
- PostgreSQL 엔진 내부에서
vector컬럼 타입과 HNSW/IVFFlat 인덱스를 제공한다. - ACID 트랜잭션, 조인(JOIN), 기존 관계형 테이블과의 원자적 트랜잭션 처리가 단일 DB에서 완결되므로, 100만 건 이하의 중소규모 워크로드에서 파이프라인 복잡도를 낮추는 현실적인 선택이다. (단, 이 규모 가정은 단일 PostgreSQL 노드 기준이며, 데이터가 수천만 건을 넘으면 별도 벡터 엔진 도입을 검토하는 편이 낫다.)
- PostgreSQL 엔진 내부에서
5. 결론: 워크로드별 기술 스택 선정 가이드
벡터 검색 시스템 구축 시 엔지니어링 의사결정 트리는 다음과 같이 요약할 수 있다4.
- 데이터 규모 < 100만 건, 기존 PostgreSQL 인프라 존재:
- 별도의 전용 벡터 DB를 도입하지 말고
pgvector(HNSW 인덱스 모드)를 우선 도입하여 운영 복잡도를 최소화하라.
- 별도의 전용 벡터 DB를 도입하지 말고
- 복잡한 메타데이터 필터링 + 단일/소형 클러스터 운영 효율:
- Rust 기반의 Qdrant를 온프레미스 또는 관리형으로 도입하여 메모리 점유 대비 처리량을 극대화하라.
- 수천만 ~ 수억 건 이상의 초대규모 분산 환경:
- 컴퓨트와 스토리지가 분리된 Milvus 분산 클러스터를 쿠버네티스(K8s) 상에 배포하고, IVF-PQ 또는 DiskANN 기반 스토리지를 구성하라.
- 검색 품질 최적화:
- 단일 Dense 벡터 검색에만 의존하지 말고, Dense + BM25 하이브리드 검색에 RRF 순위 융합 및 Cross-Encoder Reranker를 파이프라인 후단에 필수 배치하라.
댓글남기기