
[Hadoop] 아파치 얀(YARN)에 대한 기초
 [Hadoop The Definitive Guide: Storage And Analysis At Internet Scale] 책을 중심으로 하둡을 개인 공부를 위해 요약 및 정리해보았습니다. 다소 복잡한 설치 과정은 도커에 미리 이미지를 업로드해 놓았습니다. 즉, 도커 이미지를 pull하면 바로 하둡을 사용할 수 있습니다.
도커 이미지 링크 : https://hub.docker.com/r/ingu627/hadoop
아파치 YARN은 하둡의 클러스터 자원 관리 시스템으로, 클러스터의 자원을 요청하고 사용하기 위한 API를 제공한다. 이 글은 YARN의 애플리케이션 수행 구조를 살펴보고, 자원 요청과 지역성, 그리고 캐퍼시티·페어 스케줄러와 지연 스케줄링을 정리한다.
1. YARN 개요
- 아파치 YARN(Yet Another Resource Negotiator)은 하둡의 클러스터 자원 관리 시스템이다.
- YARN은 하둡 2에서 처음 도입되었으며, 맵리듀스뿐만 아니라 다른 분산 컴퓨팅 도구도 지원한다.
-
도입 배경은 하둡 1 설계의 두 가지 한계다. 맵리듀스라는 특정 프로그래밍 모델이 자원 관리 인프라와 강하게 결합되어 있어 개발자가 맵리듀스 모델을 우회적으로 쓰게 되었고, 잡의 제어 흐름을 중앙에서 처리하면서 스케줄러 확장성 문제가 계속 따라붙었다. 1
- YARN은 클러스터의 자원을 요청하고 사용하기 위한 API를 제공한다.
- 하지만 사용자 코드에서 직접 이러한 API를 사용할 수는 없다.
- 대신 사용자는 YARN이 내장된 분산 컴퓨팅 프레임워크에서 고수준 API를 작성해야 하며, 따라서 사용자는 자원 관리의 자세한 내용은 알 수 없다.

2. YARN 애플리케이션 수행 해부해보기
- YARN은 리소스 매니저와 노드 매니저 등 2가지 유형의 장기 실행 데몬을 통해 핵심 서비스를 제공한다.
- 클러스터에서 유일한 리소스 매니저(resource manager)는 클러스터 전체 자원의 사용량을 관리하고, 모든 머신에서 실행되는 노드 매니저(node manager)는 컨테이너를 구동하고 모니터링하는 역할을 맡는다.
- 리소스(메모리, CPU 등)의 사용 한도를 가진 특정 애플리케이션 프로세스는 컨테이너에서 실행된다.
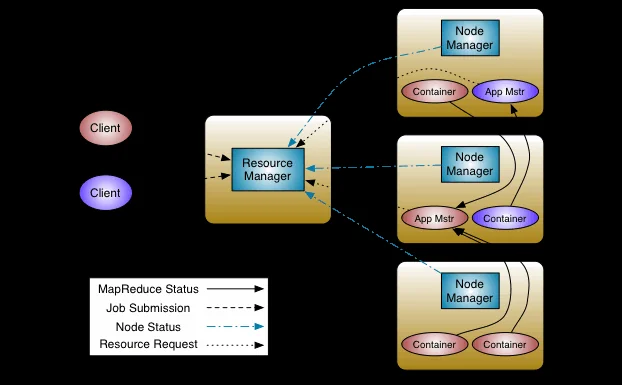
출처: Apache Hadoop YARN — Architecture (https://hadoop.apache.org/docs/stable/hadoop-yarn/hadoop-yarn-site/YARN.html), Apache License 2.0
- Fig 4.2는 YARN이 애플리케이션을 실행하는 방법을 보여준다.

- 클라이언트는 YARN에서 애플리케이션을 구동하기 위해 리소스 매니저에 접속하여 애플리케이션 마스터 프로세스의 구동을 요청한다. (1번 단계)
- 리소스 매니저는 컨테이너에서 애플리케이션 마스터를 시작할 수 있는 노드 매니저를 하나 찾는다. (2a와 2b번 단계)
- 애플리케이션 마스터가 단순한 계산을 단일 컨테이너에서 수행하고 그 결과를 클라이언트에 반환한 후 종료되거나, 리소스 매니저에 더 많은 컨테이너를 요청(3단계)한 후 분산 처리를 수행(4a와 4b번 단계)하는 경우도 있다.
- 4번 단계는 맵리듀스 YARN 애플리케이션이 수행하는 방법이다.
- 대부분의 주요 YARN 애플리케이션은 하둡의 RPC와 같은 원격 호출 방식을 이용하여 상태 변경을 전달하고 클라이언트로부터 결과를 받는다.
2.1 자원 요청
- YARN은 유연한 자원 요청 모델을 갖고 있다.
- 다수의 컨테이너를 요청할 때는 각 컨테이너에 필요한 컴퓨터 자원(메모리, CPU)의 용량뿐만 아니라 해당 요청에 대한 컨테이너의 지역성 제약도 표현할 수 있다.
- 분산 데이터 처리 알고리즘에서 클러스터의 네트워크 대역폭을 효율적으로 활용하기 위해서는 지역성(locality)을 보장하는 것이 가장 중요하다.
- 따라서 YARN은 특정 애플리케이션이 호출한 컨테이너에 대해 지역성 제약을 규정하는 것을 허용한다.
- 지역성 제약은 특정 노드나 랙(rack) 또는 클러스터의 다른 곳(외부 랙)에서 컨테이너를 요청할 때 사용된다.
- YARN 애플리케이션은 실행 중에는 아무 때나 자원 요청을 할 수 있다.
맵리듀스는 사용자의 잡(job) 당 하나의 애플리케이션이 실행되는 방식이다. 스파크는 워크플로나 사용자의 잡 세션 당 하나의 애플리케이션이 실행되는 방식이다.
3. YARN 스케줄링
- 현실 세계에서는 자원이 제한되어 있고 클러스터는 매우 바쁘고 어떤 애플리케이션은 요청이 처리될 때까지 기다려야 한다.
- YARN 스케줄러의 역할은 정해진 정책에 따라 애플리케이션에 자원을 할당하는 것이다.
- 일반적으로 스케줄링은 난해한 문제고 유일한 최선의 정책은 없기 때문에, 스케줄러와 설정 정책을 사용자가 직접 선택하도록 기능을 제공하고 있다.
3.1 스케줄러 옵션
- YARN은 FIFO, Capacity, Fair 스케줄러를 제공한다.
- FIFO 스케줄러는 애플리케이션을 큐에 하나씩 넣고 제출된 순서에 따라 순차적으로 실행한다.
- 하지만 FIFO는 공유 클러스터 환경에서는 적합하지 않다.
- 따라서 공유 클러스터 환경에서는 캐퍼시티(capacity)나 페어(fair) 스케줄러를 사용하는 것이 더 좋다.
- 이 두 스케줄러는 장시간 수행되는 잡을 계속 처리하는 동시에 작은 비정형 질의도 중간에 실행하여 적당한 시간 내에 사용자가 결과를 얻을 수 있도록 허용한다.

- 위의 그림에서 볼 수 있듯이, 캐퍼시티 스케줄러는 작은 잡을 제출되는 즉시 분리된 전용 큐에서 처리해준다.
- 또한 페어 스케줄러는 실행 중인 모든 잡의 자원을 동적으로 분배하기 때문에 미리 자원의 가용량을 예약할 필요가 없다.
- 대형 잡이 먼저 시작되면 이때는 실행 중인 잡이 하나밖에 없기 때문에 클러스터의 모든 자원을 얻을 수 있다.
- 대형 잡이 실행되는 도중에 작은 잡이 추가로 시작되면 페어 스케줄러는 클러스터 자원의 절반을 이 잡에 할당한다.
- 따라서 각 잡은 클러스터의 자원을 공평하게 사용할 수 있게 된다.
3.2 캐퍼시티 스케줄러 설정
- 캐퍼시티(capacity) 스케줄러를 이용하면 회사의 조직 체계에 맞게 하둡 클러스터를 공유할 수 있다.
- 각 조직은 전체 클러스터의 지정된 가용량을 미리 할당받는다.
-
각 조직은 분리된 전용 큐를 가지며 클러스터 가용량의 지정된 부분을 사용하도록 설정할 수 있다.
- Fig 4.3에서 보았듯이, 하나의 단일 잡은 해당 큐의 가용량을 넘는 자원은 사용할 수 없다.
- 그러나 큐 안에 다수의 잡이 존재하고 현재 가용할 수 있는 자원이 클러스터에 남아 있다면 캐퍼시티 스케줄러는 해당 큐에 있는 잡을 위해 여분의 자원을 할당할 수 있다.
-
물론 이렇게 하면 큐의 가용량을 초과하게 되는데, 이런 방식을 큐 탄력성(queue elasticity)이라고 한다.
- 큐의 계층 구조가 아래와 같다고 가정한다.

- 아래는 이러한 계층 구조를 가진
capacity-scheduler.xml이라는 캐퍼시티 스케줄러 설정 파일의 예다. 2
<?xml version="1.0"?>
<configuration>
  <property>
    <name>yarn.scheduler.capacity.root.queues</name>
    <value>prod,dev</value>
  </property>
  <property>
    <name>yarn.scheduler.capacity.root.dev.queues</name>
    <value>eng,science</value>
  </property>
  <property>
    <name>yarn.scheduler.capacity.root.prod.capacity</name>
    <value>40</value>
  </property>
  <property>
    <name>yarn.scheduler.capacity.root.dev.capacity</name>
    <value>60</value>
  </property>
  <property>
    <name>yarn.scheduler.capacity.root.dev.maximum-capacity</name>
    <value>75</value>
  </property>
  <property>
    <name>yarn.scheduler.capacity.root.dev.eng.capacity</name>
    <value>50</value>
  </property>
  <property>
    <name>yarn.scheduler.capacity.root.dev.science.capacity</name>
    <value>50</value>
  </property>
</configuration>
3.3 페어 스케줄러 설정
- 페어 스케줄러(fair scheduler)는 실행 중인 모든 애플리케이션에 동일하게 자원을 할당한다.
- Fig 4-3은 동일한 큐에 있는 애플리케이션에 공평하게 자원을 할당하는 방법을 보여주고 있다.
- 하지만 페어 공유는 큐 사이에만 실제로 적용된다.

페어 스케줄러 활성화
- 사용할 스케줄러는 yarn.resourcemanager.scheduler.class 속성에 설정한다.
- 기본 스케줄러는 캐퍼시티 스케줄러지만 원하는 스케줄러를 지정하고 싶으면
yarn-site.xml파일의 yarn.resourcemanager.scheduler.class 속성에 스케줄러의 전체 클래스 이름을 org.apache.hadoop.yarn.server.resourcemanager.scheduler.fair.FairScheduler와 같이 지정하면 된다.
큐 설정
- 페어 스케줄러는 클래스 경로에 있는
fair-scheduler.xml이라는 할당 파일에 원하는 속성을 설정한다. - 할당 파일의 이름은 yarn.scheduler.fair.allocation.file 속성을 지정하여 변경할 수 있다.
<?xml version="1.0"?>
<allocations>
  <defaultQueueSchedulingPolicy>fair</defaultQueueSchedulingPolicy>

  <queue name="prod">
    <weight>40</weight>
    <schedulingPolicy>fifo</schedulingPolicy>
  </queue>

  <queue name="dev">
    <weight>60</weight>
    <queue name="eng" />
    <queue name="science" />
  </queue>

  <queuePlacementPolicy>
    <rule name="specified" create="false" />
    <rule name="primaryGroup" create="false" />
    <rule name="default" queue="dev.eng" />
  </queuePlacementPolicy>
</allocations>
선점 (preemption)
- 바쁘게 돌아가는 클러스터에서는 빈 큐에 잡이 제출되더라도 클러스터에서 이미 실행되고 있는 다른 잡이 자원을 해제해주기 전까지 잡을 시작할 수 없다.
- 잡의 시작 시간을 어느 정도 예측 가능하게 만들기 위해 페어 스케줄러는 선점(preemption)이라는 기능을 제공한다.
- 선점은 스케줄러가 자원의 페어 공유에 위배되는 큐에서 실행되는 컨테이너를 죽일 수 있도록 허용하는 기능으로, 큐에 할당된 자원은 페어 공유 기준을 반드시 따라야 한다.
- 중단된 컨테이너는 반드시 다시 수행되어야 하므로 클러스터의 전체 효율은 떨어지게 된다는 점을 유의해야 한다.
- 선점은
yarn.scheduler.fair.preemption속성을 true로 설정하여 전체적으로 활성화시킬 수 있다. - 최소 공유와 페어 공유 등 2개의 선점 타임아웃 설정이 있다.
- 큐의 최소 보장 자원을 받지 못한 채 지정된 최소 공유 선점 타임아웃(minimum share preemption timeout)이 지나면 스케줄러는 다른 컨테이너를 선취할 수 있다.
- 큐가 페어 공유의 절반 이하로 있는 시간이 페어 공유 선점 타임아웃(fair share preemption timeout)을 초과하면 스케줄러는 다른 컨테이너를 선취할 수 있다.
3.4 지연 스케줄링 (delay scheduling)
- YARN의 모든 스케줄러는 지역성(locality) 요청을 가장 우선시한다.
- 바쁜 클러스터에서 어떤 애플리케이션이 특정 노드를 요청하면 요청하는 시점에 그 노드에 다른 컨테이너가 실행되고 있을 가능성이 높다.
- 이런 상황에서는 지역성 요구 수준을 조금 낮춘 후 동일한 랙에 컨테이너를 할당하는 방법도 있다.
- 페이스북의 600노드 하둡 클러스터에서 페어 스케줄러를 설계한 경험을 다룬 연구에서는, 지역성을 얻으려면 잠깐 기다리는 편이 훨씬 유리하다는 관찰을 바탕으로 지연 스케줄링(delay scheduling)이 제안되었다. 다음 순서의 잡이 로컬 태스크를 띄우지 못하면 짧은 시간만 기다렸다가 다른 잡을 먼저 실행시키는 방식이다. 3
- 해당 연구가 보고한 결과는 여러 워크로드에서의 거의 최적에 가까운 데이터 지역성, 그리고 공정성을 유지한 채 최대 2배까지 오르는 처리량이다(측정 환경과 워크로드는 원문 참조). 대가는 그만큼 잡 시작이 늦어진다는 점이다.
캐퍼시티 스케줄러와 페어 스케줄러는 모두 이러한 기능을 제공하고 있다.
- YARN의 모든 노드 매니저는 주기적(default:1초)으로 리소스 매니저에 하트비트(heartbeat) 요청을 보낸다.
- 하트비트를 통해 노드 매니저가 실행 중인 컨테이너의 정보와 새로운 컨테이너를 위한 가용한 자원에 대한 정보를 주고받는다.
-
따라서 각 하트비트는 애플리케이션이 실행할 컨테이너를 얻을 수 있는 중요한 스케줄링 기회가 된다.
- 지연 스케줄링을 사용할 때 스케줄러는 처음 오는 스케줄링 기회를 바로 사용하지는 않는다. 대신 지역성 제약 수준을 낮추기 전에 허용하는 스케줄링 기회의 최대 횟수까지 기다린 후 그 다음에 오는 스케줄링 기회를 잡는다.
댓글남기기