
운영체제(OS) - Deadlocks (6)
본 글은 (KOCW) 운영체제, 이화여자대학교 반효경 교수님의 강의를 듣고 내용을 요약 및 정리했습니다. 개인 공부에 목적이 있으며, 자세한 사항은 http://www.kocw.or.kr/home/cview.do?mty=p&kemId=1046323에 참고하시면 됩니다.
Chapter 7.
- Deadlocks 1 - 40분
- Deadlocks 2 - 37분
교착상태(deadlock)는 일련의 프로세스들이 서로가 가진 자원을 기다리며 block된 상태다. 이 글은 deadlock 발생의 4가지 조건과 resource-allocation graph, 그리고 prevention·avoidance·detection & recovery·ignorance 등 deadlock 처리 방법을 정리한다.
이 글에서 다루는 것
- Deadlock이 발생하기 위한 4가지 필요 조건을 살핀다.
- Resource-Allocation Graph로 자원 할당 관계와 cycle을 읽는다.
- Prevention·Avoidance·Detection and recovery·Ignorance 네 가지 처리 방법을 비교한다.


- 교착상태(deadlock) : 일련의 프로세스들이 서로가 가진 자원을 기다리면 block된 상태
- Resource (자원)
- 하드웨어, 소프트웨어 등을 포함하는 개념
- ex. I/O device, CPU cycle, memory space, semaphore 등
- 프로세스가 자원을 사용하는 절차
- Request, Allocate, Use, Release

Deadlock 발생의 4가지 조건
교착상태가 성립하려면 아래 네 조건이 동시에 만족되어야 한다 — 이 중 하나라도 깨뜨리면 deadlock을 막을 수 있다.
- Mutual exclusion (상호 배제)
- 매 순간 하나의 프로세스만이 자원을 사용할 수 있음
- No preemption (비선점)
- 프로세스는 자원을 스스로 내어놓을 뿐 강제로 빼앗기지 않음
- Hold and wait (보유대기)
- 자원을 가진 프로세스가 다른 자원을 기다릴 때 보유 자원을 놓지 않고 계속 가지고 있음
- Circular wait (순환대기)
- 자원을 기다리는 프로세스 간에 사이클이 형성되어야 함
- 프로세스 $P_0, P_1, …, P_n$이 있을 때
- $P_0$은 $P_1$이 가진 자원을 기다림
- $P_1$은 $P_2$이 가진 자원을 기다림
- $P_{n-1}$은 $P_n$이 가진 자원을 기다림
- $P_n$은 $P_0$이 가진 자원을 기다림
정리하면, 교착상태는 mutual exclusion·no preemption·hold and wait·circular wait 네 조건이 동시에 성립할 때 발생한다.
Resource-Allocation Graph 1
앞의 네 조건이 실제 자원 할당 관계에서 어떻게 드러나는지 그래프로 살펴본다.
- 자원할당그래프

Resource-Allocation Graph 2
그래프의 cycle과 deadlock의 관계를 정리한다.

- 점은 자원
- 그래프에 cycle이 없으면 deadlock이 아니다.
- 그래프에 cycle이 있으면
- 자원당 인스턴스가 하나씩 있으면 데드락을 의미
- 자원의 인스턴스가 여러 개 있을 때, 데드락일 수 있고 아닐 수 있다.1
주의: cycle이 있다고 해서 항상 deadlock인 것은 아니다 — 인스턴스가 여러 개면 deadlock이 아닐 수도 있다.
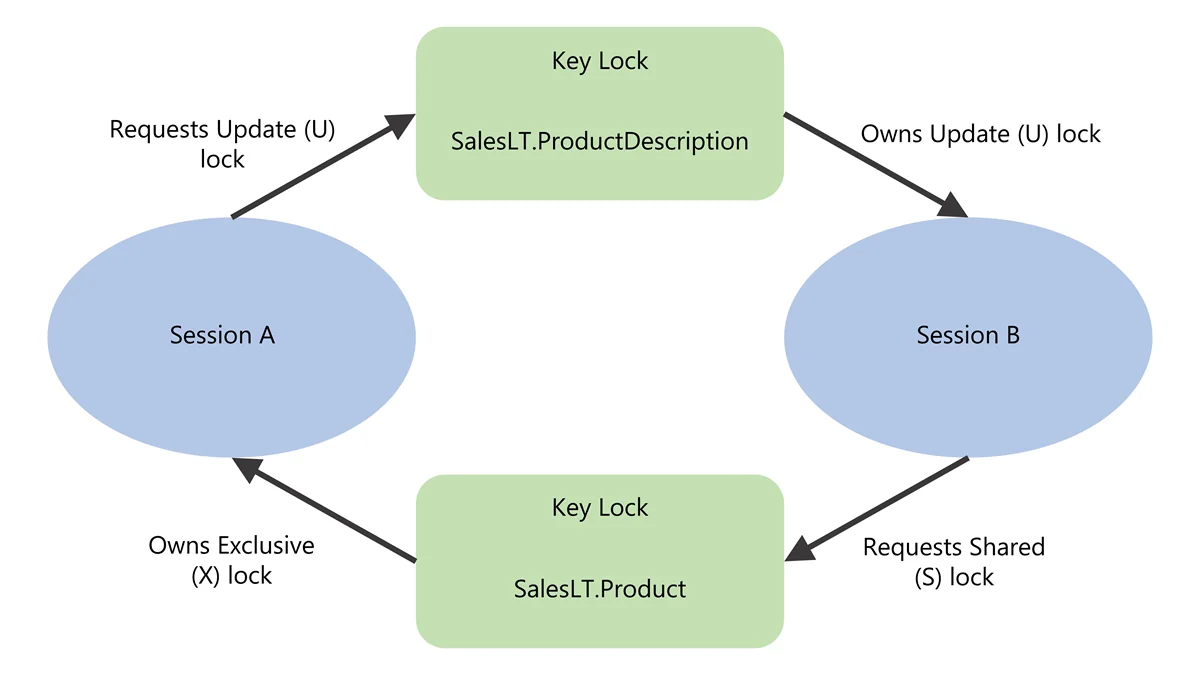
출처: Analyze and prevent deadlocks — Azure SQL Database, Microsoft Learn (https://learn.microsoft.com/en-us/azure/azure-sql/database/analyze-prevent-deadlocks), CC BY 4.0
Deadlock의 처리 방법
Deadlock을 다루는 방법은 크게 네 갈래다 — 조건 자체를 막는 prevention, 위험을 피해 가는 avoidance, 발생 후 복구하는 detection and recovery, 그리고 아무것도 하지 않는 ignorance다.
- Deadlock Prevention
- 자원 할당 시 Deadlock의 4가지 필요 조건 중 어느 하나가 만족되지 않도록 하는 것
- Deadlock Avoidance
- 자원 요청에 대한 부가적인 정보를 이용해서 deadlock의 가능성이 없는 경우에만 자원을 할당
- 시스템 state가 원래 state로 돌아올 수 있는 경우에만 자원 할당
- Deadlock Detection and recovery
- Deadlock 발생은 허용하되 그에 대한 detection 루틴을 두어 deadlock 발견시 recover
- Deadlock Ignorance
- Deadlock을 시스템이 책임지지 않음
- UNIX를 포함한 대부분의 OS가 채택
막을 것인가, 피할 것인가, 감수할 것인가 — 아래에서 각 방법을 자세히 본다.
Deadlock Prevention
Prevention은 4가지 필요 조건 중 어느 하나가 애초에 만족되지 않도록 구조를 바꾸는 방식이다.
- Mutual Exclusion
- 공유해서는 안되는 자원의 경우 반드시 성립해야 함
- Hold and Wait
- 프로세스가 자원을 요청할 때 다른 어떤 자원도 가지고 있지 않아야 한다.
- 방법 1. 프로세스 시작 시 모든 필요한 자원을 할당받게 하는 방법
- 방법 2. 자원이 필요할 경우 보유 자원을 모두 놓고 다시 요청
- No Preemption
- process가 어떤 자원을 기다려야 하는 경우 이미 보유한 자원이 선점됨
- 모든 필요한 자원을 얻을 수 있을 때 그 프로세스는 다시 시작된다.
- State를 쉽게 save하고 restore할 수 있는 자원에서 주로 사용 (CPU, memory)
- Circular Wait
- 모든 자원 유형에 할당 순서를 정하여 정해진 순서대로만 자원 할당
- ex. 순서가 3인 자원 $R_i$를 보유 중인 프로세스가 순서가 1인 자원 $R_j$을 할당받기 위해서는 우선 $R_i$를 release해야 한다.
-> Utilization 저하, throughput 감소, starvation 문제가 따른다.
결국 교착상태를 막을수록 자원 활용도가 떨어진다 — prevention이 조건 자체를 없애는 방법이라면, avoidance는 조건을 둔 채 위험을 피한다.
Deadlock Avoidance
Avoidance는 조건을 막는 대신, 자원 할당 시점마다 deadlock 가능성을 동적으로 따져 안전한 경우에만 할당한다.
- Deadlock avoidance
- 자원 요청에 대한 부가정보를 이용해서 자원 할당이 deadlock으로부터 안전(safe)한지를 동적으로 조사해서 안전한 경우에만 할당
- 가장 단순하고 일반적인 모델은 프로세스들이 필요로 하는 각 자원별 최대 사용량을 미리 선언하도록 하는 방법임
- safe state
- 시스템 내의 프로세스들에 대한
safe sequence가 존재하는 상태
- 시스템 내의 프로세스들에 대한
- safe sequence
- 프로세스의 sequence $<P_1, P_2, …, P_n>$이 safe 하려면 $P_i(1\le i \le n)$의 자원 요청이 “가용 자원 + 모든 $P_j (j < i)$의 보유 자원”에 의해 충족되어야 함
- 조건을 만족하면 다음 방법으로 모든 프로세스의 수행을 보장
- $P_i$의 자원 요청이 즉시 충족될 수 없으면 모든 $P_j(i < j)$가 종료될 때까지 기다린다.
- $P_{i-1}$이 종료되면 $P_i$의 자원요청을 만족시켜 수행한다.
- 시스템이 safe state에 있으면 no deadlock
- 시스템이 unsafe state에 있으면 possibility of deadlock
- Deadlock Avoidance
- 시스템이 unsafe state에 들어가지 않는 것을 보장
- 2가지 경우의 avoidance 알고리즘
- Single instance per resource types : Resource Allocation Graph algorithm 사용
- Multiple instances per resource types : Banker’s Algorithm 사용
Resource Allocation Graph algorithm

Banker’s Algorithm
Banker’s Algorithm은 multiple instance 상황에서 avoidance를 구현하는 대표적인 방법이다.
- 가정
- 모든 프로세스는 자원의 최대 사용량을 미리 명시
- 프로세스가 요청 자원을 모두 할당받은 경우 유한 시간 안에 이들 자원을 다시 반납한다.
주의: 모든 프로세스가 최대 사용량을 미리 알 수 없으면 이 알고리즘은 적용할 수 없다.
- 방법
- 기본 개념: 자원 요청 시 safe 상태를 유지할 경우에만 할당
- 총 요청 자원의 수가 가용 자원의 수보다 적은 프로세스를 선택 (그런 프로세스가 없으면 unsafe 상태)
- 그런 프로세스가 있으면 그 프로세스에게 자원을 할당
- 할당받은 프로세스가 종료되면 모든 자원을 반납
- 모든 프로세스가 종료될 때까지 이러한 과정 반복
정리하면, Banker’s Algorithm은 가용 자원만으로 끝낼 수 있는 프로세스를 골라 자원을 할당하는 과정을 반복해 시스템을 safe 상태로 유지한다.
safe 상태 여부를 판정하는 데는 최악의 경우 $O(m \times n^2)$번의 연산이 필요하다. 여기서 $n$은 프로세스 수, $m$은 자원 종류 수다.2
- Ex.

- Allocation : 할당
- Max : 최대
- Available : 가용
- Need : 요구
여기까지가 사전에 막거나 피하는 방법이었다면, 다음은 발생을 전제로 한 대응이다.
Deadlock Detection and Recovery
Detection은 deadlock 발생을 허용하되 주기적으로 탐지하고, 발견되면 복구하는 방식이다.
- Deadlock Detection
- Resource type 당 single instance인 경우
- 자원할당 그래프에서의 cycle이 곧 deadlock을 의미
- Resource type 당 multiple instance인 경우
- Banker’s algorithm과 유사한 방법 활용
- Resource type 당 single instance인 경우
- Wait-for graph 알고리즘
- Resource type 당 single instance인 경우
- Wait-for graph
- 자원할당 그래프의 변형
- 프로세스만으로 node 구성
- $P_j$가 가지고 있는 자원을 $P_k$가 기다리는 경우 $P_k \rightarrow P_j$
- Algorithm
- Wait-for graph에 사이클이 존재하는지를 주기적으로 조사
- $O(n^2)$
탐지 주기는 오버헤드와 회복 지연 사이의 맞바꿈이므로, 실제 시스템은 부하에 따라 주기를 조정한다. 예를 들어 SQL Server 데이터베이스 엔진의 lock monitor는 기본 5초 간격으로 교착 상태를 탐색하다가, 교착이 자주 발생하면 간격을 100ms까지 줄여 탐지를 앞당긴다.3

-
위 상황은 자원의 최대 사용량을 미리 알릴 필요 없음 -> 그래프에 점선이 없음
- Resource type 당 multiple instance인 경우

Request는 추가요청가능량이 아니라 현재 실제로 요청한 자원량을 나타냄
- Recovery
- Process termination
- 데드락에 연루된 모든 프로세스를 죽인다.
- 데드락에 연루된 프로세스를 하나씩 죽여본다. (데드락이 없어질 때까지)
- Resource Preemption
- 비용을 최소화할 victim의 선정
- safe state로 rollback하여 process를 restart
- Starvation 문제
- 동일한 프로세스가 계속해서 victim으로 선정되는 경우
- cost factor에 rollback 횟수도 같이 고려
- Process termination
결국 누구를 희생시킬지의 싸움이다.
Deadlock Ignorance
Ignorance는 deadlock이 매우 드물게 발생한다는 전제 아래 아무런 조치도 취하지 않는 방식이다.
- Deadlock이 일어나지 않는다고 생각하고 아무런 조치도 취하지 않음
- Deadlock이 매우 드물게 발생하므로 deadlock에 대한 조치 자체가 더 큰 overhead일 수 있음
- 만약, 시스템에 deadlock이 발생한 경우 시스템이 비정상적으로 작동하는 것을 사람이 느낀 후 직접 process를 죽이는 등의 방법으로 대처
- UNIX, Windows 등 대부분의 범용 OS가 채택
처리 방법별 한계
- Prevention은 네 조건 중 하나를 구조적으로 깨뜨리는 대신 자원 이용률(utilization) 저하와 throughput 감소, starvation을 수반한다.
- Avoidance(Banker’s Algorithm)는 모든 프로세스가 자원별 최대 사용량을 사전에 선언해야 하므로, 최대 사용량을 알 수 없거나 프로세스·자원 종류가 많은 범용 시스템에서는 그대로 적용하기 어렵다.
- Detection and recovery는 탐지 주기를 짧게 잡으면 탐지 오버헤드가, 길게 잡으면 회복 지연이 커지는 맞바꿈이 있다.
- 이 비용에 비해 deadlock 발생 빈도가 낮다는 판단 아래, UNIX·Windows 등 대부분의 범용 OS는 Ignorance를 택한다.
핵심 정리
- 교착상태의 정의. 일련의 프로세스들이 서로가 가진 자원을 기다리며 block된 상태다.
- 발생 조건 4가지. Mutual exclusion, No preemption, Hold and wait, Circular wait가 모두 성립해야 한다.
- 처리 방법 4가지. Prevention, Avoidance, Detection and recovery, Ignorance로 접근한다.
- safe state. 시스템이 safe state면 no deadlock, unsafe state면 possibility of deadlock이다.
- 실무의 선택. UNIX, Windows 등 대부분의 범용 OS는 Deadlock Ignorance를 채택한다.
댓글남기기