
운영체제(OS) - Memory Management (7)
본 글은 (KOCW) 운영체제, 이화여자대학교 반효경 교수님의 강의를 듣고 내용을 요약 및 정리했습니다. 개인 공부에 목적이 있으며, 자세한 사항은 http://www.kocw.or.kr/home/cview.do?mty=p&kemId=1046323에 참고하시면 됩니다.
Chapter 8.
- Memory Management 1 - 1시간 6분
- Memory Management 2 - 48분
- Memory Management 3 - 39분
- Memory Management 4 - 27분
(+) 인프런의 주니온 박사님의 운영체제 공룡책 강의를 듣고 내용을 보충했습니다. 자세한 사항은 여기를 참고하시면 됩니다.


이 글은 운영체제의 메모리 관리(Memory Management)를 다룬다. 논리적 주소와 물리적 주소, 주소 바인딩, MMU를 시작으로 물리 메모리 할당, 페이징, 세그멘테이션까지 메모리 관리의 핵심 개념을 정리한다.
이 글에서 다루는 것
- 메모리가 주소를 통해 접근되는 구조를 살펴본다.
- 논리적 주소와 물리적 주소, 그리고 주소 바인딩 시점을 구분한다.
- MMU가 주소를 변환하는 방식과 관련 용어를 정리한다.
- 연속 할당과 비연속 할당(페이징·세그멘테이션)을 비교한다.
- 다단계 페이지 테이블과 세그멘테이션 구조를 살펴본다.
Memory
메모리는 각 바이트마다 고유한 주소를 가진 배열이고, CPU는 그 주소를 통해 접근한다.
Memory는 주소를 통해 접근하는 매체이다.-
메모리는 각 고유의 주소를 가진 대량의 바이트 배열로 구성되어 있다.
A memory consists of a large array of bytes, each with its own address. each process has a separate memory space.
- CPU는 프로그램 카운터를 사용해 메모리에서 명령을 가져오고, 그 명령은 메모리에서의 로드(load)나 메모리로의 저장(store)을 일으킨다.

- 레지스터 쌍은 base 레지스터와 limit 레지스터로 되어 있다.
- legal address 의 범위를 결정할 수 있는 기능을 제공한다.
Logical vs Physical Address
프로그램이 보는 주소와 메모리에 실제 올라가는 주소는 다르다 — 이 둘을 구분하는 것이 메모리 관리의 출발점이다.
- 데이터는 메모리에 있어야만 CPU가 접근 가능하다.
- Logical address (=virtual address; VA)
- 프로세스마다 독립적으로 가지는 주소 공간 1
- 각 프로세스마다 0번지부터 시작
- CPU(processor)가 보는 주소는
logical address임 - 프로그램을 짤 때 나오는 모든 주소는 logical address
- Physical address (PA)
- 메모리에 실제 올라가는 위치
- 메모리는 physical address밖에 접근을 못한다.
- 주소 바인딩 (address binding) : 주소를 결정하는 것
- Symbolic Address -> Logical Address ->(이 시점이 언제인가?) Physical address
- 메모리 관리는 전부 하드웨어가 해주는 것이다.
결국 주소 변환은 소프트웨어가 아니라 하드웨어의 몫이다.
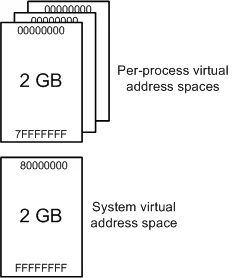
출처: Virtual Address Spaces (Microsoft Learn, Windows drivers) (https://learn.microsoft.com/en-us/windows-hardware/drivers/gettingstarted/virtual-address-spaces), CC BY 4.0
이 구분을 알았으니, 다음은 이 두 주소가 언제 결정되는지다.
주소 바인딩 (Address Binding)
주소 바인딩은 프로그램의 주소가 언제 물리 주소로 확정되는지를 다루는 문제다 — 그 시점에 따라 세 가지로 나뉜다.
A program resides on a disk as a binary executable file. A compiler typically binds symbolic addresses to relocatable addresses. A linker or loader in turn binds the relocatable addresses to absolute addresses.

- Compile time binding
- 물리적 메모리 주소(physical)가 컴파일 시 알려져 있다.
- 시작 위치 변경시 재컴파일
- 컴파일러는 절대 코드(absolute code) 생성
- Load time binding
- Loader의 책임하에 물리적 메모리 주소 부여
- 컴파일러가 재배치가능코드(relocatable code)를 생성한 경우 가능
- Execution time binding (=Run time binding)
- 수행이 시작된 이후에도 프로세스의 메모리 상 위치를 옮길 수 있다.
- CPU가 주소를 참조할 때마다 binding을 점검 (address mapping table)
하드웨어적인 지원이 필요— ex. base and limit registers, MMU (register : CPU 안에 있는 빠른 장치)

Memory-Management Unit (MMU)
CPU가 만들어 내는 주소를 메모리가 이해하는 주소로 바꾸는 작업은 MMU라는 하드웨어가 맡는다.

- 주소 변환을 위한 하드웨어
- MMU : logical address를 physical address로 매핑해 주는 Hardware device
- MMU scheme
- 사용자 프로세스가 CPU에서 수행되며 생성해내는 모든 주소값에 대해 base register (=relocation register)의 값을 더한다.
- user program
- logical address만을 다룬다.
- 실제 physical address를 볼 수 없으며 알 필요가 없다.
Dynamic Relocation

Hardware Support for Address Translation

- 운영체제 및 사용자 프로세스 간의 메모리 보호를 위해 사용하는 레지스터
- Relocation register : 접근할 수 있는 물리적 메모리 주소의 최소값
- MMU에서의 base register
- Limit register : 논리적 주소의 범위
몇 가지 용어
메모리 관리에서 자주 등장하는 네 가지 용어를 먼저 정리한다.
- Dynamic Loading
- Dynamic Linking
- Overlays
- Swapping
Dynamic Loading
- 프로세스 전체를 메모리에 미리 다 올리는 것이 아니라 해당 루틴이 불려질 때 메모리에 load하는 것
- memory utilization의 향상
- 가끔씩 사용되는 많은 양의 코드의 경우 유용
- ex. 오류 처리 루틴
- 운영체제의 특별한 지원 없이 프로그램 자체에서 구현 가능 (OS는 라이브러리를 통해 지원 가능)
- Loading : 메모리로 올리는 것
Dynamic Linking
- Linking을 실행 시간(execution time)까지 미루는 기법
- DLLs : Dynamically Linked Libraries
- Static linking
- 라이브러리가 프로그램의 실행 파일 코드에 포함
- 실행 파일의 크기가 커진다.
- 동일한 라이브러리를 각각의 프로세스가 메모리에 올리므로 메모리 낭비 (ex. printf 함수의 라이브러리 코드)
- Dynamic linking
- 라이브러리가 실행 시 연결(link)됨
- 라이브러리 호출 부분에 라이브러리 루틴의 위치를 찾기 위한 stub이라는 작은 코드를 둔다.
- 라이브러리가 이미 메모리에 있으면 그 루틴의 주소로 가고 없으면 디스크에서 읽어온다.
- 운영체제의 도움이 필요하다.
Overlays
- 메모리에 프로세스의 부분 중 실제 필요한 정보만을 올린다.
- 프로세스의 크기가 메모리보다 클 때 유용하다.
- 운영체제의 지원없이 사용자에 의해 구현
- 작은 공간의 메모리를 사용하던 초창기 시스템에서 수작업으로 프로그래머가 구현
- “Manual Overlay”
- 프로그래밍이 매우 복잡
주의: 동적 로딩과 오버레이는 모두 필요한 부분만 메모리에 올리지만, 오버레이는 운영체제 지원 없이 프로그래머가 수작업으로 구현한다는 점이 다르다.
용어를 정리했으니, 이제 메모리를 실제로 어떻게 나누고 할당하는지 살펴본다.
Allocation of Physical Memory
물리 메모리는 OS 상주 영역과 사용자 프로세스 영역으로 나뉘고, 그중 사용자 영역을 어떻게 배분하느냐가 관건이다.
| OS 상주 영역 |
|---|
| 사용자 프로세스 영역 |
- 메모리는 일반적으로 두 영역으로 나뉘어 사용
- OS 상주 영역 : interrupt vector와 함께 낮은 주소 영역 사용
- 사용자 프로세스 영역 : 높은 주소 영역 사용
사용자 프로세스 영역의 할당 기법은 다음과 같다.
- Contiguous allocation : 각각의 프로세스가 메모리의 연속적인 공간에 적재되도록 하는 것
- Fixed partition allocation
- Variable partition allocation
- Noncontiguous allocation : 하나의 프로세스가 메모리의 여러 영역에 분산되어 올라갈 수 있다.
- Paging : 일정한 크기(페이지 단위)로 잘라 메모리에 올림
- Segmentation : 의미단위로 분할해서 메모리에 올림
- Paged Segmentation
Contiguous Allocation

- 고정분할(Fixed partition) 방식
- 물리적 메모리를 몇 개의 영구적 분할(partition)로 나눈다.
- 분할의 크기가 모두 동일한 방식과 서로 다른 방식이 존재
- 분할당 하나의 프로그램 적재
- 융통성이 없다. (동시에 메모리에 load되는 프로그램의 수가 고정된다, 최대 수행 가능 프로그램 크기 제한)
- Internal fragmentation 발생 (external fragmentation도 발생) — 프로세스가 사용하지 못하고 남는 공간
- 가변분할(Variable partition) 방식
- 프로그램의 크기를 고려해서 할당
- 분할의 크기, 개수가 동적으로 변한다.
- 기술적 관리 기법 필요
- External fragmentation 발생 — 연속적인 프로그램을 못 받는다.
- 외부 조각 (External fragmentation)
- 프로그램 크기보다 분할의 크기가 작은 경우
- 아무 프로그램에도 배정되지 않은 빈 곳인데도 프로그램이 올라갈 수 없는 작은 분할
- 내부 조각 (Internal fragmentation)
- 프로그램 크기보다 분할의 크기가 큰 경우
- 하나의 분할 내부에서 발생하는 사용되지 않는 메모리 조각
- 특정 프로그램에 배정되었지만 사용되지 않는 공간
주의: 내부 조각은 분할 내부에서 남는 공간, 외부 조각은 분할 사이에 남는 공간이다 — 발생 위치가 다르다.
- Hole
- 가용 메모리 공간 (a block of available memory)
- 다양한 크기의 hole들이 메모리 여러 곳에 흩어져 있다.
- 프로세스가 도착하면 수용가능한 hole을 할당
- 운영체제는 다음의 정보를 유지 — 할당 공간, 가용 공간 (hole)

- Dynamic Storage-Allocation Problem : 가변 분할 방식에서 size n인 요청을 만족하는 가장 적절한 hole을 찾는 문제
- First-fit : Size가 n 이상인 것 중 최초로 찾아지는 hole에 할당
- Best-fit : Size가 n 이상인 가장 작은 hole을 찾아서 할당. Hole들의 리스트가 크기순으로 정렬되지 않은 경우 모든 hole의 리스트를 탐색해야 하며, 많은 수의 아주 작은 hole들이 생성된다.
- Worst-fit : 가장 큰 hole에 할당. 역시 모든 리스트를 탐색해야 하며, 상대적으로 아주 큰 hole들이 생성된다.
- First-fit과 best-fit이 worst-fit보다 속도와 공간 이용률 측면에서 효과적인 것으로 알려짐(시뮬레이션에 기반한 결과)
결국 어떤 hole을 고르느냐의 차이다.
- compaction
- external fragmentation 문제를 해결하는 한 가지 방법
- 사용 중인 메모리 영역을 한군데로 몰고 hole들을 다른 한 곳으로 몰아 큰 block을 만드는 것
- 매우 비용이 많이 드는 방법이다.
- 최소한의 메모리 이동으로 compaction하는 방법 (매우 복잡한 문제)
- Compaction은 프로세스의 주소가 실행 시간에 동적으로 재배치 가능한 경우에만 수행될 수 있다.
정리하면, 연속 할당은 결국 단편화와의 싸움이고, 그 대응이 hole 선택과 compaction이다.
Paging
페이징은 프로세스의 주소 공간을 동일한 크기의 페이지로 잘라 메모리에 흩어 놓는 비연속 할당 방식이다.
- Paging
- Process의 virtual memory를 동일한 사이즈의 page 단위로 나눈다.
- virtual memory의 내용이 page 단위로 non-contiguous하게 저장됨
- 일부는 backing storage에, 일부는 physical memory에 저장
- Basic Method
- physical memory를 동일한 크기의 frame으로 나눈다. (frame : fixed-sized block)
- logical memory를 동일 크기의 page로 나눈다. (frame과 같은 크기, page size : 보통 4KB)

- 모든 가용 frame들을 관리한다.
- page table을 사용하여 logical address를 physical address로 변환한다.
- External fragmentation 발생 안한다. (avoid)
- Internal fragmentation 발생할 수 있다.

Address Translation Architecture

Implementation of Page Table
- Page table은 main memory에 상주
- Page-table base register (PTBR)가 page table을 가리킴
- Faster context switches, but still slower memory access time.
- Page-table length register (PTLR)가 테이블 크기를 보관
- 모든 메모리 접근 연산에는 2번의 memory access 필요
- page table 접근 1번, 실제 data/instruction 접근 1번
-
속도 향상을 위해 associative register 혹은 translation look-aside buffer (TLB)라 불리는 고속의 lookup hardware cache 사용
- Paging Hardware with TLB

Associative Register
- Associative registers (TLB) : parallel search가 가능
- TLB에는 page table 중 일부만 존재
- 주소 변환을 가속화하기 위한 하드웨어 지원
- Address translation
- page table 중 일부가 associative register에 보관되어 있다.
- 만약 해당 page #가 associative register에 있는 경우 곧바로 frame #를 얻는다.
- 그렇지 않은 경우 main memory에 있는 page table로부터 frame #를 얻는다.
- TLB는 context switch 때 flush (remove old entries) 2
Effective Access Time
- TLB hit : 만약 page number가 TLB에 있는 경우, MMU는 page table를 거치지 않고 VA를 PA로 전환한다.
- TLB miss : 만약 page number가 TLB에 없는 경우, MMU는 page table로 가고, TLB에 변환 결과를 저장한다.
- Associative register lookup time = $\varepsilon$
- memory cycle time = 1
- Hit ratio = 관심 page number가 TLB에서 발견된 횟수(백분율) (=$\alpha$)
- associative register에서 찾아지는 비율
- Effective Access Time (EAT)
- EAT = $(1+\varepsilon)\alpha + (2 + \varepsilon)(1-\alpha)$ = $2 + \varepsilon - \alpha$ 3
Two-Level Page Table (Hierarchical Paging)

- 현대의 컴퓨터는 address space가 매우 큰 프로그램을 지원한다.
- 32 bit address 사용시: $2^{32}$B(4GB)의 주소 공간 (page size가 4K시 1M개의 page table entry 필요, 각 page entry가 4B시 프로세스 당 4MB의 page table 필요, 그러나 대부분의 프로그램은 4G의 주소 공간 중 지극히 일부분만 사용하므로 page table 공간이 심하게 낭비된다.)
page table 자체를 page로 구성 사용되지 않는 주소 공간에 대한 outer page table의 엔트리 값은 NULL (대응하는 inner page table이 없다.)
Two-Level Paging Example
- logical address (on 32-bit machine with 4K page size)의 구성
- 20 bit의 page number
- 12 bit의 page offset
- page table 자체가 page로 구성되기 때문에 page number는 다음과 같이 나뉜다. (각 page table entry가 4B)
- 10-bit의 page number ($p_1$)
- 10-bit의 page offset ($p_2$)
- 따라서, logical address는 다음과 같다.

- $p_1$은 outer page table의 index이고
- $p_2$는 outer page table의 page에서의 변위(displacement)
Address-Translation Scheme
- 2단계 페이징에서의 Address-Translation Scheme

Multilevel Paging and Performance
주소 공간이 커질수록 페이지 테이블도 커진다 — 다단계 페이지 테이블과 TLB가 그 비용을 줄인다.
- Address space가 더 커지면 다단계 페이지 테이블 필요 4
- 각 단계의 페이지 테이블이 메모리에 존재하므로 logical address의 physical address로의 변환에 더 많은 메모리 접근이 필요하다.
- TLB를 통해 메모리 접근 시간을 줄일 수 있다.
- 4단계 페이지 테이블을 사용하는 경우
- 메모리 접근 시간이 100ns, TLB 접근 시간이 20ns이고 TLB hit ratio가 98%인 경우 — effective memory access time = 0.98 x 120 + 0.02 x 520 = 128 nanoseconds, 결과적으로 주소변환을 위해 28ns만 소요
정리하면, 단계가 늘어도 TLB 적중률이 높으면 실제 접근 지연은 크지 않다.
Valid(v) / Invalid (i) Bit in a Page Table

Memory Protection
- 소유하지 않은 메모리에 접근하려는 프로세스를 막는다.
relocation register+limit register

- Page table의 각 entry마다 아래의 bit를 둔다 — Protection bit(page에 대한 접근 권한 (read/write/read-only))와 Valid-invalid bit
- valid는 해당 주소의 frame에 그 프로세스를 구성하는 유효한 내용이 있음을 뜻함 (접근 허용)
- invalid는 해당 주소의 frame에 유효한 내용이 없음을 뜻함 (접근 불허)
Inverted Page Table
- page table이 매우 큰 이유
- 모든 process 별로 그 logical address에 대응하는 모든 page에 대해 page table entry가 존재
- 대응하는 page가 메모리에 있든 아니든 간에 page table에는 entry로 존재
- Inverted page table
- Page frame 하나당 page table에 하나의 entry를 둔 것 (system-wide)
- 각 page table entry는 각각의 물리적 메모리의 page frame이 담고 있는 내용 표시 (process-id, process의 logical address)
- 단점 : 테이블 전체를 탐색해야 함
- 조치 : associative register 사용 (expensive)

Shared Page

- Shared code : Re-entrant Code (=Pure code) (재진입 가능 코드)
- reentrant code is non-self-modifying code, that is, it never changes during execution.
- read-only로 하여 프로세스 간에 하나의 code만 메모리에 올림 (ex. text editors, compilers, window systems)
- Shared code는 모든 프로세스의 logical address space에서 동일한 위치에 있어야 함
Private code and data- 각 프로세스들은 독자적으로 메모리에 올림
- Private data는 logical address space의 아무 곳에 와도 무방
Segmentation
세그멘테이션은 프로세스를 의미 단위로 나눈다는 점에서 페이징과 다르다.
- 프로그램은 의미 단위인 여러 개의 segment로 구성되어 있다.
- 작게는 프로그램을 구성하는 함수 하나하나를 세그먼트로 정의
- 크게는 프로그램 전체를 하나의 세그먼트로 정의 가능
- 일반적으로는 code, data, stack 부분이 하나씩의 세그먼트로 정의된다.
- segmentation은 context switch 동안 저장하고 복구해야 한다.
- Segment는 다음과 같은 logical unit 들이다.
- main(), function, global variables, stack, symbol table, arrays
Segmentation Architecture
- Logical address는 다음의 두 가지로 구성
- segment-number, offset
- Segment table
- each table entry has: base - starting physical address of the segment (segment의 시작), limit - length of the segment (segment의 길이)
- Segment-table base register (STBR)
- 물리적 메모리에서의 segment table의 위치
- Segment-table length register (STLR)
- 프로그램이 사용하는 segment의 수 (segment number $s$ is legal if $s < STLR$)
Segmentation Architecture (Cont.)
- Protection
- 각 세그먼트 별로 protection bit가 있다.
- Each entry: Valid bit = 0 => illegal segment, Read/Write/Execution 권한 bit
- Sharing
- shared segment
- same segment number
- segment는 의미 단위이기 때문에 공유(sharing)와 보안(protection)에 있어 paging보다 효과적이다.
- Allocation
- first fit / best fit
- external fragmentation 발생
- segment의 길이가 동일하지 않으므로 가변분할 방식에서와 동일한 문제점들이 발생
결국 의미 단위로 자르느냐, 고정 크기로 자르느냐의 차이다.
Segmentation with Paging
- pure segmentation과의 차이점
- segment-table entry가 segment의 base address를 가지고 있는 것이 아니라 segment를 구성하는 page table의 base address를 가지고 있다.

한계와 트레이드오프
- 페이징은 외부 조각을 없애는 대신 페이지 테이블이라는 추가 메모리를 요구하고, TLB 미스가 나면 메모리를 두 번 접근해야 한다 — EAT 식의 $\varepsilon$과 $\alpha$가 그 비용을 드러낸다.
- 다단계 페이지 테이블은 테이블 크기를 줄이지만 변환 단계가 늘어나므로, TLB 적중률이 낮아지면 접근 지연이 그대로 커진다.
- 세그멘테이션은 의미 단위라 공유와 보호에 유리하지만, 길이가 가변이므로 외부 조각과 first-fit·best-fit 탐색 비용을 함께 안고 간다.
- compaction은 외부 조각을 없앨 수 있으나 실행 시간 바인딩에서만 가능하고 메모리 이동 비용이 크다 — 그래서 실제 시스템은 페이징을 기본 메커니즘으로 삼는다.
- overlay와 동적 로딩은 필요한 부분만 올려 메모리를 아끼지만, 초기 overlay처럼 프로그래머가 직접 관리하면 구현 부담이 크다.
핵심 정리
- 주소는 두 종류다. 프로그램이 보는 논리적 주소와 메모리에 실제 올라가는 물리적 주소를 구분하고, MMU가 둘을 변환한다.
- 바인딩 시점이 자유도를 정한다. 컴파일·로드·실행 시간 중 언제 주소가 확정되는지에 따라 재배치 가능 여부가 달라진다.
- 연속 할당의 약점은 단편화다. 고정·가변 분할 모두 외부 또는 내부 조각을 남긴다.
- 페이징은 고정 크기로, 세그멘테이션은 의미 단위로 자른다. 페이징은 외부 조각을 없애는 대신 페이지 테이블 비용을 치른다.
- TLB가 주소 변환 비용을 줄인다. 다단계 페이지 테이블에서도 적중률이 높으면 접근 지연이 작다.
댓글남기기