
운영체제(OS) - Virtual Memory (8)
본 글은 (KOCW) 운영체제, 이화여자대학교 반효경 교수님의 강의를 듣고 내용을 요약 및 정리했습니다. 개인 공부에 목적이 있으며, 자세한 사항은 http://www.kocw.or.kr/home/cview.do?mty=p&kemId=1046323에 참고하시면 됩니다.
Chapter 9.
- Virtual Memory 1 - 44분
- Virtual Memory 2 - 57분
(+) 인프런의 주니온 박사님의 운영체제 공룡책 강의를 듣고 내용을 보충했습니다. 자세한 사항은 여기를 참고하시면 됩니다.
이 글은 스와핑(swapping)과 가상 메모리(virtual memory), 요구 페이징(demand paging), 페이지 교체 알고리즘, 스래싱(thrashing)과 워킹 셋(working set) 모델 등 운영체제의 메모리 관리 기법을 정리한다.
물리 메모리보다 큰 프로그램을 실행하는 출발점은 swapping이고, 그 위에 가상 메모리와 요구 페이징이 올라간다. 이 글은 그 위에서 페이지 교체 알고리즘과 할당·교체 정책, 그리고 스래싱을 막는 워킹 셋과 PFF 기법까지 순서대로 따라간다.
이 글에서 다루는 것
- Swapping과 가상 메모리. 물리 메모리를 초과하는 프로세스를 실행하게 해주는 기반
- Demand paging과 page fault. 필요한 page만 메모리에 올리는 방식
- 페이지 교체 알고리즘. Optimal, FIFO, LRU, LFU와 실제 시스템의 Clock
- 할당과 교체 범위. Page frame allocation, global vs local replacement
- Thrashing과 Working-Set·PFF. 다중 프로그래밍 정도를 조절하는 기법


Swapping
Swapping은 메모리 관리의 출발점이다 — 물리 메모리보다 큰 다중 프로그래밍을 가능하게 한다.
- Swapping : 스왑을 사용하면 모든 프로세스의 총 물리적 주소 공간이 시스템의 실제 물리적 메모리를 초과할 수 있게 해준다.
- 시스템에서 multiprogramming 정도를 증가시켜줌.
- 프로세스를 일시적으로 메모리에서 backing store로 쫓아내는 것
- Backing store
- 디스크
- 많은 사용자의 프로세스 이미지를 담을 만큼 충분히 빠르고 큰 저장 공간
- 디스크
- Swap in / Swap out
- 일반적으로 중기 스케줄러(swapper)에 의해 swap out 시킬 프로세스 선정
- priority-based CPU scheduling algorithm
- priority가 낮은 프로세스를 swapped out 시킴
- priority가 높은 프로세스를 메모리에 올려 놓음
- Compile time 혹은 load time binding에서는 원래 메모리 위치로 swap in 해야 함
- Execution time binding 에서는 추후 빈 메모리 영역 아무 곳에나 올릴 수 있음
- swap time은 대부분 transfer time (swap되는 양에 비례하는 시간)임

- page out : moves a page from memory to backing store.
- page in : moves a page from backing store to memory.

Virtual Memory
가상 메모리는 논리 주소 공간과 물리 메모리를 분리해, 프로그램이 물리 메모리보다 커도 실행되게 한다.
- 프로그램이 물리적 메모리보다 더 클 수 있도록 메모리에 완전히 저장되지 않은 프로세스의 실행을 허용하는 기술
- 논리 메모리를 물리적 메모리에서 분리하여 메인 메모리를 매우 큰 스토리지 어레이로 추상화

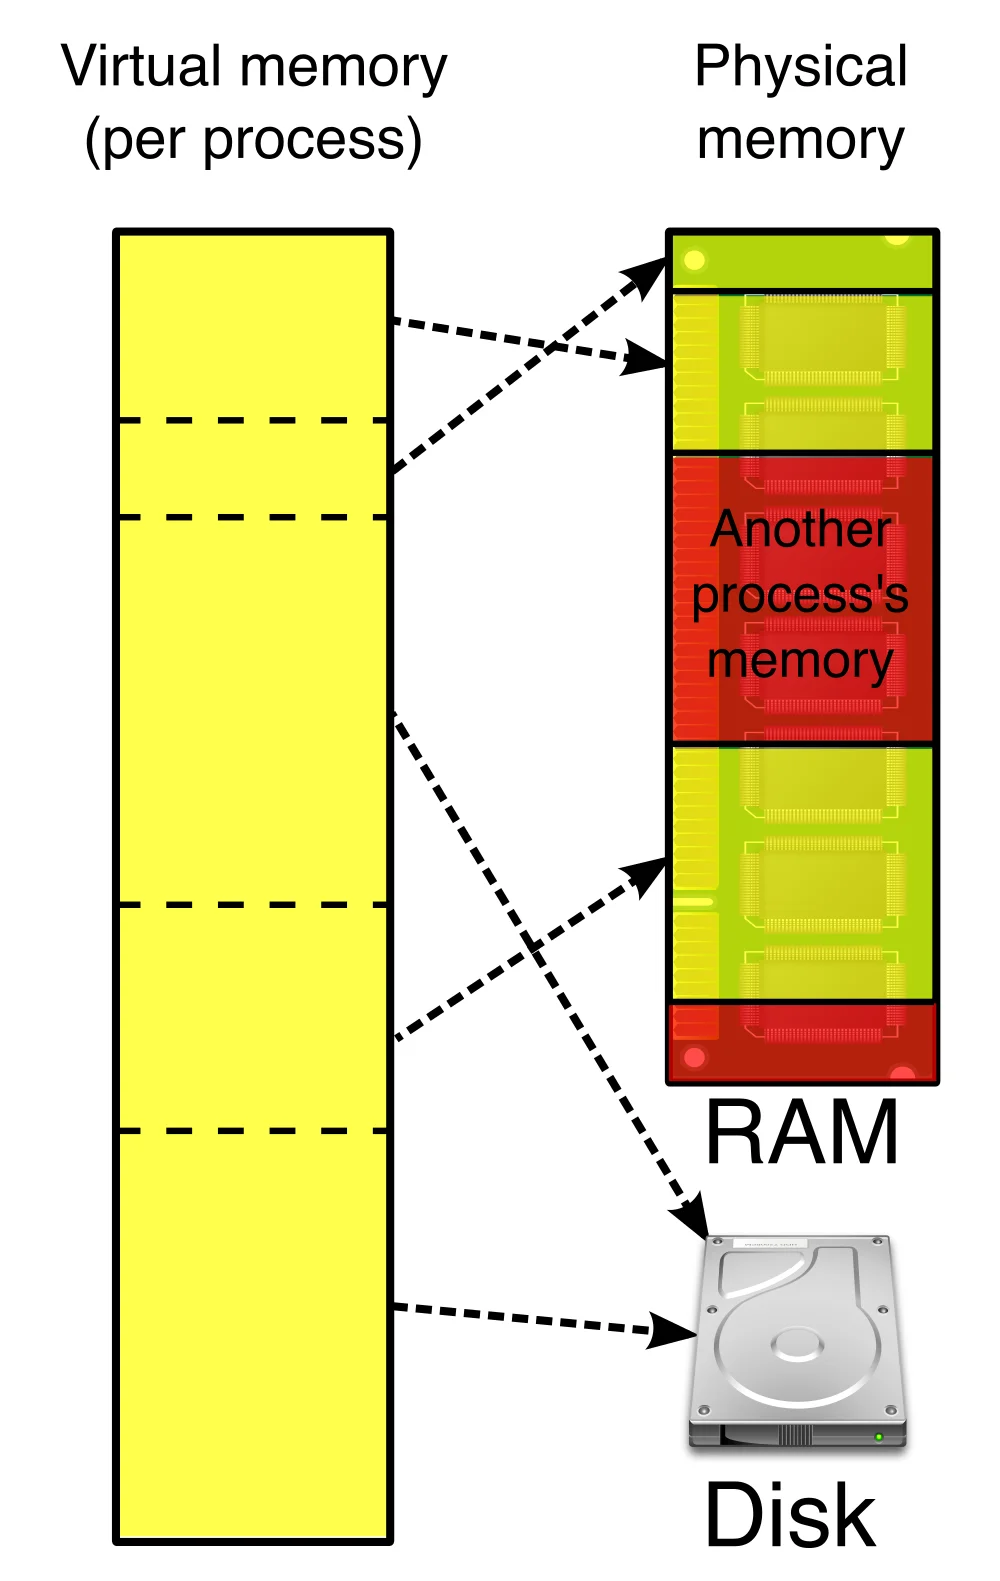
출처: Virtual memory - Wikimedia Commons (Ehamberg) (https://commons.wikimedia.org/wiki/File:Virtual_memory.svg), CC BY-SA 3.0 1
Virtual Address Space
- 프로세스가 메모리에 저장되는 방식에 대한 논리적(또는 가상) view

Shared library using virtual memory

Demand Paging
가상 메모리를 실제로 굴리는 방식이 요구 페이징이다 — 필요한 page만 그때그때 메모리에 올린다.
- 실제로 필요할 때(요청할 때만) page를 메모리에 올리는 것
- I/O 양의 감소
- Memory 사용량 감소
- 빠른 응답 시간
- 더 많은 사용자 수용
- 다만 이 이점은 참조 국소성(locality)이 좋은 프로그램에서 크게 나타난다. 국소성이 나쁘면 page fault가 잦아져 오히려 응답 시간이 느려질 수 있다. 2
- Valid/Invalid bit의 사용
- valid : the page is both legal and in memory.
- invalid : the page is either not valid or currently in secondary storage.
- 처음에는 모든 page entry가 invalid로 초기화
- address translation 시에 invalid bit이 set되어 있으면 -> page fault
Memory에 없는 Page의 Page Table

Structure of the Page Table
- 논리적 주소 공간이 커지면 page table가 지나치게 커진다.
- page table을 structure 하기 위한 기법
- Hierarchical Paging
- Hashed Page Table : for handling address space larger than 32 bits.

- Inverted Page Table
Page Fault
- invalid page를 접근하면 MMU가 trap을 발생시킴 (page fault trap)
- Kernel mode로 들어가서 page fault handler가 invoke됨
- 다음과 같은 순서로 page fault를 처리한다.
- Invalid reference? (ex. bad address, protection violation) -> abort process
- Get an empty page frame (없으면 뺏어온다: replace)
- 해당 페이지를 disk에서 memory로 읽어온다.
- disk I/O가 끝나기까지 이 프로세스는 CPU를 preempt 당함 (block)
- Disk read가 끝나면 page tables entry 기록, valid/invalid bit =
valid - ready queue에 process를 insert -> dispatch later
- 이 프로세스가 CPU를 잡고 다시 running
- 아까 중단되었던 instruction을 재개
정리하면, page fault는 trap → 빈 frame 확보 → disk read → 재개라는 한 번의 사이클로 처리된다.

Performance of Demand Paging
- Page Fault Rate $0 \le p \le 1.0$
- if $p=0$ no page faults
- if $p=1$, every reference is a fault
- Effective Access Time (EAT)
- $\text{EAT} = (1-p)\times\text{memory access} + p\times(\text{OS/HW page fault overhead} + \text{swap page out if needed} + \text{swap page in} + \text{OS/HW restart overhead})$ 2
Free frame이 없는 경우
메모리가 꽉 찼을 때 새 page를 올리려면 누군가를 내보내야 한다 — 이것이 page replacement다.
- Page replacement
- 어떤 frame을 빼앗아올지 결정해야 함
- 곧바로 사용되지 않을 page를 쫓아내는 것이 좋음
- 동일한 페이지가 여러 번 메모리에서 쫓겨났다가 다시 들어올 수 있음
- Replacement Algorithm
- page-fault rate을 최소화하는 것이 목표
- 알고리즘의 평가 : 주어진 page reference string에 대해 page fault를 얼마나 내는지 조사
기준은 언제나 ‘곧 안 쓸 page’다.

Optimal Algorithm
MIN(OPT) : 가장 먼 미래에 참조되는 page를 replace

- 미래의 참조를 어떻게 아나?
- Offline algorithm
- 다른 알고리즘의 성능에 대한 upper bound 제공
- Belady’s optimal algorithm, MIN, OPT 등으로 불림
FIFO (First In First Out) Algorithm

LRU (Least Recently Used) Algorithm
LRU: 가장 오래 전에 참조된 것을 지움

LFU (Least Frequently Used) Algorithm
LFU: 참조 횟수(reference count)가 가장 적은 페이지를 지움- 최저 참조 횟수인 page가 여럿 있는 경우
- LFU 알고리즘 자체에서는 여러 page 중 임의로 선정한다.
- 성능 향상을 위해 가장 오래 전에 참조된 page를 지우게 구현할 수도 있다.
- 장단점
- LRU처럼 직전 참조 시점만 보는 것이 아니라 장기적인 시간 규모를 보기 때문에 page의 인기도를 좀 더 정확히 반영할 수 있음
- 참조 시점의 최근성을 반영하지 못함
- LRU보다 구현이 복잡함
- 최저 참조 횟수인 page가 여럿 있는 경우
LRU와 LFU 알고리즘 예제

LRU와 LFU 알고리즘의 구현

- LRU에서는 시간 순서에 따라 일렬로 줄을 세움. 아래로 내려갈수록 가장 최근에 참조됨
- LFU는 heap을 이용해 트리 구조를 사용
다양한 캐슁 환경
교체 알고리즘은 캐슁 일반의 문제지만, paging system은 시간 제약이 다르다.
- 캐슁 기법
- 한정된 빠른 공간(=캐쉬)에 요청된 데이터를 저장해 두었다가 후속 요청시 캐쉬로부터 직접 서비스하는 방식
- paging system 외에도 cache memory, buffer caching, Web caching 등 다양한 분야에서 사용
- 캐쉬 운영의 시간 제약
- 교체 알고리즘에서 삭제할 항목을 결정하는 일에 지나치게 많은 시간이 걸리는 경우 실제 시스템에서 사용할 수 없음
- Buffer caching이나 Web caching의 경우
- O(1)에서 O(log n)정도까지 허용
- Paging system인 경우
- page fault인 경우에만 OS가 관여함
- 페이지가 이미 메모리에 존재하는 경우 참조시각 등의 정보를 OS가 알 수 없음
- O(1)인 LRU의 list 조작조차 불가능 3
주의: paging system에서는 page fault가 났을 때만 OS가 관여하므로, LRU·LFU가 필요로 하는 참조 정보를 OS가 알 수 없다.
Paging System에서 LRU, LFU 가능?

그래서 실제 시스템은 LRU를 그대로 쓸 수 없다 — 그 근사를 다음에서 다룬다.
Clock Algorithm
LRU를 실제 시스템에서 흉내 내는 방법이 Clock 알고리즘이다.

- Clock algorithm
- LRU의 근사(approximation) 알고리즘
- 여러 명칭으로 불림
- Second chance algorithm
- NUR (Not Used Recently) 또는 NRU (Not Recently Used)
- Reference bit을 사용해서 교체 대상 페이지 선정 (circular list)
- reference bit가 0인 것을 찾을 때까지 포인터를 하나씩 앞으로 이동
- 포인터 이동하는 중에 reference bit 1은 모두 0으로 바꿈
- Reference bit이 0인 것을 찾으면 그 페이지를 교체
- 한 바퀴 되돌아와서도(=second chance) 0이면 그때에는 replace 당함
- 자주 사용되는 페이지라면 second chance가 올 때 1
- Clock algorithm의 개선
- reference bit과 modified bit (dirty bit)을 함께 사용
- reference bit = 1 : 최근에 참조된 페이지
- modified bit = 1 : 최근에 변경된 페이지 (I/O를 동반하는 페이지)
Page Frame의 Allocation
각 프로세스에 frame을 얼마나 나눠 줄지도 교체만큼 중요한 문제다.
- Allocation problem : 각 process에 얼마만큼의 page frame을 할당할 것인가?
- Allocation의 필요성
- 메모리 참조 명령어 수행시 명령어, 데이터 등 여러 페이지 동시 참조
- 명령어 수행을 위해 최소한 할당되어야 하는 frame의 수가 있음
- Loop를 구성하는 page들은 한꺼번에 allocate되는 것이 유리함
- 최소한의 allocation이 없으면 매 loop마다 page fault
- 메모리 참조 명령어 수행시 명령어, 데이터 등 여러 페이지 동시 참조
- Allocation Scheme
- Equal allocation : 모든 프로세스에 똑같은 개수 할당
- Proportional allocation : 프로세스 크기에 비례하여 할당
- Priority allocation : 프로세스의 priority에 따라 다르게 할당
Global vs Local Replacement
replacement의 범위를 프로세스 안으로 좁힐지, 시스템 전체로 넓힐지가 갈린다.
- Global replacement
- Replace 시 다른 process에 할당된 frame을 빼앗아 올 수 있다.
- Process별 할당량을 조절하는 또 다른 방법임
- FIFO, LRU, LFU 등 알고리즘을 global replacement로 사용시에 해당
- Working set, PFF 알고리즘 사용
- Local replacement
- 자신에게 할당된 frame 내에서만 replacement
- FIFO, LRU, LFU 등의 알고리즘을 process 별로 운영시
차이는 남의 frame을 뺏을 수 있느냐다.
두 방식에는 트레이드오프가 있다. Global replacement는 프레임 할당이 프로세스별로 고정되지 않아, 한 프로세스가 다른 프로세스의 frame을 과도하게 가져가면 그 프로세스의 page fault rate가 치솟아 전체 처리량이 흔들릴 수 있다. 반대로 Local replacement는 남는 frame을 다른 프로세스가 활용하지 못해 시스템 전체의 메모리 활용률이 낮아질 수 있다. 2
Thrashing
할당이 부족해지면 시스템 전체가 page 교체에만 매달리는 스래싱에 빠진다.
- Thrashing
- 프로세스의 원활한 수행에 필요한 최소한의 page frame 수를 할당받지 못한 경우 발생
- Page fault rate이 매우 높아짐
- CPU utilization이 낮아짐
- OS는 MPD (Multiprogramming degree)를 높여야 한다고 판단
- 또 다른 프로세스가 시스템에 추가됨 (higher MPD)
- 프로세스 당 할당된 frame의 수가 더욱 감소
- 프로세스는 page의 swap in / swap out으로 매우 바쁨
- 대부분의 시간에 CPU는 한가함
- low throughput
CPU는 노는데 성능은 나쁘다면 스래싱을 의심한다.
Thrashing Diagram

스래싱을 막으려면 프로세스가 실제로 필요로 하는 frame의 양을 알아야 한다 — 그 기준이 다음의 working set이다.
Working-Set Model
스래싱을 막는 기준이 working set이다 — locality를 근거로 필요한 frame을 계산한다.
- Locality of reference
- 프로세스는 특정 시간 동안 일정 장소만을 집중적으로 참조한다.
- 집중적으로 참조되는 해당 page들의 집합을 locality set이라 함
- Working-set Model
- Locality에 기반하여 프로세스가 일정 시간 동안 원활하게 수행되기 위해 한꺼번에 메모리에 올라와 있어야 하는 page들의 집합을 Working Set이라 정의함
- Working Set 모델에서는 process의 working set 전체가 메모리에 올라와 있어야 수행되고 그렇지 않을 경우 모든 frame을 반납한 후 swap out (suspend)
- Thrashing을 방지함
- Multiprogramming degree를 결정함
Working-Set Algorithm
- Working set의 결정
- Working set window를 통해 알아냄
- window size가 $\Delta$인 경우
- 시각 $t_i$에서의 working set WS ($t_i$)
- Time interval $[t_i-\Delta, t_i]$사이에 참조된 서로 다른 페이지들의 집합
- Working set에 속한 page는 메모리에 유지, 속하지 않은 것은 버림 (즉, 참조된 후 $\Delta$시간 동안 해당 page를 메모리에 유지한 후 버림)
- 시각 $t_i$에서의 working set WS ($t_i$)
정리하면, working set은 최근 $\Delta$ 시간 동안 참조된 page들의 집합이다.

- Working-Set Algorithm
- Process들의 working set size의 합이 page frame의 수보다 큰 경우
- 일부 process를 swap out시켜 남은 process의 working set을 우선적으로 충족시켜 준다. (MPD를 줄임)
- Working set을 다 할당하고도 page frame이 남는 경우
- Swap out되었던 프로세스에게 working set을 할당 (MPD를 키움)
- Process들의 working set size의 합이 page frame의 수보다 큰 경우
- Window size $\Delta$
- Working set을 제대로 탐지하기 위해서는 window size를 잘 결정해야 함
- $\Delta$값이 너무 작으면 locality set을 모두 수용하지 못할 우려
- $\Delta$값이 크면 여러 규모의 locality set 수용
- $\Delta$값이 $\infty$이면 전체 프로그램을 구성하는 page를 working set으로 간주
PFF (Page-Fault Frequency) Scheme
Working set을 직접 구하기 어려울 때는 page-fault rate로 대신 판단한다.

- page-fault rate의 상한값과 하한값을 둔다.
- Page fault rate이 상한값을 넘으면 frame을 더 할당한다.
- Page fault rate이 하한값 이하면 할당 frame 수를 줄인다.
- 빈 frame이 없으면 일부 프로세스를 swap out
Page Size의 결정
마지막 변수는 page size다 — 크고 작음이 서로 다른 비용을 부른다.
- Page size를 감소시키면
- 페이지 수 증가
- 페이지 테이블 크기 증가
- Internal fragmentation 감소
- Disk transfer의 효율성 감소
- Seek/rotation vs transfer
- 필요한 정보만 메모리에 올라와 메모리 이용이 효율적
- Locality의 활용 측면에서는 좋지 않음
- Trend (현재 트렌드)
- Larger page size
핵심 정리
- Swapping과 가상 메모리. 물리 메모리를 초과하는 프로세스를 실행하게 해주는 기반이다.
- Demand paging. 필요한 page만 그때 메모리에 올려 I/O 양과 메모리 사용량을 줄인다.
- 페이지 교체 알고리즘. Optimal은 성능의 상한선이고, FIFO·LRU·LFU는 근사이며 실제 시스템은 Clock을 쓴다.
- 할당과 교체 범위. frame을 얼마나 나누고 어디서 뺏을지가 성능을 가른다.
- Thrashing과 Working-Set·PFF. 필요한 frame을 보장해 multiprogramming degree를 조절한다.

댓글남기기