
[Spark] CSV, JSON, Parquet, ORC 데이터소스 읽고 쓰는 방법
 [Spark The Definitive Guide - BIG DATA PROCESSING MADE SIMPLE] 책을 중심으로 스파크를 개인 공부를 위해 요약 및 정리해보았습니다. 다소 복잡한 설치 과정은 도커에 미리 이미지를 업로드해 놓았습니다. 즉, 도커 이미지를 pull하면 바로 스파크를 사용할 수 있습니다.
- 도커 설치 및 활용하는 방법 : [Spark] 빅데이터와 아파치 스파크란 - 1.2 스파크 실행하기
- 도커 이미지 링크 : https://hub.docker.com/r/ingu627/hadoop
- 예제를 위한 데이터 링크 : FVBros/Spark-The-Definitive-Guide
예제에 대한 실행 언어는 스칼라(scala)로 했습니다. 앞으로 스파크와 관련된 내용은 딥러닝 부분을 제외하고 스칼라로 진행될 예정입니다. 기본 실행 방법
- 예제에 사용 될 데이터들은 도커 이미지 생성 후
spark-3.3.0안의 하위 폴더data를 생성 후, 이 폴더에 추가합니다. 1.1 데이터와 도커 설치 및 활용하는 방법은 위에 링크를 남겼습니다. - 프로그램 시작은
cd spark-3.3.0후,./bin/spark-shell명령어를 실행하시면 됩니다.
1. 데이터 소스
- 스파크의 핵심 데이터소스는 다음과 같다.
- CSV
- JSON
- parquet
- ORC
- JDBC/ODBC 연결
- 일반 텍스트 파일
- 스파크의 데이터소스들 일부는 다음과 같다.
- Cassandra
- HBase
- Mongo DB
- AWS Redshift
- XML
- 기타 수많은 데이터소스
- 이번 내용의 목표는 스파크의 핵심 데이터소스를 이용해 데이터를 읽고 쓰는 방법을 터득하고, 서드파티 데이터소스와 스파크를 연동할 때 무엇을 고려해야 하는지 알아가는 것이다.
2. 데이터소스 API의 구조
2.1 읽기 API 구조
- 데이터 읽기의 핵심 구조는 다음과 같다.
- 모든 데이터 소스를 읽을 때 아래와 같은 형식을 사용한다.
- format 메서드는 선택적으로 사용할 수 있으며, 기본값은 파케이(parquet) 포맷이다.
- option 메서드를 사용해 데이터를 읽는 방법에 대한 파라미터를 키-값 쌍으로 설정할 수 있다.
- schema 메서드는 데이터 소스에서 스키마를 제공하거나, 스키마 추론 기능을 사용하려는 경우에 선택적으로 사용할 수 있다.
DataFrameReader.format(...
  ).option("key", "value"
  ).schema(...
  ).load()
2.2 데이터 읽기의 기초
- 스파크에서 데이터를 읽을 때는 기본적으로 DataFrameReader를 사용한다.
- DataFrameReader는 SparkSession의 read 속성으로 접근한다.
spark.read
- DataFrameReader를 얻은 다음에는 다음과 같은 값을 지정해야 한다.
- 포맷(format) : 선택
- 스키마(schema) : 선택
- 읽기 모드(read mode) : 필수
- 옵션(options) : 선택
- 그리고 데이터소스마다 데이터를 읽는 방식을 결정할 수 있는 옵션을 제공한다.
- 사용자는 DataFrameReader에 반드시 데이터를 읽을 경로를 지정해야 한다.
- 전반적인 코드 구성은 다음과 같다.
spark.read.format("csv"
  ).option("mode", "FAILFAST"
  ).option("inferSchema", "true"
  ).option("path", "path/to/file(s)"
  ).schema(someSchema
  ).load()
읽기 모드
- 읽기 모드 정리한 링크 : [Spark] CSV, JSON, Parquet, SQL DB 등 데이터소스에 대한 옵션 정리
2.3 쓰기 API 구조
- 데이터 쓰기의 핵심 구조는 다음과 같다.
- 모든 데이터소스에 데이터를 쓸 때 아래와 같은 형식을 사용한다.
- format 메서드는 선택적으로 할 수 있으며, default는 파케이 포맷이다.
- option 메서드를 사용해 데이터 쓰기 방법을 설정할 수 있다.
- partitionBy, bucketBy, sortBy 메서드는 파일 기반의 데이터소스에서만 동작하며, 이 기능으로 최종 파일 배치 레이아웃을 제어할 수 있다.
DataFrameWriter.format(...
  ).option(...
  ).partitionBy(...
  ).bucketBy(...
  ).sortBy(...
  ).save()
2.4 데이터 쓰기의 기초
- 데이터 쓰기는 DataFrameWriter를 사용한다.
- 데이터소스에 항상 데이터를 기록해야 하기 때문에 DataFrame의 write 속성을 이용해 DataFrame 별로 DataFrameWriter에 접근해야 한다.
dataFrame.write
- DataFrameWriter를 얻은 다음에는 포맷(format), 옵션(option), 저장(save) 모드를 지정해야 하며, 데이터가 저장될 경로를 반드시 입력해야 한다.
- 전반적인 코드 구성은 다음과 같다.
dataframe.write.format("csv"
  ).option("mode", "OVERWRITE"
  ).option("dateFormat", "yyyy-MM-dd"
  ).option("path", "path/to/file(s)"
  ).save()
저장 모드
- 저장 모드 정리한 링크 : [Spark] CSV, JSON, Parquet, SQL DB 등 데이터소스에 대한 옵션 정리
3. CSV 파일
- CSV(comma-separated values)는 콤마(
,)로 구분된 값을 의미한다. - CSV는 각 줄이 단일 레코드가 되며 레코드의 각 필드를 콤마로 구분하는 일반적인 텍스트 파일 포맷이다.
3.1 CSV 옵션
- CSV 옵션 정리한 링크 : [Spark] CSV, JSON, Parquet, SQL DB 등 데이터소스에 대한 옵션 정리
3.2 CSV 파일 읽기
- CSV 파일을 읽으려면 먼저 CSV용 DataFrameReader를 생성해야 한다.
- 예제는 다음과 같다.
spark.read.format("csv")
- 그 다음에는 스키마와 읽기 모드와 다른 옵션들도 지정한다.
- header 옵션은 첫 번째 줄이 컬럼명인지 나타내는 불리언 값이다.
spark.read.format("csv"
  ).option("header", "true"
  ).option("mode", "FAILFAST"
  ).option("inferSchema", "true"
  ).load("some/path/to/file.csv")
- CSV 파일은 비정상적인 데이터를 얼마나 수용할 수 있을지 읽기 모드로 지정할 수 있다.
- 다음 예제는 읽기 모드와 임의로 생성한 스키마를 파일의 데이터가 예상한 형태로 이루어져 있음을 검증하는 용도로 사용할 때이다.
- 실행이 잘되지만 데이터가 기대했던 데이터 포맷이 아니었다면 문제가 발생한다.
- 스파크는 지연 연산 특성이 있으므로 DataFrame 정의 시점이 아니라 잡 실행 시점에만 오류가 발생한다.
import org.apache.spark.sql.types.{StructField, StructType, StringType, LongType}

val myManualSchema = new StructType(Array(
  new StructField("DEST_COUNTRY_NAME", StringType, true),
  new StructField("ORIGIN_COUNTRY_NAME", StringType, true),
  new StructField("count", LongType, false)
))

spark.read.format("csv"
  ).option("header", "true"
  ).option("mode", "FAILFAST"
  ).schema(myManualSchema
  ).load("./data/flight-data/csv/2010-summary.csv"
  ).show(5)
-
실행결과

3.3 CSV 파일 쓰기
maxColumns와inferSchema옵션 같이 데이터 쓰기에는 적용되지 않는 옵션을 제외하면 데이터 읽기와 동일한 옵션을 제공한다.- 코드 예제는 다음과 같다.
val csvFile = spark.read.format("csv"
  ).option("header", "true"
  ).option("mode", "FAILFAST"
  ).schema(myManualSchema
  ).load("./data/flight-data/csv/2010-summary.csv")
-
실행결과

-
그리고 CSV 파일을 읽어 들여 TSV 파일로 내보내는 처리도 아주 쉽게 할 수 있다.
csvFile.write.format("csv"
  ).mode("overwrite"
  ).option("sep", "\t"
  ).save("/tmp/my-tsv-file.tsv")
-
실행결과

4. JSON 파일
- JSON(JavaScript Object Notation)은 자바스크립트에서 온 파일 형식들인 즉, 자바스크립트 객체 표기법이다.
- 스파크에서는 JSON 파일을 사용할 때 줄로 구분된(line-delimited) JSON을 기본적으로 사용한다.
multiLine옵션을 사용해 줄로 구분된 방식과 여러 줄로 구성된 방식을 선택적으로 사용할 수 있다.- 이 옵션을
true로 설정하면 전체 파일을 하나의 JSON 객체로 읽을 수 있다.
- 이 옵션을
- 스파크는 JSON 파일을 파싱한 다음에 DataFrame을 생성한다.
- 줄로 구분된 JSON은 전체 파일을 읽어 들인 다음 저장하는 방식이 아니므로 새로운 레코드를 추가할 수 있다.
- 레코드 하나가 한 줄이므로 전체 파일을 다시 쓰지 않고도 뒤에 레코드를 덧붙일 수 있어, 로그처럼 행 단위 추가가 잦은 데이터에 적합하다.
spark.read.format("json")
4.1 JSON 옵션
- JSON 옵션 정리한 링크 : [Spark] CSV, JSON, Parquet, SQL DB 등 데이터소스에 대한 옵션 정리
4.2 JSON 파일 읽기
- 다음은 JSON 파일 읽기에 대한 예제이다.
spark.read.format("json"
  ).option("mode", "FAILFAST"
  ).schema(myManualSchema
  ).load("./data/flight-data/json/2010-summary.json"
  ).show(5)
-
실행결과

4.3 JSON 파일 쓰기
- JSON 파일 쓰기는 읽기와 마찬가지로 간단하다.
- 또한 데이터소스에 관계없이 JSON 파일에 저장할 수 있다.
csvFile.write.format("json"
  ).mode("overwrite"
  ).save("/tmp/my-json-file.json")
5. 파케이 파일
- 파케이(parquet)는 다양한 스토리지 최적화 기술을 제공하는 오픈소스로 만들어진 컬럼 기반의 데이터 저장 방식이다.
- 특히 분석 워크로드에 최적화되어 있다.
- 저장소 공간을 절약할 수 있고 전체 파일을 읽는 대신 개별 컬럼을 읽을 수 있으며, 컬럼 기반의 압축 기능을 제공한다.
- 파케이는 컬럼 기반 저장과 컬럼 단위 압축을 사용하므로, 일부 컬럼만 읽는 분석 질의에서는 스캔하는 데이터 양이 CSV·JSON 같은 행 기반 포맷보다 적다.
- 다만 실제 읽기 성능 차이는 데이터 크기, 압축 방식, 질의가 참조하는 컬럼 수에 따라 달라진다. 저장 포맷은 워크로드로 읽기 시간을 재보고 정하는 편이 안전하다.
- 또한 파케이는 복합 데이터 타입을 지원한다.
- 컬럼이 배열, 맵, 구조체 데이터 타입이라 해도 문제없이 읽고 쓸 수 있다.
- 단, CSV에서는 배열을 사용할 수 없다.
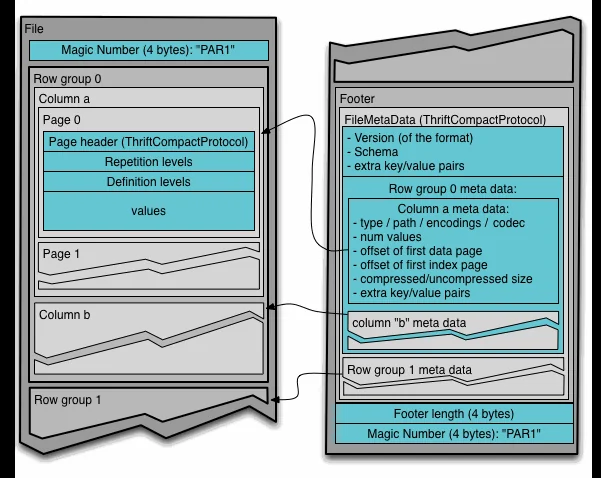
출처: Apache Parquet 문서 - File Format (https://parquet.apache.org/docs/file-format/)
- 파케이를 읽기 포맷으로 지정하는 방법은 다음과 같다.
spark.read.format("parquet")
5.1 파케이 파일 읽기
- 파케이는 옵션이 거의 없다.
- 데이터를 저장할 때 자체 스키마를 사용해 데이터를 저장하기 때문이다.
- 파케이 파일은 스키마가 파일 자체에 내장되어 있으므로 추정이 필요 없다.
- 다음은 파케이 파일을 읽는 간단한 예제이다.
spark.read.format("parquet"
  ).load("./data/flight-data/parquet/2010-summary.parquet"
  ).show(5)
-
실행결과

파케이 옵션
- 파케이 옵션 정리한 링크 : [Spark] CSV, JSON, Parquet, SQL DB 등 데이터소스에 대한 옵션 정리
5.2 파케이 파일 쓰기
- 파일의 경로만 명시하면 파케이 파일 쓰기를 할 수 있다.
csvFile.write.format("parquet"
  ).mode("overwrite"
  ).save("/tmp/my-parquet-file.parquet")
6. ORC 파일
- ORC는 하둡 워크로드를 위해 설계된 자기 기술적(self-describing)이며 데이터 타입을 인식할 수 있는 컬럼 기반의 파일 포맷이다.
- 대규모 순차 읽기에 맞게 스트라이프(stripe) 단위로 데이터를 나누고, 각 스트라이프에 min/max·블룸 필터 같은 인덱스를 함께 저장해 조건에 맞는 스트라이프만 골라 읽는 프루닝(predicate pushdown)을 지원한다.
- 스파크는 ORC를 기본 지원하므로
format("orc")만 지정하면 별도 옵션 없이 읽고 쓸 수 있다.
파케이는 스파크에 최적화된 반면 ORC는 하이브에 최적화되어 있다.
6.1 ORC 파일 읽기 및 쓰기
- 스파크에서 ORC 파일을 읽기 및 쓰기는 다음과 같다.
// 읽기
spark.read.format("orc"
  ).load("./data/flight-data/orc/2010-summary.orc"
  ).show(5)

// 쓰기
csvFile.write.format("orc"
  ).mode("overwrite"
  ).save("/tmp/my-orc-file.orc")
6.2 포맷별 한계와 트레이드오프
- CSV는 헤더와 타입 정보를 파일에 담지 않으므로
inferSchema를 쓰면 파일을 한 번 더 훑어야 하고, 매 행을 문자열로 파싱하는 비용이 든다. - JSON은 레코드 추가에는 유리하지만 중첩 구조를 그대로 담아 파일 크기가 커지기 쉽고, 컬럼 단위 프루닝 효과는 컬럼 기반 포맷보다 떨어진다.
- 파케이·ORC 같은 컬럼 기반 포맷은 일부 컬럼만 읽는 분석 질의에 유리하지만, 행 하나를 고치려면 파일을 다시 써야 하므로 소량 갱신이 잦은 워크로드에는 맞지 않는다.
- 포맷과 무관하게 작은 파일이 많이 쌓이면 태스크·메타데이터 오버헤드가 커지므로, 파티셔닝과 파일 크기 관리가 함께 필요하다.
7. SQL 데이터베이스
- 여기서부터는 다음 글에 이어서 진행된다.
댓글남기기