
[Spark] CSV, JSON, Parquet, SQL DB 등 데이터소스에 대한 옵션 정리
 [Spark The Definitive Guide - BIG DATA PROCESSING MADE SIMPLE] 책을 중심으로 스파크를 개인 공부를 위해 요약 및 정리해보았습니다. 다소 복잡한 설치 과정은 도커에 미리 이미지를 업로드해 놓았습니다. 즉, 도커 이미지를 pull하면 바로 스파크를 사용할 수 있습니다.
- 도커 설치 및 활용하는 방법 : [Spark] 빅데이터와 아파치 스파크란 - 1.2 스파크 실행하기
- 도커 이미지 링크 : https://hub.docker.com/r/ingu627/hadoop
- 예제를 위한 데이터 링크 : FVBros/Spark-The-Definitive-Guide
예제에 대한 실행 언어는 스칼라(scala)로 했습니다. 앞으로 스파크와 관련된 내용은 딥러닝 부분을 제외하고 스칼라로 진행될 예정입니다.
기본 실행 방법
- 예제에 사용 될 데이터들은 도커 이미지 생성 후
spark-3.3.0안의 하위 폴더data를 생성 후, 이 폴더에 추가합니다.- 1.1 데이터와 도커 설치 및 활용하는 방법은 위에 링크를 남겼습니다.
- 프로그램 시작은
cd spark-3.3.0후,./bin/spark-shell명령어를 실행하시면 됩니다.
1. 데이터소스 모드, 설명
- 이 내용은 이전 글인 [Spark] CSV, JSON, Parquet, ORC 데이터소스 읽고 쓰는 방법 에 대한 데이터소스 모드와 설명을 따로 정리한 글이다.
- 그때그때 참고하면 될 것 같다.
2. 읽기 모드
- 외부 데이터소스에서 데이터를 읽다 보면 자연스럽게 형식에 맞지 않는 데이터를 만나게 된다.
- 특히 반정형 데이터소스를 다룰 때 많이 발생한다.
- 읽기 모드(read mode)는 스파크가 형식에 맞지 않는 데이터를 만났을 때의 동작 방식을 지정하는 옵션이다.
- default :
permissive
- default :

3. 저장 모드
- 저장 모드(write mode)는 스파크가 지정된 위치에서 동일한 파일을 발견했을 때의 동작 방식을 지정하는 옵션이다. 1
- default :
errorIfExists
- default :

4. CSV 옵션
- CSV는 각 줄이 단일 레코드가 되며 레코드의 각 필드를 콤마로 구분하는 일반적인 텍스트 파일 포맷이다.
- CSV 파일은 정형으로 보이지만, 사실 매우 까다로운 파일 포맷 중 하나이다.
- 그 이유는 운영 환경에서는 어떤 내용이 들어 있는지, 어떠한 구조로 되어 있는지 등 다양한 전제를 만들어낼 수 없기 때문이다.
- 때문에 CSV reader는 많은 수의 옵션을 제공한다.


5. JSON 옵션
- JSON(JavaScript Object Notation)은 자바스크립트에서 온 파일 형식들인 즉, 자바스크립트 객체 표기법이다.
-
JSON은 객체이기 때문에 CSV보다 옵션 수가 적다.
- Table 9-4. JSON data source options
- 책에서는 설명 부분이 잘렸기 때문에 이 부분만 마크다운으로 작성했다.
| Read/Write | Key | Potential values | Default | Description |
|---|---|---|---|---|
Both |
compression or codec |
None, uncompressed, bzip2, deflate, gzip, lz4, or snappy |
none |
Declares what compression codec Spark should use to read or write the file. |
Both |
dateFormat |
Any string or character that conforms to Java’s SimpleDataFormat. | yyyy-MM-dd |
Declares the date format for any columns that are date type. |
Both |
timestampFormat |
Any string or character that conforms to Java’s SimpleDataFormat. | yyyy-MM-dd’T’HH:mm:ss.SSSZZ |
Declares the timestamp format for any columns that are timestamp type. |
Read |
primitiveAsString |
true,false |
false |
Infers all primitive values as string type. |
Read |
allowComments |
true,false |
false |
Ignores Java/C++ style comment in JSON records. |
Read |
allowUnquotedFieldNames |
true,false |
false |
Allows unquoted JSON field names |
Read |
allowSingleQuotes |
true,false |
true |
Allows single quotes in addition to double quotes. |
Read |
allowNumericLeadingZeros |
true,false |
false |
Allows leading zeroes in numbers (e.g., 00012) |
Read |
allowBackslashEscapingAnyCharacter |
true,false |
false |
Allows accepting quoting of all characters using backslash quoting mechanism |
Read |
columnNameOfCorruptRecord |
Any String | Value of spark.sql.columnNameOfCorruptRecord |
Allows renaming the new field having a malformed string created by permissive mode. This will override the configuration value. |
Read |
multiLine |
true,false |
false |
Allows for reading in non-line-delimited JSON files. |
6. 파케이 옵션
- 파케이(parquet)는 다양한 스토리지 최적화 기술을 제공하는 오픈소스로 만들어진 컬럼 기반의 데이터 저장 방식이다.
- 파케이는 옵션이 거의 없다.
- 단 2개의 옵션만 존재하는 이유는 스파크의 개념에 아주 잘 부합하고 알맞게 정의된 명세를 가지고 있기 때문이다.
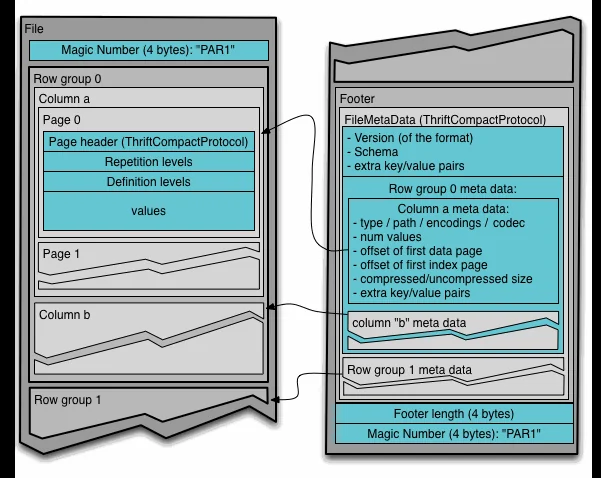
출처: Apache Parquet Documentation — File Format (https://parquet.apache.org/docs/file-format/)

7. JDBC 옵션
- JDBC는 자바에서 데이터베이스에 접속할 수 있도록 하는 자바 API이다. 2
- JDBC는 데이터베이스에서 자료를 쿼리하거나 업데이트하는 방법을 제공한다.


8. 한계와 트레이드오프
- 읽기 모드의 기본값이 안전을 보장하지 않는다 :
permissive는 형식이 맞지 않는 레코드를 버리지 않고 기본 컬럼_corrupt_record에 원문을 담고 나머지 필드는null로 채운다. 즉 잡은 성공하지만 잘못된 데이터가 조용히 섞여 들어갈 수 있으므로, 손상 레코드 존재 여부를 따로 확인하거나badRecordsPath같은 별도 검증을 붙여야 한다. 1 - 저장 모드 선택은 재실행 안전성과 데이터 보존의 맞바꿈이다 : 기본값
errorIfExists는 같은 경로에 데이터가 이미 있으면 실패하므로 반복 실행 시 잡이 깨지고,overwrite는 기존 데이터를 지우며,append는 재실행마다 중복 적재될 수 있다. 1 - 텍스트 포맷은 스키마 추론 비용을 낸다 : CSV·JSON은 값의 타입을 알기 위해 데이터를 훑어야 하므로 파케이처럼 컬럼 프루닝(필요한 열만 읽기)·압축 이점을 그대로 누리기 어렵다. JSON의
multiLine처럼 기본값이false인 옵션이 있어, 여러 줄에 걸친 객체는 기본 설정으로는 읽히지 않는다. - JDBC 읽기는 파티션 설계에 성능이 좌우된다 : 단일 파티션으로 읽으면 커넥션 하나에 부하가 몰리므로
partitionColumn,lowerBound,upperBound,numPartitions로 분할해야 하는데, 분포가 고르지 않으면 특정 파티션에 데이터가 쏠린다. 3
댓글남기기