
[Spark] 스파크 SQL 정리 (실행방법, 테이블, 뷰, 데이터베이스, 함수, 서브쿼리)
 [Spark The Definitive Guide - BIG DATA PROCESSING MADE SIMPLE] 책을 중심으로 스파크를 개인 공부를 위해 요약 및 정리해보았습니다. 다소 복잡한 설치 과정은 도커에 미리 이미지를 업로드해 놓았습니다. 즉, 도커 이미지를 pull하면 바로 스파크를 사용할 수 있습니다.
도커 설치 및 활용하는 방법 : [Spark] 빅데이터와 아파치 스파크란 - 1.2 스파크 실행하기 도커 이미지 링크 : https://hub.docker.com/r/ingu627/hadoop 예제를 위한 데이터 링크 : FVBros/Spark-The-Definitive-Guide 예제에 대한 실행 언어는 SQL과 스칼라(scala)로 했습니다.
기본 실행 방법
- 예제에 사용 될 데이터들은 도커 이미지 생성 후
spark-3.3.0안의 하위 폴더data를 생성 후, 이 폴더에 추가합니다. 1.1 데이터와 도커 설치 및 활용하는 방법은 위에 링크를 남겼습니다. - 프로그램 시작은
cd spark-3.3.0후,./bin/spark-sql명령어를 실행하시면 됩니다.
- 이 글에서 다루는 것
- 스파크 SQL의 개념, 하이브 메타스토어 연동 및 쿼리 실행 방법 (CLI, 프로그래밍 인터페이스, 쓰리프트 JDBC/ODBC)
- 카탈로그 추상화와 관리형·외부 테이블의 생성, 데이터 삽입 및 메타데이터 관리
- 쿼리 계획 추상화를 위한 전역 및 임시 뷰의 생성과 관리
- 데이터베이스 생성, 설정 및 관리와 ANSI-SQL SELECT 구문 활용
- 구조체·리스트 등 복합 데이터 타입, 사용자 정의 함수(UDF) 등록 및 상호연관·비상호연관 서브쿼리 연산
1. 스파크 SQL
- 스파크 SQL을 사용해 데이터베이스에 생성된 뷰(view) 나 테이블에 SQL 쿼리를 실행할 수 있다.
- 또한 시스템 함수를 사용하거나 사용자 정의 함수를 정의할 수 있다.
- 그리고 워크로드를 최적화하기 위해 쿼리 실행 계획을 분석할 수 있다.
- 스파크 SQL은 DataFrame과 Dataset API에 통합되어 있기 때문에, 데이터 변환 시 SQL과 DataFrame의 기능을 모두 사용할 수 있으며 두 방식 모두 동일한 실행 코드로 컴파일된다.
스파크 SQL은 OLTP(online transaction processing) 데이터베이스가 아닌 OLAP(online analytic processing) 데이터베이스로 동작한다. 즉, 매우 낮은 지연 시간이 필요한 쿼리를 수행하기 위한 용도로 사용할 수 없다.
2. SQL이란
- SQL(정형 질의 언어, Structured Query Language)는 데이터에 대한 관계형 연산을 표현하기 위한 도메인 특화 언어이다.
- 모든 관계형 데이터베이스에서 사용되며, 많은 NoSQL 데이터베이스에서도 쉽게 사용할 수 있는 변형된 자체 SQL을 제공한다.
3. 스파크와 하이브의 관계
- 스파크 SQL은 하이브 메타스토어를 사용하므로 하이브와 잘 연동할 수 있다.
- 하이브 메타스토어는 여러 세션에서 사용할 테이블 정보를 보관하고 있다.
- 스파크 SQL은 하이브 메타스토어에 접속한 뒤 조회할 파일 수를 최소화하기 위해 메타데이터를 참조한다.
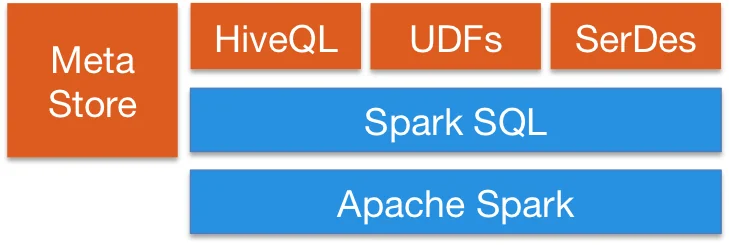
출처: Apache Spark 공식 사이트 - Spark SQL
하이브 메타스토어
- 하이브 메타스토어에 접속하려면 몇 가지 속성이 필요하다.
- 먼저 접근하려는 하이브 메타스토어에 적합한 버전을
spark.sql.hive.metastore.version에 설정해야 한다. - 또한
HiveMetastoreClient가 초기화되는 방식을 변경하려면spark.sql.hive.metastore.jars를 설정해야 한다. - 스파크는 기본 버전을 사용하지만 메이븐 저장소나 자바 가상 머신의 표준 포맷에 맞게 클래스패스에 정의할 수도 있다.
- 또한 하이브 메타스토어가 저장된 다른 데이터베이스에 접속하려면 적합한 클래스 접두사를 정의해야 한다.
- 또한 스파크와 하이브에서 공유할 수 있도록 클래스 접두사를
spark.sql.hive.metastore.sharedPrefixes속성에 설정한다.
4. 스파크 SQL 쿼리 실행 방법
- 스파크는 SQL 쿼리를 실행할 수 있는 몇 가지 인터페이스를 제공한다.
4.1 스파크 SQL CLI
- 스파크 SQL CLI(명령행 인터페이스, command line interface)는 로컬 환경의 명령행에서 기본 스파크 SQL 쿼리를 실행할 수 있는 도구이다.
- 스파크 SQL CLI는 쓰리프트 JDBC 서버와 통신할 수 없다.
- 스파크 SQL CLI를 사용하려면 다음 명령을 실행한다.
- 스파크가 설치된 경로의 conf 디렉터리에 hive-site.xml, core-site.xml, hdfs-site.xml 파일을 배치해 하이브를 사용할 수 있는 환경을 구성할 수 있다.
cd spark-3.3.0/

$ ./bin/spark-sql
4.2 스파크의 프로그래밍 SQL 인터페이스
- 서버를 설정해 SQL을 사용할 수도 있지만, 스파크에서 지원하는 언어 API로 비정형 SQL을 실행할 수도 있다.
- 이를 위해 SparkSession 객체(=spark)의 sql 메서드를 사용한다.
- 처리된 결과는 DataFrame을 반환한다.
spark.sql()은 다른 트랜스포메이션과 마찬가지로 즉시 실행되지 않고 지연 처리된다.
spark.sql("SELECT 1 + 1").show()
-
실행결과

-
함수에 여러 줄로 구성된 문자열을 전달할 수 있으므로 여러 줄로 구성된 쿼리를 아주 간단히 표현할 수 있다.
spark.sql("""
    SELECT user_id, department, first_name FROM professors
    WHERE department IN
        (SELECT name FROM department WHERE created_data >= '2016-01-01')
""")
- SQL과 DataFrame은 같은 실행 엔진을 공유하므로 어느 쪽으로 표현하든 서로 오갈 수 있다.
createOrReplaceTempView()명령어를 통해 DataFrame을 SQL에서 처리할 수 있도록 처리해준다.
- DataFrame을 생성하고 SQL을 사용해 처리할 수 있으며 그 결과를 다시 DataFrame으로 돌려받는다.
spark.read.json("./data/flight-data/json/2015-summary.json"
    ).createOrReplaceTempView("some_sql_view")

spark.sql("""
    SELECT DEST_COUNTRY_NAME, sum(count)
    FROM some_sql_view
    GROUP BY DEST_COUNTRY_NAME"""
    ).where("DEST_COUNTRY_NAME like 'S%'"
    ).where("'sum(count)' > 10"
    ).count()
4.3 스파크 SQL 쓰리프트 JDBC/ODBC 서버
- 스파크는 자바 데이터베이스 연결(Java Database Connectivity, JDBC) 인터페이스를 제공한다.
- 사용자나 원격 프로그램은 스파크 SQL을 실행하기 위해 이 인터페이스로 스파크 드라이버에 접속한다.
- JDBC/ODBC(Open Database Connectivity) 서버를 시작하려면 다음 명령을 실행한다.
- 이 스크립트는
bin/spark-submit스크립트에서 사용할 수 있는 모든 명령행 옵션을 지원한다.
- 이 스크립트는
$ ./sbin/start-thriftserver.sh
- 환경변수나 시스템 속성을 지정해 쓰리프트 서버의 주소를 변경할 수 있다.
- 환경 변수는 다음과 같이 설정한다.
$ export HIVE_SERVER2_THRIFT_PORT=<listening-port>
$ export HIVE_SERVER2_THRIFT_BIND_HOST=<listening-host>
$ ./sbin/start-thriftserver.sh \
    --master <master.sh> \
...
- 시스템 속성은 다음과 같이 설정한다.
$ ./sbin/start-thriftserver.sh \
    --hiveconf hive.server2.thrift.port=<listening-port> \
    --hiveconf hive.server2.thrift.bind.host=<listening-host> \
    --master <master-uri>
    ...
- 서버가 시작되면 다음 명령을 사용해 접속 테스트를 한다.
$ ./bin/beeline
-
실행결과

5. 카탈로그
- 스파크 SQL에서 가장 높은 추상화 단계는 카탈로그(catalog)이다.
- 카탈로그는 테이블에 저장된 데이터에 대한 메타데이터뿐만 아니라 데이터베이스, 테이블, 함수 그리고 뷰에 대한 정보를 추상화한다.
- 카탈로그는
org.apache.spark.sql.catalog.Catalog패키지로 사용할 수 있다. - 카탈로그는 테이블, 데이터베이스 그리고 함수를 조회하는 등 여러 가지 유용한 함수를 제공한다.
6. 테이블
- 스파크 SQL을 사용해 유용한 작업을 수행하려면 먼저 테이블을 정의해야 한다.
- DataFrame은 프로그래밍 언어로 정의하지만 테이블은 데이터베이스에서 정의한다.
- 스파크에서 테이블을 생성하면 default 데이터베이스에 등록된다.
6.1 스파크 관리형 테이블
- 관리형 테이블과 외부 테이블의 개념은 반드시 알아야 한다.
- 테이블은 테이블의 데이터와 테이블에 대한 데이터(메타데이터)인 2가지 중요한 정보를 저장한다.
- 스파크는 데이터뿐만 아니라 파일에 대한 메타데이터를 관리할 수 있다.
- 디스크에 저장된 파일을 이용해 테이블을 정의하면 외부 테이블을 정의하는 것이다.
-
DataFrame의 saveAsTable 메서드는 스파크가 관련된 모든 정보를 추적할 수 있는 관리형 테이블을 만들 수 있다.
- saveAsTable 메서드는 테이블을 읽고 데이터를 스파크 포맷으로 변환한 후 새로운 경로에 저장한다.
- 데이터 저장 경로를 변경하려면 SparkSession을 생성할 때
spark.sql.warehouse.dir속성에 원하는 디렉터리 경로를 설정한다. - 기본 저장 경로는
/user/hive/warehouse이다.
- 데이터 저장 경로를 변경하려면 SparkSession을 생성할 때
6.2 테이블 생성하기
- 스파크는 SQL에서 전체 데이터소스 API를 재사용할 수 있는 독특한 기능을 지원한다.
- 즉, 테이블을 정의한 다음 테이블에 데이터를 적재할 필요가 없다.
- 스파크는 실행 즉시 테이블을 생성한다.
- 다음은 항공운항 데이터를 읽는 예제이다.
;는 커맨드를 종료시켜 준다.
USING 구문을 통해 포맷을 지정하지 않으면 스파크는 기본적으로 하이브 SerDe 설정을 사용한다. 하이브 사용자는 STORED AS 구문으로 하이브 테이블을 생성한다.
CREATE TABLE flights (
    DEST_COUNTRY_NAME STRING, ORIGIN_COUNTRY_NAME STRING, count LONG
)
USING JSON OPTIONS (path './data/flight-data/json/2015-summary.json');
- 테이블의 특정 컬럼에 코멘트(comment)를 추가해 다른 개발자의 이해를 도울 수 있다.
CREATE TABLE flights_csv (
    DEST_COUNTRY_NAME STRING,
    ORIGIN_COUNTRY_NAME STRING COMMENT "remember, the US will be most prevalent",
    count LONG
)
USING csv OPTIONS (header true, path './data/flight-data/csv/2015-summary.csv');
- 또한 SELECT 쿼리의 결과를 이용해 테이블을 생성할 수도 있다.
CREATE TABLE flights_from_select USING parquet AS SELECT * FROM flights;
- 파티셔닝된 데이터셋을 저장해 데이터 레이아웃을 제어할 수 있다.
CREATE TABLE partitioned_flights
USING parquet PARTITIONED BY (DEST_COUNTRY_NAME) AS SELECT DEST_COUNTRY_NAME, ORIGIN_COUNTRY_NAME, count FROM flights LIMIT 5;
6.3 외부 테이블 생성하기
- 하이브(Hive)는 초기 빅데이터 SQL 시스템 중 하나였다.
- 기존 하이브 쿼리문을 스파크 SQL로 변환해야 하는 상황을 만날 수도 있는데, 대부분의 하이브 쿼리문을 스파크 SQL에서 바로 사용할 수 있다.
- 다음은 외부 테이블(unmanaged table)을 생성하는 예제이다.
- 스파크는 외부 테이블의 메타데이터를 관리한다.
- 하지만 데이터 파일은 스파크에서 관리하지 않는다.
- CREATE EXTERNAL TABLE 구문을 사용해 외부 테이블을 생성할 수 있다.
CREATE EXTERNAL TABLE hive_flights (
    DEST_COUNTRY_NAME STRING, ORIGIN_COUNTRY_NAME STRING,
    count LONG
)
ROW FORMAT DELIMITED FIELDS TERMINATED BY ',' LOCATION './data/flight-data-hive/';
- 또한 SELECT 쿼리의 결과를 이용해 외부 테이블을 생성할 수 있다.
CREATE EXTERNAL TABLE hive_flights_2
ROW FORMAT DELIMITED FIELDS TERMINATED BY ','
LOCATION './data/flight-data-hive/' AS SELECT * FROM flights;
6.4 테이블에 데이터 삽입하기
INSERT INTO flights_from_select
 SELECT DEST_COUNTRY_NAME, ORIGIN_COUNTRY_NAME, count
 FROM flights LIMIT 20;
- 특정 파티션에만 저장하고 싶은 경우 파티션 명세를 추가할 수도 있다.
INSERT INTO partitioned_flights
 PARTITION (DEST_COUNTRY_NAME="UNITED STATES")
 SELECT ORIGIN_COUNTRY_NAME, count FROM flights
 WHERE DEST_COUNTRY_NAME= 'UNITED STATES' LIMIT 12;
6.5 테이블 메타데이터 확인하기
- DESCRIBE 구문은 테이블의 메타데이터 정보를 반환한다.
DESCRIBE TABLE flights_csv;
-
실행결과

-
다음 명령을 사용해 파티셔닝 스키마 정보를 확인할 수 있다.
SHOW PARTITIONS partitioned_flights;
-
실행결과

6.6 테이블 메타데이터 갱신하기
- 테이블 메타데이터를 갱신할 수 있는 2가지 명령이 있다.
- REFRESH TABLE 구문은 테이블과 관련된 모든 캐싱된 항목을 갱신한다.
- 테이블이 이미 캐싱되어 있다면 다음번 스캔이 동작하는 시점에 다시 캐싱한다.
REFRESH table partitioned_flights;
- REPAIR TABLE 구문은 카탈로그에서 관리하는 테이블의 파티션 정보를 새로 고친다.
- 이 명령은 새로운 파티션 정보를 수집하는 데 초점을 맞춘다.
MSCK REPAIR TABLE partitioned_flights;
6.7 테이블 제거하기
- 테이블은 삭제(delete)할 수 없고 오로지 제거(drop)만 할 수 있다.
- DROP 키워드를 사용해 테이블을 제거한다.
- DROP TABLE IF EXISTS 구문을 사용해 테이블이 존재하는 경우에만 제거한다.
DROP TABLE flights_csv;

-- 테이블이 존재하는 경우에만 제거
DROP TABLE IF EXISTS flights_csv;
6.8 테이블 캐싱하기
- 테이블을 캐시하거나 캐시에서 제거할 수 있다.
CACHE TABLE flights;

UNCACHE TABLE flights;
7. 뷰
- 뷰(view)는 기존 테이블에 여러 트랜스포메이션 작업을 지정한다.
- 뷰는 단순 쿼리 실행 계획일 뿐이다.
- 뷰를 사용하면 쿼리 로직을 체계화하거나 재사용하기 편하게 만들 수 있다.
- 뷰는 데이터베이스에 설정하는 전역 뷰나 세션별 뷰가 될 수 있다.
7.1 뷰 생성하기
- 신규 경로에 모든 데이터를 다시 저장하는 대신 단순하게 쿼리 시점에 데이터소스에 트랜스포메이션을 수행한다.
filter,select,GROUP BY,ROLLUP같은 트랜스포메이션이 이에 해당한다.
- 다음은 목적지가 United States인 항공운항 데이터를 보기 위한 뷰를 생성하는 예제이다.
CREATE VIEW just_usa_view AS
 SELECT * FROM flights WHERE dest_country_name = "United States";
- 테이블처럼 데이터베이스에 등록되지 않고 현재 세션에서만 사용할 수 있는 임시 뷰를 만들 수 있다.
CREATE TEMP VIEW just_usa_view_temp AS
 SELECT * FROM flights WHERE dest_country_name = "United States";
- 전역적 임시 뷰(global temp view)는 데이터베이스에 상관없이 사용할 수 있으므로 전체 스파크 애플리케이션에서 볼 수 있다.
- 하지만 세션이 종료되면 뷰도 사라진다.
CREATE GLOBAL TEMP VIEW just_usa_view_temp AS
 SELECT * FROM flights WHERE dest_country_name = "United States";

SHOW TABLES;
-
실행결과

-
CREATE OR REPLACE를 사용해 생성된 뷰를 덮어쓸 수 있다.
CREATE OR REPLACE TEMP VIEW just_usa_view_temp AS
 SELECT * FROM flights WHERE dest_country_name = "United States";
- 이제 다른 테이블과 동일한 방식으로 뷰를 사용할 수 있다.
SELECT * FROM just_usa_view_temp;
- 뷰는 실질적으로 트랜스포메이션이며 스파크는 쿼리가 실행될 때만 뷰에 정의된 트랜스포메이션을 수행한다.
- 뷰는 기존 DataFrame에서 새로운 DataFrame을 만드는 것과 동일하다.
- 즉, 테이블의 데이터를 실제로 조회하는 경우에만 필터를 적용한다.
7.2 뷰 제거하기
- 뷰를 제거하면 어떤 데이터도 제거되지 않으며 뷰 정의만 제거된다.
DROP VIEW IF EXISTS just_usa_view;
스파크 SQL에서 테이블과 뷰를 구성해 쿼리를 실행하는 기본 구조를 살펴보았다면, 이제 테이블들을 체계적으로 격리하고 조직화하는 데이터베이스 관리부터 고급 SELECT 구문, 복합 데이터 타입, 사용자 정의 함수(UDF), 그리고 서브쿼리까지 확장된 SQL 고급 활용법을 살펴본다.
8. 데이터베이스
- 데이터베이스(database)는 여러 테이블을 조직화하기 위한 도구이다.
- 스파크에서 실행하는 모든 SQL 명령문은 사용 중인 데이터베이스 범위에서 실행된다.
그전에, 관련 데이터가
spark-3.3.0/spark-warehouse/data에 있는지 확인해본다.
- 다음은 전체 데이터베이스 목록을 확인할 수 있다.
SHOW DATABASES;
-
실행결과

8.1 데이터베이스 생성하기
- CREATE DATABASE 키워드를 사용해 데이터베이스를 설정한다.
CREATE DATABASE some_db;
8.2 데이터베이스 사용하기
- USE 키워드를 사용해 쿼리 수행에 필요한 데이터베이스를 설정한다.
- 모든 쿼리는 테이블 이름을 찾을 때 앞서 지정한 데이터베이스를 참조한다.
USE some_db;
- 첫 번째 코드를 사용해 다른 데이터베이스의 테이블에 쿼리를 수행할 수 있다.
- 두 번째 코드를 사용해 현재 어떤 데이터베이스를 사용 중인지 확인할 수 있다.
- 세 번째 코드를 사용해 기본 데이터베이스로 돌아갈 수 있다.
SELECT * FROM default.flights;

SELECT current_database();

USE default;
8.3 데이터베이스 제거하기
- DROP DATABASE 키워드를 사용해 데이터베이스를 제거한다.
DROP DATABASE IF EXISTS some_db;
9. select 구문
- 스파크 쿼리는 다음과 같이 ANSI-SQL 요건을 충족한다.
SELECT [ALL|DISTINCT] name_expression[, named_expression, ...]
    FROM relation [, relation, ...]
    [lateral_view[, lateral_view, ...]]
    [WHERE boolean_expression]
    [aggregation [HAVING boolean_expression]]
    [ORDER BY sort_expressions]
    [CLUSTER BY expressions]
    [DISTRIBUTE BY expressions]
    [SORT BY sort_expressions]
    [WINDOW named_window[, WINDOW named_window, ...]]

named_expressions:
  : expression [AS alias]

relation:
  | join_relation
  | (table_name|query|relation) [sample] [AS alias]
  : VALUES (expressions)[, (expressions), ...]
    [AS (column_name[, column_name, ...])]

expressions:
  : expression[, expression, ...]

sort_expressions:
  : expression [ASC|DESC][, expression [ASC|DESC], ...]
9.1 case…when…then 구문
case...when...then...end구문을 사용해 조건에 맞는 처리를 할 수 있다.- 다음 구문은 프로그래밍의 if 구문과 동일한 처리를 한다.
SELECT
  CASE WHEN DEST_COUNTRY_NAME = 'UNITED STATES' THEN 1
       WHEN DEST_COUNTRY_NAME = 'Egypt' THEN 0
       ELSE -1 END
FROM partitioned_flights;
10. 고급 주제
- SQL 쿼리는 특정 명령 집합을 실행하도록 요청하는 SQL 구문이다.
- SQL 구문은 조작(manipulation), 정의(definition), 제어(control)와 관련된 명령을 정의할 수 있다.
10.1 복합 데이터 타입
- 복합 데이터 타입은 표준 SQL에는 없는 스파크 SQL만의 기능이다.
- 스파크 SQL에는 구조체(structs), 리스트(lists), 맵(maps) 3가지 핵심 복합 데이터 타입이 존재한다.
구조체
- 구조체는 맵에 더 가까우며 스파크에서 중첩 데이터를 생성하거나 쿼리하는 방법을 제공한다.
- 구조체를 만들기 위해서는 여러 컬럼이나 표현식을 괄호로 묶기만 하면 된다.
CREATE VIEW IF NOT EXISTS nested_data AS
  SELECT (DEST_COUNTRY_NAME, ORIGIN_COUNTRY_NAME) as country, count FROM flights;
- 점을 사용해 구조체의 개별 컬럼을 조회할 수 있다.
SELECT country.DEST_COUNTRY_NAME, count FROM nested_data;
- 구조체의 이름과 모든 하위 컬럼을 지정해 모든 값을 조회할 수 있다.
SELECT country.*, count FROM nested_data;
리스트
- 값의 리스트를 만드는 collect_list 함수나 중복 값이 없는 배열을 만드는 collect_set 함수를 사용할 수 있다.
- 두 함수는 모두 집계(aggregation) 함수이므로 집계 연산 시에만 사용할 수 있다.
SELECT DEST_COUNTRY_NAME as new_name, collect_list(count) as flight_counts, collect_set(ORIGIN_COUNTRY_NAME) as origin_set
FROM flights GROUP BY DEST_COUNTRY_NAME;
- 컬럼에 직접 배열을 생성할 수도 있다.
SELECT DEST_COUNTRY_NAME, ARRAY(1, 2, 3) FROM flights;
- 배열 쿼리 구문을 사용해 리스트의 특정 위치의 데이터를 쿼리할 수 있다.
SELECT DEST_COUNTRY_NAME as new_name,  collect_list(count)[0]
FROM flights GROUP BY DEST_COUNTRY_NAME;
- explode 함수를 사용해 배열을 다시 여러 로우로 변환할 수 있다.
- 이 함수를 사용해 저장된 배열의 모든 값을 단일 로우 형태로 분해한다.
CREATE OR REPLACE TEMP VIEW flights_agg AS
  SELECT DEST_COUNTRY_NAME, collect_list(count) as collected_counts
  FROM flights GROUP BY DEST_COUNTRY_NAME;

SELECT explode(collected_counts), DEST_COUNTRY_NAME FROM flights_agg;
10.2 함수
- 스파크 SQL은 복합 데이터 타입 외에도 다양한 고급 함수를 제공한다.
- 스파크 SQL이 제공하는 전체 함수 목록을 확인하려면
SHOW FUNCTIONS구문을 사용한다.
SHOW FUNCTIONS;
사용자 정의 함수
- 스파크는 사용자 정의 함수를 정의하고 분산 환경에서 사용할 수 있는 기능을 제공한다.
- 특정 언어를 사용해 함수를 개발한 다음, 등록하여 함수를 정의할 수 있다.
- 스칼라 사용자 함수 정의 :
def [func id]([param id]: [type], …): [type] = { [function] }2
- 스칼라 사용자 함수 정의 :
def power3(number:Double):Double = number * number * number
spark.udf.register("power3", power3(_:Double):Double)
SELECT count, power3(count) FROM flights;
10.3 서브쿼리
- 서브쿼리(subquery)를 사용하면 쿼리 안에 쿼리를 지정할 수 있다.
- 스파크에는 2가지 기본 서브쿼리가 있다.
- 상호 연관 서브쿼리(correlated subquery)는 서브쿼리의 정보를 보완하기 위해 쿼리의 외부 범위에 있는 외부 정보를 사용할 수 있다.
- 조건절 서브쿼리(predicate subquery)는 값에 따라 필터링할 수 있게 해준다.
비상호연관 조건절 서브쿼리
- 첫 번째 비상호연관 쿼리는 데이터 중 상위 5개의 목적지 국가 정보를 조회한다.
SELECT dest_country_name FROM flights
GROUP BY dest_country_name ORDER BY sum(count) DESC LIMIT 5;
-
실행결과

-
이제 서브쿼리를 필터 내부에 배치하고 이전 예제의 결과에 출발지 국가 정보가 존재하는지 확인할 수 있다.
- 이 쿼리는 쿼리의 외부 범위에 있는 어떤 관련 정보도 사용하고 있지 않으므로 비상호연관 관계이다.
SELECT * FROM flights
WHERE origin_country_name IN (SELECT dest_country_name FROM flights
      GROUP BY dest_country_name ORDER BY sum(count) DESC LIMIT 5);
상호연관 조건절 서브쿼리
- 상호연관 조건절 서브쿼리는 내부 쿼리에서 외부 범위에 있는 정보를 사용할 수 있다.
- ex. 목적지 국가에서 되돌아올 수 있는 항공편이 있는지 알고 싶다면 목적지 국가를 출발지 국가로, 출발지 국가를 목적지 국가로 하여 항공편이 있는지 확인한다.
SELECT * FROM flights f1
WHERE EXISTS (SELECT 1 FROM flights f2
            WHERE f1.dest_country_name = f2.origin_country_name)
AND EXISTS (SELECT 1 FROM flights f2
            WHERE f2.dest_country_name = f1.origin_country_name);
비상호연관 스칼라 쿼리
- 비상호연관 스칼라 쿼리(uncorrelated scalar query)를 사용하면 기존에 없던 일부 정보를 가져올 수 있다.
SELECT *, (SELECT max(count) FROM flights) AS maximum FROM flights;
11. 한계와 트레이드오프
- 스파크 SQL은 OLAP 엔진이므로 밀리초 단위 응답이 필요한 트랜잭션성 질의에는 쓰지 않는다. 조회 지연은 클러스터 구성과 데이터 크기에 따라 달라진다.
- 뷰는 실행 계획만 저장하고 데이터를 물리적으로 복제하지 않으므로, 조회할 때마다 정의된 변환을 다시 수행한다. 같은 결과를 반복 조회해야 한다면 결과를 별도 테이블로 적재하는 편이 낫다.
- 관리형 테이블은
DROP TABLE시 테이블 디렉터리까지 함께 지워지지만, 외부 테이블은 메타데이터만 지워지고 원본 파일은 남는다. 삭제 범위가 다르므로 제거 전에 테이블 유형을 확인해야 한다. 3 - 하이브 메타스토어를 직접 붙일 때는
spark.sql.hive.metastore.version·spark.sql.hive.metastore.jars를 메타스토어 버전에 맞춰야 한다. 버전이 어긋나면 테이블 메타데이터를 제대로 읽지 못할 수 있다. 4 - 이 글의 실행 결과는 스파크 3.3.0 · 로컬 하이브 메타스토어 · 책의 항공운항 요약 데이터라는 조건에서 얻은 것이다. 클러스터 규모나 메타스토어 버전이 다르면 동작과 지연 시간은 달라질 수 있다.
핵심 정리
- OLAP 엔진으로서의 스파크 SQL: 스파크 SQL은 하이브 메타스토어를 사용해 하이브 테이블의 메타데이터를 그대로 읽으며, DataFrame/Dataset API와 동일한 카탈리스트(Catalyst) 최적화 코드로 컴파일된다. 다만 OLTP가 아닌 OLAP 엔진이므로 낮은 지연 시간이 필요한 질의에는 쓰지 않는다.
- 다양한 실행 인터페이스: 로컬 대화형 CLI(
spark-sql), SparkSession의spark.sql()프로그래밍 API, 그리고 BI/원격 연동을 위한 쓰리프트 JDBC/ODBC 서버(beeline)를 지원한다. - 카탈로그와 메타데이터: 카탈로그는 데이터베이스, 테이블, 뷰, 함수를 총괄 추상화하며,
DESCRIBE,REFRESH,MSCK REPAIR구문으로 메타데이터와 파티션을 동기화한다. - 관리형 vs 외부 테이블: 스파크가 데이터와 메타데이터를 모두 관리하는 관리형 테이블(
saveAsTable)과 메타데이터만 관리하고 원본 스토리지를 유지하는 외부 테이블(CREATE EXTERNAL TABLE)로 구분된다. - 뷰를 통한 쿼리 추상화: 뷰는 물리 데이터를 복제하지 않는 지연 평가 기반 쿼리 실행 계획이며, 세션 임시 뷰와 애플리케이션 전역 임시 뷰(
global_temp)로 분리해 재사용할 수 있다. - 데이터베이스 격리 및 ANSI-SQL: 여러 테이블을 네임스페이스 단위로 조직화하며,
CASE...WHEN등 ANSI-SQL의 SELECT 구문을 지원한다. - 복합 데이터 타입과 분해: 구조체(
struct), 리스트(collect_list,collect_set),explode함수를 통해 중첩 반정형 데이터를 자유롭게 조작하고 평탄화한다. - UDF 확장과 서브쿼리 최적화: 스칼라 등으로 작성한 사용자 정의 함수를 카탈로그에 등록해 SQL에서 호출할 수 있으며, 조건절·스칼라·상호연관 서브쿼리를 통해 유연한 필터링 연산을 지원한다.
댓글남기기