
[Spark] 집계 연산, 함수, SQL 명령어 정리
 [Spark The Definitive Guide - BIG DATA PROCESSING MADE SIMPLE] 책을 중심으로 스파크를 개인 공부를 위해 요약 및 정리해보았습니다. 다소 복잡한 설치 과정은 도커에 미리 이미지를 업로드해 놓았습니다. 즉, 도커 이미지를 pull하면 바로 스파크를 사용할 수 있습니다.
- 도커 설치 및 활용하는 방법 : [Spark] 빅데이터와 아파치 스파크란 - 1.2 스파크 실행하기
- 도커 이미지 링크 : https://hub.docker.com/r/ingu627/hadoop
- 예제를 위한 데이터 링크 : FVBros/Spark-The-Definitive-Guide
예제에 대한 실행 언어는 스칼라(scala)로 했습니다. 앞으로 스파크와 관련된 내용은 딥러닝 부분을 제외하고 스칼라로 진행될 예정입니다.
기본 실행 방법
- 예제에 사용 될 데이터들은 도커 이미지 생성 후
spark-3.3.0안의 하위 폴더data를 생성 후, 이 폴더에 추가합니다. 1.1 데이터와 도커 설치 및 활용하는 방법은 위에 링크를 남겼습니다. - 프로그램 시작은
cd spark-3.3.0후,./bin/spark-shell명령어를 실행하시면 됩니다.
1. 집계 연산
- 집계(aggregation)는 무언가를 함께 모으는 행위이다.
- 집계를 수행하려면 키(key)나 그룹(group)을 지정하고 하나 이상의 컬럼을 변환하는 방법을 지정하는 집계 함수(aggregation func)를 사용한다.
-
집계 함수는 여러 입력값이 주어지면 그룹별로 결과를 생성한다.
- 스파크는 모든 데이터 타입을 다루는 것 외에도 다음과 같은 그룹화 데이터 타입을 생성할 수 있다. 1
- 가장 간단한 형태의 그룹화는 select 구문에서 집계를 수행해 DataFrame의 전체 데이터를 요약하는 것이다.
- group by는 하나 이상의 키를 지정할 수 있으며, 값을 가진 컬럼을 변환하기 위해 다른 집계 함수를 사용할 수 있다.
- 윈도우(window)는 하나 이상의 키를 지정할 수 있으며, 값을 가진 컬럼을 변환하기 위해 다른 집계 함수를 사용할 수 있다.
- 그룹화 셋(grouping set)은 서로 다른 레벨의 값을 집계할 때 사용한다.
- 롤업(rollup)은 하나 이상의 키를 지정할 수 있다. 그리고 컬럼을 변환하는 데 다른 집계 함수를 사용하여 계층적으로 요약된 값을 구할 수 있다.
- 큐브(cube)는 모든 컬럼 조합에 대한 요약 값을 계산한다.
- 구매 이력 데이터를 사용해 파티션 수를 5개로 줄이도록 리파티셔닝하고, 빠르게 접근할 수 있도록 캐싱(caching)한다.
coalesce는 셔플 없이 파티션을 합치는 연산이므로 파티션 수를 늘리는 용도로는 쓸 수 없다. 늘려야 한다면 셔플을 동반하는repartition을 사용한다. 2
val df = spark.read.format("csv"
    ).option("header", "true"
    ).option("inferSchema", "true"
    ).load("./data/retail-data/all/*.csv"
    ).coalesce(5)

df.cache()
df.createOrReplaceTempView("dfTable")
- DataFrame을 사용해 기본 집계를 수행해본다.
- count 메서드는 데이터셋의 전체 크기를 알아보는 용도로 사용하지만 메모리에 DataFrame 캐싱 작업을 수행하는 용도로 사용되기도 한다.
df.count() == 541909
-
실행결과

-
스파크 웹 UI의 SQL / DataFrame 탭에서는 DataFrame과 SQL 쿼리가 어떤 계획으로 실행되는지 그래프로 확인할 수 있다.
- 아래는
GROUP BY집계 쿼리의 실행 계획이다. 집계가HashAggregate(부분 집계) →Exchange(셔플) →HashAggregate(최종 집계) 순서로 수행되는 것을 볼 수 있다.
- 아래는
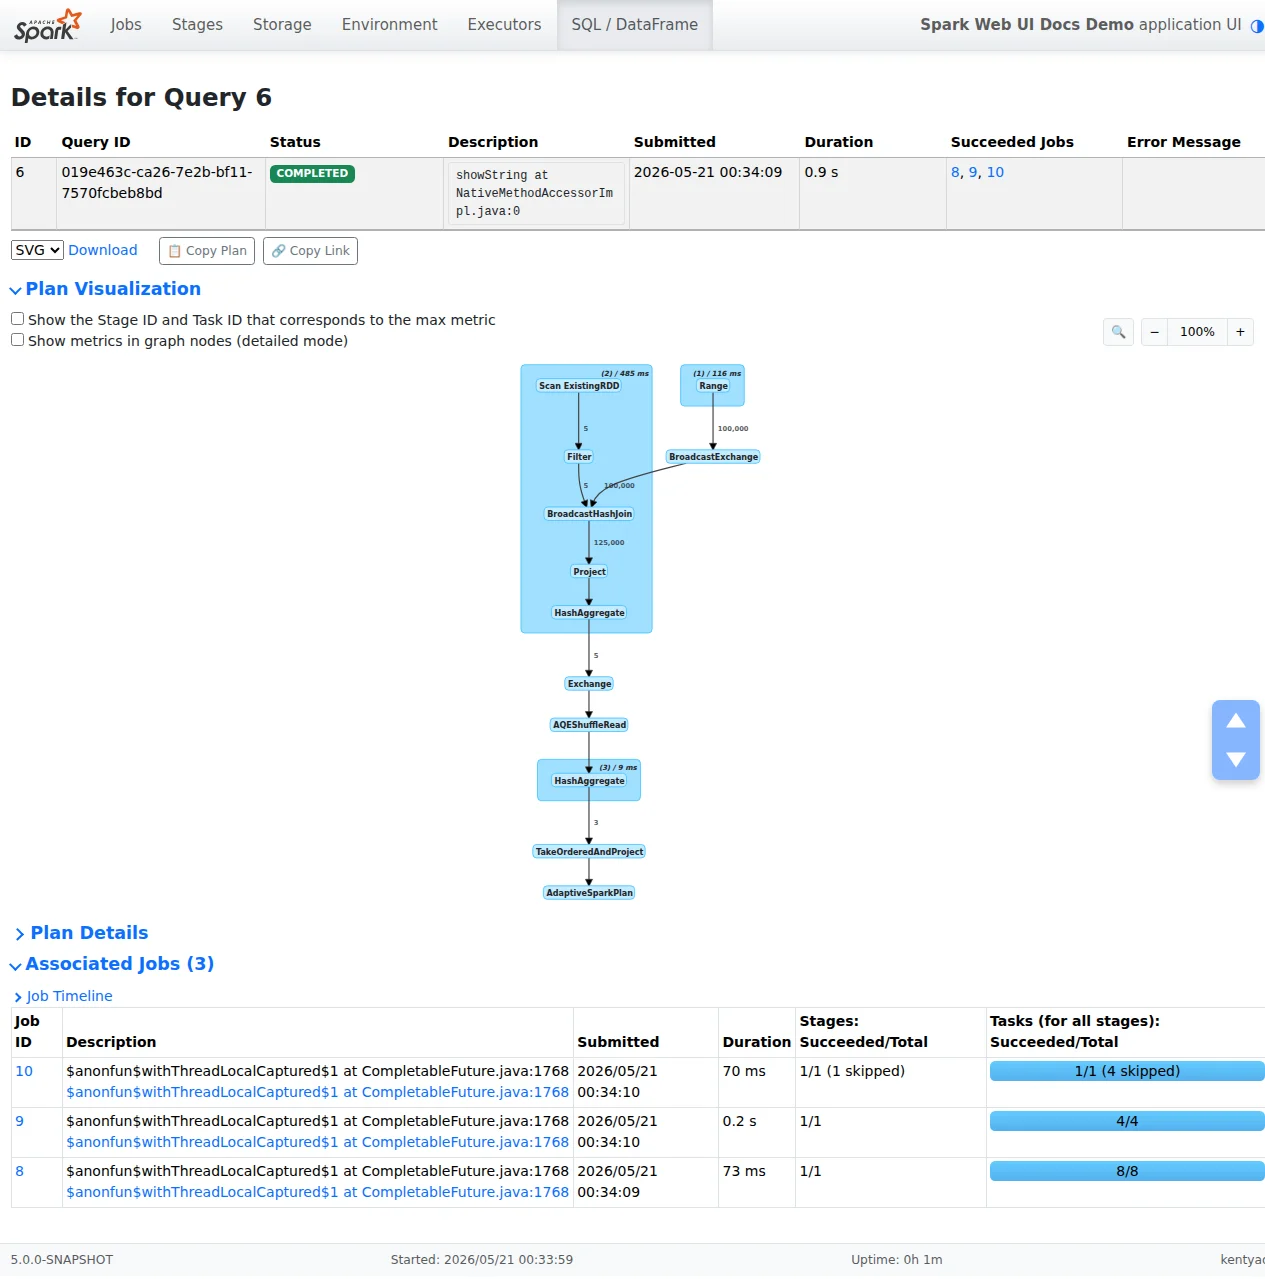
출처: Apache Spark Documentation - Web UI, SQL Plan Visualization (https://spark.apache.org/docs/latest/web-ui.html), Apache License 2.0
2. 집계 함수
- 집계 함수는 org.apache.spark.sql.functions API(클릭)에서 찾아볼 수 있다.
2.1 count
- count 함수는 2가지 방식으로 사용할 수 있다.
- 하나는 count 함수에 특정 컬럼을 지정하는 방식이고, 다른 하나는
count(*)나count(1)을 사용하는 방식이다. - 다음 예제에서
count함수는 액션이 아닌 트랜스포메이션으로 동작한다.
import org.apache.spark.sql.functions.count

df.select(count("StockCode")).show()
-
실행결과

2.2 countDistinct
- 전체 레코드 수가 아닌 고유 레코드 수를 구해야 한다면 countDistinct 함수를 사용한다.
- 이 함수는 개별 컬럼을 처리하는 데 적합하다.
import org.apache.spark.sql.functions.countDistinct

df.select(countDistinct("StockCode")).show()
-
실행결과

2.3 approx_count_distinct
- 어느 정도 수준의 정확도를 가지는 근사치만으로도 유의미하다면 approx_count_distinct 함수를 사용해 근사치를 계산할 수 있다.
- 이 함수는 근사치의 정확도를 조절하는 파라미터를 하나 더 사용한다. 원서에서는 최대 추정 오류율(maximum estimation error)이라고 설명하고, 현재 API 문서에서는 허용 가능한 최대 상대표준편차(maximum relative standard deviation,
rsd, 기본값0.05)로 정의한다. 아래 예제는0.1을 지정한다. 3 - countDistinct 함수가 고윳값을 정확히 세는 것과 달리, approx_count_distinct는 근사치를 반환하는 대신 countDistinct보다 빠르게 결과를 낸다. 데이터 규모가 커질수록 두 함수의 차이가 커진다.
- 결과가 근사치이므로 정확한 고유 개수가 필요한 집계(예: 정산·과금)에는 countDistinct를 사용해야 한다.
- 이 함수는 근사치의 정확도를 조절하는 파라미터를 하나 더 사용한다. 원서에서는 최대 추정 오류율(maximum estimation error)이라고 설명하고, 현재 API 문서에서는 허용 가능한 최대 상대표준편차(maximum relative standard deviation,
import org.apache.spark.sql.functions.approx_count_distinct

df.select(approx_count_distinct("StockCode", 0.1)).show()
-
실행결과

2.4 first와 last
- first와 last 함수는 DataFrame의 첫 번째 값이나 마지막 값을 얻을 때 사용한다.
- 이들 함수는 DataFrame의 값이 아닌 로우를 기반으로 동작한다.
import org.apache.spark.sql.functions.{first, last}

df.select(first("StockCode"), last("StockCode")).show()
-
실행결과

2.5 min과 max
- DataFrame에서 최솟값과 최댓값을 추출하려면 min과 max 함수를 사용한다.
import org.apache.spark.sql.functions.{min, max}

df.select(min("Quantity"), max("Quantity")).show()
-
실행결과

2.6 sum
- sum함수는 DataFrame에서 특정 컬럼의 모든 값을 합산해준다.
import org.apache.spark.sql.functions.sum

df.select(sum("Quantity")).show()
-
실행결과

2.7 sumDistinct
- sumDistinct 함수를 사용해 고윳값을 합산할 수 있다.
import org.apache.spark.sql.functions.sumDistinct

df.select(sumDistinct("Quantity")).show()
-
실행결과

2.8 avg
- avg 함수나 mean함수를 사용하여 평균값을 구한다.
- 다음 예제는 집계된 컬럼을 재사용하기 위해
alias메서드를 사용한다.
import org.apache.spark.sql.functions.{sum, count, avg, expr}

df.select(
  count("Quantity").alias("total_transactions"),
  sum("Quantity").alias("total_purchases"),
  avg("Quantity").alias("avg_purchases"),
  expr("mean(Quantity)").alias("mean_purchases")
).selectExpr(
  "total_purchases/total_transactions",
  "avg_purchases",
  "mean_purchases"
).show()
-
실행결과

2.9 분산과 표준편차
- 분산(variance)은 평균과의 차이를 제곱한 결과의 평균이다.
- 표준편차(standard deviation)은 분산의 제곱근이다.
- 모표준편차(population standard deviation)와 표본표준편차(sample standard deviation)는 다른 통계 방식이므로 구분해서 사용해야 한다.
import org.apache.spark.sql.functions.{var_pop, var_samp, stddev_pop, stddev_samp}

df.select(var_pop("Quantity"), var_samp("Quantity"),
stddev_pop("Quantity"), stddev_samp("Quantity")).show()
-
실행결과

2.10 왜도와 첨도
- 왜도(skewness)와 첨도(kurtosis) 모두 데이터의 변곡점(extreme point)을 측정하는 방법이다.
- 왜도(skewness)는 데이터 평균의 비대칭 정도를 측정하고, 첨도(kurtosis)는 데이터 끝 부분을 측정한다.
- 왜도와 첨도는 확률변수(random variable)의 확률분포(probability distribution)로 데이터를 모델링할 때 특히 중요하다.


import org.apache.spark.sql.functions.{skewness, kurtosis}

df.select(skewness("Quantity"), kurtosis("Quantity")).show()
-
실행결과

2.11 공분산과 상관관계
- cov 함수는 공분산(covariance)을 계산할 수 있는데, 공분산은 데이터 입력값에 따라 다른 범위를 가진다.
- 2개의 확률변수의 선형 관계를 나타내는 값이다.
- covar_pop : 2개의 확률 변수의 모 공분산을 계산한다.
- covar_samp : 2개의 확률 변수의 표본 공분산을 계산한다.
- 공분산은 값의 단위(스케일)에 따라 크기가 달라지므로, 서로 다른 변수 쌍의 공분산 값을 직접 비교하기는 어렵다.
- corr 함수는 상관관계(correlation)를 계산할 수 있는데, 상관관계는 피어슨 상관계수(Pearson correlation coefficient)를 측정하며 -1과 1 사이의 값을 가진다.
- 피어슨 상관계수는 두 변수의 선형 관계만 측정하므로, 관계가 비선형이면 상관계수가 0에 가깝게 나올 수 있다.
import org.apache.spark.sql.functions.{corr, covar_pop, covar_samp}

df.select(
  corr("InvoiceNo", "Quantity"),
  covar_samp("InvoiceNo", "Quantity"),
  covar_pop("InvoiceNo", "Quantity")).show()
-
실행결과

2.12 복합 데이터 타입의 집계
- 스파크는 수식을 이용한 집계뿐만 아니라 복합 데이터 타입을 사용해 집계를 수행할 수 있다.
- .agg() : 집계 함수를 인수(argument)로 받아들이는 DataFrame 메서드이다. 6
- 예를 들어 특정 컬럼의 값을 리스트로 수집하거나 set 데이터 타입으로 고윳값만 수집할 수 있다.
import org.apache.spark.sql.functions.{collect_set, collect_list}

df.agg(collect_set("Country"), collect_list("Country")).show()
-
실행결과

댓글남기기