
[Spark] 저수준 API: 키-값 형태의 RDD 고급 연산
 [Spark The Definitive Guide - BIG DATA PROCESSING MADE SIMPLE] 책을 중심으로 스파크를 개인 공부를 위해 요약 및 정리해보았습니다. 다소 복잡한 설치 과정은 도커에 미리 이미지를 업로드해 놓았습니다. 즉, 도커 이미지를 pull하면 바로 스파크를 사용할 수 있습니다.
- 도커 설치 및 활용하는 방법 : [Spark] 빅데이터와 아파치 스파크란 - 1.2 스파크 실행하기
- 도커 이미지 링크 : https://hub.docker.com/r/ingu627/hadoop
- 예제를 위한 데이터 링크 : FVBros/Spark-The-Definitive-Guide
예제에 대한 실행 언어는 SQL과 스칼라(scala)로 했습니다.
기본 실행 방법
- 예제에 사용 될 데이터들은 도커 이미지 생성 후
spark-3.3.0안의 하위 폴더data를 생성 후, 이 폴더에 추가합니다.- 1.1 데이터와 도커 설치 및 활용하는 방법은 위에 링크를 남겼습니다.
- 프로그램 시작은
cd spark-3.3.0후,./bin/spark-shell명령어를 실행하시면 됩니다.
이 글은 Spark The Definitive Guide를 바탕으로 스파크의 저수준 API인 키-값 형태 RDD의 고급 연산을 정리한다. keyBy·lookup·sampleByKey 같은 키-값 연산, countByKey·groupByKey·reduceByKey·aggregateByKey·combineByKey·foldByKey 등의 집계, cogroup·조인, 그리고 coalesce·repartition으로 파티션을 제어하는 방법을 다룬다.
1. RDD 고급 개념
- 이번에는 키-값 형태의 RDD 중심으로 RDD 고급 연산을 알아본다.
- 또한 사용자 정의 파티션 함수를 사용하여 클러스터에 데이터가 배치되는 방식을 정확히 제어해본다.
- 예제에서 사용될 데이터는 다음과 같다.
val myCollection = "Spark The Definitive Guide : Big Data Processing Made Simple".split(" ")
val words = spark.sparkContext.parallelize(myCollection, 2)
이 글에서 다루는 파티션 분산과 드라이버·익스큐터 사이의 작업 분배는 다음 구조 위에서 일어난다.
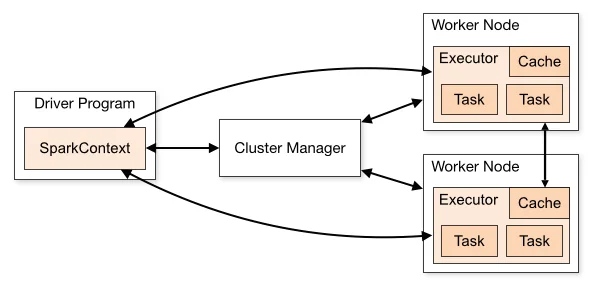
출처: Apache Spark Documentation, “Cluster Mode Overview” (https://spark.apache.org/docs/latest/cluster-overview.html) — Apache License 2.0
2. 키-값 형태의 RDD
- RDD에는 데이터를 키-값 형태로 다룰 수 있는 다양한 메서드가 있는데, 이러한 메서드는
<연산명>ByKey형태의 이름을 가진다. - 메서드 이름에 ByKey가 있다면 PairRDD 타입만 사용할 수 있다.
- PairRDD 타입을 만드는 가장 쉬운 방법은 RDD에 맵 연산을 수행해 키-값 구조로 만드는 것이다.
words.map(word => (word.toLowerCase, 1))
-
실행결과

2.1 keyBy
- 현재 값으로부터 키를 생성하는 keyBy 함수를 사용해 동일한 결과를 얻을 수 있다.
- 다음 예제에서는 단어의 첫 번째 문자를 키로 만들어 RDD를 생성한다.
toSeq: 순서가 존재하는 순서열로 만든다.
val keyword = words.keyBy(word => word.toLowerCase.toSeq(0).toString)
2.2 값 매핑하기
- 생성된 키-값 셋을 사용해 데이터를 다뤄본다.
- 만약 튜플 형태의 데이터를 사용한다면 스파크는 튜플의 첫 번째 요소를 키로, 두 번째 요소를 값으로 추정한다.
- mapValues 메서드를 사용하면 값 수정 시 발생할 수 있는 오류를 미리 방지할 수 있다.
keyword.mapValues(word => word.toUpperCase).collect()
-
실행결과

-
flatMap 함수를 사용해 반환되는 결과의 각 로우가 문자를 나타내도록 확장할 수 있다.
keyword.flatMapValues(word => word.toUpperCase).collect()
-
실행결과

2.3 키와 값 추출하기
- 키-값 형태의 데이터를 가지고 있다면 keys, values 메서드를 사용해 키나 값 전체를 추출할 수 있다.
keyword.keys.collect()
keyword.values.collect()
-
실행결과

2.4 lookup
- lookup 메서드를 사용해서 특정 키에 관한 결과를 찾을 수 있다.
- 그러나 각 입력에 대해 오직 하나의 키만 찾을 수 있도록 강제하는 메커니즘은 없다.
keyword.lookup("s")
-
실행결과

2.5 sampleByKey
- 근사치(approximation)나 정확도(exactly)를 이용해 키를 기반으로 RDD 샘플을 생성할 수 있다.
- 두 작업 모두 특정 키를 부분 샘플링할 수 있으며 선택에 따라 비복원 추출을 사용할 수도 있다.
val distinctChars = words.flatMap(word => word.toLowerCase.toSeq
    ).distinct.collect()

import scala.util.Random

// def toMap [T, U] (implicit ev: <:<[A, (T, U)]) : Map[T, U]
val sampleMap = distinctChars.map(c => (c, new Random().nextDouble())).toMap

words.map(word => (word.toLowerCase.toSeq(0), word)
    ).sampleByKey(true, sampleMap, 6L
    ).collect()
-
실행결과

3. 집계
- 사용하는 메서드에 따라 일반 RDD나 PairRDD를 사용해 집계를 사용할 수 있다.
val chars = words.flatMap(word => word.toLowerCase.toSeq)
val KVcharacters = chars.map(letter => (letter, 1))

def maxFunc(left:Int, right:Int) = math.max(left, right)
def addFunc(left:Int, right:Int) = left + right

// sc = SparkContext
val nums = sc.parallelize(1 to 30, 5)
3.1 countByKey
- countByKey 메서드는 각 키의 아이템 수를 구하고 로컬 맵으로 결과를 수집한다.
countByKey메서드에 제한 시간(timeout)과 신뢰도(confidence)를 인수로 지정해 근사치를 구할 수 있다.
val timeout = 1000L // 밀리세컨트 단위
val confidence = 0.95

KVcharacters.countByKey()
KVcharacters.countByKeyApprox(timeout, confidence)
-
실행결과

3.2 집계 연산 구현 방식 이해하기
- 키-값 형태의 PairRDD를 생성하는 몇 가지 방법이 있다.
- 이때 구현 방식은 잡(job)의 안정성을 위해 중요하다.
3.2.1 groupByKey
- 각 키에 대한 값의 크기가 일정하고 익스큐터(executor)에 할당된 메모리에서 처리 가능할 정도의 크기라면 groupByKey 메서드를 사용한다.
KVcharacters.groupByKey().map(row => (row._1, row._2.reduce(addFunc))).collect()
3.2.2 reduceByKey
- 결괏값을 배열에 모을 수 있도록 합계 함수와 함께 reduceByKey 메서드를 수행한다.
- 이러한 구현 방식은 각 파티션에서 먼저 리듀스하기 때문에 키에 속한 값을 전부 메모리에 유지하지 않아도 되고, 키 편중이 심한 데이터에서도 메모리 부담이 작다.
- 또한 최종 리듀스 과정을 제외한 모든 작업은 개별 워커에서 처리하기 때문에 연산 중에 셔플이 발생하지 않는다.
- 셔플 이전에 파티션 로컬에서 값을 병합하므로, 셔플로 전송되는 레코드 수가 원본 레코드 수가 아니라 파티션별 (키, 병합된 값) 쌍의 수준으로 줄어든다. 그만큼 네트워크와 메모리 사용량이 줄어 groupByKey보다 안정적이며, 실제 향상 폭은 키의 종류 수 대비 레코드 수의 비율에 따라 달라진다.1
KVcharacters.reduceByKey(addFunc).collect()
-
실행결과

3.3 기타 집계 메서드
- 정형 API를 사용하면 간단하게 수행할 수 있으므로 고급 집계 함수를 굳이 사용하지 않아도 된다.
- 하지만 고급 집계 함수를 사용해 클러스터 노드에서 수행하는 집계를 구체적이고 세밀하게 제어할 수 있다.
3.3.1 aggregate
- aggregate 함수는 null 값이나 집계의 시작값이 필요하며 2가지 함수를 파라미터로 사용한다.
- 첫 번째 함수는 파티션 내에서 수행되고, 두 번째 함수는 모든 파티션에 걸쳐 수행된다.
- 두 함수 모두 시작값을 사용한다.
nums.aggregate(0)(maxFunc, addFunc)
// 결과 : 90
aggregate함수는 드라이버에서 최종 집계를 수행하기 때문에 성능에 약간의 영향이 있다.- treeAggregate 함수는 기본적으로 드라이버에서 최종 집계를 수행하기 전에 익스큐터끼리 트리(tree)를 형성해 집계 처리의 일부 하위 과정을 푸시 다운(push down) 방식으로 먼저 수행한다.
- 집계 처리를 여러 단계로 구성하는 것은 드라이버의 메모리를 모두 소비하는 현상을 막는 데 도움이 된다.
val depth = 3
nums.treeAggregate(0)(maxFunc, addFunc, depth)
// 결과 : 90
3.3.2 aggregateByKey
- aggregateByKey 함수는 aggregate 함수와 동일하지만 파티션 대신 키를 기준으로 연산을 수행한다.
KVcharacters.aggregateByKey(0)(addFunc, maxFunc).collect()
-
실행결과

3.3.3 combineByKey
- combineByKey 함수는 집계 함수 대신 컴바이너(combiner)를 사용한다.
- 이 컴바이너는 키를 기준으로 연산을 수행하며 파라미터로 사용된 함수에 따라 값을 병합한다.
- 그런 다음 여러 컴바이너의 결괏값을 병합해(merge) 결과를 반환한다.
val valToCombiner = (value:Int) => List(value)
val mergeValuesFunc = (vals:List[Int], valToAppend:Int) => valToAppend :: vals
val mergeCombinerFunc = (vals1:List[Int], vals2:List[Int]) => vals1 ::: vals2
val outputPartitions = 6

KVcharacters.combineByKey(
    valToCombiner,
    mergeValuesFunc,
    mergeCombinerFunc,
    outputPartitions
).collect()
-
실행결과

3.3.4 foldByKey
- foldByKey 함수는 결합 함수와 항등원(neutral)인 제로값을 이용해 각 키의 값을 병합한다.
- 항등원(neutral) : 어떤 원소와 연산을 취해도 자기 자신이 되게 하는 원소를 의미한다.
- 제로값은 결과에 여러 번 사용될 수 있으나 결과를 변경할 수는 없다.
KVcharacters.foldByKey(0)(addFunc).collect()
-
실행결과

4. cogroup
- cogroup은 최대 3개(스칼라 기준)의 키-값 형태의 RDD를 그룹화할 수 있으며 각 키를 기준으로 값을 결합한다.
- 즉, RDD에 대한 그룹 기반의 조인을 수행한다.
- 그룹화된 키를 키로, 키와 관련된 모든 값을 값으로 하는 키-값 형태의 배열을 결과로 반환한다.
import scala.util.Random

val distinctChars = words.flatMap(word => word.toLowerCase.toSeq).distinct
val charRDD = distinctChars.map(c => (c, new Random().nextDouble()))
val charRDD2 = distinctChars.map(c => (c, new Random().nextDouble()))
val charRDD3 = distinctChars.map(c => (c, new Random().nextDouble()))

charRDD.cogroup(charRDD2, charRDD3).take(5)
-
실행결과

5. 조인
- fullOuterJoin : 외부 조인
- leftOuterJoin : 왼쪽 외부 조인
- rightOuterJoin : 오른쪽 외부 조인
- cartesian : 교차 조인
5.1 내부 조인
val keyedChars = distinctChars.map(c => (c, new Random().nextDouble()))
val outputPartitions = 10

KVcharacters.join(keyedChars).count()
// output : 51
KVcharacters.join(keyedChars, outputPartitions).count()
// output : 51
5.2 zip
- zip 함수를 사용해 동일한 길이의 2개의 RDD를 지퍼(zipper)를 잠그듯이 연결할 수 있으며 PairRDD를 생성한다.
val numRange = sc.parallelize(0 to 9, 2)
words.zip(numRange).collect()
-
실행결과

6. 파티션 제어하기
- RDD를 사용하면 데이터가 클러스터 전체에 물리적으로 정확히 분산되는 방식을 정의할 수 있다.
6.1 coalesce
- coalesce는 파티션을 재분배할 때 발생하는 데이터 셔플을 방지하기 위해 동일한 워커에 존재하는 파티션을 합치는 메서드이다.
- 예를 들어 words RDD는 현재 2개의 파티션으로 구성되어 있는데, coalesce 메서드를 사용해 데이터 셔플링 없이 하나의 파티션으로 합친다.
words.coalesce(1).getNumPartitions
// output : 1
6.2 repartition
- repartition 메서드를 사용해 파티션 수를 늘리거나 줄일 수 있지만, 처리 시 노드 간의 셔플이 발생할 수 있다.
- 파티션 수를 늘리면 맵 타입이나 필터 타입의 연산을 수행할 때 병렬 처리 수준을 높일 수 있다.
words.repartition(10)
7. 한계와 트레이드오프
- groupByKey는 한 키의 모든 값을 익스큐터 메모리에 올린 뒤에 리듀스를 시작하므로, 키 분포가 치우친 데이터에서는 익스큐터 OOM으로 잡이 실패할 수 있다. 3.2.1의 “키당 값의 크기가 익스큐터 메모리에서 처리 가능한 수준”이라는 전제가 실제 데이터에서는 자주 깨진다.
- reduceByKey·aggregateByKey·foldByKey는 결합 함수가 결합법칙과 교환법칙을 만족할 때만 파티션 단위 병합 결과가 전체 결과와 일치한다. 순서에 의존하는 연산(예: 평균을 addFunc로 그대로 리듀스하는 경우)은 (합, 개수) 쌍으로 나눠 집계하는 식으로 병합 방식을 바꿔야 한다.
- aggregateByKey·foldByKey에 넘기는 제로값은 파티션마다 한 번씩 적용되므로 반드시 항등원이어야 한다. 항등원이 아니면 파티션 수만큼 결과가 왜곡된다.
- coalesce는 파티션 수를 줄일 수만 있고 늘릴 수는 없다. 늘리려면 repartition을 써야 하는데, 이때는 노드 간 셔플이 발생한다.
- 파티션 수를 줄이면 맵·필터 연산의 병렬 처리 수준도 그만큼 낮아질 수 있고, sampleByKey(true, …)는 확률적 샘플이라 집계를 정확히 재현해야 하는 파이프라인에는 적합하지 않다.1
댓글남기기