
[Spark] 저수준 API: 분산형 공유 변수
 [Spark The Definitive Guide - BIG DATA PROCESSING MADE SIMPLE] 책을 중심으로 스파크를 개인 공부를 위해 요약 및 정리해보았습니다. 다소 복잡한 설치 과정은 도커에 미리 이미지를 업로드해 놓았습니다. 즉, 도커 이미지를 pull하면 바로 스파크를 사용할 수 있습니다. 도커 설치 및 활용하는 방법 : [Spark] 빅데이터와 아파치 스파크란 - 1.2 스파크 실행하기 도커 이미지 링크 : https://hub.docker.com/r/ingu627/hadoop 예제를 위한 데이터 링크 : FVBros/Spark-The-Definitive-Guide 예제에 대한 실행 언어는 SQL과 스칼라(scala)로 했습니다.
기본 실행 방법
- 예제에 사용 될 데이터들은 도커 이미지 생성 후
spark-3.3.0안의 하위 폴더data를 생성 후, 이 폴더에 추가합니다.- 1.1 데이터와 도커 설치 및 활용하는 방법은 위에 링크를 남겼습니다.
- 프로그램 시작은
cd spark-3.3.0후,./bin/spark-shell명령어를 실행하시면 됩니다.
1. 분산형 공유 변수
- 스파크의 저수준 API에는 RDD 외에도 분산형 공유 변수(Distributed Shared Variables)가 있다.
- 분산형 공유 변수에는 브로드캐스트(broadcast) 변수와 어큐뮬레이터(accumulator)라는 2개의 타입이 있다.
- 브로드캐스트 변수를 사용하면 모든 워커 노드에 큰 값을 저장하므로 재전송 없이 많은 스파크 액션에서 재사용할 수 있다.
- 어큐뮬레이터를 사용하면 모든 태스크의 데이터를 공유 결과에 추가할 수 있다.
- 클러스터에서 실행할 때 특별한 속성을 가진 사용자 정의 함수에서 이 변수를 사용할 수 있다.
분산형 공유 변수는 아래와 같은 클러스터 구성에서 드라이버와 익스큐터 사이를 오가며 동작한다. 브로드캐스트 값은 각 익스큐터에 내려가 캐시되고, 어큐뮬레이터 값은 드라이버로 모인다.
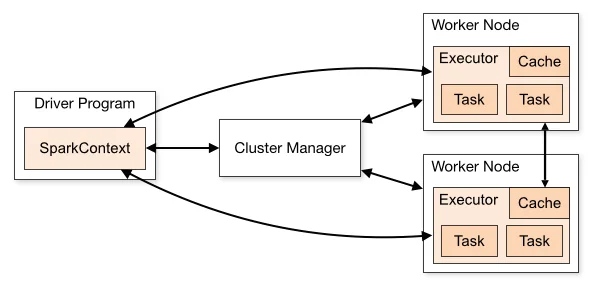
출처: Cluster Mode Overview - Spark 공식 문서 (https://spark.apache.org/docs/latest/cluster-overview.html)
2. 브로드캐스트 변수
- 브로드캐스트 변수는 불변성 값을 클로저(closure) 함수의 변수로 캡슐화하지 않고 클러스터에서 효율적으로 공유하는 방법을 제공한다.
- 브로드캐스트 변수는 모든 태스크마다 직렬화하지 않고 클러스터의 모든 머신에 캐시하는 불변성 공유 변수이다.
- Fig 14-1은 익스큐터 메모리 크기에 맞는 조회용 테이블을 전달하고 함수에서 사용하는 그림이다.

- 단어나 값의 목록을 가지고 있다고 가정해본다.
val myCollection = "Spark The Definitive Guide : Big Data Processing Made Simple".split(" ")
val words = spark.sparkContext.parallelize(myCollection, 2)

val supplementalData = Map("Spark" -> 1000, "Definitive" -> 200, "Big" -> -300, "Simple" -> 100)
- 위 구조체를 스파크에 브로드캐스트할 수 있으며,
supplementalData변수를 이용해 참조한다.- 이 값은 불변성이며 액션을 실행할 때 클러스터의 모든 노드에 지연 처리 방식으로 복제된다.
val suppBroadcast = spark.sparkContext.broadcast(supplementalData)
- value 메서드는 직렬화된 함수에서 브로드캐스트된 데이터를 직렬화하지 않아도 접근할 수 있다.
- 직렬화(serialize) : 어떤 데이터를 다른 곳에서 사용할 수 있게 다른 포맷의 데이터로 바꾸는 것을 의미한다. 1
- 스파크는 각 스테이지에서 태스크들이 공통으로 쓰는 데이터를 자동으로 브로드캐스트한다. 이렇게 전파된 데이터는 직렬화된 형태로 캐시되었다가 태스크를 실행할 때마다 역직렬화되므로, 브로드캐스트 변수를 직접 만들어 쓰는 편이 유리한 경우는 여러 스테이지의 태스크가 같은 데이터를 필요로 하거나 데이터를 역직렬화된 형태로 캐시해 둘 때로 한정된다.2
- 드라이버에 있는 큰 객체(예: 정적 조회 테이블)를 브로드캐스트 변수로 바꾸면 태스크마다 그 객체를 직렬화해 보내지 않아도 되어 직렬화되는 태스크의 크기와 잡 실행 비용이 줄어든다. 스파크는 마스터 로그에 태스크별 직렬화 크기를 출력하므로 이를 기준으로 판단할 수 있는데, 일반적으로 태스크가 약 20KiB를 넘으면 점검 대상으로 본다.3
- 다만 브로드캐스트 값은 각 익스큐터의 힙에 상주하므로 그만큼 익스큐터 메모리에서 차지하는 공간을 고려해야 하고3, 브로드캐스트 변수는 값을 수정할 수 없는 읽기 전용이며 브로드캐스트되는 값은 직렬화 가능해야 한다.2
suppBroadcast.value
-
실행결과

- 이제 브로드캐스트된 데이터를 사용해 RDD를 변환할 수 있다.
- 다음 예제에서는 맵 연산의 처리 과정에 따라 키-값 쌍 데이터를 생성한다.
words.map(word => (word, suppBroadcast.value.getOrElse(word, 0))
    ).sortBy(wordPair => wordPair._2
    ).collect()
-
실행결과

3. 어큐뮬레이터
- 어큐뮬레이터(accumulator)는 트랜스포메이션 내부의 다양한 값을 갱신하는 데 사용한다.
- 그리고 각 태스크의 갱신 값을 드라이버로 전달해 하나의 공유 결과로 합칠 수 있다.

- 어큐뮬레이터는 스파크 클러스터에서 로우 단위로 안전하게 값을 갱신할 수 있는 변경 가능한(mutable) 변수를 제공한다.
- 그리고 디버깅용이나 저수준 집계 생성용으로 사용할 수 있다.
- 어큐뮬레이터는 카운터나 합계를 구하는 용도로 사용할 수 있다.
-
스파크는 기본적으로 수치형 어큐뮬레이터를 지원하며 사용자 정의 어큐뮬레이터를 만들어 사용할 수도 있다.
- 어큐뮬레이터의 값은 액션(action)을 처리하는 과정에서만 갱신된다.
- 스파크는 각 태스크에서 어큐뮬레이터를 한 번만 갱신하도록 제어한다.
- 따라서 재시작한 태스크는 어큐뮬레이터 값을 갱신할 수 없다.
- 트랜스포메이션에서 태스크나 잡 스테이지를 재처리하는 경우 각 태스크의 갱신 작업이 2번 이상 적용될 수 있다.
- 어큐뮬레이터 값은 드라이버 프로그램만
value메서드로 읽을 수 있고, 클러스터에서 실행되는 태스크는add로 더할 수만 있을 뿐 값을 읽을 수 없다.4 - 태스크가 끝날 때 누적 갱신을 병합하는 데 실패하면 스파크는 그 실패를 무시하고 태스크를 성공으로 표시한 채 다음 태스크를 실행하므로,4 어큐뮬레이터 값이 모든 갱신을 반영한다고 보장할 수 없다.
3.1 기본 예제
- 항공운항 데이터셋에 사용자 정의 집계를 수행하면서 어큐뮬레이터를 실험해본다.
case class Flight(DEST_COUNTRY_NAME: String,
                  ORIGIN_COUNTRY_NAME: String, count: BigInt)
val flights = spark.read.parquet("./data/flight-data/parquet/2010-summary.parquet"
    ).as[Flight]
- 이제 출발지나 도착지가 중국인 항공편의 수를 구하는 어큐뮬레이터를 생성한다.
import org.apache.spark.util.LongAccumulator

val accChina = new LongAccumulator
val accChina2 = spark.sparkContext.longAccumulator("China")

spark.sparkContext.register(accChina, "China")
- 다음은 어큐뮬레이터에 값을 더하는 방법을 정의하는 단계이다.
- 그리고 foreach 메서드를 사용해 항공운항 데이터셋의 전체 로우를 처리해본다.
- foreach 메서드는 입력 DataFrame의 매 로우마다 함수를 한 번씩 적용해 어큐뮬레이터 값을 증가시킨다.
def accChinaFunc(flight_row: Flight) = {
    val destination = flight_row.DEST_COUNTRY_NAME
    val origin = flight_row.ORIGIN_COUNTRY_NAME

    if (destination == "China") {
        accChina.add(flight_row.count.toLong)
    }
    if (origin == "China") {
        accChina.add(flight_row.count.toLong)
    }
}

flights.foreach(flight_row => accChinaFunc(flight_row))
-
실행결과

댓글남기기