
[논문 리뷰] Quasar: Resource-Efficient and QoS-Aware Cluster Management

“Quasar: Resource-Efficient and QoS-Aware Cluster Management” 논문을 개인 공부 및 리뷰를 위해 정리한 글이다.
대규모 클라우드 데이터 센터는 낮은 리소스 사용률(보통 10~20% 미만)과 엄격한 서비스 품질(QoS) 보장 사이의 심각한 딜레마를 겪는다. 기존 클러스터 매니저는 사용자가 직접 서버 수나 코어를 지정하는 예약(reservation) 기반 방식을 채택했으나, 이로 인해 대다수 워크로드가 과다 프로비저닝되거나 반대로 간섭에 의해 성능 저하를 겪었다. Quasar는 사용자가 세부 하드웨어 수치가 아닌 높은 수준의 성능 목표(QPS, 지연 시간, 완료 시간)를 제시하면, 빠른 협업 필터링 분류와 결합된 그리디 스케줄링을 통해 리소스 할당(allocation)과 배정(assignment)을 공동으로 최적화하는 성능 중심 클러스터 관리 아키텍처를 제안한다.
논문 링크 : Quasar paper
1. Introduction
현대 클라우드 데이터 센터는 대규모 서버 자원을 공유해 규모의 경제를 달성하려 하지만, 실제 운영 환경에서는 사용률이 극단적으로 낮게 머무는 만성적인 비효율에 직면해 있다. 사용자가 필요한 물리 리소스를 직접 예측해 예약하는 기존 체계에서는 성능 저하를 피하기 위한 과다 프로비저닝이 만연하기 때문이다.
- 클라우드 플랫폼은 사용자와 클라우드 운영자에게 유연성(flexibility)과 비용 효율성(cost efficiency)이라는 두 가지 핵심 이점을 제공한다.
- 사용자는 짧은 단일 프로세스 애플리케이션에서 대규모 multi-tier 서비스에 이르는 다양한 작업을 신속하게 시작할 수 있으며, 각 지점에서 실제로 사용한 리소스에 대해서만 비용을 지불하면 된다.
- 클라우드 운영자는 대규모 데이터 센터(DC)를 구축하고 여러 사용자와 워크로드 간에 리소스를 공유함으로써 규모(scale)의 경제를 달성할 수 있다.
- 그럼에도 불구하고 대부분의 클라우드 시설은 비용 효율성을 목표로 하면서도 실제로는 매우 낮은 사용률(utilization)로 운영된다.
- Fig 1에서는 한 달 동안 Mesos에서 관리하는 수천 대의 서버가 있는 트위터(Twitter) 프로덕션 클러스터의 사용률 분석 결과를 보여준다.
- 예약(reservation)이 총 용량의 최대 80%에 도달하더라도 총 CPU 사용률은 지속적으로 20% 미만에 머문다. (Fig 1.a)
- 예약(reservation): 가상 시스템에 보장된 최소 할당량을 지정하는 것을 의미한다. 3
- Fig 1.d는 적절한 양의 리소스를 예약하는 워크로드가 극소수에 불과함을 보여준다.
- 여기에 표시된 컴퓨팅 리소스는 메모리와 유사한 경향을 보인다.
- 대부분의 워크로드(70%)는 예약을 최대 10배까지 과대평가하는 반면, 다른 워크로드(20%)는 예약을 최대 5배까지 과소평가한다.
- 워크로드(workload): 리소스에서 실행할 수 있는 특정한 애플리케이션, 서비스, 기능 또는 특정한 작업량이다. 가상 머신, 데이터베이스, 컨테이너, 하둡 노드 및 애플리케이션이 모두 워크로드로 간주된다. 4

- 다양한 분석에 따르면 산업 전반의 실제 리소스 사용률은 6%에서 12% 사이에 불과하다.
- 전반적으로 낮은 사용률은 클라우드 인프라가 풀어야 할 가장 중대한 과제이다.
- 클러스터 관리자는 사용 가능한 리소스의 사용률을 최대화하면서 각 작업의 성능(performance) 목표를 달성하는 방식으로 다양한 워크로드에 리소스를 제공할 책임이 있다.
- 이를 위해 관리자는 두 가지 핵심 결정을 순차적 혹은 종합적으로 내려야 한다.
- 리소스 할당(Resource allocation): 각 워크로드에 적절한 양의 리소스를 결정하여 할당한다.
- 리소스 배정(Resource assignment): 지정된 할당량을 충족할 특정 물리 서버를 선택하여 배치한다.
기존 클러스터 관리 프레임워크가 애플리케이션 성능과 리소스 활용 목표를 동시에 충족하지 못하고 사용률을 제한하는 데는 세 가지 근본적인 이유가 존재한다.
- 워크로드 요구량 추정의 어려움: 각 워크로드에 필요한 리소스를 사전에 정확히 결정하는 것은 대단히 어렵다.
- user-facing 서비스의 부하(load)는 사용자 요청 패턴의 복잡성과 데이터셋 크기에 따라 끊임없이 변한다.
- 부하(load): 시스템에서 원하는 어떤 효과를 얻기 위해 취하는 행동에 필요한 동작이나 자원을 말한다. 5
- 예약 크기가 작으면(undersized) 애플리케이션 성능이 심각하게 저하되고, 예약 크기가 크면(oversized) 리소스 사용률이 바닥으로 떨어진다.
- 할당과 배정의 본질적 결합: 리소스의 양(할당)과 배치 위치(배정)는 독립적이지 않고 강하게 얽혀 있다.
- 하드웨어 이질성(heterogeneity): 데이터 센터의 15년 수명 동안 서버 하드웨어가 순차적으로 증설 및 교체됨에 따라 노드 간 사양 편차가 매우 크다.
- 코로케이션 간섭(co-located interference): 동일 서버에 함께 배치된 워크로드 간의 공유 리소스 경합으로 인해 심각한 성능 저하가 초래될 수 있다.
- 이는 낮은 부하부터 예기치 않은 스파이크(spike)에 이르는 광범위한 트래픽 환경에서 엄격한 테일 레이턴시(tail-latency) 요구 조건을 맞춰야 하는 user-facing 서비스에 치명적이다.
- 우선순위가 낮은 이러한 서비스와 유휴 리소스를 소비하는 배치 태스크를 코로케이션하면, 전체 부하가 낮더라도 허용 불가능한 지연 시간이 발생할 수 있다.
- 코로케이션(co-location): IDC 공간을 임대하여 여러 서버 랙을 한데 모아두고 관리하는 형태이다. 6
- 이 때문에 클라우드 운영자는 낮은 사용률을 감수하면서도 짧은 지연시간(low-latency) 서비스들을 전용 서버에 격리 배포해 왔다.
- 짧은 지연시간(low-latency): 최소 지연으로 응답을 제공하는 컴퓨팅 시스템 기능이다. 7
- 결과적으로 워크로드 간 리소스를 공유하는 환경에서 사용자는 간섭으로 인한 예측 불가능한 성능 저하를 피하고자 리소스 예약을 과도하게 부풀리는 악순환이 발생한다.
- 대규모 클러스터의 확장성 제약: 수천 대의 서버와 워크로드가 밀집된 클러스터 환경에서는 스케줄링 의사결정의 시간과 복잡도에 엄격한 제약이 따른다.
결국 예약 기반 방식으로는 성능 보장과 고효율 사용률을 동시에 달성할 수 없다. Quasar 클러스터 관리자는 각 워크로드의 성능 및 QoS 제약 조건을 충족하면서도 클러스터 리소스 활용률을 극대화하는 새로운 아키텍처를 제시한다.
- QoS(Quality of Service): 트래픽을 생성하는 애플리케이션의 필수 동작에 맞게 라우터나 스위치 같은 네트워크 디바이스가 해당 트래픽을 전달할 수 있도록 트래픽을 조작하는 것이다. 즉, 네트워크 디바이스가 트래픽을 구별한 후에 트래픽에 서로 다른 동작을 적용할 수 있도록 해준다. 8
- QoS의 또 다른 정의: 다른 응용 프로그램, 사용자, 데이터 흐름 등에 우선순위를 정하여 데이터 전송에 특정 수준의 성능을 보장하기 위한 능력을 말한다. 9
Quasar가 제공하는 세 가지 핵심 설계 원칙은 다음과 같다.
- 예약 중심에서 성능 중심(performance-centric)으로의 패러다임 전환:
- 사용자가 스케줄러에 저수준 리소스(코어 수, 메모리 크기 등)를 수동으로 요청하는 대신, 처리량(throughput) 또는 지연 시간(latency) 관점의 고수준 성능 제약 조건을 제시한다.
- Quasar는 사용 가능한 서버 및 활성 워크로드 현황을 종합 감안하여 성능 제약을 충족하는 데 필요한 ‘최소한의 리소스 양’을 시스템이 직접 결정한다.
- 리소스 할당은 시간이 지남에 따라 워크로드나 클러스터 시스템 변화에 맞춰 동적으로 조정된다.
- 빠르고 정확한 협업 필터링 기반 분류(classification):
- 소량의 샌드박스 프로파일링 정보와 과거 오프라인 워크로드 데이터를 결합하여, 애플리케이션에 대한 사전 소스코드 분석 없이도 리소스 할당과 배정이 성능에 미치는 영향을 빠르고 정확하게 예측한다.
- 각 워크로드에 대해 네 가지 병렬 분류를 수행하여 성능 결정 요인을 다각도로 평가한다.
- scale-up 영향: 서버당 할당되는 코어 및 메모리 리소스 양에 따른 성능 변화
- scale-out 영향: 워크로드에 투입되는 서버 노드 수에 따른 확장성 변화
- heterogeneity 영향: 다양한 하드웨어 서버 구성에 따른 성능 차이
- interference 영향: 코로케이션 환경에서 공유 리소스 경합 시 감내할 수 있는 간섭 수준
- 할당(Allocation)과 배정(Assignment)의 공동 최적화(Joint Optimization):
- 분류 결과를 바탕으로 그리디 스케줄러가 워크로드에 필요한 적절한 리소스 양과 최적의 물리 서버 집합을 한 번에 공동으로 결정한다.
- 워크로드 실행 전반에 걸쳐 지속적으로 성능을 모니터링하며, 성능이 목표 제약 조건에서 벗어날 경우 동적으로 재분류하여 할당과 배정을 재조정한다.
저자들은 로컬 40대 서버 클러스터와 AWS EC2의 200대 노드 클러스터 환경에서 Quasar 프로토타입을 실증 평가했다. 하둡, 스톰, 스파크 등 대규모 분석 프레임워크부터 memcached, 카산드라 등 지연 시간에 민감한 상태 저장(stateful) 서비스에 이르기까지 폭넓은 워크로드를 검증했다.
- memcached: 고성능 캐시 또는 세션 스토어로 사용할 수 있는 분산 인메모리 키-값 스토어이다. 10
실험 결과 Quasar는 200개 서버 클러스터의 고부하 정상 상태에서 서버 사용률을 평균 47% 향상시키는 동시에 개별 워크로드의 QoS 성능 목표를 안정적으로 달성했다.
이제 Quasar가 기존 클러스터 매니저의 한계를 극복하기 위해 던진 문제의식과 구체적인 동기를 살펴본다.
2. Motivation
기존 분산 클러스터 인프라는 자원의 양을 결정하는 ‘할당’과 물리 머신을 지정하는 ‘배정’을 서로 단절된 별개 단계로 다루어 왔다. 하지만 이 두 결정이 분리되는 순간, 하드웨어 이질성과 코로케이션 간섭으로 인해 성능 예측이 불가능해진다.
2.1 Cluster Management Overview
클러스터 관리 프레임워크는 기본적으로 보안, 장애 허용(fault tolerance), 모니터링을 포함한 다양한 인프라 서비스를 제공한다. 그중에서도 핵심은 새롭게 유입되는 워크로드에 대한 리소스 할당과 배정이다.
Resource allocation
- 할당(Allocation): 워크로드가 사용할 리소스의 물리적 규모(총 서버 수, 코어 수, 노드당 메모리 및 네트워크 대역폭)를 결정하는 과정이다.
- Mesos와 같은 전통적 프레임워크는 이러한 요청을 처리하고 가용성과 공정성(fairness)을 기반으로 개별 프레임워크(하둡, 스파크 등)에 리소스를 제안(offer)하고 수락/거절받는 방식을 취한다.
아래 그림은 Mesos 마스터가 각 에이전트 노드의 자원을 프레임워크(하둡, MPI 등) 스케줄러에 제안(offer)하는 구조를 보여준다.
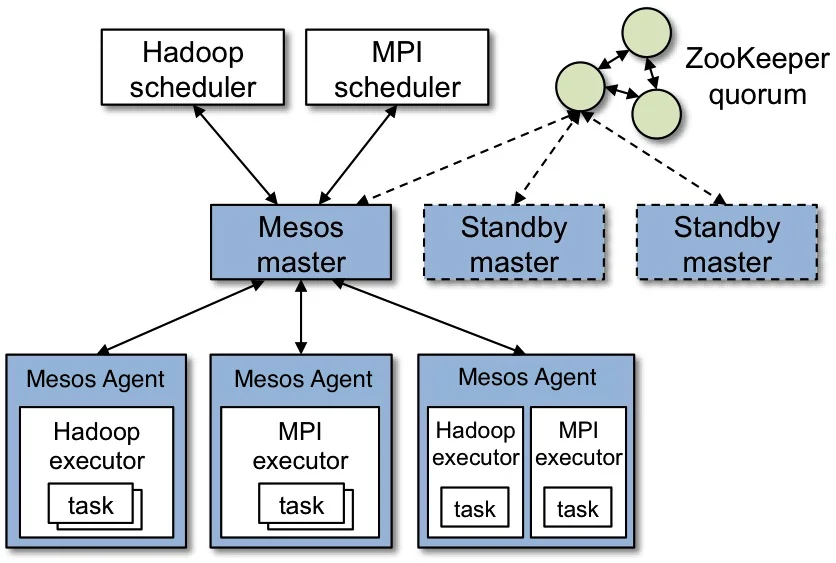 출처: Apache Mesos Architecture (https://mesos.apache.org/documentation/latest/architecture/)
Resource assignment
- 배정(Assignment): 결정된 할당량을 충족하기 위해 클러스터 내의 구체적인 물리 서버들을 선택하여 작업을 매핑하는 과정이다.
- 배정 단계에서 발생하는 가장 큰 두 가지 장애물은 서버 이질성(heterogeneity)과 코로케이션 간섭(interference)이다.
- 선행 연구인 Paragon은 알려지지 않은 워크로드에 리소스 할당량이 주어졌을 때, 협업 필터링 분류 기법을 통해 이질성과 간섭이 성능에 미치는 영향을 빠르게 추정했다.
- Paragon은 이 정보를 활용해 최적의 성능을 낼 수 있는 서버 타입을 배정하고, 상호 간섭이 적은 워크로드들을 골라 코로케이션했다. 하지만 할당 자체는 외부 입력에 의존했다.
2.2 The Case for Coordinated Cluster Management
클러스터 스케줄링 기술의 지속적인 발전에도 불구하고, 대다수 퍼블릭 및 프라이빗 클라우드의 실제 리소스 사용률은 여전히 10~20% 수준으로 극히 낮다.
기존 클러스터 매니저가 고질적인 저사용률을 벗어나지 못하는 근본 원인은 다음 두 가지이다.
- 예약 모델의 한계: 사용자가 본인 워크로드의 정확한 리소스 요구량을 이해하고 이를 세밀한 예약 수치로 표현하기가 사실상 불가능하다.
- 할당과 배정의 결합성 무시: 최적의 리소스 할당량은 어떤 유형의 서버에 배정되는지, 그 서버에서 함께 동작하는 다른 워크로드가 무엇인지에 따라 완전히 달라진다.
할당과 배정을 분리하면 자원 낭비와 성능 저하 중 하나는 반드시 발생한다.

Fig 2는 추천 알고리즘을 수행하는 대규모 하둡 작업(배치)과 읽기 집약적 memcached 서비스(저지연)라는 상반된 워크로드를 대상으로 다양한 할당·배정 조건이 성능에 미치는 영향을 분석한 결과이다.
- Hadoop의 가변성: 사용 가능한 모든 코어와 메모리를 활용하는 서버 구성 A 단일 노드 대비 속도 향상(speedup)을 측정했다.
- 각 바이올린 플롯의 변동성(variability)은 개별 서버 내에 할당된 코어 및 메모리 양의 차이로 인해 발생한다.
- 이질성(Heterogeneity): 서버 아키텍처 선택에 따라 최대 7배의 성능 편차가 발생하며, 동일 서버 내 할당 자원량에 따라서도 최대 10배의 편차가 나타난다.
- 간섭(Interference): 서버 A 기준으로 투입된 자원량에 따라 하둡은 특정 유형의 간섭에 최대 10배까지 둔감(insensitive)해질 수 있다.
- 확장성(Scale-out): 노드당 할당된 리소스 양에 따라 스케일아웃 효율이 sublinear에서 superlinear까지 극단적으로 갈린다.
- 데이터셋(Dataset): 입력 데이터셋의 복잡도와 크기에 따라 하둡 실행 성능이 최대 3배까지 달라진다.
- memcached의 가변성: 처리량에 따른 99번째 백분위수 지연 시간(tail latency)을 측정했다.
- 프로덕션 배포에서는 0.2ms에서 1ms 사이의 99th 지연 시간을 충족하기 위해 인위적으로 처리량을 제한해야 하는 현실을 보여준다.
이처럼 복잡한 상관관계를 사용자가 직접 계산하여 리소스를 예약하는 것은 불가능하다. 이제 Quasar가 이 문제를 어떻게 해결하는지 살펴본다.
3. Quasar
Quasar는 사용자의 고수준 성능 목표를 입력받아, 빠른 협업 필터링 분류와 그리디 탐색을 통해 할당과 배정을 단일 최적화 루프 안에서 공동으로 해결한다.
3.1 Overview
Quasar는 기존 클러스터 매니저와 차별화되는 세 가지 핵심 축으로 동작한다.
- 성능 중심 인터페이스(Performance-centric Interface):
- 사용자가 저수준의 하드웨어 예약(코어 수, 메모리 용량 등)을 요청하는 대신, 워크로드 유형에 맞는 고수준 성능 제약을 전달한다.
- 지연 시간 민감 워크로드: QPS(초당 쿼리 수) 목표와 지연 시간 QoS 제약 조건으로 명시한다.
- 분산 데이터 처리 프레임워크(하둡 등): 작업의 목표 완료 시간(Execution Time)을 제약 조건으로 전달한다.
- 단일 노드/스레드 워크로드: 초당 명령어 수인 IPS(초당 명령 수) 지표를 사용한다.
- 고수준 제약이 주어지면 클러스터의 현재 리소스 상태와 활성 워크로드를 고려해 이를 충족하는 최소 리소스를 탐색하는 책임은 Quasar가 맡는다.
- 동적 리소스 조정: 할당량은 런타임 중 워크로드 상태 변화나 시스템 조건에 맞춰 능동적으로 변경된다.
- 빠른 4차원 분류 기법(Fast 4-dimensional Classification):
- 승인 시 신규 워크로드와 데이터셋을 몇 대의 노드에서 수 초간 짧게 프로파일링한다.
- 이 소량의 프로파일링 정보와 오프라인으로 수집된 대량의 과거 워크로드 데이터를 결합하여, 방대한 할당-배정 공간에 대한 성능을 빠르고 정확하게 도출한다.
- 분류 복잡도를 크게 낮추기 위해 네 가지 독립적인 병렬 분류(scale-up, scale-out, heterogeneity, interference)로 문제를 분해한다.
- 할당과 배정의 공동 최적화(Greedy Joint Scheduling):
- 4차원 분류 결과를 결합한 그리디(greedy) 알고리즘을 사용해, 워크로드의 성능 목표를 충족하는 데 필요한 리소스의 양과 최적의 물리 서버 집합을 동시에 결정한다.
- 실행 전반에 걸쳐 지속적으로 성능을 모니터링하며, 제약 조건 위반이 감지되면 재분류와 재조정을 즉각 수행한다.
이제 이 아키텍처의 심장부인 협업 필터링 분류 엔진의 세부 동작을 살펴본다.
3.2 Fast and Accurate Classification
미지의 워크로드에 대해 수많은 하드웨어 사양과 간섭 시나리오를 일일이 벤치마킹하는 것은 불가능하다. Quasar는 추천 시스템의 핵심 알고리즘인 협업 필터링을 시스템 스케줄링에 접목하여 이 문제를 해결한다.
- 협업 필터링(collaborative filtering) 기술은 매우 희소(sparse)한 입력 데이터를 가진 추천 시스템에서 널리 활용된다.
- 대표적인 예로 넷플릭스(Netflix)가 영화 추천 시스템에서 SVD(singular value decomposition) 기술을 사용한 사례가 있다.
- SVD에 대한 입력은 사용자를 행으로, 영화를 열로, 레이팅(rating)을 요소로 포함하는 매우 희소한 행렬이다.
- SGD(Stochastic Gradient Descent)를 사용한 PQ 재구성(reconstruction)은 $\sum ,U\ ,V$ 를 사용하여 행렬 $A$의 누락된 결측 항목을 복원한다.
- Paragon에서는 서버 간섭 및 이질성과 관련하여 작업 부하를 빠르게 분류하기 위해 협업 필터링을 도입했다.
- 소수의 기준 애플리케이션에 대해 서로 다른 서버와 다양한 간섭 조건에서 성능을 도출하기 위해 완전히 오프라인으로 프로파일링을 진행해 둔다.
- 새로운 애플리케이션이 유입되면 2개의 공유 리소스에 대한 간섭이 있거나 없는 서버 구성 중 단 2개에서 1분 동안 프로파일링한다.
- SVD 및 PQ 재구성을 통해 나머지 서버 구성과 나머지 리소스 간섭 환경에서의 워크로드 성능을 높은 정확도로 추정한다.
- Paragon은 협업 필터링이 수십 개의 서버 구성과 다양한 간섭 요인에 대해 미지의 애플리케이션을 빠르고 정확하게 분류할 수 있음을 입증했다.
Quasar의 분류 엔진은 Paragon의 분류 엔진을 두 가지 핵심 방향으로 확장한다.
- Scale-out 및 Scale-up 축 추정: 협업 필터링을 확장하여 애플리케이션 성능에 대한 리소스 scale-out(서버 수)과 scale-up(서버당 리소스 양)의 영향을 함께 추정한다. 이는 리소스 할당(allocation)을 최적화하기 위해 필수적이다.
- 워크로드 유형별 맞춤 조정: 워크로드의 특성에 맞춰 분류 파라미터와 제약 조건을 유연하게 조정한다.
- 웹 서버의 경우 scale-out과 scale-in을 모두 고려하며 QPS(초당 쿼리 수)와 지연 시간을 모니터링한다.
- 하둡의 경우 노드당 매퍼(mapper) 수, JVM 힙 크기, 압축 옵션 등 프레임워크 자체의 구성 매개변수까지 함께 최적화한다.
Scale-up classification
단일 서버 내에서 부여되는 리소스 양(컴퓨팅 코어, 메모리, 스토리지 용량)에 따라 워크로드 성능이 어떻게 변화하는지 추정한다.
- 워크로드가 제출되면 무작위로 선택된 두 개의 scale-up 할당 조건에서 간략한 프로파일링을 거친다.
- 프로파일링 파라미터와 지속 시간은 워크로드 유형에 따라 최적화되어 있다.
- memcached 서비스: 서로 다른 2개의 코어/스레드 수 및 메모리 할당 조건에서 실제 라이브 트래픽을 주입받으며 5~10초 동안 프로파일링된다.
- 하둡 배치 워크로드: 핵심 프레임워크 매개변수(노드당 매퍼 수, JVM 힙 크기, 블록 크기, 작업당 메모리, 복제 계수, 압축 등)의 서로 다른 2개 할당 및 구성을 사용하여 전체 Map 작업 중 극히 작은 서브셋을 프로파일링한다. 이 프로파일링은 맵 작업이 최소 20% 완료될 때까지만 지속된다.
- 프로파일링 데이터 행렬화: 각 애플리케이션의 성능 목표(예상 완료 시간 또는 QPS) 형식으로 측정치를 수집하여 워크로드를 행으로, scale-up 구성을 열로 갖는 행렬 $A$에 삽입한다.
- 구성에는 컴퓨팅, 메모리 및 스토리지 할당량과 프레임워크 매개변수 값이 포함된다.
- SVD 및 PQ 재구성을 적용하여 모든 scale-up 할당 조건에서의 워크로드 성능 곡선을 복원한다.
Scale-out classification
분산 분석 프레임워크(하둡, 스파크)나 분산 서비스(웹서버, memcached, 카산드라)처럼 복수 서버로 수평 확장이 가능한 워크로드의 스케일링 효율을 추정한다.
- scale-out 분류를 위해서는 단일 노드 실행 외에 추가 노드 구성에서 한 번 더 프로파일링을 수행한다.
- 이를 통해 워크로드를 행으로, scale-out 노드 수를 열로 갖는 행렬 $A$에 2개의 관측치 항목을 채운다.
- 협업 필터링을 통해 미지의 모든 노드 수에 대한 성능 값을 정확하게 복구한다.
- 시스템이 온라인 상태일 때 프로파일링 오버헤드가 급증하는 것을 막기 위해, scale-out 분류는 1~4개의 노드 범위에서만 제한적으로 수행된다.
Heterogeneity classification
서버 하드웨어 아키텍처 차이에 따른 성능 영향을 추정한다.
- 동일한 워크로드 매개변수를 유지한 채, scale-up 실행과 동일한 시간 동안 무작위로 선택된 다른 서버 유형에서 1회 추가 프로파일링을 수행한다.
- 협업 필터링을 통해 클러스터 내 다른 모든 서버 유형에서의 워크로드 성능을 추정한다.
Interference classification
CPU, 캐시 계층, 메모리 용량 및 대역폭, 스토리지 및 네트워크 대역폭 등 다양한 공유 리소스 경합(contention)에서 발생하는 간섭에 대한 워크로드의 민감도를 정량화한다.
- 별도의 추가 프로파일링 노드를 요구하지 않는다.
- scale-up의 첫 번째 실행 환경을 그대로 활용하여, 특정 공유 리소스에 부하를 거는 2개의 마이크로벤치마크를 순차적으로 주입한다.
- 마이크로벤치마크 주입 시 Quasar는 워크로드 성능이 허용 가능한 QoS 수준 아래로 떨어질 때까지 간섭 강도를 점진적으로 높인다.
- 허용 임계점에 도달한 부하 강도를 행렬 $A$의 해당 간섭 소스 열에 워크로드 민감도로 기록한다.
- 이후 협업 필터링을 통해 나머지 모든 간섭 소스에 대한 민감도를 추론한다.
- 프로파일링이 완료되면 네 가지 유형의 분류 모델이 결측 항목을 모두 재구성하여 최적의 할당 및 배정 권장안을 산출한다.
Multiple parallel versus single exhaustive classification
모든 파라미터 조합을 단일 모델로 전수 탐색하면 계산 복잡도가 감당할 수 없을 만큼 폭증한다. Quasar는 분류 문제를 scale-up, scale-out, heterogeneity, interference라는 4개의 직교하는 구성 요소로 분해해 병렬 수행함으로써, 높은 정확도를 확보하면서도 의사결정 시간을 수 초 단위로 단축했다.
복잡한 전수 조사를 4개의 독립 분류로 분해한 것이 Quasar의 핵심 묘수이다.
Validation
Table 2와 Fig 3은 Quasar 분류 엔진의 예측 정확도와 샘플링 효율성을 검증한 결과이다.
Table 2는 각 애플리케이션 및 분류 유형에 따른 평균 오류, 90번째 백분위수(90th percentile) 오류, 최대 오류를 보여준다. 여기서 오류(error)는 추정 성능과 실제 측정 성능(혹은 간섭 민감도) 간의 편차를 의미한다.
- 평균적으로 분류 오류는 모든 애플리케이션 유형에 걸쳐 8% 미만이며, 최대 오류 역시 17% 미만에 불과하여 스케줄러가 신뢰할 수 있는 정확한 정보를 제공함을 입증한다.
Fig 3(a-d)는 입력 행렬의 밀도(프로파일링 실행 횟수)에 따른 90번째 백분위수 오류 변화를 보여준다.
- 네 가지 분류 유형 모두 단 1회의 프로파일링만으로는 오류가 높게 나타난다.
- 행당 2개 이상의 관측치를 입력하면 오류가 급격히 감소하며, 4~5개 항목 이후에는 수렴 구간에 도달한다. 즉, 단 2개의 샘플만으로도 실용적인 정확도를 충분히 확보할 수 있다.
3.3 Greedy Allocation and Assignment
분류 엔진이 생성한 성능 예측 곡선은 리소스의 양, 유형, 구체적인 서버 인스턴스를 한 번에 결정하는 그리디 스케줄러에 전달된다.
- 최소 리소스 할당 원칙: 스케줄러의 목표는 워크로드의 목표 성능을 충족하는 데 필요한 ‘최소한의 리소스’를 찾는 것이다. 이를 통해 불필요한 과다 프로비저닝을 원천 차단하고 검색 공간을 대폭 축소한다.
- 품질 기반 서버 정렬: 분류 출력을 기반으로 사용 가능한 서버들의 품질 순위를 매긴다. 즉, 성능이 우수하고 간섭이 적은 고품질 플랫폼을 우선적으로 탐색한다.
- 단계적 리소스 스케일링:
- Scale-up 우선: 먼저 노드당 리소스를 늘려 작업을 소수의 고성능 서버에 조밀하게 패킹(packing)함으로써 노드 간 통신 오버헤드를 줄인다.
- Scale-out 확장: 단일 노드 스케일업만으로 성능 제약 조건을 맞출 수 없거나 자원이 부족할 경우, 부하를 여러 서버로 수평 분산한다.
3.4 Putting it All Together
Fig 4는 워크로드 진입부터 모니터링까지 Quasar 클러스터 관리의 전체 라이프사이클을 보여준다.
- 워크로드 도착 및 프로파일링: 워크로드가 제출되면 격리된 샌드박스 환경에서 최대 4개의 프로파일링 작업이 병렬로 실행된다. 플랫폼 A와 B(플랫폼 A의 2개 노드는 scale-out 측정에 활용)에서 실제 데이터셋을 바탕으로 각 축당 2개의 데이터 포인트를 수집한다.
- 4차원 협업 필터링 분류: 수집된 희소 데이터를 기반으로 분류 엔진이 전체 워크로드 특성 곡선(speedup graph)을 신속히 복원한다.
- 그리디 스케줄링 및 배치: 복원된 성능 프로파일을 바탕으로 그리디 스케줄러가 최적의 서버들을 선별하여 작업을 배정한다.
- 지속 모니터링 및 상태 유지: Quasar는 워크로드별 및 서버별 상태 정보를 실시간으로 유지 관리한다.
정적인 배정에서 끝나지 않고 런타임 환경 변화에 실시간으로 대응하는 동적 적응 메커니즘을 살펴본다.
4. Implementation
실제 프로덕션 환경에 Quasar를 안착시키기 위해서는 런타임 동적 적응, 프로파일링 시의 부작용 격리, 분산 시스템의 고질적 병목인 스트래글러(straggler) 처리가 필수적이다.
Quasar API는 제출된 워크로드의 성능 제약 조건과 유형을 등록하는 인터페이스뿐만 아니라, 작업 상태 조회, 취소, 실행 중 제약 조건 동적 업데이트 기능을 포괄한다.
4.1 Dynamic Adaptation
일부 워크로드는 실행 중 단계(phase)가 바뀌거나 사용자 유입 트래픽이 요동치면서 런타임 동작 패턴이 급변한다.
- 트래픽(traffic): 서버와 스위치 등 네트워크 장치에서 일정 시간 내에 흐르는 데이터의 양을 말한다. 11
- Quasar는 이러한 성능 변화를 실시간으로 감지하고 리소스 할당과 배정을 동적으로 재조정하여 QoS 목표를 끊임없이 수호한다.
phase detection
- 실시간 성능 모니터링: Quasar는 클러스터 내 모든 활성 워크로드의 성능 메트릭을 상시 추적한다.
- 동적 재분류: 성능 이상이 감지되면 애플리케이션을 현재 런타임 상태 기준으로 즉각 재분류하고 필요 자원을 재할당한다.
- 선제적 마이크로벤치마크 주입: 활성 워크로드를 주기적으로 샘플링하여 제어된 간섭 마이크로벤치마크를 주입함으로써 잠재적 phase 변경 및 스케줄링 불일치를 사전에 탐지한다.
- 높은 감지 정확도:
- 단순 반응형(reactive) 모니터링만으로도 phase 변화의 94%를 감지해낸다.
- 10분마다 활성 워크로드의 20%를 선제적으로 샘플링함으로써, 단 8%의 거짓 양성(False Positive) 확률로 변경 사항의 78%를 사전 감지(proactive detection)한다.
Allocation adjustment
phase 변화가 감지되거나 user-facing 서비스에 트래픽 스파이크가 발생하면, Quasar는 즉각 리소스 조정을 단행한다.
- Scale-up 우선 조정: 현재 워크로드가 점유 중인 서버 내에서 코어 및 메모리 할당량을 먼저 늘리거나 줄인다.
- Scale-out 및 마이그레이션: 스케일업이 불가능하거나 성능 목표를 달성할 수 없을 때는 신규 서버를 추가 할당(scale-out)하거나 더 적합한 서버로 작업을 실시간 마이그레이션한다.
4.2 Side Effect Free Profiling
분류에 필요한 프로파일링 데이터를 얻기 위해 라이브 워크로드의 복제본을 직접 구동하면, 데이터베이스 중복 레코드 생성, 중간 결과 불일치, 파일 손상과 같은 심각한 부작용(side effect)이 발생할 수 있다.
- 샌드박스(sandbox): 외부로부터 들어온 프로그램이 보호된 영역에서 동작해 시스템이 부정하게 조작되는 것을 막는 격리 환경이다. 12
- Copy-on-Write 기반 격리: Quasar는 Linux 컨테이너(LXC)와 chroot를 활용해 학습용 복제본을 샌드박싱하며, 파일 I/O는
copy-on-write스냅샷 위에서만 수행되도록 격리한다. - cgroups 자원 통제: cgroup을 통해 프로파일링 실행이 사용하는 CPU 및 메모리 상한을 엄격히 통제하여 클러스터의 기존 프로덕션 작업에 영향을 주지 않는다.
프로파일링은 실제 데이터를 다루되 시스템 상태는 티끌 하나 오염시키지 않는다.
4.3 Stragglers
하둡이나 스파크 같은 분산 병렬 프레임워크에서는 부실한 파티셔닝, 하드웨어 불안정성, 네트워크 간섭 등으로 인해 특정 태스크가 유독 비정상적으로 지연되는 스트래글러(straggler) 현상이 빈번하다.
- Quasar는 Hadoop TaskTracker API를 주기적으로 폴링하여 실행 속도가 중앙값보다 50% 이상 느린 이상 태스크를 감지한다.
- 해당 태스크가 동작 중인 노드에 마이크로벤치마크를 주입하여 간섭 민감도를 재측정한다.
- 재분류 결과가 초기 분류치와 20% 이상 차이가 나면 해당 태스크를 스트래글러로 공식 판정하고, Hadoop JobTracker에 통보하여 새로 배정된 청정 서버에서 태스크를 즉시 재시작하도록 유도한다.
4.4 Discussion
- 비용 목표(Cost target): 성능 목표뿐만 아니라 사용자가 예산 비용 한도, 비즈니스 우선순위, 유틸리티 함수를 지정하여 트레이드오프를 제어할 수 있다.
- 자원 파티셔닝(Resource partitioning): 하드웨어를 정적으로 분할 격리하는 대신, 상호 경합하지 않는 이종 워크로드를 영리하게 코로케이션하여 하드웨어 파티셔닝 없이도 간섭을 원천 억제한다.
- 장애 허용(Fault tolerance): 마스터-워커 액티브-스탠바이 미러링을 구축하여 활성 워크로드 목록, 할당량, QoS 보장 상태를 실시간 복제한다. 분산 프레임워크 자체의 워커 장애 복구는 각 프레임워크(하둡, 스파크 등) 고유의 내결함성 메커니즘에 위임한다.
이제 이러한 아키텍처가 실제 대규모 클러스터에서 어떻게 검증되었는지 실험 방법론을 살펴본다.
5. Methodology
Quasar의 실효성을 입증하기 위해 단일 배치 작업부터 수천 개의 복합 워크로드가 혼재된 대규모 클라우드 환경까지 5단계의 체계적인 시나리오를 구성했다.
Cluster
실험은 두 가지 환경에서 진행되었다.
- 로컬 프라이빗 클러스터: 40대의 물리 서버로 구성된 테스트베드.
- 대규모 퍼블릭 클라우드: AWS EC2 전용 인스턴스로 구축된 200개 노드 클러스터.
Single Batch Job
하둡, 스톰, 스파크 같은 분석 프레임워크 자체 스케줄러는 사용 가능한 하드웨어 이질성을 알지 못하고 작업 데이터 복잡도를 온전히 이해하지 못해 자원을 과소 혹은 과대 프로비저닝(provisioning)한다.
- 프로비저닝(provisioning): 사용자의 요구에 맞게 시스템 자원을 할당, 배치, 배포해 두었다가 필요 시 즉시 사용할 수 있도록 미리 준비하는 과정이다. 13
- 단일 하둡 작업을 대상으로 하둡 자체 스케줄러 대비 Quasar의 할당 및 배정 효율성을 직접 대조한다.
Multiple Batch Jobs
현실적인 멀티 테넌트 배치 클러스터 환경을 모사한다.
- 하둡(Mahout 기반 머신러닝 16종), 스톰(실시간 텍스트/이미지 처리 4종), 스파크(회귀/ML 4종) 등 총 24개 작업이 5초 간격으로 유입된다.
- 프레임워크 기본 스케줄러 및 코어/메모리 부하만 고려하는 최소 부하(Least-Loaded, LL) 스케줄러와 Quasar를 대조 평가한다.
Low-Latency Service
엄격한 지연 시간 보장이 요구되는 웹서빙 환경을 평가한다.
- 테넌트(tenant): 클라우드 서비스 이용자가 독립적으로 점유하는 논리적 컴퓨팅 환경을 말한다. 14
- Apache 웹 서버, PHP 애플리케이션, MySQL 데이터베이스로 구성된 실제 회의 관리 시스템인 HotCRP를 벤치마크로 활용했다.
- HotCRP: 학술 회의 논문 제출 및 피어 리뷰 과정을 관리하는 오픈소스 웹 소프트웨어이다. 15
- 목표: 요청당 100ms 지연 시간 QoS를 유지하면서 다양한 QPS 트래픽을 처리한다.
- 기존 오토스케일링(CPU 부하 70% 초과 시 단순 노드 추가) 및 LL 스케줄러와 성능 및 코어 활용률을 비교한다.
Stateful Latency-Critical Services
다량의 상태 데이터를 메모리 및 디스크에 유지하는 상태 저장(stateful) 저지연 분산 NoSQL 서비스를 다룬다.
- 인메모리 캐시: memcached 클러스터.
- 디스크 기반 분산 DB: Apache 카산드라(Cassandra) 클러스터.
Large-Scale Cloud Provider
모든 유형의 워크로드 1,200개가 1초 간격으로 무작위 유입되는 AWS EC2 200노드 대규모 클라우드 환경이다.
- 정상 상태에서 시스템 코어 사용률이 100%에 근접하도록 설계되었으며, 비효율적인 할당으로 인한 머신 포화를 막기 위해 허용 제어(Admission Control)를 적용했다.
- 전통적인 ‘리소스 예약 + LL 스케줄링 + 오토스케일링’ 조합과 Quasar의 통합 제어를 전면 대조한다.
이제 이 실험 설계를 바탕으로 도출된 핵심 성능 및 사용률 결과를 검증한다.
6. Evaluation
실험 평가는 단일 배치 최적화부터 복수 배치 프레임워크 공유, 저지연 서비스, 상태 저장 NoSQL, 1,200개 워크로드가 동작하는 대규모 클라우드에 이르기까지 전방위로 수행되었다.
6.1 Single Batch Job

성능 개선(Performance):
- Fig 5는 하둡 자체 스케줄러 대비 Quasar가 리소스를 할당·배정했을 때 10개 하둡 작업의 실행 시간 감소율을 보여준다.
- Quasar는 모든 작업의 실행 시간을 평균 29%, 최대 58%까지 단축시켰다.
- 노란색 점은 제출 시 지정된 성능 목표를 달성하는 데 필요한 실행 시간 단축 기준치이다. 이 목표는 사전 파라미터 스위프(sweep)를 통해 달성 가능한 최적 성능으로 설정되었다.
- Quasar는 할당 및 배정이 성능에 미치는 영향 곡선을 바탕으로 평균 5.8% 오차 이내로 목표 제약 조건을 정확히 충족했다.
파라미터 및 자원 효율성(Efficiency):
- Table 3은 20GB 데이터셋 기반 Mahout 추천 알고리즘 하둡 작업에 대해 Quasar와 Hadoop 기본 스케줄러가 선택한 매개변수 설정을 비교한다.
- 노드당 매퍼 수 확장: Quasar는 매퍼 간 경합 간섭이 낮다는 점을 파악하여 노드당 매퍼 수를 12개로 확대했다.
- 불필요 힙 축소: JVM 힙 크기가 이 작업 성능에 결정적이지 않다는 점을 감지하고 힙 크기를 축소하여 다른 워크로드가 쓸 수 있는 메모리를 확보했다.
- 최적 서버 플랫폼 배정: 하둡이 사용 가능한 모든 서버에 무작위로 분산한 반면, Quasar는 가장 성능 효율이 뛰어난 E, F 타입 서버에 작업을 집중 배정했다.
6.2 Multiple Batch Frameworks

성능 격차(Performance):
- Fig 6은 하둡, 스톰, 스파크 작업이 혼재된 클러스터에서 Quasar가 스케줄링을 관리할 때의 실행 시간 단축 효과를 보여준다.
- 평균 성능은 기준선(기본 스케줄러 및 LL) 대비 27% 향상되었으며, 주어진 성능 목표 제약 조건의 5.3% 오차 이내로 안정적으로 수렴했다.
- 간섭 인식 배치 덕분에 주 작업(primary job)의 QoS를 전혀 침해하지 않으면서도 잔여 클러스터 용량을 best-effort 작업에 온전히 투입할 수 있었다.
클러스터 사용률 향상(Utilization):
- Fig 7은 시간 경과에 따른 서버별 CPU 사용률 히트맵(5초 간격 샘플링)이다.
- 개별 프레임워크 스케줄러가 기록한 평균 사용률 34%에 비해, Quasar는 서버 간 균형 잡힌 워크로드 패킹을 통해 사용률을 크게 끌어올렸다.
6.3 Low-Latency Service

QPS 추종 및 레이턴시 보장(Performance):
- 일정 트래픽(Fig 8a): Quasar 환경에서 HotCRP 웹 서비스는 간섭 없이 실행되며, 동시에 동작하는 best-effort 배치 작업 역시 최소 런타임 기준 5% 오차 이내로 완료되었다. 반면 단순 autoscaling 환경에서는 24%의 런타임 지연이 발생했다.
- 변동 트래픽(Fig 8b): 트래픽이 요동칠 때 Quasar는 목표 QPS를 오차 없이 추적했다. 반면 autoscaling은 코로케이션 간섭과 비효율적 scale-up 구성으로 인해 목표보다 평균 18% 낮은 QPS를 기록했다.
- 잉여 자원 보존(Fig 8c): Quasar는 scale-out과 scale-up을 능동적으로 병용하여 새로운 QPS 목표를 최소한의 자원으로 맞춤으로써, best-effort 작업이 쓸 수 있는 코어를 최대로 남겨둔다.
- 급격한 트래픽 스파이크(Fig 8d, 8e): 극단적인 부하 급증 상황에서도 Quasar는 평균 4% 이내로 목표 QPS를 추종하며(Fig 8d), 사실상 100%에 가까운 요청에 대해 100ms 지연 시간 QoS를 준수했다(Fig 8e).
6.4 Stateful Latency-Critical Services

엄격한 QoS 준수율(Performance):
- Fig 9는 시간 경과에 따른 memcached 및 카산드라의 처리량과 쿼리 지연 시간 분포이다.
- memcached: Quasar는 전체 요청의 98.8%에서 지연 시간 QoS를 달성했다. 반면 기존 autoscaling은 80% 수준에 그쳤다.
- 카산드라(Cassandra): Quasar는 98.6%의 요청에서 지연 시간 QoS를 충족한 반면, autoscaling은 93%의 준수율을 기록했다.

다차원 리소스 활용도(Utilization):
- Fig 10은 Quasar가 24시간 동안 클러스터를 관리할 때의 CPU 사용률, 메모리 용량, 디스크 I/O 대역폭 분포이다(각 열은 6시간 단위 평균 스냅샷).
- CPU뿐만 아니라 메모리와 디스크 대역폭까지 고르게 활용되어 인프라 병목 없이 균형 잡힌 자원 소비를 달성했다.
6.5 Large-Scale Cloud Provider

대규모 복합 워크로드 성능(Performance):
- Fig 11a는 AWS EC2 200개 노드 클러스터에서 실행된 1,200개 워크로드의 정규화된 성능 분포를 보여준다.
- 대다수 워크로드가 사전에 정의된 목표 성능을 정확하게 충족했다.
클러스터 사용률 향상(Utilization):
- Fig 11b-c는 전통적인 ‘예약 + LL 스케줄러’ 대비 Quasar의 서버별 CPU 사용률을 비교한다.
- 기존 예약 방식은 저조한 사용률에 허덕인 반면, Quasar는 배치 및 지연 시간 민감 워크로드의 QoS 제약을 지키면서도 평균 클러스터 사용률을 62%까지 끌어올렸다.
- Fig 11d는 실제 사용 리소스와 할당 리소스의 추이를 보여준다. Quasar는 이질성과 간섭이 성능에 미치는 영향을 정확히 알고 있으므로 불필요한 안전 마진(safety margin) 없이 매우 타이트하게 리소스를 최적화한다.
낮은 관리 오버헤드(Overhead):
- 프로파일링, 협업 필터링 분류, 그리디 스케줄링, 동적 적응을 모두 포함한 Quasar의 총 관리 오버헤드는 전체 워크로드 실행 시간의 평균 4.1%에 불과했다.
정확한 간섭 추론과 공동 최적화가 클라우드 인프라의 유휴 자원을 실질적인 처리량으로 전환시켰다.
6.6 한계 및 트레이드오프
- 프로파일링 오버헤드: 워크로드 승인 시 최소 2개 구성에서 샌드박스 프로파일링을 수행하므로 몇 초에서 1분가량의 시작 지연이 붙는다. 논문이 보고한 총 관리 오버헤드는 전체 실행 시간의 평균 4.1%이며, 실행 시간이 짧은 작업일수록 이 비율은 커진다.
- 잔여 추정 오차: 4차원 분류의 평균 오차는 8% 미만이고 목표 제약 충족도는 5% 내외의 오차를 동반하므로, 목표 성능을 오차 범위만큼 벗어날 가능성은 남는다.
- 제한된 추정 범위: 간섭 민감도는 2개 공유 리소스의 마이크로벤치마크로 측정하고 나머지는 협업 필터링으로 추론하며, scale-out 프로파일링은 1~4개 노드로 제한된다. 프로파일링에 없는 간섭 유형이나 과거 데이터에 없는 워크로드에서는 정확도가 낮아질 수 있다.
- 평가 범위와 출처: 검증 수치는 논문 저자들이 직접 수행해 보고한 결과이며 독립적인 제3자 재현은 아니다. 실험도 40대 로컬 클러스터와 200노드 EC2 클러스터, 특정 워크로드 집합에 국한된다.
핵심 요약 및 시사점
- 성능 중심 인터페이스로의 전환: 사용자가 임의로 하드웨어 자원을 예약하던 기존 방식의 비효율을 타파하고, QPS나 지연 시간 같은 고수준 성능 목표를 입력받아 시스템이 필요한 최소 자원을 결정하도록 패러다임을 바꿨다.
- 4차원 협업 필터링 분류: SVD 기반 협업 필터링을 시스템 스케줄링에 접목하여 scale-up, scale-out, heterogeneity, interference의 4개 직교 축에서 8% 미만의 평균 오차로 성능 곡선을 수초 내에 도출했다.
- 할당과 배정의 공동 최적화: 자원의 규모(할당)와 물리적 배치 위치(배정)를 단일 그리디 스케줄러 루프에서 동시에 풀어내어, 과다 프로비저닝을 제거하고 최적의 서버 패킹을 실현했다.
- 무부작용 샌드박싱과 동적 적응: LXC 컨테이너와 Copy-on-Write 스냅샷으로 프로덕션 부작용 없이 신속한 프로파일링을 수행하며, 런타임 phase 변화와 스트래글러를 실시간 감지해 능동적으로 재할당한다.
- 실증적 효용성 입증: 200개 노드 EC2 대규모 클라우드 환경에서 모든 워크로드의 엄격한 QoS를 98% 이상 수호하면서도, 데이터 센터 평균 CPU 사용률을 62%까지 대폭 끌어올렸다.
댓글남기기