2026 엔터프라이즈 에이전트 호스팅 & AI FinOps: AWS(Bedrock AgentCore vs HyperPod EKS)와 Azure(Foundry Copilot Harness vs Serverless GPU) 손익분기점 분석
에이전트 워크로드를 프로덕션 클라우드에 배포한 뒤 엔지니어링 조직이 직면하는 가장 현실적인 Day-2 운영 문제는 모델의 추론 정확도가 아니라 유휴 GPU로 인한 비용 누수(Idle GPU Waste)와 인프라 런타임 선택의 불확실성이다. 앞서 /cloud/cloud-finops/1에서 Inform·Optimize·Operate 순환과 예약 할인 전략을 살펴보았고, /cloud/cloud-security-governance/2에서 멀티계정 격리와 최소 권한 경계를 다뤘다면, 이제는 에이전트 런타임 고유의 비대칭적 트래픽 패턴과 장기 실행 세션 특성을 반영한 AI 전용 단위 경제학(AI Unit Economics)이 필요한 시점이다.
특히 2026년 하반기 들어 AWS가 Bedrock AgentCore와 SageMaker HyperPod EKS(InstantStart)를 고도화하고, Microsoft가 Microsoft Foundry(Copilot Harness, Routines)와 /azure/azure-container-apps-production/3의 확장인 Container Apps Serverless GPU, 그리고 /azure/entra-id-ai-service-auth/4 기반의 에이전트 신원 및 이그레스 통제를 잇달아 정식 출시하면서 아키텍트의 선택지는 크게 세분화되었다. 나아가 /agent/hle-benchmark-dynamic-token-budgeting-jev/5에서 확인했듯이 단일 추론 쿼리가 수만 개의 사고 토큰을 소모하는 환경에서는, 어떤 쿼리를 토큰 종량제 서버리스 런타임으로 보내고 어떤 쿼리를 상시 가동형 GPU 클러스터로 라우팅할지 결정하는 제어 플레인 설계가 인프라 원가를 직접 좌우한다.
멀티 클라우드 환경에서 엔터프라이즈 에이전트 플랫폼의 호스팅 토폴로지와 비용 손익분기점(Break-even Point)을 검토하면서 실측 데이터와 수식을 바탕으로 정리해 둔 아키텍처 결정 기준을 이 글에 함께 묶어 기록해 둡니다.
1. 클라우드 지출의 18%를 차지한 GPU, 그러나 95%는 유휴 상태다
2026년 엔터프라이즈 클라우드 재무 구조에서 가장 두드러진 변화는 가속기 컴퓨팅 지출의 구조적 팽창이다. 전통적인 무상태 웹 애플리케이션이나 배치 파이프라인과 달리, 거대언어모델(LLM) 및 자율 에이전트 워크로드는 고비용 HBM(High Bandwidth Memory)을 탑재한 GPU 인스턴스를 점유하면서도 실제 연산 활용률은 낮게 유지되는 비효율 구조를 보인다.
1.1 2026 AI FinOps 산업 지표와 95% 유휴 GPU 문제
가트너(Gartner)의 2026년 클라우드 및 AI 인프라 지출 분석에 따르면, 전 세계 기업의 신규 AI 인프라 설비 및 클라우드 지출 규모는 2026년 기준 4,010억 달러($401B)에 도달했으며, 기업 전체 클라우드 지출에서 GPU 워크로드가 차지하는 비중은 2023년 4%에서 2026년 18%로 4.5배 증가했다6. 단일 노드에 8개의 NVIDIA H100(80GB HBM3)을 장착한 AWS p5.48xlarge 인스턴스의 온디맨드 요금은 시간당 $55.04로, 1개 노드만 365일 상시 가동해도 월간 약 $40,000(연간 약 $482,000)의 고정 비용이 발생한다.
그러나 투입된 비용 대비 실제 하드웨어 가동률은 낮은 수준에 머물러 있다. CAST AI가 23,000개 이상의 프로덕션 쿠버네티스 클러스터를 전수 계측한 2026 State of Kubernetes Optimization Report에 따르면, 프로비저닝된 클라우드 GPU의 평균 연산 사용률(Utilization)은 5%에 불과하며 나머지 95%의 시간과 용량은 유휴 상태로 방치되고 있다7. Datadog의 컨테이너 리소스 활용률 보고서 역시 전체 컨테이너 인프라 지출의 83%가 실제 워크로드가 소비하지 않는 과잉 할당(Over-provisioned) 및 유휴 리소스에서 발생한다고 지적한다8.
| 계측 지표 (2026 산업 리포트 기준) | 측정 수치 | 출처 및 계측 대상 | 비용 및 운영상 시사점 |
|---|---|---|---|
| 기업 클라우드 지출 내 GPU 비중 | 18% (2023년 4%) | Gartner 2026 ($401B 신규 지출) | 클라우드 예산 통제의 핵심 축이 CPU에서 GPU로 이동 |
p5.48xlarge (8×H100) 온디맨드 단가 |
$55.04 / hr (월 ~$40,000) | AWS US-East 온디맨드 기준 | 단일 노드 유휴 방치 시 연간 약 6.5억 원 손실 |
| 쿠버네티스 클러스터 평균 GPU 사용률 | 5% (95% 유휴) | CAST AI 2026 (23,000개 클러스터) | 야간·주말 트래픽 공백 및 메모리 과잉 예약이 주원인 |
| 전체 컨테이너 비용 중 유휴 리소스 비중 | 83% | Datadog Container Report | 오토스케일러 미작동 및 정적 리소스 요청(Requests) 고정 |
1.2 AI 단위 경제성(Unit Economics) 수식과 3대 핵심 KPI
FinOps 재단(FinOps Foundation)의 AI 비용 관리 프레임워크는 인프라 총액이 아니라 비즈니스 산출물 1단위당 소요 비용을 추적하는 단위 경제성(Unit Economics)을 표준 지표로 삼는다9. 에이전트 호스팅 환경에서 아키텍트가 상시 계측해야 할 3대 핵심 성과 지표(KPI)는 토큰당 비용(Cost per Token), 추론 건당 비용(Cost per Inference), 모델 업데이트당 비용(Cost per Model Update)이다.
상시 가동형 GPU 인스턴스 클러스터에서 가동률 $\eta \in (0, 1]$에 따른 유효 백만 토큰당 비용 $C_{\text{1M-tokens}}(\eta)$는 시간당 노드 단가 $P_{\text{node}}$, 노드당 초당 최대 처리 토큰 수(Peak Throughput) $\Theta_{\text{max}}$, 그리고 스토리지·네트워크 이그레스·오케스트레이션 오버헤드 비용 $C_{\text{overhead}}$를 결합하여 다음과 같이 정식화된다.
\[C_{\text{1M-tokens}}(\eta) = \frac{(P_{\text{node}} + C_{\text{overhead}}) \times 10^6}{3600 \times \Theta_{\text{max}} \times \eta}\]이 수식이 보여주는 핵심 법칙은 유효 토큰 단가가 가동률 $\eta$에 반비례($\propto 1/\eta$)하여 비선형으로 급증한다는 점이다. 예를 들어 피크 처리량 기준으로 설계된 GPU 서빙 클러스터의 평균 가동률이 $\eta = 0.90$(90%)일 때 백만 토큰당 유효 비용이 $2.47이라면, 주간 업무 시간 외 유휴 구간으로 인해 평균 가동률이 $\eta = 0.30$(30%)으로 떨어지는 순간 동일한 인프라에서 백만 토큰당 유효 비용은 약 $8.00으로 3배 이상 치솟는다.
단일 에이전트 작업(Task) 단위의 추론 비용 $C_{\text{inference}}$는 에이전트 루프의 평균 호출 횟수 $K$, 턴당 입력 토큰 $T_{\text{in}}^{(k)}$, 출력 및 사고 토큰 $T_{\text{out}}^{(k)}$, 그리고 외부 도구 실행 시간 $t_{\text{tool}}$ 동안 점유되는 런타임 세션 유지 비용 $C_{\text{session}}$의 합으로 계산된다.
\[C_{\text{inference}} = \sum_{k=1}^{K} \left( T_{\text{in}}^{(k)} \cdot c_{\text{in}} + T_{\text{out}}^{(k)} \cdot c_{\text{out}} \right) + C_{\text{session}} \cdot t_{\text{tool}}\]또한 파인튜닝이나 연속 사전학습(Continual Pre-training)을 병행하는 조직에서는 체크포인트 저장소, 노드 장애로 인한 재학습 손실 시간 $t_{\text{recovery}}$, 검증 평가 파이프라인 비용을 합산한 모델 업데이트당 비용(Cost per Model Update)을 별도 KPI로 분리해 추적해야 추론 서빙 예산과의 혼선을 막을 수 있다.
1.3 GPU 적정화(Right-sizing)와 VPA 기반 리소스 재할당
GPU 단위 비용을 낮추는 첫 번째 엔지니어링 조치는 모델 파라미터 규모에 맞춘 하드웨어 적정화(Right-sizing)다. 모든 에이전트 서브태스크를 H100이나 A100 80GB 노드에 배치하는 대신, 라우팅·분류·요약과 같은 7B 이하 소형 모델은 시간당 $0.526(g4dn.xlarge)인 NVIDIA T4(16GB VRAM)에 배치하고, 13B~24B 규모의 4비트/8비트 양자화(FP8/AWQ) 모델은 NVIDIA L4(24GB VRAM, g6.xlarge)에 매핑하면 동일 처리량 대비 인스턴스 시간당 단가를 50~80% 절감할 수 있다.
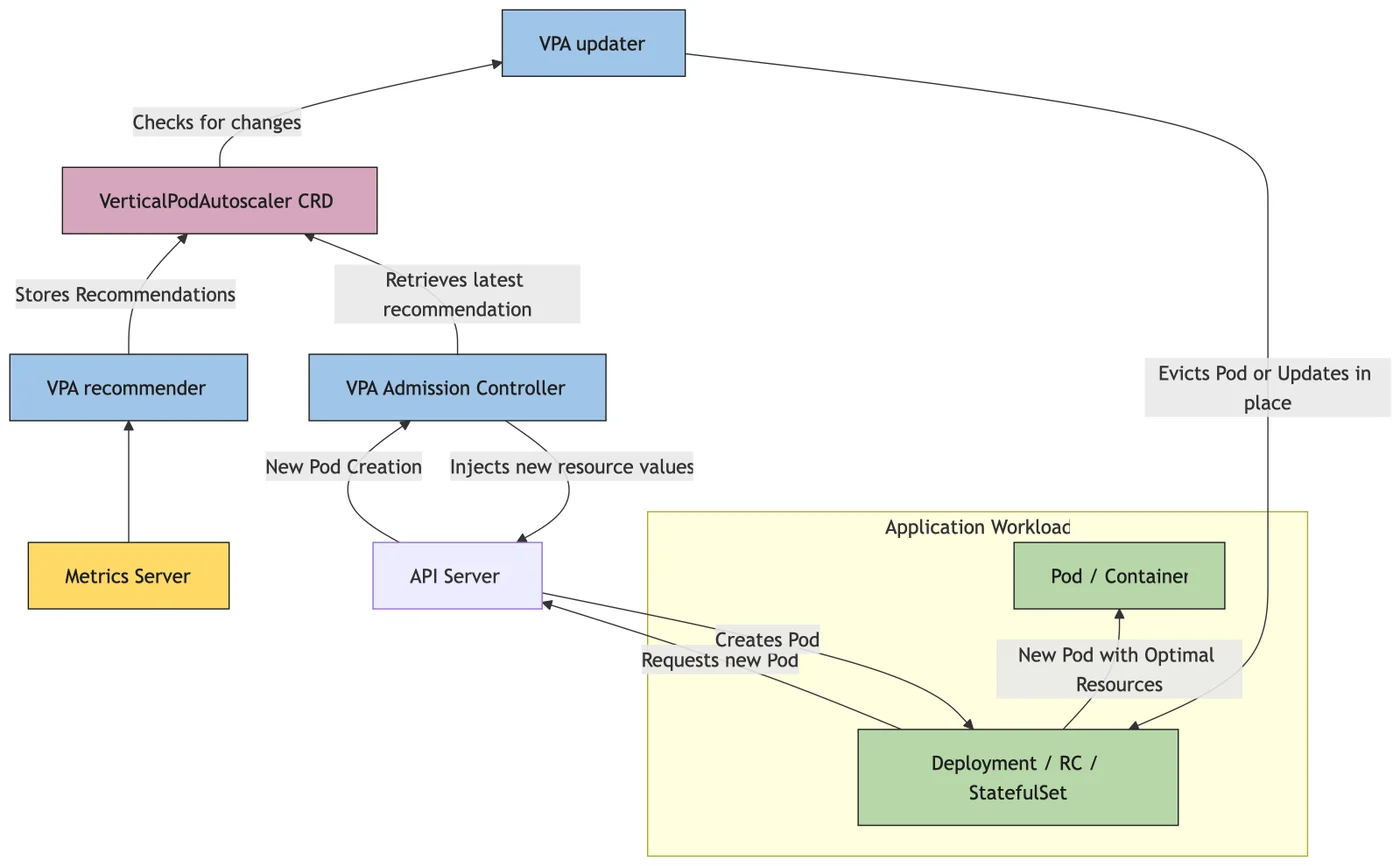 출처: Kubernetes Documentation — Vertical Pod Autoscaling, CC BY 4.0
또한 에이전트 오케스트레이터 파드, 도구 실행 샌드박스, 벡터 검색 사이드카 등 GPU 주변부 CPU·메모리 워크로드에서 발생하는 83%의 컨테이너 유휴 비용을 제거하기 위해 쿠버네티스 수직 파드 오토스케일러(Vertical Pod Autoscaler, VPA)를 결합한다. 위 공식 아키텍처 다이어그램에 나타난 것처럼 VPA는 과거 리소스 소비 히스토리를 분석해 적정 요청량(Requests)을 산출하는 recommender, 권장값과 현재 설정의 괴리가 임계치를 넘을 때 파드를 안전하게 퇴거시키는 updater, 그리고 신규 파드 생성 시점에 변경된 CPU·메모리 스펙을 주입하는 admission-controller의 3단 구조로 동작한다. GPU 노드의 호스트 메모리와 CPU가 보조 컨테이너의 과잉 예약으로 고갈되어 파드 스케줄링이 막히는 현상(Bin-packing 실패)을 VPA로 해소할 수 있다.
핵심 요약 — 클라우드 지출의 18%를 차지하는 GPU 인프라가 평균 95%의 유휴율을 기록하고 있으므로, 가동률($\eta$)에 반비례하는 토큰당 단가 수식을 기준으로 T4·L4 적정화와 VPA 리소스 최적화를 선행해야 한다.
2. AWS 2026 아키텍처 결정 프레임워크: Bedrock AgentCore vs SageMaker AI vs HyperPod EKS
AWS 생태계에서 에이전트 및 LLM 서빙 인프라를 설계할 때 가장 빈번히 발생하는 혼선은 브랜드 개편 이후의 서비스 경계와 과금 모델 차이를 정확히 구분하지 못하는 데서 비롯된다. 2026년 기준 AWS의 AI 스택은 역할에 따라 세 가지 축으로 명확히 나뉜다.
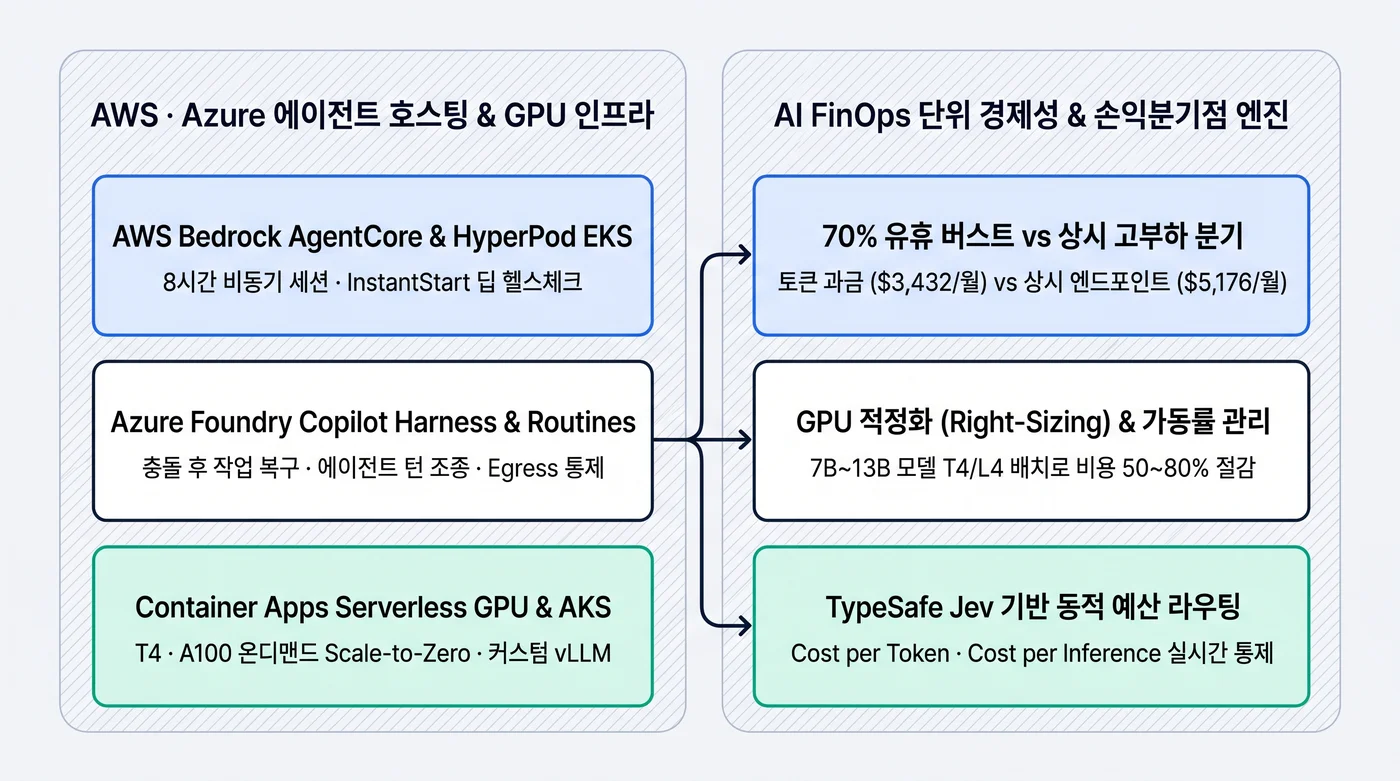
2.1 2026년 AWS AI 서비스 명칭 및 역할 경계 구분
2026년 아키텍처 리뷰에서 반드시 구분해야 할 세 가지 핵심 플랫폼의 정의는 다음과 같다.
- Amazon SageMaker AI: 기존 Amazon SageMaker에서 명칭이 변경된 완전관리형 머신러닝 플랫폼이다. 커스텀 모델 학습, 전용 실시간 추론 엔드포인트(Real-time Inference Endpoints), 배치 변환 등 인스턴스 기반의 ML 생명주기 전반을 담당한다.
- Amazon SageMaker Unified Studio: 데이터 엔지니어링(Athena, EMR, Redshift), 데이터 거버넌스(DataZone), 모델 개발(SageMaker AI) 및 생성형 AI 앱 빌더(Bedrock)를 단일 웹 인터페이스로 통합한 개발 환경이다. 런타임 호스팅 엔진이 아니라 통합 컨트롤 플레인 워크스페이스다.
- Amazon Bedrock (Bedrock AgentCore & Custom Model Import): 서버리스 파운데이션 모델 API 및 엔터프라이즈 에이전트 런타임 플랫폼이다. 자체 파인튜닝한 오픈웨이트 가중치를 S3에서 가져와 서버리스로 서빙하는 커스텀 모델 임포트(Custom Model Import)와, 에이전트 실행 루프·메모리·도구 호출을 서버리스로 호스팅하는 Bedrock AgentCore를 포함한다10.
여기서 흔히 제기되는 대안인 SageMaker Serverless Inference는 LLM 및 에이전트 서빙에 사용할 수 없다. SageMaker Serverless Inference는 컨테이너 메모리 상한이 6,144MB(6GB)로 엄격히 제한되어 있고 GPU 가속기를 전혀 지원하지 않기 때문에, 수 기가바이트 이상의 VRAM과 CUDA 연산을 요구하는 현대적 LLM 가중치를 로드할 수 없다.
2.2 손익분기점 정량 분석: 70% 유휴 버스트 워크로드의 비용 비교
전형적인 사내 업무용 에이전트(코드 리뷰, 사내 지식 검색, 재무 보고서 생성)는 평일 주간 업무 시간(오전 9시~오후 6시)에 트래픽이 집중되고 야간 및 주말을 포함한 전체 시간의 약 70% 동안 유휴(Idle) 상태에 머문다. ExploreAgentic AI의 2026년 비용 벤치마크 데이터를 기반으로 이러한 버스트성(Bursty) 에이전트 워크로드를 상시 가동형 SageMaker AI 엔드포인트와 서버리스 Bedrock에 각각 배포했을 때의 월간 비용을 비교해 보자11.
상시 가동형 SageMaker AI 실시간 엔드포인트에 시간당 $7.09인 GPU 인스턴스(예: 멀티 GPU g5.12xlarge 또는 고성능 추론 구성)를 월 730시간 내내 띄워 두면, 트래픽 유무와 무관하게 고정 인스턴스 비용이 청구된다.
반면 동일한 주간 활성 트래픽을 유휴 시간 과금이 $0인 Amazon Bedrock의 토큰 종량제(Pay-per-token) 및 Bedrock AgentCore 소비 기반 과금 모델로 처리하면, 실제 활성 구간(30% 시간대)에 발생한 입출력 토큰과 에이전트 세션 실행 시간만 과금되어 월간 총비용이 $3,432로 집계된다. 즉, 70% 유휴 구간이 존재하는 전형적인 엔터프라이즈 버스트 워크로드에서는 서버리스 아키텍처가 상시 가동형 엔드포인트 대비 월 $1,744(33.7%)의 직접 비용을 절감한다.
일반화하여 시간당 인스턴스 비용이 $P_{\text{inst}}$이고, 활성 시간 동안 시간당 평균 토큰 소비 비용이 $C_{\text{active_token}}$일 때, 전체 시간 중 활성 트래픽 비율(Duty Cycle) $\alpha \in [0, 1]$에 대한 손익분기점 $\alpha^*$는 다음과 같이 도출된다.
\[P_{\text{inst}} \times 730 = C_{\text{active\_token}} \times 730 \times \alpha^* \implies \alpha^* = \frac{P_{\text{inst}}}{C_{\text{active\_token}}}\]위 벤치마크 사례에서는 활성 구간 시간당 토큰 비용이 약 $15.67이므로 손익분기점 활성 비율은 $\alpha^* = 7.09 / 15.67 \approx 0.452$(45.2%)가 된다. 즉, 24시간 중 최대치 트래픽이 흐르는 시간이 45.2% 미만이면 Bedrock 서버리스가 유리하고, 24시간 글로벌 서비스처럼 평균 가동률이 45.2%를 지속적으로 초과하면 전용 인스턴스 클러스터가 저렴해진다.
2.3 런타임 아키텍처 비교: Bedrock AgentCore vs EKS Auto Mode vs SageMaker HyperPod EKS
워크로드의 트래픽 밀도와 인프라 제어권 요구사항에 따라 AWS의 3대 에이전트·모델 호스팅 런타임은 다음과 같은 기술적 특성을 가진다.
- Amazon Bedrock AgentCore:
- 배포 및 세션 지속성: 개발자가
@aws/agentcoreCLI의 단일 명령(npx @aws/agentcore deploy)만으로 LangGraph, CrewAI, 또는 자체 Python 에이전트 코드를 패키징해 배포할 수 있다10. 일반 서버리스 함수(AWS Lambda의 15분 제한)와 달리 단일 비동기 에이전트 세션을 최대 8시간(28,800초)까지 유지할 수 있어 대규모 리포지토리 리팩토링이나 다단계 데이터 분석 작업을 중단 없이 수행한다. - 서버리스 A2A(Agent-to-Agent) 정책 집행: 복수의 전문 에이전트가 협업할 때 호출자 에이전트와 피호출자 에이전트 간의 신원 검증 및 세밀한 권한 정책(Cedar 기반 가드레일 및 IAM Policy)을 게이트웨이 계층에서 서버리스로 강제한다.
- 배포 및 세션 지속성: 개발자가
- Amazon EKS Auto Mode (2026년 10월 업데이트):
- 자체 컨테이너화된 에이전트 게이트웨이와 마이크로서비스를 쿠버네티스 표준 API로 운영하되 노드 패치와 오토스케일러 관리를 위임하고자 할 때 선택한다. 2026년 10월 업데이트를 통해 고급 컴퓨트 설정(Advanced Compute Configuration)이 추가되면서, 커스텀 NodePool 가중치, 세밀한 코어·메모리 비율 제어, GPU 인스턴스 패밀리 우선순위 지정을 선언형 매니페스트로 직접 통제할 수 있게 되었다.
- Amazon SageMaker HyperPod EKS (2026년 4월~하반기 업데이트):
- 손익분기점($\alpha^*$)을 넘어서는 대규모 상시 추론 트래픽이나 수백 개 GPU를 묶는 분산 파인튜닝·강화학습(GRPO) 워크로드를 위한 인프라다12.
- HyperPod InstantStart: 쿠버네티스 컨트롤 플레인과 노드 프로비저닝 경로를 데이터 패스 외부에서 병렬 초기화함으로써, 대규모 EKS 기반 GPU 클러스터 컨트롤 플레인을 8~12분 이내에 기동한다.
- 온디맨드 딥 헬스체크(On-Demand Deep Health Checks): 2026년 4월 도입된 기능으로, 워크로드 투입 전후에 NVLink 대역폭, EFA(Elastic Fabric Adapter) 루프백, DCGM 하드웨어 무결성 검사를 온디맨드로 실행해 불량 GPU 노드를 사전 격리하고 자동 노드 교체(Auto-resume) 및 계층형 체크포인팅(Tiered Checkpointing)과 연동한다.
| 비교 항목 | Amazon Bedrock AgentCore | Amazon EKS Auto Mode (2026.10) | SageMaker HyperPod EKS (2026.04+) |
|---|---|---|---|
| 과금 구조 및 유휴 비용 | 토큰/세션 초당 과금 (유휴 시 $0) | EC2 인스턴스 시간당 과금 + 관리비 | 전용 HyperPod 인스턴스 시간당 과금 |
| 최대 세션 실행 시간 | 최대 8시간 비동기 세션 기본 지원 | 제한 없음 (파드 생명주기 직접 제어) | 제한 없음 (장기 분산 학습 및 상시 서빙) |
| 배포 및 운영 인터페이스 | @aws/agentcore CLI 단일 명령 |
Kubernetes API + 고급 컴퓨트 NodePool | HyperPod CLI / EKS 컨트롤 플레인 (8~12분 기동) |
| 하드웨어 결함 복구 | AWS 완전 위임 (사용자 비가시 영역) | 노드 비정상 시 EC2 자동 교체 | 온디맨드 딥 헬스체크(NVLink/EFA) + 자동 노드 복구 |
| 최적 워크로드 타깃 | 70% 이상 유휴 구간을 가진 버스트 에이전트 | 중규모 상시 에이전트 API 및 복합 마이크로서비스 | 고밀도 상시 LLM 서빙 및 대규모 가중치 학습 |
핵심 요약 — 주간 트래픽 위주의 70% 유휴 에이전트는 상시 가동형 SageMaker AI($5,176/월) 대신 Bedrock AgentCore($3,432/월)를 선택해 33.7% 비용을 절감하고, 가동률 손익분기점(45.2%)을 넘는 대규모 상시 부하는 InstantStart와 딥 헬스체크를 갖춘 SageMaker HyperPod EKS로 수용한다.
3. Azure 2026 아키텍처 결정 프레임워크: Microsoft Foundry 호스팅 에이전트 vs Container Apps Serverless GPU vs AKS
마이크로소프트 애저(Azure) 생태계 역시 2026년 8월부터 10월 사이에 엔터프라이즈 에이전트 런타임과 서버리스 GPU 서빙 영역에서 대규모 기능 통합을 단행했다. 과거 개발자가 직접 구현해야 했던 상태 복구, 백그라운드 스케줄링, 브라우저 샌드박스, 네트워크 이그레스 통제가 플랫폼 기본 기능으로 흡수되었다.
3.1 Microsoft Foundry (2026년 8월~10월 업데이트): Copilot Harness와 장기 실행 호스팅 에이전트
2026년 가을 릴리스를 통해 정립된 Microsoft Foundry 호스팅 에이전트(Hosted Agents)와 Copilot Harness(2026년 10월 28일 공개)는 단순 프롬프트 체인을 넘어선 장기 실행 자율 에이전트의 운영 안정성을 보장하는 데 초점을 맞춘다13.
- 충돌 후 작업 복구(Post-Crash Task Recovery) 및 재연결 스트리밍: 장기 실행 에이전트가 외부 API 타임아웃이나 컨테이너 재시작으로 중단되더라도, 마지막으로 커밋된 실행 그래프 체크포인트(State Checkpoint)에서 세션을 즉시 재개한다. 클라이언트가 네트워크 순단 후 재접속하면 누락된 토큰 및 도구 이벤트 스트림을 이어서 수신하는 재연결 스트리밍(Reconnectable Streaming)을 지원한다.
- 실행 중 에이전트 조종(Steerable Agents) 및 Human-in-the-Loop 승인: 에이전트가 다단계 도구 루프를 실행하는 도중에 사용자나 상위 감독 제어기가 개입해 제약 조건을 수정하거나 방향을 틀 수 있는 실시간 스티어링 인터페이스를 제공하며, 고위험 작업(DB 스키마 변경, 외부 결제 등) 직전에 실행을 일시 정지하고 관리자 승인을 대기하는 네이티브 게이트를 내장한다.
- Foundry Routines (2026년 9월 24일 GA): 별도의 Azure Functions, Logic Apps, 혹은 외부 메시지 큐(Service Bus)를 앞단에 구축하지 않고도, 크론(Cron) 스케줄이나 시스템 이벤트 트리거에 맞춰 에이전트 워크플로우를 백그라운드에서 자동 실행·재시도·데드레터 처리하는 관리형 자동화 엔진이다.
- 관리형 브라우저 자동화 도구(Managed Browser Automation Tool, 2026년 10월 19일 GA): 레거시 사내 웹 포털이나 API가 없는 외부 웹 시스템을 조작해야 하는 에이전트를 위해, 격리된 헤드리스 Chromium 풀과 DOM/시각적 액션 실행기를 Foundry 런타임 내부 도구로 기본 제공한다.
- 네트워크 이그레스 제어(Network Egress Control, 2026년 9월 24일) 및 Responses API 오케스트레이션: 에이전트 샌드박스에서 외부 인터넷으로 나가는 모든 아웃바운드 트래픽을 화이트리스트 도메인 및 프라이빗 엔드포인트 단위로 감사(Audit)하고 차단하여 프롬프트 인젝션을 통한 데이터 유출(Exfiltration)을 원천 봉쇄한다. 또한 Azure OpenAI Responses API를 통해 서버 측 대화 상태를 유지하면서 복수의 전문 에이전트 간 핸드오프(Handoff)와 병렬 도구 호출을 단일 API 표면에서 오케스트레이션한다.
3.2 커스텀 vLLM 서빙 대안: Azure Container Apps Serverless GPU vs AKS
오픈웨이트 모델(Llama 4, Qwen 3, DeepSeek 변형 등)이나 사내 파인튜닝 모델을 vLLM, SGLang, TGI 컨테이너로 직접 서빙해야 하지만 24시간 상시 트래픽이 보장되지 않는 경우, Azure Container Apps(ACA) Serverless GPU가 핵심 대안으로 작동한다14.
ACA Serverless GPU는 NVIDIA T4(NC8as-T4) 및 NVIDIA A100(NC24-A100) 가속기를 파드 단위로 온디맨드 할당하며, KEDA(Kubernetes Event-driven Autoscaling) 기반의 HTTP 동시성 또는 큐 길이 메트릭과 연동하여 트래픽이 없을 때 복제본 수를 0으로 줄이는 Scale-to-Zero를 지원한다. 초 단위로 과금되며 유휴 시 GPU 컴퓨트 비용이 완전히 $0으로 떨어지기 때문에, 커스텀 가중치를 유지하면서도 서버리스의 비용 탄력성을 얻을 수 있다.
반면 다음과 같은 조건에 해당하는 워크로드는 Azure Kubernetes Service(AKS) 전용 GPU 노드풀로 가야 한다.
- 초당 수백 건 이상의 요청이 24시간 유입되어 Scale-to-Zero가 발생할 틈이 없고, 1년/3년 예약 인스턴스(Azure Reservations) 할인을 적용받아 단가를 최대 60% 이상 낮춰야 하는 경우.
- 단일 노드의 A100 1장으로 감당할 수 없는 초대형 모델이라 InfiniBand RDMA(NDv5 H100/H200 시리즈) 기반의 멀티 노드 텐서·파이프라인 병렬화와 커스텀 데몬셋(GPU Operator, DCGM Exporter) 제어권이 필수적인 경우.
| 비교 항목 | Microsoft Foundry Hosted Agents | Azure Container Apps Serverless GPU | Azure Kubernetes Service (AKS GPU) |
|---|---|---|---|
| 주요 목적 | 장기 실행 에이전트 하네스·도구·상태 오케스트레이션 | 커스텀 vLLM/컨테이너 모델의 Scale-to-Zero 서빙 | 대규모 상시 추론 및 멀티노드 분산 GPU 클러스터 |
| 지원 가속기 및 런타임 | 관리형 Foundry 컴퓨트 + Responses API | NVIDIA T4, NVIDIA A100 (온디맨드 초당 과금) | 모든 Azure N-시리즈 VM (H100/H200 InfiniBand 포함) |
| 유휴 시 비용 (Idle Cost) | 유휴 시 추론 과금 $0 (Routines 실행 시만 과금) | Scale-to-Zero 지원 (Replicas = 0일 때 $0) | 노드 가동 시간당 상시 과금 (Cluster Autoscaler 의존) |
| 상태 복구 및 자동화 | Post-Crash 복구, Steerable Agents, Routines(09.24) | 컨테이너 수준 무상태 (외부 Redis/DB 결합 필요) | K8s 오퍼레이터(Kaito, Ray, LeaderWorkerSet) 직접 구축 |
| 네트워크 및 보안 통제 | 내장 Network Egress 제어(09.24) + Entra Agent ID | VNet 통합, 프라이빗 엔드포인트, Managed Identity | Calico/Cilium NetworkPolicy, Azure CNI Overlay |
핵심 요약 — Azure에서는 상태 복구·Routines·브라우저 도구·이그레스 통제가 필요한 에이전트 하네스는 Microsoft Foundry에 올리고, 간헐적 트래픽의 커스텀 vLLM 모델은 Container Apps Serverless GPU(T4/A100 Scale-to-Zero)로, 상시 고부하 멀티노드 서빙은 AKS로 분리 배치한다.
4. 멀티 클라우드 아키텍트를 위한 워크로드별 매핑 매트릭스와 FinOps 제어 코드
앞서 도출한 AWS와 Azure의 런타임 특성 및 손익분기점 공식을 결합하면, 엔터프라이즈 아키텍트는 워크로드의 4대 속성(트래픽 패턴, 세션 지속 시간, 커스텀 가중치 유무, 네트워크 격리 수준)에 따라 최적의 인프라를 결정론적으로 매핑할 수 있다.
4.1 워크로드 특성별 AWS·Azure 최적 인프라 매핑 매트릭스
| 워크로드 유형 및 조건 | 트래픽 패턴 (Duty Cycle) | 세션 지속 시간 및 상태 | AWS 최적 아키텍처 | Azure 최적 아키텍처 | 기대 FinOps 효과 |
|---|---|---|---|---|---|
| 사내 지식·코딩 보조 에이전트 | 주간 집중, 70% 유휴 ($\alpha < 0.35$) | 5분~최대 8시간 비동기 루프 | Bedrock AgentCore + Bedrock API | Microsoft Foundry (Copilot Harness) | 상시 GPU 대비 33~60% 비용 절감 |
| 정기 배치 감사·웹 크롤링 에이전트 | 일/주 단위 크론 트리거 ($\alpha < 0.10$) | 10~60분, 브라우저·도구 집중 | Bedrock AgentCore + EventBridge | Foundry Routines + Browser Tool | 별도 큐·상시 워커 인프라 비용 100% 제거 |
| 도메인 특화 파인튜닝 모델 (7B~70B) 버스트 서빙 | 간헐적 스파이크 ($\alpha < 0.45$) | 단발성/짧은 멀티턴 추론 | Bedrock Custom Model Import | Container Apps Serverless GPU (T4/A100) | Scale-to-Zero로 야간·주말 유휴 GPU 비용 $0 |
| 글로벌 고객 대면 상시 고부하 에이전트 | 24×7 지속 트래픽 ($\alpha > 0.65$) | 저지연(p99 < 2s) 스트리밍 | EKS Auto Mode + Karpenter GPU | AKS + Kaito / 예약 VM 노드풀 | 토큰 종량제 대비 대량 처리 단가 40~55% 절감 |
| 초거대 모델 연속 학습 및 고밀도 멀티노드 추론 | 상시 80%+ 클러스터 점유 ($\alpha > 0.80$) | 수일~수주 장기 분산 작업 | SageMaker HyperPod EKS (InstantStart) | AKS NDv5 (H100 InfiniBand) + CycleCloud | 딥 헬스체크·자동 노드 복구로 학습 중단 손실 최소화 |
4.2 TypeSafe System One(Jev) 기반 동적 FinOps 디스패처 구현
실제 엔터프라이즈 환경에서는 단일 플랫폼으로 모든 요청을 처리하기보다, 평시 베이스라인 트래픽은 예약 할인된 전용 GPU 클러스터(HyperPod EKS / AKS)에서 소화하고, 초과 스파이크나 최대 8시간이 걸리는 고복잡도 자율 루프는 서버리스 에이전트 런타임(Bedrock AgentCore / Foundry)으로 오버플로우(Overflow)시키는 하이브리드 토폴로지가 가장 높은 비용 효율을 달성한다.
이때 인바운드 요청의 작업 복잡도, 예상 실행 시간, 보안 이그레스 민감도를 생성형 LLM으로 먼저 판단하려 하면 그 자체로 수백 밀리초의 지연과 추가 토큰 비용이 발생한다. 대신 TypeSafe AI의 비생성형 판단 모델인 System One(Jev, POST /v1/systemone)을 라우터 앞단에 배치하면, 단 70~120ms 만에 1M 입력 토큰당 $0.042의 초저비용으로 스키마 오류(0%) 없이 최적의 실행 런타임과 하드웨어 티어를 결정할 수 있다15.
먼저 /v1/systemone 엔드포인트로 전송되는 원시 HTTP 요청 페이로드 구조는 다음과 같이 배경 데이터(state)와 순수 판단 규칙(questions)을 엄격히 분리한다.
{
  "state": {
    "prompt_preview": "지난 4분기 전체 마이크로서비스 리포지토리 42개의 Terraform 모듈에서 IAM 와일드카드 권한을 전수 스캔하고 최소 권한 PR을 생성해 줘.",
    "tenant_tier": "enterprise_regulated",
    "cluster_telemetry": {
      "hyperpod_gpu_utilization_pct": 88.5,
      "aca_serverless_warm_replicas": 2,
      "remaining_daily_token_budget_usd": 145.20
    }
  },
  "questions": {
    "execution_profile": {
      "type": "choice",
      "instructions": "요청된 작업의 예상 실행 시간과 도구 호출 패턴에 따라 실행 프로파일을 분류하시오.",
      "criteria": {
        "short_sync_inference": "단일 응답 생성 또는 3회 이하의 즉시 조회로 30초 이내에 완료되는 동기식 질의.",
        "burst_custom_weight": "사내 파인튜닝 전용 모델 가중치 추론이 필요하나 장기 루프가 아닌 단발성 분석 작업.",
        "long_running_autonomous": "다수 리포지토리 순회, 외부 브라우저 조작, 코드 수정 및 테스트 반복 등 10분~8시간이 소요되는 장기 자율 에이전트 작업."
      }
    },
    "compute_intensity": {
      "type": "score",
      "instructions": "요구되는 추론 모델의 파라미터 체급 및 연산 집약도 수준을 평가하시오.",
      "criteria": {
        "0": "단순 분류, 텍스트 요약, 정규식 추출 등 7B 이하 경량 모델(NVIDIA T4급)로 처리 가능한 작업.",
        "1": "중간 난이도의 코드 생성 및 다문서 합성으로 13B~32B 양자화 모델(NVIDIA L4/A100 단일 카드)이 적합한 작업.",
        "2": "복합 아키텍처 추론, 대규모 리팩토링, 정밀 감사 등 70B 이상 프론티어 모델 또는 다단계 사고 루프가 필수적인 작업."
      }
    },
    "requires_strict_egress_lock": {
      "type": "noul",
      "instructions": "작업 대상에 IAM 권한, 재무 원장, 개인식별정보(PII) 또는 프로덕션 인프라 변경이 포함되어 외부 인터넷 이그레스 차단 샌드박스가 필수적인가?"
    }
  }
}
위 스냅 판정 결과를 받아 AWS와 Azure의 호스트 인프라로 결정론적 분기(if-else)를 수행하는 Python 제어 코드는 다음과 같다.
from dataclasses import dataclass
from typesafe import SystemOne, Choice, Score, Noul

client = SystemOne()

FINOPS_DISPATCH_RUBRIC = {
    "execution_profile": Choice(
        instructions="요청된 작업의 예상 실행 시간과 도구 호출 패턴에 따라 실행 프로파일을 분류하시오.",
        criteria={
            "short_sync_inference": "단일 응답 생성 또는 3회 이하의 즉시 조회로 30초 이내에 완료되는 동기식 질의.",
            "burst_custom_weight": "사내 파인튜닝 전용 모델 가중치 추론이 필요하나 장기 루프가 아닌 단발성 분석 작업.",
            "long_running_autonomous": "다수 리포지토리 순회, 외부 브라우저 조작, 코드 수정 및 테스트 반복 등 10분~8시간이 소요되는 장기 자율 에이전트 작업.",
        },
    ),
    "compute_intensity": Score(
        instructions="요구되는 추론 모델의 파라미터 체급 및 연산 집약도 수준을 평가하시오.",
        criteria={
            0: "단순 분류, 텍스트 요약, 정규식 추출 등 7B 이하 경량 모델(NVIDIA T4급)로 처리 가능한 작업.",
            1: "중간 난이도의 코드 생성 및 다문서 합성으로 13B~32B 양자화 모델(NVIDIA L4/A100 단일 카드)이 적합한 작업.",
            2: "복합 아키텍처 추론, 대규모 리팩토링, 정밀 감사 등 70B 이상 프론티어 모델 또는 다단계 사고 루프가 필수적인 작업.",
        },
    ),
    "requires_strict_egress_lock": Noul(
        instructions="작업 대상에 IAM 권한, 재무 원장, 개인식별정보(PII) 또는 프로덕션 인프라 변경이 포함되어 외부 인터넷 이그레스 차단 샌드박스가 필수적인가?"
    ),
}

@dataclass
class DispatchTarget:
    provider_runtime: str
    hardware_sku: str
    egress_policy: str
    max_session_seconds: int

def route_agent_workload(
    prompt_preview: str,
    tenant_tier: str,
    cluster_telemetry: dict,
    preferred_cloud: str = "aws",
) -> DispatchTarget:
    # 단일 패스 병렬 스냅 판정 (70~120ms)
    eval_res = client.evaluate(
        state={
            "prompt_preview": prompt_preview,
            "tenant_tier": tenant_tier,
            "cluster_telemetry": cluster_telemetry,
        },
        questions=FINOPS_DISPATCH_RUBRIC,
    )

    profile = eval_res.execution_profile.choice
    profile_conf = eval_res.execution_profile.prob
    intensity = eval_res.compute_intensity.score
    strict_egress = eval_res.requires_strict_egress_lock.prob >= 0.80

    egress_mode = "isolated_allowlist_only" if strict_egress else "standard_nat_audit"

    # 1. 장기 실행 자율 에이전트 (최대 8시간 세션 또는 충돌 복구 필요)
    if profile == "long_running_autonomous" and profile_conf >= 0.75:
        if preferred_cloud == "aws":
            return DispatchTarget(
                provider_runtime="aws_bedrock_agentcore",
                hardware_sku="serverless_managed_frontier",
                egress_policy=egress_mode,
                max_session_seconds=28800,  # 8 hours
            )
        return DispatchTarget(
            provider_runtime="azure_foundry_copilot_harness",
            hardware_sku="foundry_hosted_recoverable",
            egress_policy=egress_mode,
            max_session_seconds=28800,
        )

    # 2. 커스텀 가중치 버스트 추론 (Scale-to-Zero 서버리스 GPU 활용)
    if profile == "burst_custom_weight":
        gpu_sku = "nvidia_t4_16gb" if intensity == 0 else "nvidia_a100_80gb"
        if preferred_cloud == "azure":
            return DispatchTarget(
                provider_runtime="azure_container_apps_serverless_gpu",
                hardware_sku=gpu_sku,
                egress_policy=egress_mode,
                max_session_seconds=600,
            )
        return DispatchTarget(
            provider_runtime="aws_bedrock_custom_model_import",
            hardware_sku="serverless_custom_model_unit",
            egress_policy=egress_mode,
            max_session_seconds=600,
        )

    # 3. 단기 동기식 질의: 전용 클러스터 여유 용량이 있으면 고정비 클러스터로 우선 배정하여 가동률(eta) 극대화
    gpu_util = cluster_telemetry.get("hyperpod_gpu_utilization_pct", 100.0)
    if gpu_util < 85.0:
        right_sized_tier = "g4dn_t4_pool" if intensity == 0 else "g6_l4_pool" if intensity == 1 else "p5_h100_pool"
        return DispatchTarget(
            provider_runtime="sagemaker_hyperpod_eks" if preferred_cloud == "aws" else "azure_aks_gpu_pool",
            hardware_sku=right_sized_tier,
            egress_policy=egress_mode,
            max_session_seconds=120,
        )

    # 4. 전용 클러스터 포화(>85%) 시 서버리스 토큰 API로 스파이크 오버플로우
    return DispatchTarget(
        provider_runtime="aws_bedrock_on_demand" if preferred_cloud == "aws" else "azure_openai_responses_api",
        hardware_sku="serverless_token_tier",
        egress_policy=egress_mode,
        max_session_seconds=300,
    )
위 코드는 AI에게 라우팅 실행 권한을 위임하지 않고, 호스트 애플리케이션 코드가 클러스터 실시간 가동률(gpu_util < 85.0)과 Jev의 보정된 확률(profile_conf >= 0.75, strict_egress >= 0.80)을 결합해 결정론적으로 인프라를 선택하는 코드-퍼스트(Code-First) 제어 패턴을 구현한다.
핵심 요약 — 상시 전용 GPU 클러스터의 가동률을 85%까지 채워 단위 토큰 비용을 낮추되, 8시간 장기 자율 루프와 스파이크 트래픽은 System One(Jev)의 100ms 스냅 판정을 통해 서버리스 에이전트 런타임과 T4/L4/A100 적정화 풀로 동적 분기한다.
5. 실전 테라폼/배포 설정과 FinOps 거버넌스 정책
아키텍처 결정을 실제 클라우드 인프라에 코드형 인프라(IaC)로 고정할 때는 유휴 시 자동 축소(Scale-to-Zero) 조건, 하드웨어 헬스체크, 그리고 예산 상한 가드레일을 선언적으로 명시해야 한다.
5.1 Azure Container Apps Serverless GPU (A100/T4 Scale-to-Zero) 구성
다음 Bicep/ARM 호환 YAML 매니페스트는 커스텀 vLLM 추론 컨테이너에 Consumption-GPU-NC24-A100(또는 경량 모델용 Consumption-GPU-NC8as-T4) 워크로드 프로파일을 연결하고, 유휴 시간 300초 경과 시 파드 개수를 minReplicas: 0으로 축소해 유휴 GPU 과금을 원천 차단하는 프로덕션 구성이다.
apiVersion: app.azure.com/v1alpha2
kind: ContainerApp
metadata:
  name: custom-vllm-agent-worker
  namespace: ai-finops-prod
  labels:
    finops.cost-center: "agent-platform"
    finops.workload-type: "burst-custom-weight"
    finops.idle-policy: "scale-to-zero"
spec:
  workloadProfileName: "gpu-a100-serverless" # Consumption-GPU-NC24-A100 또는 Consumption-GPU-NC8as-T4
  configuration:
    activeRevisionsMode: Single
    ingress:
      external: false
      targetPort: 8000
      transport: http
  template:
    containers:
      - name: vllm-openai-server
        image: acraiplatformprod.azurecr.io/vllm-qwen3-32b-awq:v2026.10
        resources:
          cpu: 24.0
          memory: 220Gi
          gpu: 1
        env:
          - name: VLLM_MAX_MODEL_LEN
            value: "32768"
          - name: VLLM_GPU_MEMORY_UTILIZATION
            value: "0.92"
    scale:
      minReplicas: 0
      maxReplicas: 8
      cooldownPeriod: 300
      pollingInterval: 15
      rules:
        - name: http-concurrency-scaler
          http:
            metadata:
              concurrentRequests: "16"
5.2 AWS SageMaker HyperPod EKS 딥 헬스체크 및 자동 복구 구성
대규모 상시 트래픽과 학습을 담당하는 SageMaker HyperPod EKS 클러스터에서는 불량 GPU로 인한 좀비 파드와 학습 멈춤(Hang)으로 수만 달러가 증발하는 것을 막기 위해, 온디맨드 딥 헬스체크(DeepHealthCheck)와 자동 노드 교체 정책을 클러스터 스펙에 강제한다.
apiVersion: sagemaker.aws.amazon.com/v1
kind: HyperPodCluster
metadata:
  name: enterprise-agent-hyperpod-eks
  annotations:
    sagemaker.amazonaws.com/instant-start: "enabled"
    finops.company.io/owner: "ml-infra-team"
    finops.company.io/budget-alert-usd: "45000"
spec:
  orchestrator:
    eks:
      clusterArn: "arn:aws:eks:us-east-1:123456789012:cluster/agent-serving-eks"
  nodeRecovery: "Automatic"
  instanceGroups:
    - name: h100-high-throughput-pool
      instanceType: "ml.p5.48xlarge"
      instanceCount: 4
      lifeCycleConfig:
        sourceS3Uri: "s3://enterprise-ai-ops-us-east-1/lifecycle-scripts/"
        onCreate: "on_create_efa_nccl_tune.sh"
      deepHealthChecks:
        - "InstanceStress"
        - "InstanceConnectivity"
      onDemandHealthCheckSchedule:
        triggerOnNodeReboot: true
        verifyNvlinkBandwidth: true
        verifyEfaLoopback: true
위 설정이 적용되면 노드가 기동되거나 재부팅될 때마다 EFA 패브릭 루프백과 NVLink 대역폭 검증이 자동 실행되며, 기준치 미달 노드는 쿠버네티스 스케줄러에서 즉시 격리(Cordon)된 뒤 과금 없는 새 건강 노드로 자동 교체된다.
핵심 요약 — Container Apps Serverless GPU는 minReplicas: 0과 300초 쿨다운으로 유휴 과금을 0원으로 만들고, SageMaker HyperPod EKS는 InstanceStress 및 InstanceConnectivity 딥 헬스체크를 선언해 불량 GPU 노드로 인한 매몰 비용을 차단한다.
6. 엔지니어링 한계와 트레이드오프
서버리스 에이전트 런타임과 Scale-to-Zero GPU, 그리고 Jev 기반 동적 라우팅을 프로덕션에 도입할 때는 다음 다섯 가지 엔지니어링 한계와 비용 트레이드오프를 반드시 설계에 반영해야 한다.
- Scale-to-Zero 환경의 컨테이너 및 모델 가중치 콜드 스타트 지연:
- Azure Container Apps Serverless GPU에서 복제본이
0에서1로 기동할 때, 수십 기가바이트의 컨테이너 이미지 풀(Pull)과 VRAM으로의 가중치 적재에 T4 기준 25~45초, A100(32B~70B 모델) 기준 60~120초의 콜드 스타트 지연이 발생한다. 실시간 대화형 SLO(p95 < 3초)가 요구되는 경로에서는 콜드 스타트를 숨기기 위해 첫 1~2턴은 서버리스 토큰 API(Bedrock/Azure OpenAI)로 즉시 응답하면서 백그라운드에서 Serverless GPU 컨테이너를 워밍업(Warm-up)하는 폴백 브리징 패턴이 필요하다.
- Azure Container Apps Serverless GPU에서 복제본이
- 토큰 종량제 모델의 트래픽 급증 시 손익분기점 역전(Cross-over Point):
- 주간 버스트 워크로드(활성 비율 $\alpha = 0.30$)에서는 Bedrock이 SageMaker AI 대비 33.7% 저렴하지만, 서비스가 성장하여 평균 활성 비율이 손익분기점($\alpha^* \approx 0.452$)을 넘어 70~80%에 도달하면 토큰 종량제 청구액이 전용 인스턴스 고정비를 최대 1.8~2.2배 초과하는 역전 현상이 발생한다. 따라서 FinOps 파이프라인은 주간 단위로 $\alpha$ 지표를 계측해 $\alpha > 0.50$이 2주 연속 유지되면 해당 워크로드를 HyperPod EKS 또는 AKS 예약 노드풀로 마이그레이션하는 트리거를 갖춰야 한다.
- 장기 실행 세션(최대 8시간)의 상태 직렬화 및 이그레스 감사 오버헤드:
- Bedrock AgentCore의 8시간 세션이나 Foundry의 Post-Crash Task Recovery는 매 도구 실행 턴마다 메모리 그래프와 실행 컨텍스트를 외부 스토리지에 직렬화(Checkpointing)한다. 컨텍스트 창이 100K 토큰을 넘어가면 상태 스냅샷 저장 및 Network Egress 심층 패킷 감사로 인해 턴당 40~90ms의 고정 I/O 지연과 추가 스토리지 IOPS 비용이 누적된다.
- 홀드아웃 데이터셋 기반
Jev라우팅 임계값 보정(Calibration) 필수:- 4절의 디스패처 코드에서 사용한 확률 임계값(
profile_conf >= 0.75,strict_egress >= 0.80)을 검증 없이 임의의 상수로 고정하면, 단기 작업을 장기 에이전트 하네스로 과잉 배정하거나 반대로 장기 작업이 120초 동기 타임아웃에 걸려 실패할 수 있다. 반드시 사내 실제 프롬프트 로그 500~1,000건으로 구성된 홀드아웃(Held-out) 데이터셋에서 정밀도-재현율(Precision-Recall) 및 비용 곡선을 실측하여 도메인별 임계값을 보정해야 한다.
- 4절의 디스패처 코드에서 사용한 확률 임계값(
- 타입 안정성과 무오류성의 구별 및 다층 방어:
SystemOne(Jev)이 스키마 파싱 에러 0%로 결정론적 타입(Choice,Score,Noul)을 반환한다는 것이 모든 분류 판정의 무오류성(Infallibility)을 보장하지는 않는다. 적대적 프롬프트가 경량 작업으로 위장해 고비용 추론 루프를 유발하거나 이그레스 통제를 우회하려 할 수 있으므로,Jev판정과 별개로 컨테이너 런타임 수준의 최대 토큰 하드 캡(max_tokens)과 VNet/VPC 방화벽 수준의 물리적 아웃바운드 차단 규칙을 중첩 적용해야 한다.
핵심 요약 — Scale-to-Zero의 60~120초 콜드 스타트와 가동률 45.2% 이상에서의 토큰 비용 역전 현상을 방어하기 위해, 서버리스 워밍업 브리징과 주간 가동률($\alpha$) 자동 계측, 그리고 홀드아웃 데이터 기반의 Jev 임계값 보정을 함께 운영해야 한다.
References
-
ingu627.github.io: 클라우드 비용 최적화(FinOps): 단위 경제학과 예약 전략 (2026). /cloud/cloud-finops/ ↩
-
ingu627.github.io: 클라우드 보안과 거버넌스: IAM 최소 권한·네트워크 경계·멀티계정 통제 (2026). /cloud/cloud-security-governance/ ↩
-
ingu627.github.io: Azure Container Apps 프로덕션 설계: KEDA 오토스케일링과 리비전 트래픽 분할 (2026). /azure/azure-container-apps-production/ ↩
-
ingu627.github.io: Entra ID 기반 AI 서비스 인증 아키텍처: Managed Identity와 OBO 플로우 (2026). /azure/entra-id-ai-service-auth/ ↩
-
ingu627.github.io: Humanity’s Last Exam(HLE) 시대, 추론 토큰 파산을 막는 동적 예산 라우팅: System One(Jev)과 하이브리드 추론의 결합 (2026). /agent/hle-benchmark-dynamic-token-budgeting-jev/ ↩
-
Gartner: Forecast Analysis: AI Infrastructure and Cloud GPU Spending Worldwide, 2023–2026 (2026). https://www.gartner.com/en/information-technology ↩
-
CAST AI: 2026 State of Kubernetes Optimization Report (Analysis of 23,000+ Clusters) (2026). https://cast.ai/kubernetes-cost-benchmark-report/ ↩
-
Datadog: State of Cloud Costs and Container Resource Utilization Report (2026). https://www.datadoghq.com/state-of-cloud-costs/ ↩
-
FinOps Foundation: FinOps for AI and Unit Economics Framework (2026). https://www.finops.org/wg/finops-for-ai/ ↩
-
AWS Official Documentation: Amazon Bedrock AgentCore Runtime & Custom Model Import Developer Guide (2026). https://docs.aws.amazon.com/bedrock/ ↩ ↩2
-
ExploreAgentic AI: 2026 Enterprise Agent Hosting Benchmark: Amazon Bedrock AgentCore vs SageMaker AI Cost Analysis (2026). https://aws.amazon.com/bedrock/pricing/ ↩
-
AWS Official Documentation: Amazon SageMaker HyperPod with Amazon EKS Orchestration — InstantStart & Deep Health Checks (2026). https://docs.aws.amazon.com/sagemaker/latest/dg/sagemaker-hyperpod-eks.html ↩
-
Microsoft Learn: Microsoft Foundry Hosted Agents, Copilot Harness, Routines, and Network Egress Control (August–October 2026 Release Notes) (2026). https://learn.microsoft.com/en-us/azure/ai-studio/ ↩
-
Microsoft Learn: Azure Container Apps Serverless GPUs (NVIDIA T4 & A100) and KEDA Scale-to-Zero Architecture (2026). https://learn.microsoft.com/en-us/azure/container-apps/gpu-Overview ↩
-
TypeSafe AI Official Documentation: System One (
/v1/systemone) & Jev Question Design Guide (2026). https://docs.typesafe.ai ↩
댓글남기기