쿠버네티스 AI 추론 스택 추상화: kro(Kube Resource Orchestrator) ResourceGraphDefinition과 Crossplane v2 아키텍처 비교
이 글을 30초에 파악하기
한 줄로 — AI 추론 서버 하나를 올리는 데 필요한 쿠버네티스 설정 파일이 여러 팀 폴더에 흩어져 있을 때, 그 묶음을 대신 만들어 주는 두 도구(kro와 Crossplane v2)를 나란히 놓고 어디에 무엇을 쓸지 정리한다.
읽고 나면 알게 되는 것
- 서비스 하나에 왜 여섯 가지 종류의 쿠버네티스 리소스가 필요하고, 손으로 엮을 때 설정이 어긋나는 이유
- kro가 클러스터 안 리소스를 하나의 상위 API로 합성하는 방식과, Crossplane v2가 네임스페이스 단위로 구조를 바꾼 지점
- Helm·kro·Crossplane v2를 어떤 기준으로 나눠 쓰고, 프로덕션에 넣을 때 무엇이 걸림돌이 되는지
용어 먼저 보기
| 용어 | 한 줄 설명 | 이 글에서의 역할 |
|---|---|---|
| CRD | 쿠버네티스에 원래 없던 새 리소스 종류를 등록해 두는 정의서 | 1절에서 AI 추론 스택이 요구하는 6종 목록 |
| Helm | YAML 템플릿을 한 번 렌더링해 배포하는 패키징 도구 | 1.2절 한계 분석과 4.1절 비교표 |
| kro | 클러스터 안의 리소스 여러 개를 하나의 상위 API로 묶는 컨트롤러 | 2절 전체와 5.1절 매니페스트 |
| ResourceGraphDefinition(RGD) | kro에 어떤 하위 리소스를 어떤 순서로 만들지 선언하는 매니페스트 | 2.1절 합성 메커니즘, 5.1절 예시 |
| CEL | 쿠버네티스에서 참조와 조건을 식으로 쓰는 표현식 언어 | 2.2절 정적 타입 검증, 5.2절 수치 제약 |
| DAG | 한 방향으로만 흐르고 되돌아오지 않는 의존 순서 그래프 | 2.3절 위상 정렬 |
| Managed Resource(MR) | Crossplane이 클라우드 자원 하나를 쿠버네티스 객체로 대표한 것 | 3.1절 v1 구조 부채, 3.2절 v2 변화 |
이런 분께 — 클러스터에 AI 추론 서비스를 올리면서 매니페스트 관리가 감당이 안 되는 플랫폼·인프라 엔지니어. 처음이라면 4절 비교표로 세 도구의 차이를 먼저 잡고 2절과 3절의 원리로 돌아오면 된다.
금요일 밤, 모델 버전 하나를 올리려고 저장소를 열었더니 서로 다른 팀이 관리하는 매니페스트가 여러 벌로 흩어져 있었다. 어느 파일을 먼저 고쳐야 하는지 적어 둔 사람은 없었다.
엔터프라이즈 환경에서 대규모 언어 모델(LLM)이나 멀티모달 에이전트 서비스를 쿠버네티스(Kubernetes) 클러스터 위에 프로덕션 수준으로 배포하는 일은 단순하지 않다. 단일 Deployment와 Service 두 개의 YAML 파일로는 끝나지 않는다. 앞서 살펴본 쿠버네티스 DRA(Dynamic Resource Allocation) 기반 GPU 스케줄링1으로 NVLink와 RDMA NIC 토폴로지를 할당한다.
분리형 서빙(Disaggregated Serving) 및 Gateway API Inference Extension(GAIE)2으로 프리필(Prefill)과 디코드(Decode) 파드 풀을 제어한다. 여기에 Cilium Tetragon eBPF 커널 보안 및 OTel GenAI 관측성3까지 결합하면 사정이 달라진다. 단일 모델을 서빙하는 데만 최소 6개 이상의 사용자 정의 리소스 정의(CustomResourceDefinition, CRD) 인스턴스가 필요하다.
그것도 상호 참조로 엮은 상태여야 한다.
문제는 그 요구 대상이 바뀔 때 생긴다. 플랫폼 위에서 모델을 배포하려는 애플리케이션 엔지니어와 ML 연구원에게 하부 인프라 CRD의 세부 스펙을 직접 작성하라고 요구하기 때문이다. 서비스 하나당 400~700줄에 달하는 YAML 보일러플레이트가 수십 개 팀의 Git 저장소로 복제된다.
그 과정에서 레이블 셀렉터 불일치, 보안 정책 누락, 버전 파편화 같은 설정 드리프트(Configuration Drift)가 일상화된다. 기존 IaC와 GitOps 실전 아키텍처(Terraform·Helm·ArgoCD·Flux)4에서 표준으로 쓰이던 Helm 차트는 정적 문자열 치환에 기반한다. 따라서 선행 리소스의 런타임 상태(status)를 읽어 후행 리소스의 스펙(spec)에 주입하는 동적 의존성 오케스트레이션은 수행하지 못한다.
Helm은 반죽을 한 번 섞어 오븐에 넣는 방식에 가깝다. 다 구워진 뒤에야 속을 들여다볼 수 있고, 그 결과를 다시 반죽에 되돌리는 단계는 없다.
인클러스터 AI 추론 스택과 클라우드 외부 리소스를 단일 추상화 API로 캡슐화하는 방법이 궁금했다. 그 답을 찾으려고 쿠버네티스 네이티브 리소스 합성기인 kro(Kube Resource Orchestrator)5를 살펴본다. 2025년 하반기에 아키텍처를 전면 개편한 Crossplane v26의 내부 동작 원리도 함께 본다. 두 도구의 조합 패턴을 개인 연구 및 아키텍처 리뷰 목적으로 정리해 보았습니다.
1. AI 서비스 하나를 배포하기 위해 왜 6개의 CRD를 손으로 엮어야 하는가
새 모델을 붙이려고 저장소를 열었더니 GPU 요청서, 분산 추론 워크로드, 라우팅 설정, 커널 보안 정책이 저마다 다른 폴더에 흩어져 있었다. 한 파일을 고치면 다른 파일의 레이블이 어긋났다.
이 절은 AI 서비스 하나를 배포할 때 매니페스트가 왜 여섯 갈래로 찢어지는지 정리한다. 현대 쿠버네티스 기반 AI 플랫폼은 기능마다 담당 오퍼레이터(Operator)를 따로 두는 구조로 발전했다. 하드웨어 친화성(Hardware Affinity), 멀티노드 분산 통신, KV 캐시 인지형 라우팅, 커널 샌드박싱이 각각 독립된 오퍼레이터로 나뉘어 있다. 이 모듈화 전략은 개별 컴포넌트의 전문성을 높였다. 반면 최종 사용자 관점에서는 심각한 매니페스트 파편화(Manifest Fragmentation)를 초래했다.
1.1 현대 쿠버네티스 AI 추론 스택의 매니페스트 파편화와 설정 드리프트
프로덕션 클러스터에 70B 이상의 LLM 추론 서비스를 하나 올린다고 하자. 플랫폼이 요구하는 표준 리소스 그래프는 다음 6종의 CRD로 구성된다. 아래 목록은 그 여섯 가지가 각각 무엇을 책임지는지 보여준다.
- 하드웨어 토폴로지 할당 (
ResourceClaimTemplate,resource.k8s.io/v1): 쿠버네티스 DRA 드라이버를 호출한다. 동일 NVSwitch 도메인 안의 GPU 4~8장과 RoCE v2 RDMA NIC를 원자적으로 묶어 요청한다1. - 멀티노드 분산 추론 워크로드: 리소스는
LeaderWorkerSet(leaderworkerset.x-k8s.io/v1)다. 텐서 병렬화(TP)와 파이프라인 병렬화(PP)를 수행하는 파드 집합을 단일 라이프사이클로 묶는다. 리더(Leader) 파드와 워커(Worker) 파드가 그 대상이다. gang 스케줄링과 토폴로지 정렬 재시작도 이 리소스가 보장한다7. - KV 캐시 및 큐 깊이 인식 백엔드 풀: 리소스 종류는
InferencePool(inference.networking.x-k8s.io/v1alpha2)다. 엔드포인트 피커(Endpoint Picker, EPP)가 볼 대상 파드 셀렉터와 포트를 정의한다. GAIE의 EPP는 추론 워커들의 실시간 KV 캐시 점유율과 대기열 길이를 수집한다2.
앞의 세 가지는 하드웨어와 워커 파드 쪽을 다룬다. 나머지 세 가지는 트래픽과 보안, 확장을 맡는다.
- L7(애플리케이션 계층) 추론 트래픽 라우팅: 리소스는
InferenceModel과HTTPRoute(gateway.networking.k8s.io/v1)다. 외부에 노출되는 모델 이름(예:deepseek-r1-70b)을InferencePool과 연결한다. 어댑터(LoRA) 버전별 가중치 분할과 테넌트 우선순위(Criticality)도 여기서 정한다. - 커널 수준 런타임 샌드박싱 (
TracingPolicyNamespaced,cilium.io/v1alpha1): 추론 컨테이너 안의 비인가 바이너리 실행(sys_execve)을 감시한다. 사설망 외부로의 무단 소켓 연결(tcp_connect)도 같은 지점에서 잡는다. 두 경우 모두 eBPF 커널 훅에서 즉시 차단(Sigkill)한다3. - 메트릭 기반 오토스케일링 및 가용성 보장: 리소스는
HorizontalPodAutoscaler와PodDisruptionBudget이다. 토큰 생성 지연 시간(TPOT)이나 프리필 큐 깊이에 따라LeaderWorkerSet의 복제본 수를 조절한다. 노드 드레인 시에는 최소 가용 복제본을 방어한다.
클러스터에서 운영하는 모델 서비스의 수를 $M$이라 하자. 서비스당 결합되는 이기종 CRD의 수는 $K$($K \ge 6$)다. 리소스 쌍 사이에 존재하는 평균 이름·레이블·시크릿 참조 간선 수는 $\bar{p}_{\text{ref}}$로 둔다. 수동 YAML 관리 환경에서 전체 상호 참조 간선 수 $E_{\text{total}}$은 다음과 같이 증가한다.
\[E_{\text{total}}(M, K) = M \times \binom{K}{2} \bar{p}_{\text{ref}} = \frac{M \cdot K(K - 1)}{2} \bar{p}_{\text{ref}}\]개별 참조 간선 하나를 사람이 수정할 때 오타나 셀렉터 불일치가 생길 확률을 $\epsilon$($0 < \epsilon \ll 1$)이라 하자. 그러면 릴리스 한 번을 배포했을 때 클러스터 안에서 서비스가 하나 이상 참조 불일치 장애를 겪을 확률 $P_{\text{drift}}$는 다음과 같이 수렴한다.
\[P_{\text{drift}}(M, K) = 1 - (1 - \epsilon)^{E_{\text{total}}(M, K)} \approx 1 - \exp\left(-\frac{\epsilon \cdot \bar{p}_{\text{ref}} \cdot M \cdot K(K - 1)}{2}\right)\]예를 하나 들어 보자. 모델 서비스가 $M = 25$개, CRD가 $K = 6$개, $\bar{p}_{\text{ref}} = 1.6$, 간선당 휴먼 에러율이 $\epsilon = 0.002$(0.2%)인 환경을 가정한다. 이때 $E_{\text{total}} = 600$개에 달한다. 릴리스마다 설정 불일치가 발생할 확률은 $P_{\text{drift}} \approx 1 - (0.998)^{600} \approx 69.9\%$까지 치솟는다.
1.2 Helm 템플릿 엔진의 구조적 한계: 문자열 치환과 단발성 렌더링
플랫폼 팀은 예전부터 이런 다중 리소스 보일러플레이트를 감추려고 헬름(Helm) 차트를 써 왔다. 그러나 Helm의 템플릿 엔진은 Go 템플릿(text/template)에 기반한다. 이 구조는 현대 AI 추론 스택을 추상화할 때 세 가지 한계를 드러낸다. 아래 세 항목이 그 한계다.
- 비타입화 문자열 치환: Helm은 쿠버네티스 리소스의 추상 구문 트리(Abstract Syntax Tree, AST)나 OpenAPI v3 스키마를 이해하지 못한다. 이런 방식을 비타입화 문자열 치환(Untyped Text Interpolation)이라 부른다. 수행하는 일은 공백 들여쓰기(
nindent 4)와 문자열 이어붙이기뿐이다.values.yaml에 정수 대신 문자열을 넣어도 차트 패키징 시점에는 검출되지 않는다. 존재하지 않는 CRD 필드 경로를 적어도 마찬가지다. 실제 클러스터 API 서버에 적용될 때야 실패한다. - 런타임 상태 전파(Status Propagation) 및 순서 제어 부재: Helm은 YAML 텍스트를 한 번 렌더링해 API 서버로 던지는 단발성 렌더러(One-shot Renderer)다. 렌더링은 클라이언트나 GitOps 컨트롤러에서 일어난다. 선행 리소스가 준비된 뒤에야 채워지는 런타임 값을 후행 리소스로 넘길 방법이 없다. 예를 들어
InferencePool이나 클라우드 스토리지가 프로비저닝된 후.status.addresses[0].value에 기록되는 값을 읽는다고 하자. 이 값을 후행LeaderWorkerSet의 환경 변수에 주입하는 일은 Helm 템플릿만으로 불가능하다. - 하위 리소스 드리프트 미감지: 운영 중인 클러스터에서
kubectl edit tracingpolicynamespaced명령으로 eBPF 보안 정책을 임의 수정할 수 있다. Helm은 새 차트 리비전 배포가 트리거되기 전까지 이를 감지하지 못한다. 원래 상태로 되돌리는 상시 조정 루프(Reconciliation Loop)도 갖지 않는다.
핵심 요약 — 단일 AI 추론 서비스를 위해 6개 이상의 CRD를 수동이나 Helm 문자열 템플릿으로 엮는 방식은 참조 간선 수에 비례해 설정 불일치 확률을 높인다. 따라서 정적 타입 검증과 런타임 상태 전파를 지원하는 인클러스터 오케스트레이터가 필수적이다.
2. kro(Kube Resource Orchestrator) 해부: ResourceGraphDefinition과 CEL DAG
서비스 하나를 배포할 때마다 같은 매니페스트를 복사해 이름만 바꾸는 작업을 반복하고 있었다면, 그 복사본을 대신 만들어 줄 상위 API 하나를 원하게 된다. 그 API가 하위 리소스를 어떤 순서로 엮는지가 관건이 된다.
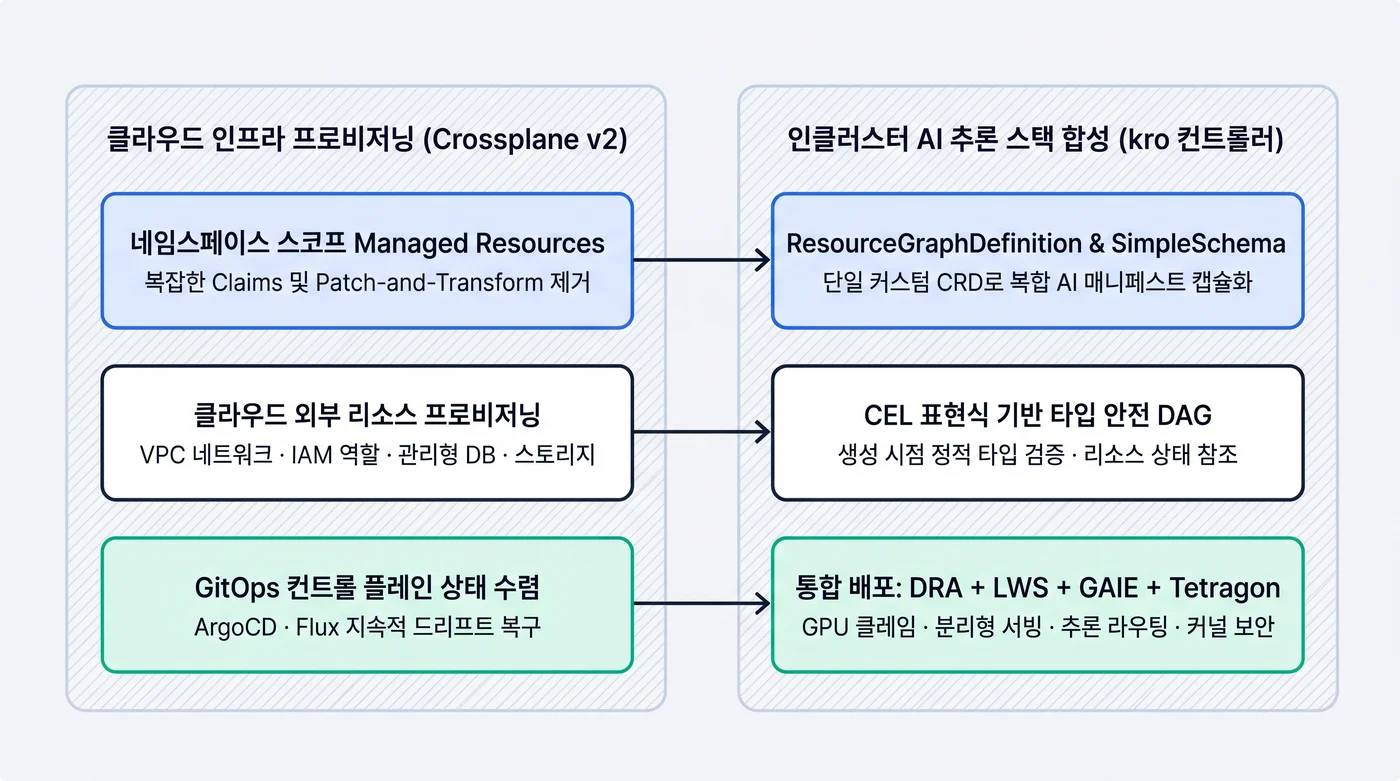
이 절은 클러스터 안의 리소스 여러 개를 하나의 고수준 API로 묶는 방법을 다룬다. 그 문제를 풀기 위해 AWS, Google Cloud, Microsoft Azure가 공동으로 설계한 오픈소스 컨트롤러가 kro(Kube Resource Orchestrator)다5. kro는 클라우드 벤더 종속성 없이 표준 쿠버네티스 API만으로 복수의 리소스를 하나의 고수준 API로 캡슐화한다.
2.1 ResourceGraphDefinition(RGD)과 동적 CRD 합성 메커니즘
kro의 핵심 추상화 단위는 ResourceGraphDefinition(RGD, kro.run/v1alpha1)이라는 단일 CRD다. 플랫폼 엔지니어가 클러스터에 RGD 매니페스트를 선언하면 정해진 파이프라인이 돈다. 그 파이프라인은 다음 4단계다.
- 스키마 컴파일 및 동적 CRD 등록: RGD의
spec.schema에 정의된 간결한 타입 선언(SimpleSchema)을 파싱한다. 이를 표준 쿠버네티스CustomResourceDefinition(apiextensions.k8s.io/v1) OpenAPI v3 스키마로 변환한다. 변환 결과는 API 서버에 즉시 등록된다. - 하위 리소스 스키마 인트로스펙션(Introspection): RGD의
spec.resources배열에 어떤 리소스가 나열돼 있는지 본다. 각 대상 리소스의 스키마를 쿠버네티스 API 서버의 Discovery 엔드포인트에서 조회한다. 대상 리소스로는LeaderWorkerSet,ResourceClaimTemplate,InferencePool등이 있다. 조회 결과로 메모리 상에 타입 심볼 테이블을 구축한다. - 정적 표현식 검증 및 유향 비순환 그래프(DAG) 컴파일: 리소스 간에 작성된 모든 공통 표현식 언어(Common Expression Language, CEL)8 참조식을 파싱한다. 참조 대상 필드의 존재 여부와 출력·입력 타입 일치 여부를 정적으로 검증한다. 이어서 리소스 간 실행 순서 그래프를 생성한다.
- 동적 마이크로 컨트롤러(Dynamic Controller) 기동: 검증이 통과되면 RGD 상태가
Active로 전환된다. 그러면kro프로세스 내부의 동적 인포머(Informer)와 리컨실러 루프가 새로 등록된 커스텀 리소스의 이벤트를 감시한다. 커스텀 리소스의 예로DisaggregatedLLMService가 있다. 생성·수정·삭제 이벤트와 하위 리소스들의 변화를 상시 감시한다.
RGD는 조립 설명서 한 장을 받으면 부품 목록과 조립 순서를 스스로 만들어 내는 작업반장과 같다. 부품이 도착하지 않았으면 다음 공정을 시작하지 않고, 설명서에 없는 부품 이름을 적으면 공정을 시작하기도 전에 반려된다.
2.2 SimpleSchema와 튜링 불완전 CEL(Common Expression Language) 정적 타입 검증
기존 CRD 개발에서는 수백 줄의 OpenAPI v3 JSON Schema를 손으로 작성해야 했다. kro는 대신 SimpleSchema 문법을 채택했다. 덕분에 스키마 정의 분량이 90% 이상 줄어든다5. 필드 선언은 다음처럼 짧다.
modelId: string | required=true description="서빙할 모델 식별자"는 필수 문자열 필드다.gpusPerWorker: integer | default=4 minimum=1 maximum=8는 정수 필드다.enableKernelSandbox: boolean | default=true는 불리언 필드다.
위 세 줄이면 타입과 필수 여부, 기본값, 허용 범위가 모두 표현된다. 더 중요한 결정은 템플릿 언어의 선택이다. kro는 Go 템플릿이나 범용 스크립트 언어를 쓰지 않는다. 대신 튜링 불완전(Turing-incomplete) 언어인 CEL(Common Expression Language)을 채택했다8.
- 정지 문제(Halting Problem) 원천 배제와 선형 시간 복잡도: CEL은 무한 루프(
while), 임의 재귀 호출, 외부 네트워크 I/O를 문법 수준에서 금지한다. 평가가 끝나지 않는 표현식은 애초에 만들어지지 않는다. 표현식의 추상 구문 트리(AST) 노드 수를 $N_{\text{ast}}$, 컬렉션 크기를 $C$라 하자. 그러면 모든 CEL 표현식의 평가 시간 $T_{\text{eval}}$은 엄격한 상한을 갖는다. \(T_{\text{eval}} = \mathcal{O}(N_{\text{ast}} \cdot C)\) 따라서kro컨트롤러가 수천 개의 리소스 인스턴스를 조정하더라도 특정 표현식 평가가 컨트롤 플레인 스레드를 블로킹(Starvation)하지 않는다. - 생성 전(Pre-admission) 정적 타입 체킹: 개발자가 RGD 내부에서
${lwsCluster.status.readyReplicas}를 참조해 정수 연산을 수행한다고 하자. 또는${draTemplate.metadata.name}을 문자열 필드에 대입한다고 하자.kro는 API 서버의 OpenAPI 스키마와 대조한다. 그리고readyReplicas가 실제integer타입인지 RGD 등록 시점에 검증한다. 만약 오타로${lwsCluster.status.readyReplica}(단수형)라고 적으면 어떻게 될까. 인스턴스를 배포하기도 전에 RGD 자체가 거부된다.
2.3 유향 비순환 그래프(DAG) 위상 정렬과 런타임 조정 루프(Reconciliation Loop)
kro에서는 리소스 간의 생성 순서를 dependsOn 같은 수동 배열로 하드코딩할 필요가 없다. 컨트롤러가 CEL 표현식 내부의 심볼 참조를 분석한다. 그리고 유향 비순환 그래프(Directed Acyclic Graph, DAG) $G = (V, E)$를 자동으로 구축한다.
- 의존성 간선 추출 규칙: RGD 내의 리소스 집합을 $V = {r_1, r_2, \dots, r_K}$라 하자. 리소스 $r_j$의 매니페스트 정의 안에는 CEL 표현식 집합 $\Phi(r_j)$가 들어 있다. 이 집합이 리소스 $r_i$의 메타데이터나 상태 필드를 참조한다고 하자($\text{ref}(r_i) \in \Phi(r_j)$). 그러면
kro는 유향 간선 $e_{i \to j} = (r_i, r_j) \in E$를 추가한다. -
순환 참조 검출과 위상 정렬(Topological Sort): 분할에는 칸 알고리즘(Kahn’s Algorithm)을 쓴다. 인디그리(In-degree)가 $\deg^-(r) = 0$인 루트 노드부터 계층 $L_1, L_2, \dots, L_D$로 나눈다. 그래프 안에 순환 경로($r_i \to \dots \to r_i$)가 있으면 방문된 정점 수가 $ V $보다 작다. 이 경우 즉시 CyclicDependencyDetected오류를 반환한다.
위상 정렬된 그래프의 깊이를 $D$라 하자. 계층 $L_d$($d = 1, \dots, D$)에 속한 리소스 $r$마다 API 적용 시간 $t_{\text{apply}}(r)$이 있다. 상태 준비 대기 시간(readyWhen 조건 충족 시간) $t_{\text{ready}}(r)$도 있다. 이때 전체 추론 스택의 프로비저닝 완료 시간 $T_{\text{provision}}(G)$은 다음과 같이 결정된다.
즉, 서로 의존성이 없는 리소스들은 병렬로 생성된다. 예를 들어 $L_1$ 계층의 ResourceClaimTemplate, TracingPolicyNamespaced, InferencePool이 그렇다. 반면 선행 리소스의 출력이나 준비 상태에 의존하는 후행 리소스는 조건이 참이 되는 즉시 프로비저닝된다. 준비 상태는 readyWhen: [${lwsCluster.status.readyReplicas >= 1}] 형태로 적는다. includeWhen 조건식도 같은 그래프 안에서 처리된다. 예를 들어 ${schema.spec.enableKernelSandbox == true}일 때만 해당 리소스를 만든다. 조건부 리소스 생성과 제거까지 단일 그래프 안에서 결정론적으로 끝난다.
핵심 요약 — kro는 SimpleSchema와 튜링 불완전 CEL 표현식을 결합한다. 덕분에 RGD 등록 시점에 정적 타입 안전성을 검증한다. 심볼 참조에서 자동 추론한 DAG 위상 정렬을 통해 인클러스터 리소스들의 생성 순서와 드리프트 복구도 보장한다.
3. Crossplane v2(2025.08+) 아키텍처 개편: 네임스페이스 Managed Resources와 Claims의 폐기
개발팀이 자기 네임스페이스 안에서 클라우드 버킷 하나를 만들려 했는데, 실제로는 성격이 다른 오브젝트 세 개를 순서대로 만들어야 했다. 마지막 단계는 클러스터 전체 권한을 가진 사람만 밟을 수 있었다.
이 절은 클러스터 바깥의 클라우드 자원을 쿠버네티스 API로 다루는 쪽을 정리한다. kro가 클러스터 내부(In-cluster) 리소스 합성에 집중한다면, 바깥은 다른 도구가 맡는다. VPC, S3 버킷, IAM Role, RDS, Azure CosmosDB 같은 클라우드 외부 관리형 인프라를 쿠버네티스 API로 프로비저닝하는 영역이다. 이 영역의 사실상 표준 도구는 CNCF 프로젝트인 크로스플레인(Crossplane)이다6. Crossplane은 이들 자원의 생명주기까지 관리한다.
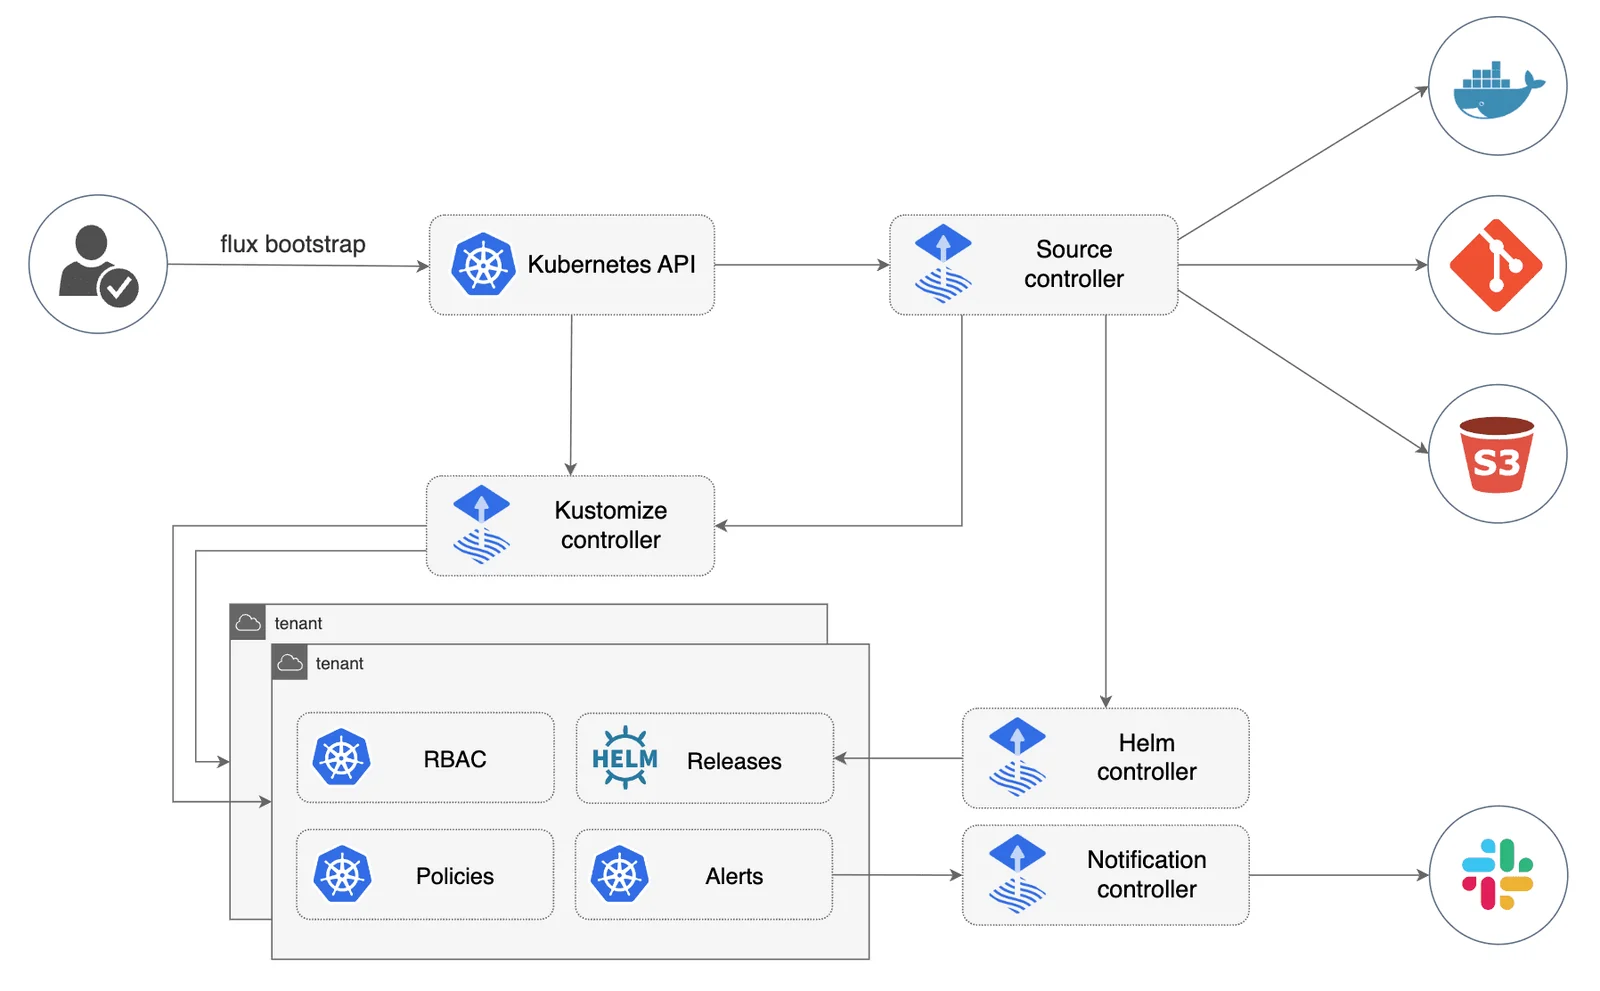 출처: GitOps Toolkit Components — Flux 공식 문서, Apache-2.0 License
위 Flux GitOps Toolkit 아키텍처9는 현대 GitOps 파이프라인의 기본 전제를 보여준다. source-controller가 Git 저장소를 폴링한다. kustomize-controller가 네임스페이스별 매니페스트를 조정한다. 이 구조는 네임스페이스(Namespace) 기반 멀티테넌시를 전제로 동작한다4. 그러나 2025년 이전의 Crossplane v1 아키텍처는 이 네임스페이스 경계 모델과 정면으로 충돌했다. 아래에서 그 구조적 한계를 본다.
3.1 Crossplane v1의 구조적 부채: 클러스터 스코프 MR과 3계층 Claim 보일러플레이트
Crossplane v1에서는 AWS S3 버킷이나 IAM 역할 같은 모든 관리형 리소스(Managed Resource, MR)가 예외 없이 클러스터 스코프(Cluster-scoped)였다. 이 설계는 실제 운영 환경에서 세 가지 엔지니어링 부채를 남겼다. 아래 목록이 그 부채다.
- XR과 Claim(XRC)의 이중 추상화 강제: 애플리케이션 팀에게 특정 네임스페이스(
team-alpha) 권한만 준 상태를 가정하자. 이때 클러스터 스코프인 MR이나 복합 리소스(Composite Resource, XR)를 직접 생성하게 할 수 없었다. 결과적으로 플랫폼 팀이 클러스터 스코프 XR 위에 네임스페이스 스코프 프록시 객체를 얹어야 했다. 클레임(Claim, XRC)이 그 객체다. 그 결과 3계층 구조($\text{Claim} \to \text{XR} \to \text{MR}$)를 모든 추상화마다 강제로 작성하게 됐다. - 네이티브 Patch-and-Transform(P&T)의 가독성 저하: XR의 필드 값을 하위 MR로 복사하려면 경로 규칙을 나열해야 했다.
FromCompositeFieldPath,ToCompositeFieldPath, 정규식 변환이 수백 줄의 YAML 배열로 이어진다. 이것이 네이티브 P&T 방식이다. 조건문 하나나 리스트 반복문을 표현하려 해도 YAML 코드가 기하급수적으로 비대해졌다. - GitOps 동기화와 RBAC 병목: RBAC는 역할 기반 접근 제어(Role-Based Access Control)를 뜻한다. Flux
Kustomization이나 ArgoCDApplication이 네임스페이스 단위로 격리되어 있다고 하자. 그러면 네임스페이스 내부의 Claim이 클러스터 스코프의 XR과 MR을 간접 생성한다. 이 과정에서 소유권 추적 문제가 빈번했다.ownerReferences는 네임스페이스 리소스가 클러스터 스코프 리소스를 소유하는 것을 금지한다. 삭제 순서 문제(Finalizer 교착)도 함께 발생했다.
3.2 Crossplane v2의 3대 핵심 변화: 네임스페이스 MR, Claims 폐기, Composition Functions
2025년 8월 정식 릴리스된 Crossplane v2(apiextensions.crossplane.io/v2)는 v1의 복잡성을 걷어냈다. 그리고 아키텍처를 쿠버네티스 네이티브 멀티테넌시 모델로 전면 재설계했다6. 바뀐 지점은 세 가지다.
- 1. 관리형 리소스의 네임스페이스 스코프 전환: Crossplane v2 MR은 이제 기본으로 네임스페이스 스코프(Namespaced)로 동작한다. AWS, Azure, GCP 프로바이더 모두 같다. 애플리케이션 네임스페이스 안에
Pod,Service와 나란히 S3Bucket이나 IAMRole을 직접 배치할 수 있다. 팀별 클라우드 인프라 접근 통제는 쿠버네티스 표준Role및RoleBinding만으로 완결된다. - 2. Claims(XRC) 계층의 완전 폐기와 네임스페이스 XR: 복합 리소스(XR) 정의 자체가 네임스페이스 스코프를 지원한다.
CompositeResourceDefinition(XRD v2)에서 만드는 XR이scope: Namespaced를 직접 받는다. 이에 따라 v1에서 네임스페이스 노출만을 위해 존재했던 Claims(claimNames) 메커니즘이 폐기(Deprecated & Removed in v2 API)되었다. 복합 인프라 하나를 배포할 때 API 서버(etcd)에 생성되는 객체 수가 줄어든다. $\text{Claim} + \text{XR} + K \cdot \text{MR}$에서 $\text{XR} + K \cdot \text{MR}$로 단축된다. 교차 스코프 참조로 인한 GitOps 상태 추적 불일치도 사라졌다. - 3. Composition Functions 도입: v2의
Composition에서는 레거시 YAML 패치 배열(resources[].patches)이 제거됐다. 네이티브 Patch-and-Transform 방식도 사라졌다. 모든 합성 로직이mode: Pipeline기반의 컴포지션 함수(Composition Functions)로 일원화되었다10. 플랫폼 엔지니어는 여러 언어로 작성된 gRPC 함수를 파이프라인 단계로 연결한다. Go 템플릿(function-go-templating), KCL(function-kcl), CEL(function-cel-filter), 또는 범용 Python·Go 컨테이너가 그 재료다. 이렇게 외부 클라우드 리소스들을 프로그래밍 방식으로 조합한다.
이전 구조는 건물마다 관리실을 거쳐야만 택배를 보낼 수 있던 것과 같다. 관리실이 사라지고 세대 앞에 우편함이 놓이면, 보내는 사람은 자기 앞에서 한 번만 접수하면 된다.
3.3 클라우드 외부 리소스 프로비저닝을 위한 Crossplane v2 XRD & Composition 예시
AI 추론 워크로드는 모델 가중치(Safetensors)와 LoRA 어댑터를 로드해야 한다. 그러려면 외부 클라우드 인프라가 필요하다. AWS S3 전용 버킷, KMS 암호화 키, EKS Pod Identity IAM Role이 그 예다. 아래는 이를 프로비저닝하는 Crossplane v2 매니페스트 예시다.
apiVersion: apiextensions.crossplane.io/v2
kind: CompositeResourceDefinition
metadata:
  name: xaimodelstorages.platform.ingu627.dev
spec:
  # Crossplane v2: Claim 없이 XR 자체를 네임스페이스 스코프로 직접 선언
  scope: Namespaced
  group: platform.ingu627.dev
  names:
    kind: XAIModelStorage
    plural: xaimodelstorages
  versions:
    - name: v1alpha1
      served: true
      referenceable: true
      schema:
        openAPIV3Schema:
          type: object
          properties:
            spec:
              type: object
              required: [region, modelBucketPrefix, serviceAccountName]
              properties:
                region:
                  type: string
                  default: ap-northeast-2
                modelBucketPrefix:
                  type: string
                serviceAccountName:
                  type: string
            status:
              type: object
              properties:
                bucketArn:
                  type: string
                iamRoleArn:
                  type: string
---
apiVersion: apiextensions.crossplane.io/v2
kind: Composition
metadata:
  name: xaimodelstorage-aws-v2
spec:
  compositeTypeRef:
    apiVersion: platform.ingu627.dev/v1alpha1
    kind: XAIModelStorage
  mode: Pipeline
  pipeline:
    - step: render-aws-storage-and-irsa
      functionRef:
        name: function-go-templating
      input:
        apiVersion: gotemplating.fn.crossplane.io/v1beta1
        kind: GoTemplate
        source: Inline
        inline:
          template: |
            apiVersion: s3.aws.m.upbound.io/v1beta1
            kind: Bucket
            metadata:
              name: {{ .observed.composite.resource.metadata.name }}-weights
              namespace: {{ .observed.composite.resource.metadata.namespace }}
              annotations:
                gotemplating.fn.crossplane.io/composition-resource-name: model-bucket
            spec:
              forProvider:
                region: {{ .observed.composite.resource.spec.region }}
            ---
            apiVersion: v1
            kind: Secret
            metadata:
              name: {{ .observed.composite.resource.metadata.name }}-cloud-env
              namespace: {{ .observed.composite.resource.metadata.namespace }}
              annotations:
                gotemplating.fn.crossplane.io/composition-resource-name: cloud-env-secret
            stringData:
              MODEL_S3_BUCKET_ARN: {{ dig "resources" "model-bucket" "resource" "status" "atProvider" "arn" "" .observed | quote }}
    - step: auto-detect-readiness
      functionRef:
        name: function-auto-ready
위 예시에서 주목할 점은 API 그룹 선택이다. s3.aws.m.upbound.io/v1beta1를 쓴다. 이 그룹은 Crossplane v2의 네임스페이스 스코프 Managed Resource 그룹 규칙인 *.m.upbound.io를 따른다. 덕분에 S3 Bucket과 출력 Secret이 동일한 애플리케이션 네임스페이스 안에 생성된다. 별도의 Claim 없이 XAIModelStorage 자체가 네임스페이스 리소스로 동작한다.
핵심 요약 — Crossplane v2는 관리형 리소스(MR)와 복합 리소스(XR)를 네임스페이스 스코프로 전환했다. 불필요한 Claims 계층과 레거시 패치 문법도 제거했다. 덕분에 클라우드 외부 인프라를 GitOps 멀티테넌시 경계에 맞춰 프로비저닝한다.
4. 아키텍처 비교와 역할 분담: kro vs Crossplane v2 vs Helm
이 절은 앞의 두 도구와 Helm을 나란히 놓고 어디에 무엇을 쓸지 정리한다. 클라우드 네이티브 플랫폼을 설계할 때 흔히 범하는 오류가 있다. 하나의 도구로 모든 계층의 문제를 해결하려는 것이다. Crossplane으로 인클러스터 파드와 서비스까지 전부 감싸면 유지보수 비용이 급증한다. 반대로 Helm 차트 하나에 Terraform 역할까지 우겨넣어도 결과는 같다.
택배 회사가 장거리 간선 운송과 집 앞 배송을 나눠 맡는 것과 같다. 한 회사가 둘 다 떠안으면 트럭도 창고도 각각 따로 준비해야 하고, 한쪽이 밀릴 때 다른 쪽까지 같이 늦어진다.
4.1 3대 쿠버네티스 추상화 도구 정량·정성 비교 매트릭스
| 비교 항목 | Helm (v3 / v4) | kro (kro.run/v1alpha1) |
Crossplane v2 (apiextensions.crossplane.io/v2) |
|---|---|---|---|
| 주 추상화 타깃 | 정적 매니페스트 패키징 및 릴리스 배포 | 인클러스터(In-cluster) K8s 네이티브 리소스 및 오퍼레이터 CRD 합성 | 클라우드 외부(External Cloud) 인프라(AWS, Azure, GCP) 프로비저닝 및 멀티클라우드 추상화 |
| 스키마 정의 방식 | values.yaml + 선택적 values.schema.json (강제성 낮음) |
SimpleSchema (선언 즉시 OpenAPI v3 CRD로 자동 컴파일) |
표준 OpenAPI v3 Schema (CompositeResourceDefinition) |
| 템플릿 및 합성 엔진 | Go text/template (비타입화 문자열 치환) |
CEL(Common Expression Language) 인라인 표현식 (${...}) |
Composition Functions gRPC 파이프라인 (Go, KCL, Python, CEL) |
| 의존성 그래프(DAG) 추론 | 미지원 (훅 가중치 helm.sh/hook-weight 수동 지정) |
자동 추론 (CEL 심볼 참조 분석 후 Kahn 위상 정렬 수행) | 함수 파이프라인 내부에서 순차/조건부 준비 상태(Readiness) 제어 |
| 정적 타입 안전성 검증 | 미지원 (렌더링 후 API 서버 적용 시점에 오류 발견) | RGD 등록 시점 정적 검증 (대상 CRD OpenAPI 스키마와 대조) | XRD 스키마 검증 지원 (단, 함수 컨테이너 내부 로직은 런타임 검증) |
| 런타임 드리프트 자가 치유 | 미지원 (수동 helm upgrade 전까지 하위 리소스 변경 방치) |
상시 지원 (인포머가 하위 리소스 변경 감지 시 수 초 내 원복) | 상시 지원 (클라우드 API 주기적 폴링 및 인클러스터 상태 수렴) |
| 컨트롤 플레인 메모리 부하 | 낮음 (릴리스당 Secret 1개 저장, 상주 컨트롤러 없음) | 매우 낮음 (단일 바이너리, RGD당CRD 1개 등록, 외부 파드 불필요) | 높음 (클라우드 프로바이더 CRD 수백 개 등록 및 함수 파드 상주) |
4.2 API 서버(etcd) 부하 수식 모델링과 플랫폼 엔지니어링 역할 분담 패턴
그렇다면 인클러스터 AI 추론 스택 합성에는 왜 Crossplane 대신 kro를 쓰고, 클라우드 외부 리소스에는 왜 Crossplane v2를 쓸까. 이 선택은 쿠버네티스 API 서버(kube-apiserver)의 메모리와 워치(Watch) 오버헤드 수식으로 설명된다.
클러스터에 등록된 전체 CRD 개수를 $N_{\text{CRD}}$라 하자. CRD 1개당 API 서버가 OpenAPI v3 검증기와 디스커버리 캐시를 유지하는 데 쓰는 평균 힙 메모리를 $m_{\text{schema}}$(실측 약 $1.8 \sim 3.5\text{ MB}$)로 둔다. $k$번째 CRD의 활성 객체 수는 $N_{\text{obj}, k}$다.
객체당 평균 직렬화 크기는 $s_{\text{obj}, k}$다. 해당 리소스를 감시하는 컨트롤러 인포머(Watch) 배수는 $W_{\text{informer}, k}$다. 이때 API 서버의 CRD 관련 메모리 점유량 $M_{\text{apiserver}}$는 다음과 같이 근사된다.
\[M_{\text{apiserver}} = N_{\text{CRD}} \cdot m_{\text{schema}} + \sum_{k=1}^{N_{\text{CRD}}} N_{\text{obj}, k} \cdot s_{\text{obj}, k} \cdot \left(1 + W_{\text{informer}, k}\right)\]- 클라우드 외부 계층(Crossplane v2): AWS나 Azure의 외부 API를 제어하려면 패밀리 프로바이더를 설치해야 한다.
provider-upjet-aws-s3,provider-upjet-aws-iam등이 그 예다. gRPCComposition Function러너 파드도 띄워야 한다. 이 비용은 외부 클라우드 API와 쿠버네티스 상태 머신을 동기화하는 데 필요하다. 앞서 다룬 2026 엔터프라이즈 에이전트 호스팅 & AI FinOps 아키텍처11의 클라우드 스토리지·네트워크·권한 경계를 코드로 관리할 때도 이 계층이 핵심 역할을 한다. - 인클러스터 AI 스택 계층(
kro): 이미 클러스터 내부에 설치된 리소스를 묶는 작업에는 외부 클라우드 API 호출이 전혀 없다. 대상은LeaderWorkerSet,ResourceClaimTemplate,InferencePool,TracingPolicyNamespaced다. 그래서 gRPC 함수 러너 파드를 거칠 네트워크 홉도 필요 없다.kro의 단일 프로세스 메모리 안에서 CEL AST 평가($< 2\text{ ms}$)와 자동 DAG 위상 정렬로 처리하면 된다. 이렇게 하면 컨트롤 플레인 지연 시간과 메모리 오버헤드가 최소화된다.
그래서 가장 실용적인 역할 분담은 플랫폼 엔지니어링 2계층 추상화 패턴(Two-Tier Abstraction Pattern)으로 정리된다. 아래 두 계층이 그것이다.
- Outer Infrastructure Loop(Crossplane v2 담당):
XAIModelStorageXR로 외부 저장소를 만든다. S3/Blob 모델 저장소, KMS 암호화 키, IAM 워크로드 아이덴티티가 대상이다. 연결 메타데이터(버킷 ARN, 리전, 엔드포인트)는 해당 네임스페이스의Secret(*-cloud-env)으로 출력한다. - Inner AI Stack Loop(
kroResourceGraphDefinition담당): Crossplane v2가 생성한Secret이름을 입력 파라미터로 받는다. 합성 대상은 DRA GPU 클레임 템플릿, LWS(LeaderWorkerSet) 분산 추론 파드, GAIE 추론 풀 및 라우트, Tetragon eBPF 샌드박스, HPA다. 이들을 단일DisaggregatedLLMServiceCRD로 합성한다.
핵심 요약 — 클라우드 외부 리소스(S3·IAM·RDS)는 네임스페이스 MR과 함수 파이프라인을 갖춘 Crossplane v2로 프로비저닝한다. 연결 정보는 Secret으로 넘긴다. 인클러스터 6종 AI CRD 조합은 CEL DAG 기반의 kro로 추상화한다. 이 2계층 분담이 컨트롤 플레인 효율을 극대화한다.
5. 실전 매니페스트와 TypeSafe Jev 기반 플랫폼 PR 정책 검증
PR 하나를 올렸는데 리뷰어가 GPU 수량과 보안 예외 사유를 사람 눈으로 따져 보는 동안 머지가 계속 밀렸다면, 그 판단을 배포 전 게이트로 옮길 수 있는지가 문제가 된다. 그 판단 기준을 코드로 고정해 두면 리뷰 품질이 리뷰어의 기억에 좌우되지 않는다.
이 절은 앞서 설계한 2계층 아키텍처를 배포 가능한 코드로 옮긴다. 먼저 6개의 인클러스터 AI CRD를 하나로 묶는 kro ResourceGraphDefinition을 작성한다. 이어서 개발자가 GitOps 저장소에 제출한 커스텀 리소스 PR을 검증하는 파이프라인을 붙인다. PR의 아키텍처·보안·비용 정합성을 TypeSafe System One(Jev)12으로 스냅 판정하는 파이프라인이다.
5.1 DRA + LWS + GAIE + Tetragon을 하나로 묶는 kro ResourceGraphDefinition 명세
아래 매니페스트는 플랫폼 팀이 클러스터에 단 한 번 등록하는 ResourceGraphDefinition이다. 이 RGD가 등록되면 애플리케이션 팀의 일이 줄어든다. 단 15줄짜리 DisaggregatedLLMService 리소스 하나만 작성하면 된다. 그러면 전체 추론 스택이 배포된다.
apiVersion: kro.run/v1alpha1
kind: ResourceGraphDefinition
metadata:
  name: disaggregated-llm-service.ai.ingu627.dev
spec:
  schema:
    apiVersion: v1alpha1
    group: ai.ingu627.dev
    kind: DisaggregatedLLMService
    spec:
      modelName: string | required=true description="외부 라우팅 및 GAIE에 등록할 모델 식별자"
      image: string | default="vllm/vllm-openai:v0.31.0"
      workerGroupReplicas: integer | default=2 minimum=1 maximum=16
      nodesPerGroup: integer | default=2 minimum=1 maximum=8
      gpusPerNode: integer | default=8 minimum=1 maximum=8
      cloudEnvSecretName: string | required=true description="Crossplane v2가 생성한 클라우드 환경 Secret 이름"
      enableKernelSandbox: boolean | default=true description="Tetragon eBPF 런타임 커널 격리 활성화 여부"
      maxScaleReplicas: integer | default=6 minimum=1 maximum=32
    status:
      readyWorkerGroups: ${lwsCluster.status.readyReplicas}
      inferencePoolName: ${gaiePool.metadata.name}
  resources:
    # 1. [Layer 1] 쿠버네티스 DRA GPU 및 RDMA NIC 토폴로지 클레임 템플릿
    - id: draGpuTemplate
      template:
        apiVersion: resource.k8s.io/v1
        kind: ResourceClaimTemplate
        metadata:
          name: ${schema.metadata.name}-gpu-claim
          namespace: ${schema.metadata.namespace}
        spec:
          spec:
            devices:
              requests:
                - name: h100-rdma-slice
                  deviceClassName: gpu.nvidia.com
                  count: ${schema.spec.gpusPerNode}

    # 2. [Layer 2] 멀티노드 분산 추론 워크로드 (draGpuTemplate 참조 -> 자동 DAG 간선 생성)
    - id: lwsCluster
      readyWhen:
        - ${lwsCluster.status.readyReplicas >= 1}
      template:
        apiVersion: leaderworkerset.x-k8s.io/v1
        kind: LeaderWorkerSet
        metadata:
          name: ${schema.metadata.name}-lws
          namespace: ${schema.metadata.namespace}
        spec:
          replicas: ${schema.spec.workerGroupReplicas}
          leaderWorkerTemplate:
            size: ${schema.spec.nodesPerGroup}
            workerTemplate:
              metadata:
                labels:
                  app.kubernetes.io/name: ${schema.metadata.name}
                  ai.ingu627.dev/role: inference-worker
              spec:
                envFrom:
                  - secretRef:
                      name: ${schema.spec.cloudEnvSecretName}
                containers:
                  - name: vllm-worker
                    image: ${schema.spec.image}
                    ports:
                      - containerPort: 8000
                        name: http-infer
                    resources:
                      claims:
                        - name: gpu-topology
                resourceClaims:
                  - name: gpu-topology
                    resourceClaimTemplateName: ${draGpuTemplate.metadata.name}

    # 3. [Layer 3] GAIE InferencePool (lwsCluster 준비 완료 후 활성화)
    - id: gaiePool
      template:
        apiVersion: inference.networking.x-k8s.io/v1alpha2
        kind: InferencePool
        metadata:
          name: ${schema.metadata.name}-pool
          namespace: ${schema.metadata.namespace}
        spec:
          targetPortNumber: 8000
          selector:
            app.kubernetes.io/name: ${lwsCluster.metadata.name}
          extensionRef:
            name: ${schema.metadata.name}-epp

    # 4. [Layer 4] Gateway API HTTPRoute (gaiePool 참조)
    - id: gaieRoute
      template:
        apiVersion: gateway.networking.k8s.io/v1
        kind: HTTPRoute
        metadata:
          name: ${schema.metadata.name}-route
          namespace: ${schema.metadata.namespace}
        spec:
          parentRefs:
            - name: internal-ai-gateway
              namespace: ai-gateway-system
          rules:
            - backendRefs:
                - group: inference.networking.x-k8s.io
                  kind: InferencePool
                  name: ${gaiePool.metadata.name}
                  port: 8000

    # 5. [Layer 1 Conditional] Cilium Tetragon eBPF 커널 샌드박스 정책 (조건부 활성화)
    - id: tetragonPolicy
      includeWhen:
        - ${schema.spec.enableKernelSandbox == true}
      template:
        apiVersion: cilium.io/v1alpha1
        kind: TracingPolicyNamespaced
        metadata:
          name: ${schema.metadata.name}-sandbox
          namespace: ${schema.metadata.namespace}
        spec:
          podSelector:
            matchLabels:
              app.kubernetes.io/name: ${schema.metadata.name}
          kprobes:
            - call: "sys_execve"
              syscall: true
              selectors:
                - matchBinaries:
                    - operator: "NotIn"
                      values: ["/usr/bin/python3", "/vllm-workspace/entrypoint.sh"]
                  matchActions:
                    - action: Sigkill

    # 6. [Layer 3] 수평 파드 오토스케일러 (lwsCluster 참조)
    - id: lwsHpa
      template:
        apiVersion: autoscaling/v2
        kind: HorizontalPodAutoscaler
        metadata:
          name: ${schema.metadata.name}-hpa
          namespace: ${schema.metadata.namespace}
        spec:
          scaleTargetRef:
            apiVersion: leaderworkerset.x-k8s.io/v1
            kind: LeaderWorkerSet
            name: ${lwsCluster.metadata.name}
          minReplicas: ${schema.spec.workerGroupReplicas}
          maxReplicas: ${schema.spec.maxScaleReplicas}
          metrics:
            - type: Pods
              pods:
                metric:
                  name: vllm:num_requests_waiting
                target:
                  type: AverageValue
                  averageValue: "15"
위 RGD에서 kro는 표현식 참조를 스캔한다. 그리고 다음과 같은 3단계 위상 정렬 계층을 자동으로 도출한다.
- $L_1 = {\text{draGpuTemplate}, \text{tetragonPolicy}}$: 외부 리소스 참조가 없어 즉시 병렬 생성된다.
- $L_2 = {\text{lwsCluster}}$:
draGpuTemplate.metadata.name에 의존하며 파드 Ready를 기다린다. - $L_3 = {\text{gaiePool}, \text{lwsHpa}} \to L_4 = {\text{gaieRoute}}$:
lwsCluster준비 완료 후 순차 프로비저닝된다.
5.2 GitOps PR 단계의 시맨틱 정책 검증: CEL 정적 검사와 TypeSafe System One(Jev) 결합
kro의 CEL 검증기와 쿠버네티스 ValidatingAdmissionPolicy는 수치 제약을 결정론적으로 걸러낸다. gpusPerNode <= 8 같은 구문론적(Syntactic)·수치적 제약이 그 예다. 그러나 GitOps Pull Request(PR) 단계에서는 다른 검증이 필요하다. 수치 규칙만으로 판단할 수 없는 의미론적(Semantic) 맥락 검증이다. 아래 두 사례가 그런 검증을 요구한다.
- 개발자가 8B 소형 양자화 모델(
llama-3.1-8b-instruct-fp8)을 배포한다고 하자.nodesPerGroup: 4,gpusPerNode: 8(그룹당 H100 32장)을 요청했다. PR 본문에는 “단순 사내 FAQ 챗봇 테스트용”이라고 적혀 있다. 구문상으로는 유효하지만 GPU는 크게 과할당된 경우다. - 개발자가
enableKernelSandbox: false로 Tetragon eBPF 샌드박스를 해제한다고 하자. PR 사유란에는 구체적인 커널 프로파일링 티켓 번호가 없다. “속도 개선 목적”이라고만 적혀 있다.
이런 PR 컨텍스트를 거대 생성형 LLM의 사고 연쇄(Chain-of-Thought, CoT)로 심사한다고 하자. 그러면 건당 4~8초의 지연이 생긴다. 비결정론적 JSON 파싱 오류도 함께 발생한다. 반면 TypeSafe System One(Jev)의 /v1/systemone 엔드포인트는 다르다. 단일 포워드 패스(Single-pass) 토큰 확률 분포 평가만 수행한다. 그 결과 70~150ms 내에 세 가지 원자적 질문을 병렬 판정(Speculative Fan-Out)한다12.
사고 연쇄 심사는 지원자에게 자기소개를 길게 시키고 그 답변을 다시 읽어 채점하는 면접에 가깝다. 단일 패스 평가는 신분증 사진과 얼굴을 한 번 대조하고 끝내는 검문에 가깝다.
1) HTTP 엔드포인트(/v1/systemone) 요청 페이로드 구조
{
  "state": {
    "pr_author_team": "customer-support-bot-team",
    "pr_description": "사내 복지 규정 FAQ 챗봇 베타 테스트 배포입니다. 빠른 배포를 위해 커널 샌드박스는 잠시 껐습니다.",
    "requested_cr_spec": {
      "kind": "DisaggregatedLLMService",
      "modelName": "meta-llama/Llama-3.1-8B-Instruct-FP8",
      "workerGroupReplicas": 2,
      "nodesPerGroup": 4,
      "gpusPerNode": 8,
      "enableKernelSandbox": false,
      "maxScaleReplicas": 8
    },
    "namespace_finops_budget": {
      "monthly_gpu_hour_limit": 1200,
      "estimated_monthly_gpu_hours_requested": 46080
    }
  },
  "questions": {
    "sizing_alignment": {
      "type": "choice",
      "instructions": "요청된 모델 파라미터 규모와 할당된 멀티노드 GPU 토폴로지(nodesPerGroup * gpusPerNode) 간의 정합성을 판정하시오."
    },
    "sandbox_exemption_validity": {
      "type": "score",
      "instructions": "enableKernelSandbox가 false일 때 PR 설명에 기재된 보안 예외 사유의 타당성을 평가하시오."
    },
    "block_gitops_merge": {
      "type": "noul",
      "instructions": "해당 PR이 하드웨어 과할당, FinOps 예산 초과, 또는 무인가 보안 샌드박스 해제를 포함하여 자동 병합을 차단해야 하는가?"
    }
  }
}
5.3 Python SDK 루브릭 선언 및 결정론적 GitOps 게이트 쿡북
typesafe-house-style의 5대 원칙을 따른다. 모든 PR 메타데이터와 YAML 스펙은 state에만 격리한다. questions에는 구체적 상황으로 기술된 판단 규칙만 선언한다.
from typesafe import SystemOne, Choice, Score, Noul
from dataclasses import dataclass
from typing import Dict, Any

client = SystemOne()

# GitOps PR 시맨틱 거버넌스를 위한 TypeSafe System One 루브릭
KRO_GITOPS_PR_RUBRIC = {
    "sizing_alignment": Choice(
        instructions="요청된 모델 아키텍처(파라미터 크기/정밀도)와 단일 워커 그룹당 GPU 수(nodesPerGroup * gpusPerNode)의 물리적 정합성을 분류하시오.",
        criteria={
            "right_sized": "모델 가중치 및 KV 캐시 요구량에 부합하는 GPU 수량이 할당된 상태 (예: 8B~14B 모델에 1~2 GPU, 70B 모델에 4~8 GPU, 405B+ MoE 모델에 멀티노드 16+ GPU).",
            "over_provisioned": "소형/중형 모델(30B 이하)에 멀티노드(nodesPerGroup >= 2) 또는 8장 이상의 H100 GPU가 과다 할당된 상태.",
            "under_provisioned": "초거대 모델(70B FP16 또는 405B+)에 단일 GPU만 할당되어 런타임 OOM(Out-Of-Memory) 발생이 확실시되는 상태."
        }
    ),
    "sandbox_exemption_validity": Score(
        instructions="enableKernelSandbox 설정과 PR 본문의 보안 예외 승인 근거를 평가하시오.",
        criteria={
            0: "enableKernelSandbox가 false로 비활성화되었으나, 보안팀 승인 티켓 번호(SEC-*)나 구체적인 커널 디버깅 사유가 누락된 상태.",
            1: "enableKernelSandbox가 false이나, PR 본문에 제한된 스테이징 환경 명시와 유효한 보안 예외 티켓 번호(SEC-*)가 함께 기재된 상태.",
            2: "enableKernelSandbox가 true로 설정되어 Tetragon eBPF 커널 샌드박스가 정상 활성화된 상태."
        }
    ),
    "block_gitops_merge": Noul(
        instructions="예상 월간 GPU 시간이 팀 예산 한도를 초과하거나, 모델 대비 GPU 과할당 또는 미승인 샌드박스 해제가 존재하여 PR 병합을 즉시 차단해야 하는가?"
    )
}

@dataclass
class GitOpsGateDecision:
    allowed: bool
    reason: str
    assigned_reviewers: list[str]

def evaluate_disaggregated_llm_pr(pr_state: Dict[str, Any]) -> GitOpsGateDecision:
    # 단일 패스 비생성형 평가 (평균 지연 95ms, 스키마 에러율 0%)
    res = client.evaluate(state=pr_state, questions=KRO_GITOPS_PR_RUBRIC)

    # 1. 보안 가드레일: Tetragon 샌드박스 무단 해제 시 즉시 차단 및 보안팀 호출
    if res.sandbox_exemption_validity.score == 0:
        return GitOpsGateDecision(
            allowed=False,
            reason="Tetragon eBPF 커널 샌드박스(enableKernelSandbox=false) 해제에는 SEC-* 승인 티켓이 필수입니다.",
            assigned_reviewers=["security-platform-oncall"]
        )

    # 2. 토폴로지 과할당/과소할당 및 FinOps 예산 초과 차단 (홀드아웃 보정 임계값 0.82 적용)
    if res.block_gitops_merge.prob >= 0.82 or res.sizing_alignment.choice != "right_sized":
        return GitOpsGateDecision(
            allowed=False,
            reason=f"토폴로지 정합성 위배({res.sizing_alignment.choice}) 또는 FinOps GPU 시간 예산 초과가 감지되었습니다.",
            assigned_reviewers=["ai-infra-capacity-team"]
        )

    # 3. 정합성 통과 시 Flux/ArgoCD 자동 동기화 승인
    return GitOpsGateDecision(
        allowed=True,
        reason="구문(CEL) 및 시맨틱(Jev) 정책 검증을 모두 통과했습니다.",
        assigned_reviewers=[]
    )
핵심 요약 — kro의 ResourceGraphDefinition으로 6종 CRD를 단일 선언형 API로 압축한다. GitOps PR 단계에서는 CEL 구문 검증과 TypeSafe System One(Jev)의 100ms급 시맨틱 스냅 판정을 결합한다. 그러면 하드웨어 과할당과 보안 정책 우회를 배포 전에 차단할 수 있다.
6. 엔지니어링 한계와 트레이드오프
kro로 만든 리소스를 클러스터에 올린 뒤 팀에서 LoRA 어댑터를 2개에서 5개로 늘려 달라고 요청했다. RGD의 스키마 배열 길이만 바꿨는데도 하위 ConfigMap은 여전히 2개만 생성됐다. 이것이 CEL의 표현력 한계가 운영에서 드러나는 첫 장면이다.
이 절은 지금까지의 구성을 프로덕션에 넣을 때 남는 한계를 정리한다. kro와 Crossplane v2, 그리고 Jev 기반 PR 게이트에는 다섯 가지 운영상 트레이드오프가 있다. 설계 단계에서 미리 반영해야 한다. 앞의 세 가지는 도구 자체의 구조에서 오고, 뒤의 두 가지는 검증 계층 운영에서 생긴다.
- kro API 성숙도(
v1alpha1)와 튜링 불완전 CEL의 반복문 표현 제약:kro는 2025~2026년 기준kro.run/v1alpha1단계로 발전 중이다. CEL이 튜링 불완전하기 때문에 동적 팬아웃(Dynamic Resource Fan-out)에 제약이 따른다. 입력 배열(loraAdapters: [...])의 원소 수만큼 서로 다른 하위ConfigMap이나HTTPRoute를 N개 복제 생성하는 일이 그 예다. 입력 배열 길이에 따라 리소스 개수 자체가 변해야 하는 변환이 있다. 그런 변환은 Crossplane v2의function-kcl또는function-go-templating파이프라인으로 처리하는 편이 적합하다. - 동적 생성 CRD의 RBAC 권한 집중과 ArgoCD/Flux 상태 추적 충돌:
kro컨트롤러가 RGD로부터 새 CRD를 등록한다고 하자. 그리고LeaderWorkerSet이나TracingPolicyNamespaced를 대신 생성·수정한다고 하자. 그러려면kro의 ServiceAccount에 해당 하위 리소스들에 대한 광범위한 클러스터 권한(ClusterRole)이 필요하다. 최소 권한 원칙을 지키려면 RGD로 허용할 리소스 그룹만 명시적으로 묶은 Aggregated ClusterRole을 구성해야 한다. ArgoCD를 쓸 때는 문제가 하나 더 있다.kro가 동적으로 생성한 하위 리소스들은 부모 인스턴스를 가리키는ownerReferences를 갖는다. ArgoCDApplication에서ServerSideApply=true와 리소스 무시 규칙을 제대로 설정하지 않으면 동기화 플래핑(Sync Flapping)이 생긴다. 하위 리소스의 런타임 필드 갱신을 두고 ArgoCD와kro리컨실러가 서로 덮어쓰는 현상이다. - 대규모 MR 운영 시 API 서버와 클라우드 Rate Limit 부하: Crossplane v2가 Claims 계층을 제거해 객체 수를 줄였어도 본질은 같다. 수천 개의 클라우드 리소스를 단일 쿠버네티스 관리 클러스터의 etcd에 저장한다. 그리고 주기적으로 클라우드 API(
Describe*,Get*)를 폴링한다. 관리 대상 MR이 5,000개를 넘어가는 환경이라면 모놀리식 프로바이더 대신 필요한 서비스만 분리된 패밀리 프로바이더(provider-upjet-aws-s3등)를 설치한다. 컨트롤러의--max-reconcile-rate및--poll-interval파라미터도 보수적으로 튜닝한다. 그래야 AWS/Azure API 스로틀링(ThrottlingException)과 API 서버 OOM을 예방할 수 있다.
아래 두 항목은 앞의 셋과 성격이 다르다. 판정과 검증 계층을 어떻게 운영할지에 대한 조건이다.
- Jev 판정 임계값의 홀드아웃 데이터셋 보정 필수성: 5.2절의 GitOps PR 게이트 코드에서 쓴 확률 임계값(
prob >= 0.82)은 임의로 하드코딩하면 안 된다. 사내에서 실제로 발생했던 과거 PR 반려 이력이 필요하다. OOM 장애를 유발한 매니페스트와 정상 승인 PR도 모아야 한다. 이렇게 모은 독립 홀드아웃 검증셋(Held-out Validation Set)으로 정밀도(Precision)와 재현율(Recall) 곡선을 측정한다. 그 뒤 도메인에 맞게 임계값을 보정해야 한다. - 타입 안전성과 무오류성은 다르다: 타입 안전성(Type Safety)이 무오류성(Infallibility)을 뜻하지는 않는다.
kro의 CEL 정적 타입 검사와Jev의 스키마 보장 응답(파싱 에러율 0%)은 인터페이스 계약의 안전성만 보장한다. 모델의 시맨틱 판정이 항상 참이라는 뜻도 아니다. 런타임 장애가 발생하지 않는다는 뜻도 아니다. PR 설명란에 적대적 프롬프트 주입(Adversarial Steering)을 시도해Jev의 점수를 우회하려 할 수도 있다. 따라서 심층 방어(Defense-in-Depth)가 필요하다.enableKernelSandbox: false금지나 GPU 상한선 같은 핵심 불변식(Invariant)은 쿠버네티스 네이티브 수단으로 이중 강제해야 한다. 강제 수단은ValidatingAdmissionPolicy(CEL)와ResourceQuota다.
건물의 잠금장치가 규격대로 설치됐다는 검사 성적서는 그 문을 아무도 열 수 없다는 뜻이 아니다. 성적서는 자물쇠가 계약대로 달렸다는 것만 보증하고, 열쇠를 가진 사람이 문을 열지 않는다는 것까지 보증하지는 않는다.
핵심 요약 — kro의 CEL 반복문 제약, 동적 CRD의 RBAC·GitOps 트래킹 설정, Crossplane v2의 etcd 워치 부하는 사전에 설계에 반영해야 한다. Jev 시맨틱 판정은 홀드아웃 임계값 보정과 쿠버네티스 네이티브 Admission Policy, 다층 방어로 결합해야 한다.
References
-
ingu627.github.io: 쿠버네티스 DRA(Dynamic Resource Allocation) 기반 차세대 GPU 스케줄링 아키텍처 (2026). /k8s/kubernetes-dra-dynamic-resource-allocation-gpu/ ↩ ↩2
-
ingu627.github.io: 엔터프라이즈 AI 플랫폼 설계: 분리형 서빙(Disaggregated Serving), KV 캐시 오프로딩, Gateway API Inference Extension(GAIE) (2026). /llm/enterprise-ai-platform-disaggregated-serving-kvcache-gaie/ ↩ ↩2
-
ingu627.github.io: eBPF 기반 AI 런타임 보안(Cilium Tetragon)과 OpenTelemetry GenAI 에이전트 궤적 평가 아키텍처 (2026). /k8s/ebpf-ai-observability-cilium-tetragon-otel-genai-trajectory-eval/ ↩ ↩2
-
ingu627.github.io: IaC와 GitOps 실전 가이드: Terraform, Helm, ArgoCD, Flux 아키텍처 비교 (2026). /cloud/iac-gitops/ ↩ ↩2
-
Kubernetes SIGs / kro Official Documentation: Kube Resource Orchestrator (kro) — ResourceGraphDefinition, SimpleSchema, and CEL DAG Concepts (2025–2026). https://kro.run/docs/overview ↩ ↩2 ↩3
-
Crossplane Official Documentation & Blog: Announcing Crossplane v2.0 — Namespaced Managed Resources, Direct Composite Resources, and Simplified App Authoring (2025). https://docs.crossplane.io ↩ ↩2 ↩3
-
Kubernetes SIGs: LeaderWorkerSet (LWS) API for Multi-Host AI/ML Inference Workloads on Kubernetes (2025). https://github.com/kubernetes-sigs/lws ↩
-
Google / Kubernetes API Machinery: Common Expression Language (CEL) Specification and Kubernetes Validation Rules (2025). https://cel.dev ↩ ↩2
-
Flux CD Official Documentation: GitOps Toolkit Components (source-controller, kustomize-controller, helm-controller, notification-controller) (2025). https://fluxcd.io/flux/components/ ↩
-
Crossplane Official Documentation: Composition Functions and Pipeline Mode (
apiextensions.crossplane.io/v2) (2025). https://docs.crossplane.io/latest/concepts/composition-functions/ ↩ -
ingu627.github.io: 2026 엔터프라이즈 에이전트 호스팅 & AI FinOps 아키텍처: AWS Bedrock AgentCore와 Azure Foundry 비교 (2026). /cloud/enterprise-agent-hosting-ai-finops-aws-azure/ ↩
-
TypeSafe AI Official Documentation: System One (
/v1/systemone) & Jev Question Design Guide (2026). https://docs.typesafe.ai ↩ ↩2
댓글남기기