4비트 양자화는 왜 대배치(Large-Batch) 서빙에서 BF16보다 느려지는가: NVIDIA Model Optimizer(FP8·NVFP4)와 vLLM 추측 디코딩(Speculators v0.5·VLM) 심층 분석
이 글을 30초에 파악하기
한 줄로 — 동시 접속자가 늘었을 때 메모리를 4분의 1로 줄인 모델이 압축하지 않은 모델보다 오히려 느려지는 이유와, 그 현상이 사라지는 조건을 실제 측정값으로 따라가는 글이다.
읽고 나면 알게 되는 것
- 동시 요청이 늘 때 4비트 압축 모델이 원본 모델보다 느려지는 이유가 무엇인지
- 같은 압축이라도 어떤 방식이면 배치가 커져도 이득이 유지되는지
- 다음 단어를 미리 찍어 속도를 올리는 기법이 어떤 조건에서 오히려 손해가 되는지
용어 먼저 보기
| 용어 | 한 줄 설명 | 이 글에서의 역할 |
|---|---|---|
| 양자화 역전 | 메모리를 아끼려고 모델을 줄였는데, 특정 조건에서 줄이지 않은 모델보다 느려지는 현상 | 2절 전체가 이 현상의 원인을 캔다 |
| 연속 배칭 | 기다리는 요청들을 묶어 한 번의 계산으로 함께 처리하는 서빙 방식 | 1.1절 실측 표의 배치 크기가 이 값이다 |
| KV 캐시 | 앞서 계산한 토큰 정보를 저장해 두고 다시 계산하지 않게 하는 메모리 공간 | 1.2절에서 남은 VRAM을 이 공간에 배분한다 |
| TTFT | 요청을 보낸 뒤 첫 글자가 화면에 나올 때까지 걸리는 시간 | 1.1절에서 처리량과 정반대로 움직이는 값으로 측정된다 |
| INT4 AWQ (W4A16) | 가중치만 4비트로 줄이고 실제 계산은 16비트로 하는 압축 방식 | 2.2절에서 배치 64에서 0.88x로 떨어지는 쪽이다 |
| FP8·NVFP4 (W8A8·W4A4) | 가중치와 계산 입력을 함께 낮춰 전용 연산 장치로 계산하는 방식 | 2.3절에서 역전을 피하는 대안으로 제시된다 |
| 추측 디코딩 | 작은 초안 모델이 다음 단어 후보를 먼저 찍고 큰 모델이 한 번에 검증하는 기법 | 3절부터 4절까지 속도 이득과 한계를 다룬다 |
이런 분께 — 동시 요청이 많은 서비스를 운영하면서 모델 압축을 검토 중인 엔지니어에게 맞다. 처음 읽는다면 1.1절과 2.2절의 측정 표만 먼저 보고, 이유가 궁금하면 1.3절에서 2.3절 순서로 이어 읽으면 된다.
데모에서는 잘 돌던 모델이 사내 챗봇에 붙이자마자 느려졌다는 문의가 들어온다. 모델도 코드도 그대로인데 동시에 들어오는 요청 수만 달라졌을 때, 무엇을 먼저 의심해야 하는지가 이 글의 출발점이다.
단일 GPU나 소규모 노드에 대규모 언어 모델(LLM, Large Language Model)을 올린다고 하자. 이때 엔지니어가 가장 먼저 꺼내는 처방은 4비트 가중치 양자화(INT4 Weight-Only Quantization)다. 근거는 앞서 다룬 모델 경량화와 양자화 파이프라인 아키텍처1에서 이미 정리했다.
PTQ(Post-Training Quantization) 기반의 AWQ나 GPTQ로 가중치를 4비트로 압축하면 병목이 하나 줄어든다. HBM(High Bandwidth Memory)에서 SRAM으로 가중치를 읽어오는 대역폭 병목이다. 그 결과 단일 스트림 디코딩 속도가 개선된다.
트래픽을 추론 라우팅과 요청 캐스케이딩2 및 커스텀 모델 서빙 파이프라인3으로 계층별 분산해도 결론은 같다. 대형 모델을 실행하는 워커 노드의 단위 시간당 토큰 처리 효율을 높이는 일은 여전히 비용 절감의 핵심 과제다.
가중치를 4비트로 줄이는 일은 창고에 넣을 짐의 부피를 줄이는 일과 같다. 창고에서 꺼내 오는 시간은 줄지만, 꺼낸 짐을 원래 쓰임에 맞게 되살리는 손이 한 번 더 든다.
그러나 동시 접속자가 늘어 서빙 엔진의 연속 배칭(Continuous Batching) 배치 크기(Batch Size)가 16에서 64 이상으로 커지면 상황이 뒤집힌다. 이때는 직관과 정반대되는 현상이 관측된다. 메모리를 4분의 1로 줄인 INT4 AWQ(W4A16) 모델이 압축하지 않은 원본 BF16 모델보다 느려지는 양자화 역전(Quantization Inversion)이 바로 그것이다.
동시에 전체 시스템 처리량(Throughput)을 높이려 배치를 키울수록 개별 사용자가 체감하는 첫 토큰 도달 시간(TTFT, Time-To-First-Token)은 수십 배로 악화된다.
저자는 개인 오픈 웨이트 모델 허브인 ollama.com/ingu627 및 기술 포트폴리오4를 통해 6종의 양자화 모델(누적 15,293 Pulls)을 패키징해 왔다. 대상 모델은 Qwen2.5-VL, Llama 4 Scout, EXAONE 4.0 등이다. 이들을 vLLM 클러스터에서 벤치마킹하는 과정에서 대배치 양자화 역전을 직접 겪었다.
이 글은 그 원인과, 이를 해결하기 위한 FP8·NVFP4 커널 분기 및 추측 디코딩(Speculative Decoding) 결합 아키텍처를 수식과 코드 중심으로 정리한다.
1. 처리량 20배 증가와 TTFT 16.4배 악화의 딜레마
이 절은 서빙 운영에서 가장 자주 부딪히는 상충 관계에서 출발한다. 배치를 키우면 전체 처리량은 늘어나지만, 개별 사용자가 기다리는 시간은 함께 나빠진다. 두 값이 어디서 갈라지고 무엇이 그 속도를 결정하는지를 실측 표와 메모리 예산으로 확인한다.
1.1 H100 80GB 환경에서의 Llama 3.3 70B 연속 배칭 실측
프로덕션 서빙 클러스터에서 GPU 대당 비용 효율(Tokens per Dollar)을 높이려면, 단일 GPU가 동시에 처리하는 요청 수(Concurrency)를 끌어올려야 한다. 그런데 이 선택에는 대가가 따른다. Spheron이 2026년 10월 NVIDIA H100 80GB SXM 환경에서 측정한 벤치마크5가 그 대가를 보여준다.
측정 조건은 온디맨드 시간당 단가 $2.65/hr, 대상 모델은 Llama 3.3 70B FP8이다. 이 표는 연속 배칭이 만들어내는 처리량과 지연 시간 사이의 구조적 딜레마를 그대로 드러낸다.
| 동시 요청 수 (Concurrency) | 총 시스템 처리량 (Total Throughput) | 기준 대비 처리량 배수 | 개별 체감 TTFT (p50) | 기준 대비 TTFT 악화 배수 | GPU 병목 구간 특성 |
|---|---|---|---|---|---|
| 1개 (단일 스트림) | 120 tok/s | 1.0x | 45 ms | 1.0x | HBM 메모리 대역폭 바운드 |
| 16개 (중소 배치) | 1,180 tok/s | 9.8x | 165 ms | 3.7x | 메모리-연산 전이 구간 |
| 64개 (대배치 진입) | 2,050 tok/s | 17.1x | 480 ms | 10.7x | 텐서 코어 연산 밀도 바운드 |
| 100개 (고밀도 배치) | 2,400 tok/s | 20.0x | 740 ms | 16.4x | 연산 포화 및 KV 캐시 경합 |
동시 요청 수를 1개에서 100개로 확장하면, 연속 배칭 스케줄러가 디코드 단계의 행렬 곱셈을 묶어 처리한다. 그래서 전체 처리량은 120 tok/s에서 2,400 tok/s로 20.0배 증가한다. 반면 개별 요청의 중간값(p50) TTFT는 45ms에서 740ms로 16.4배 길어진다.
원인은 자원 경합이다. 다수의 디코드 스텝과 신규 진입 프롬프트의 프리필(Prefill) 연산이 같은 스트리밍 멀티프로세서(SM, Streaming Multiprocessor)와 HBM 대역폭을 두고 다투기 때문이다.
1.2 80GB VRAM의 물리적 한계와 KV 캐시 예산 수식
Llama 3.3 70B 모델을 단일 H100 80GB GPU에 적재할 때의 메모리 예산을 분해해보면 병목의 원인이 더 선명해진다. FP8(1바이트)로 양자화된 70B 모델의 정적 가중치 크기 $M_{\text{weights}}$는 약 70GB다. 여기에 CUDA 컨텍스트와 커널 작업 공간(Workspace), 런타임 활성화 텐서 버퍼($M_{\text{runtime}} \approx 2.5\text{GB}$)가 더 붙는다.
그 몫을 제외하면 KV 캐시(Key-Value Cache)에 쓸 수 있는 여유 공간 $M_{\text{KV}}$는 7.5~10GB 남짓에 불과하다.
KV 캐시 총량은 레이어 수 $L$, 키-값 헤드 수 $H_{kv}$, 헤드 차원 $d_h$, 데이터 타입 바이트 수 $b_{\text{kv}}$로 결정된다. 그룹 쿼리 어텐션(GQA, Grouped-Query Attention)을 쓰는 트랜스포머에서 동시 배치 크기 $B$와 평균 시퀀스 길이 $S$가 요구하는 총량은 다음과 같다.
\[M_{\text{KV}}(B, S) = 2 \times L \times H_{kv} \times d_h \times B \times S \times b_{\text{kv}}\]Llama 3.3 70B는 $L=80, H_{kv}=8, d_h=128$다. KV 캐시를 FP16($b_{\text{kv}}=2$)으로 유지하면 토큰 1개당 소모량이 정해진다. 그 값은 $2 \times 80 \times 8 \times 128 \times 2 = 327,680\text{ Bytes} \approx 320\text{KB}$다.
남은 10GB VRAM 전체를 KV 캐시에 할당해도 사정은 빠듯하다. 클러스터가 동시에 보유할 수 있는 최대 토큰 수용량 $T_{\max}$는 약 32,768개에 그친다. 동시 요청 $B=100$개가 유입되면 요청당 평균 327토큰만 넘어가도 한계에 닿는다.
이때 PagedAttention 블록 퇴거(Eviction)와 재연산(Recomputation)이 발생하며 지연 시간이 급증한다.
1.3 루프라인 모델(Roofline Model)과 산술 강도 유도
배치 크기에 따라 서빙 병목이 이동하는 현상은 하드웨어의 산술 강도(Arithmetic Intensity, $I$)로 설명된다. 산술 강도는 부동소수점 연산 수(FLOPs)를 메모리 전송량(Bytes)으로 나눈 값이다. 선형 투영 레이어 하나를 생각하자.
은닉 차원 $d_{\text{model}}$과 중간 차원 $d_{\text{ffn}}$을 가진 레이어($W \in \mathbb{R}^{d_{\text{in}} \times d_{\text{out}}}$)다. 이 레이어에 배치 크기 $B$의 입력 행렬 $X \in \mathbb{R}^{B \times d_{\text{in}}}$가 통과할 때, 그 비율 $I(B)$는 다음과 같이 유도된다.
\[I(B) = \frac{\text{FLOPs}}{\text{Bytes}_{\text{HBM}}} = \frac{2 \cdot B \cdot d_{\text{in}} \cdot d_{\text{out}}}{d_{\text{in}} \cdot d_{\text{out}} \cdot b_w + (B \cdot d_{\text{in}} + B \cdot d_{\text{out}}) \cdot b_a}\]여기서 $b_w$는 가중치의 바이트 크기, $b_a$는 활성화 값의 바이트 크기다. $d_{\text{in}}, d_{\text{out}} \gg B$인 일반적인 디코딩 구간에서 분모의 활성화 전송 항을 생략하면 근사식은 다음과 같이 단순화된다.
\[I(B) \approx \frac{2 \cdot B}{b_w} \quad (\text{FLOPs/Byte})\]하드웨어에는 피크 연산 성능 $\text{Peak}_{\text{FLOPs}}$와 HBM 대역폭 $\text{BW}_{\text{HBM}}$의 비율이 있다. 이 비율을 릿지 포인트(Ridge Point) $I_{\text{ridge}} = \text{Peak}_{\text{FLOPs}} / \text{BW}_{\text{HBM}}$라 한다. 이 값을 기준선으로 삼으면 영역이 둘로 갈린다.
$I(B) < I_{\text{ridge}}$이면 메모리 바운드, $I(B) \ge I_{\text{ridge}}$이면 연산 바운드 영역에 진입한다. 배치 크기 $B$가 커질수록 $I(B)$는 선형으로 증가한다. 결국 하드웨어의 병목이 HBM 대역폭에서 텐서 코어 연산 및 커널 실행 오버헤드로 전환된다.
핵심 요약 — Llama 3.3 70B FP8 서빙에서 동시 요청을 1개에서 100개로 늘리면 처리량은 20배 증가한다. 반면 TTFT p50은 16.4배 악화된다. 70GB 가중치 점유 때문에 남은 10GB 내외에서 KV 캐시를 운용해야 하는 물리적 제약도 남는다.
2. 양자화의 역설: 왜 배치 64에서 INT4 AWQ는 BF16보다 느려지는가
이 절은 앞 절에서 남긴 역설을 다룬다. 메모리를 4분의 1로 아낀 모델이 왜 대배치에서 오히려 느려지는지를 커널 수준에서 설명한다. 결론부터 말하면 원인은 압축률이 아니라 역양자화 비용이다.
2.1 NVIDIA Model Optimizer(nvidia-modelopt) 통합 양자화 파이프라인
과거 TensorRT Model Optimizer로 불리던 도구는 2025년 12월 8일부로 NVIDIA Model Optimizer(nvidia-modelopt)로 이름을 바꿨다. 이 도구는 단일 mtq.quantize() API 호출만으로 표준화된 양자화 체크포인트를 만든다. 그 체크포인트는 TensorRT-LLM, vLLM, SGLang에서 즉시 로드된다6.
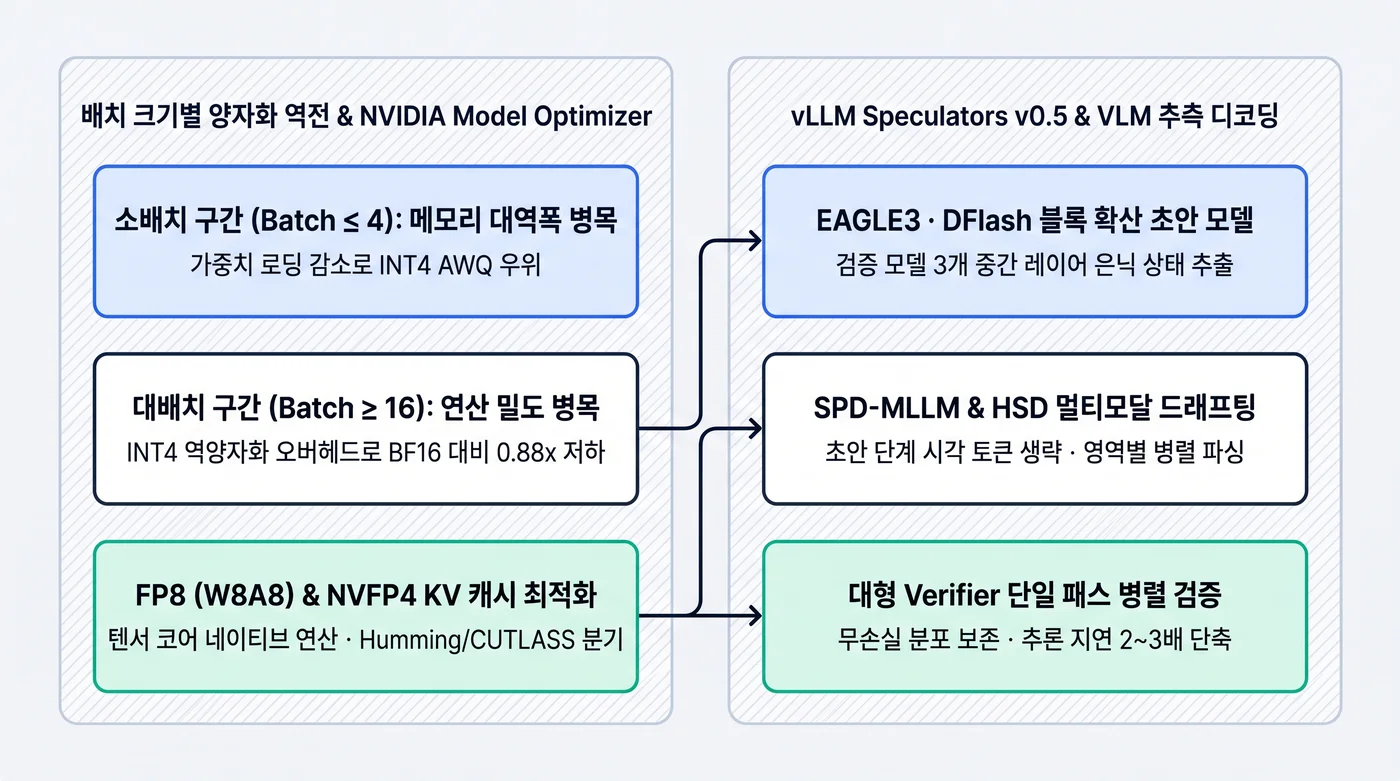
양자화 포맷은 두 갈래로 나뉜다. 하나는 가중치만 압축하고 활성화 값은 고정밀도로 두는 W4A16(INT4 AWQ7, GPTQ) 방식이다. 다른 하나는 가중치와 활성화 값을 모두 저정밀도로 바꿔 전용 텐서 코어에서 연산하는 W8A8(FP8) 및 W4A4(NVFP4) 방식이다.
2.2 H200 실측 벤치마크: 배치 크기에 따른 INT4 AWQ 처리량 역전
NVIDIA는 H200 GPU에서 배치 크기별 상대 처리량을 측정했다. 조건은 nvidia-modelopt v0.21.1과 TensorRT-LLM v0.15, 입력 시퀀스 2,048 토큰, 출력 128 토큰이고 기준선은 BF16 = 1.00x다6. 이 벤치마크는 W4A16 양자화의 역전 현상을 정량적으로 입증한다.
| 모델 아키텍처 | 양자화 포맷 (정밀도 구성) | Batch 1 상대 처리량 | Batch 4 상대 처리량 | Batch 8 상대 처리량 | Batch 16 상대 처리량 | Batch 64 상대 처리량 | 대배치 성능 판정 |
|---|---|---|---|---|---|---|---|
| Llama-3.1-70B | BF16 (W16A16 기준선) | 1.00x | 1.00x | 1.00x | 1.00x | 1.00x | 기준선 (Baseline) |
| Llama-3.1-70B | INT4 AWQ (W4A16) | 1.78x | 1.42x | 1.12x | 0.96x | 0.88x | Batch ≥ 16 역전 (저하) |
| Llama-3.1-70B | FP8 (W8A8 + FP8 KV) | 1.45x | 1.48x | 1.52x | 1.58x | 1.64x | 전 구간 가속 유지 |
| Llama-3.1-8B | BF16 (W16A16 기준선) | 1.00x | 1.00x | 1.00x | 1.00x | 1.00x | 기준선 (Baseline) |
| Llama-3.1-8B | INT4 AWQ (W4A16) | 1.54x | 1.08x | 0.75x | 0.79x | 0.83x | Batch ≥ 8 조기 역전 |
| Llama-3.1-8B | FP8 (W8A8 + FP8 KV) | 1.32x | 1.39x | 1.44x | 1.49x | 1.55x | 전 구간 가속 유지 |
위 표에는 배치 크기에 따라 부호가 뒤집히는 두 구간이 나란히 있다. 각 구간에서 무엇이 실행 시간을 지배하는지가 다르다.
- 소배치 구간 (Batch $\le 4$): HBM에서 레지스터로 가중치를 퍼 올리는 시간 $T_{\text{mem}}$이 전체 실행 시간을 지배한다. 가중치 크기를 BF16 대비 4분의 1로 줄이면 이 전송 시간도 그만큼 짧아진다. 그래서 INT4 AWQ(W4A16)는 Llama-3.1-70B Batch 1에서
1.78x의 가속비를 기록한다. - 대배치 구간 (Batch $\ge 16$): 입력 행렬 $X \in \mathbb{R}^{B \times d_{\text{in}}}$의 행(Row) 수가 늘어나면 산술 강도 $I(B)$가 상승한다. 그만큼 병목이 연산 밀도 쪽으로 옮겨간다. 그런데 GPU에는 INT4와 FP16을 직접 곱하는 네이티브 혼합 정밀도 텐서 코어 명령어가 없다. 그래서 W4A16 커널은 매 타일(Tile) 행렬 곱셈마다 INT4 가중치를 레지스터 상에서 FP16으로 실시간 역양자화(On-the-fly Dequantization)해야 한다.
표의 숫자를 배치 순서로 따라가면 역전이 그대로 보인다. Llama-3.1-70B의 INT4 AWQ는 Batch 1에서 1.78x였으나 Batch 16에서 0.96x, Batch 64에서 0.88x까지 내려간다. Batch 64의 0.88x는 처리량이 12% 낮다는 뜻이지 처리 시간이 12% 늘어난다는 뜻이 아니다.
같은 작업을 처리하는 데 BF16의 약 1.14배 시간이 걸린다. 반면 FP8은 Batch 1의 1.45x에서 Batch 64의 1.64x로 오히려 올라간다.
실시간 역양자화가 포함된 W4A16 GEMM의 단위 스텝 실행 시간 $T_{\text{W4A16}}(B)$를 수식으로 분해하면 다음과 같다.
\[T_{\text{W4A16}}(B) = \max\left( \frac{\text{Bytes}_{\text{INT4}}}{\text{BW}_{\text{HBM}}}, \frac{\text{FLOPs}_{\text{FP16}}(B)}{\text{Peak}_{\text{FP16}}} + T_{\text{dequant}}(B) \right)\]여기서 $T_{\text{dequant}}(B)$는 역양자화에 드는 ALU/SIMT 코어 명령어 오버헤드다. 그 안에는 비트 시프트(>>), 비트 마스킹(& 0x0F), 영점(Zero-point) 감산, 그룹 스케일(Scale) 곱셈이 들어간다. 배치 크기가 커지면 HBM 절감 이득($\text{Bytes}_{\text{INT4}} / \text{BW}_{\text{HBM}}$)은 연산 시간 뒤에 숨어버린다(Latency Hiding).
반대로 $T_{\text{dequant}}(B)$는 텐서 코어 파이프라인을 지연시킨다. 결국 Llama-3.1-70B Batch 64에서 처리량이 BF16 대비 0.88x로 하락한다. 파라미터 규모가 작은 8B 모델은 가중치 로딩 비중이 더 낮다.
그래서 Batch 8에서 이미 0.75x로 역전이 시작된다.
2.3 해결책: FP8(W8A8)·NVFP4 결합 및 vLLM 커스텀 선형 백엔드 분기
대배치 역전을 피하는 첫걸음은 기본 포맷을 바꾸는 것이다. 가중치와 활성화 값을 모두 양자화하면 역양자화 단계 없이 텐서 코어에서 직접 행렬 곱을 수행할 수 있다. 그 포맷이 FP8(W8A8)이다.
여기에 메모리 점유율이 큰 KV 캐시용으로 4비트 부동소수점인 NVFP4를 결합한다. 한편 어텐션이나 라우터 게이트처럼 정밀도에 민감한 레이어는 NVFP4 W4A16 또는 BF16으로 남긴다. 이때는 vLLM에서 레이어 특성에 맞춰 선형 백엔드(Linear Backend) 커널을 분리 지정하면 오버헤드를 억제할 수 있다.
import torch
import modelopt.torch.quantization as mtq
from modelopt.torch.export import export_hf_checkpoint
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "meta-llama/Llama-3.3-70B-Instruct"
model = AutoModelForCausalLM.from_pretrained(model_id, torch_dtype=torch.bfloat16, device_map="auto")
tokenizer = AutoTokenizer.from_pretrained(model_id)

# 1. FP8 (W8A8) 선형 연산 + NVFP4 KV 캐시 결합 양자화 구성
quant_cfg = mtq.FP8_DEFAULT_CFG.copy()
quant_cfg["quant_cfg"]["*kv_b_proj*"] = {"num_bits": (2, 1), "axis": -1}  # NVFP4 KV Cache

def forward_loop(m):
    for text in ["Distributed Kubernetes KV cache budgeting.", "Speculative decoding draft verification."]:
        with torch.no_grad():
            m(**tokenizer(text, return_tensors="pt").to(m.device))

# 2. 단일 mtq.quantize() API로 양자화 및 vLLM/TRT-LLM/SGLang 통합 체크포인트 추출
model = mtq.quantize(model, quant_cfg, forward_loop=forward_loop)
export_hf_checkpoint(model, export_dir="/models/llama-3.3-70b-fp8-nvfp4kv")
추출된 혼합 정밀도 모델을 vLLM에 배포할 때는 커널을 레이어별로 나눠 붙인다. 아래 매니페스트가 그 예다. NVFP4 W4A16이 적용된 레이어에는 레지스터 언패킹이 최적화된 Humming 커널을 쓴다. 주력 FP8/NVFP4 텐서 코어 연산 레이어에는 CUTLASS 백엔드를 붙인다.
apiVersion: serving.kserve.io/v1beta1
kind: InferenceService
metadata:
  name: llama-3-3-70b-fp8-nvfp4
  namespace: ai-serving
spec:
  predictor:
    containers:
      - name: vllm-engine
        image: vllm/vllm-openai:v0.8.4
        args:
          - "--model=/models/llama-3.3-70b-fp8-nvfp4kv"
          - "--quantization=modelopt"
          - "--kv-cache-dtype=nvfp4"
          - "--max-num-seqs=128"
          - "--max-model-len=16384"
        env:
          - name: VLLM_NVFP4_W4A16_BACKEND
            value: "HYBRID_HUMMING_CUTLASS"
          - name: VLLM_LINEAR_KERNEL_OVERRIDES
            value: '{"*.mlp.down_proj": "humming", "*.self_attn.*": "cutlass", "default": "cutlass"}'
2.4 가지치기(Pruning)·2단계 지식 증류·FP8 순차 결합 실측
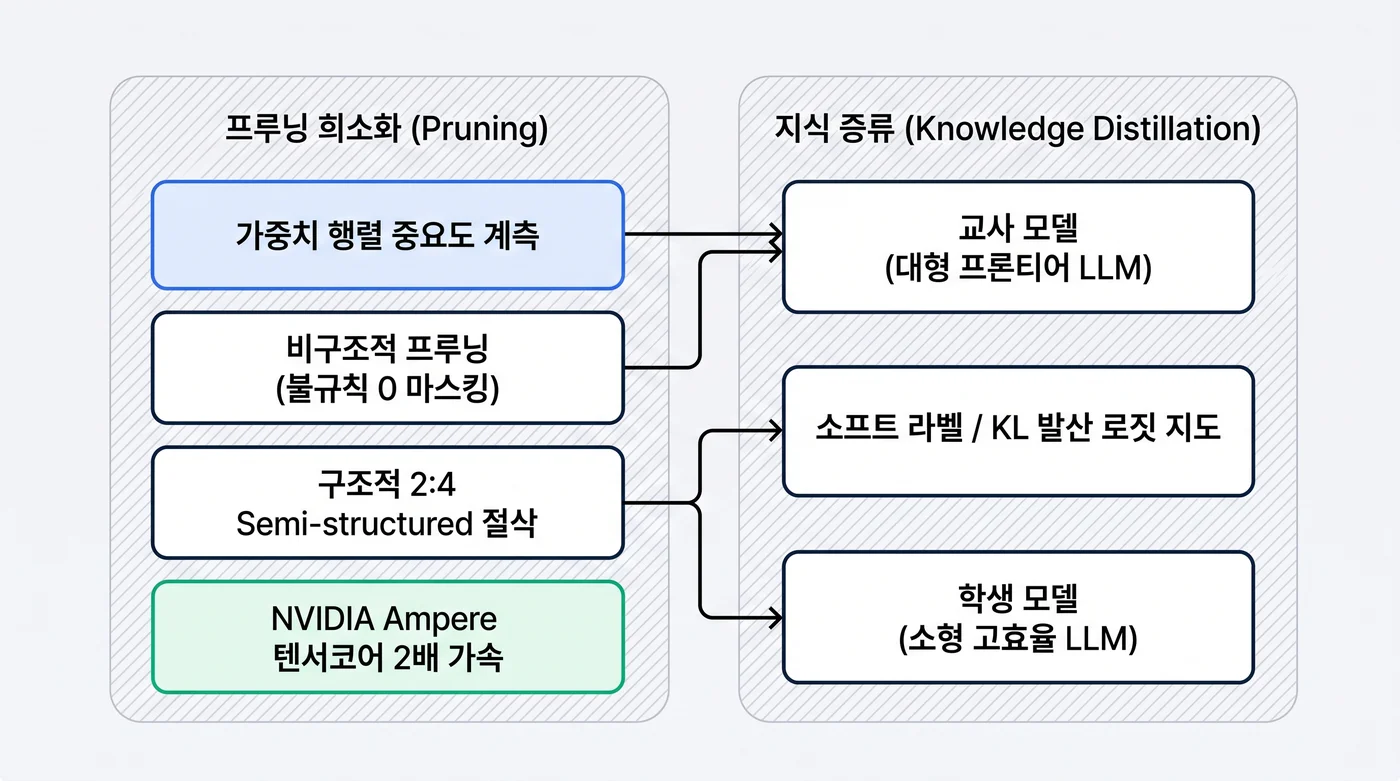
양자화만 적용해서 얻는 이득에는 한계가 있다. 구조적 가지치기(Structural Pruning)와 지식 증류(Knowledge Distillation)를 파이프라인으로 결합하면 대배치 처리량과 메모리 효율을 함께 끌어올릴 수 있다18.
 출처: ingu627.github.io — 모델 경량화와 양자화 파이프라인 아키텍처
실제로 NVIDIA는 하이브리드 MoE 모델인 Nemotron-3-Nano-30B-A3B에 세 단계를 순서대로 적용했다. ① 중요도 기반 가중치 가지치기(Pruning)다. ② 교사 모델의 은닉 상태 정렬 및 KL 발산 로짓 지도(Logit Guidance)를 결합한 2단계 지식 증류(Two-Stage Knowledge Distillation)다.
③ nvidia-modelopt 기반 FP8(W8A8) 양자화다. 그 결과 정확도 손실을 1% 미만으로 유지하면서 vLLM 서빙 환경에서 처리량 2.6배 향상 및 VRAM 메모리 점유 2.6배 절감을 동시에 달성했다8.
핵심 요약 — Batch 16 이상에서 INT4 AWQ(W4A16)는 BF16 대비 처리량이 0.88x로 하락한다. 원인은 실시간 FP16 역양자화 커널 오버헤드다. 그래서 대배치 서빙에서는 텐서 코어 네이티브 연산을 수행하는 FP8(W8A8)과 NVFP4 KV 캐시, Humming/CUTLASS 커널 분기를 적용해야 한다.
3. vLLM Speculators(v0.3~v0.5) 기반 추측 디코딩 엔지니어링
챗봇 응답이 한 토큰씩 찍히는 동안 GPU는 가중치 전체를 HBM에서 다시 읽는다. 그 사이 텐서 코어는 대부분 비어 있고, 응답이 길어질수록 이 빈 시간이 그대로 지연으로 쌓인다.
이 절은 순차 디코딩 스텝 자체를 줄이는 방법을 다룬다. 양자화가 한 번의 계산을 가볍게 만드는 접근이라면, 추측 디코딩은 계산 횟수를 줄이는 접근이다. 먼저 얼마나 빨라지는지를 수식으로 계산하고, 그 다음 실제 프레임워크 구성으로 넘어간다.
3.1 추측 디코딩의 기대 생성 토큰 수와 지연 시간 단축 수리 모델
양자화가 단일 순전파(Forward Pass)의 메모리 전송량을 줄이는 접근이라면, 추측 디코딩(Speculative Decoding)9은 순차적인 오토리그레시브 디코딩 스텝 수 자체를 압축한다. 작은 초안 모델(Drafter, $M_q$)이 $K$개의 후보 토큰을 빠르게 생성한다. 그러면 대형 검증 모델(Verifier, $M_p$)이 단일 순전파(GEMM)로 $K$개 토큰을 병렬 검증한다.
초안 토큰이 검증 모델의 분포 $p(x)$에 의해 수락될 평균 확률(Acceptance Rate)을 $\alpha \in [0, 1]$이라 하자. 그러면 한 번의 검증 모델 순전파당 생성되는 기대 토큰 수 $\mathbb{E}[\tau]$는 절단된 기하 분포의 합으로 유도된다.
\[\mathbb{E}[\tau] = \sum_{i=0}^{K} \alpha^i = \frac{1 - \alpha^{K+1}}{1 - \alpha}\]초안 모델 1회 실행의 시간 비용을 검증 모델 1회 실행 대비 비율 $c = T_{\text{draft}} / T_{\text{verify}}$로 두자. 총 $K$번의 초안 생성을 거치는 추측 디코딩의 실질 가속비(Speedup Factor) $S(\alpha, K, c)$는 다음과 같다.
\[S(\alpha, K, c) = \frac{\mathbb{E}[\tau]}{1 + K \cdot c} = \frac{1 - \alpha^{K+1}}{(1 - \alpha)(1 + K \cdot c)}\]예를 들어 $K=5, \alpha=0.80, c=0.04$인 환경을 보자. 단일 검증 패스에서 $\mathbb{E}[\tau] = (1 - 0.8^6) / 0.2 \approx 3.69$토큰이 생성된다. 전체 디코딩 지연 시간은 표준 디코딩 대비 2.2~3.0배 단축된다.
거부된 첫 위치에서는 수정 분포 $p’(x) = \text{norm}(\max(0, p(x) - q(x)))$에서 토큰을 다시 샘플링한다. 그래서 출력 분포는 원본 모델과 수학적으로 100% 동일(Lossless)하다.
3.2 vLLM Speculators 아키텍처: 3개 중간 레이어 은닉 상태 추출
vLLM 프로젝트의 공식 추측 디코딩 프레임워크가 Speculators(v0.3~v0.5)10다. 이 프레임워크는 별도의 독립 소형 모델을 쓰지 않는다. 대신 검증 모델 내부의 특징 표현을 직접 재사용하는 EAGLE3 계열 아키텍처를 표준으로 채택했다.
Speculators의 데이터 추출 및 학습 파이프라인은 검증 모델의 프리필 단계에서 다음 4가지 텐서를 오프라인 또는 온라인으로 추출한다. 그리고 그 텐서로 초안 헤드를 훈련한다.
- 3개 중간 레이어 은닉 상태(Intermediate Hidden States): 초기 방식은 최종 레이어 직전의 단일 벡터만 썼다. 여기서는 검증 모델의 저층·중층·고층에서 은닉 상태 3개($h^{(l_1)}, h^{(l_2)}, h^{(l_3)}$)를 뽑는다. 이를 연결(Concatenation)한 뒤 선형 투영하여 계층적 문맥 정보를 보존한다.
- 토큰 ID 시퀀스(Token IDs): 자기회귀 입력 임베딩 구성을 위한 원본 토큰 인덱스 시퀀스다.
- 어시스턴트 응답 손실 마스크(Loss Mask): 시스템 프롬프트와 사용자 질의 구간은
0으로 마스킹한다. 실제 어시스턴트 응답 구간만1로 활성화한다. 이렇게 하면 초안 모델의 학습 용량이 생성 분포에 집중된다. - 타깃 출력 확률 분포(Output Probabilities): Top-$K$ 로짓 또는 전체 어휘 분포에 대한 교차 엔트로피 및 KL 발산 손실 계산에 쓰는 타깃 텐서다.
현재 vLLM Speculators는 Llama 3.1~3.3(8B~70B) 및 Qwen3(8B~32B) 전 제품군을 지원한다. 해당 모델군에는 사전 학습된 EAGLE3 체크포인트가 제공된다.
3.3 Speculators v0.5.0의 핵심 진화: DFlash 블록 확산과 온·오프라인 통합 학습
2026년 5월 28일 릴리즈된 Speculators v0.5.010은 초안 생성 자체의 직렬 병목을 없애는 데 초점을 맞췄다. 이를 위해 네 가지 아키텍처 업그레이드를 도입했다. 아래 목록은 각 항목이 어떤 병목을 겨냥하는지를 보여준다.
- DFlash 블록 확산(Block-Diffusion) 초안 모델: 기존 EAGLE3는 초안 토큰 $K$개를 만들 때 $K$번의 순차적 소형 순전파를 수행해야 했다. DFlash는 이 한계를 블록 단위 확산(Block-Diffusion) 디노이징으로 넘는다. 후보 토큰 블록 $K$개 전체를 단일 순전파(Single-step Parallel Drafting)로 동시에 예측하는 방식이다. 덕분에 식 $S(\alpha, K, c)$의 초안 비용 항 $K \cdot c$가 $c_{\text{block}}$ 단일 상수로 줄어든다.
- 온·오프라인 통합 학습(Unified Online/Offline Training): 기존 오프라인 방식은 테라바이트 규모의 은닉 상태 텐서를 디스크에 덤프했다. 온라인 모드는 vLLM 추론 서버가 실시간으로 만드는 은닉 상태를 공유 메모리 버퍼로 받아 즉시 학습한다. 두 방식을 단일 트레이너 인터페이스로 통합한 것이 이번 변경이다.
- 네이티브 은닉 상태 추출(Native Hidden-State Extraction): 모델 코드를 수동으로 패치할 필요가 없다. vLLM 엔진 내부 훅(Hook)을 통해 지정된 3개 레이어의 은닉 상태를 제로 카피(Zero-copy)로 수집한다.
- Gemma 4 전용 가속: 하이브리드 로컬-글로벌 어텐션 구조를 가진 Gemma 4 패밀리에는 전용 커널이 붙는다. EAGLE3 및 DFlash 어댑터 커널이 기본 내장된 형태다.
# Speculators v0.5.0 DFlash 블록 확산 초안 모델 학습 및 vLLM 서빙 설정 예시
speculator_config:
  version: "0.5.0"
  algorithm: "dflash_eagle3"
  verifier_model: "Qwen/Qwen3-32B-FP8"
  feature_extraction:
    mode: "online_native"
    captured_layers: [8, 32, 60]
    apply_assistant_loss_mask: true
    top_k_logits: 64
  drafter_architecture:
    block_diffusion_size: 6
    hidden_size: 4096
    num_attention_heads: 32
vllm_runtime_args:
  speculative_model: "/models/qwen3-32b-dflash-speculator-v0.5"
  num_speculative_tokens: 6
  speculative_draft_tensor_parallel_size: 1
핵심 요약 — vLLM Speculators v0.5.0은 검증 모델의 3개 중간 레이어 은닉 상태와 손실 마스크를 네이티브로 추출해 EAGLE3를 학습시킨다. 또 DFlash 블록 확산 초안 모델로 후보 토큰 블록을 병렬 생성한다. 그 결과 디코딩 지연이 2~3배 줄어든다.
4. 시각-언어 모델(VLM)을 위한 멀티모달 추측 디코딩: SPD-MLLM과 HSD
계약서 스캔본과 요약 지시를 함께 넣었더니, 같은 길이의 텍스트만 넣었을 때보다 첫 글자가 늦게 나온다. 이미지 한 장이 수천 개의 시각 토큰으로 바뀌어 프리필 컨텍스트를 채우기 때문이다.
이 절은 이미지가 붙은 요청에서 추측 디코딩이 무너지는 지점을 다룬다. 텍스트만 있는 요청에서는 잘 돌던 기법이 시각 입력 앞에서 갑자기 이득을 잃는다. 원인은 시각 토큰 수이고, 해법은 초안 단계와 검증 단계를 비대칭으로 나누는 데 있다.
초안 모델이 하는 일은 사진을 보지 않고도 다음 문장의 문법을 맞히는 것과 비슷하다. 검증 모델이 사진을 대조해 숫자와 고유명사만 바로잡아 주면, 사진을 매번 처음부터 다시 보는 수고를 덜 수 있다.
4.1 시각 토큰(Visual Tokens) 폭증이 유발하는 VLM 초안 병목
Qwen2.5-VL-7B나 Llama 4 Scout 같은 시각-언어 모델(VLM, Vision-Language Model)은 텍스트 전용 LLM과 다르게 동작한다. 고해상도 이미지나 다중 페이지 PDF 문서를 입력하면, 비전 인코더(ViT)가 이미지 한 장당 1,024~4,096개의 시각 토큰(Visual Tokens)을 생성한다.
텍스트 응답이 불과 200토큰이더라도 프리필 컨텍스트 길이는 수천 토큰으로 불어난다. 이 상태에서 일반 추측 디코딩을 그대로 적용하면 소형 초안 모델($M_q$)도 부담을 피하지 못한다. 수천 개의 시각 토큰 KV 캐시에 대해 매 스텝 어텐션을 계산해야 하기 때문이다. 결국 초안 생성 비용 $c$가 급증하고 가속 효과는 사라진다.
4.2 SPD-MLLM(시각 토큰 생략)과 HSD(계층적 병렬 파싱) 아키텍처
멀티모달 추측 디코딩 서베이 연구(Preprints 202603.2344)11는 이 병목을 푸는 두 가지 비대칭 아키텍처를 제시한다. 아래 두 항목은 초안 단계와 검증 단계 중 어디를 손보는지가 서로 다르다.
- SPD-MLLM (Speculative Decoding for Multimodal LLM — 초안 단계 시각 토큰 생략/압축):
- 출발점은 관찰 하나다. 초안 모델이 다음 단어를 예측할 때 문법적 연결어, 마크다운 구문, 일반적인 문맥 흐름은 이전 텍스트 토큰과 검증 모델의 최상위 은닉 상태만으로도 높은 정확도로 추측된다.
- 초안 단계(Draft Stage)에서는 무거운 원본 이미지 토큰 수천 개를 완전히 생략한다(Visual Token Bypass). 또는 평균 풀링(Average Pooling)으로 90% 이상 압축한 경량 시퀀스만 참조한다. 그 상태로 $K$개의 후보 토큰을 고속 생성한다.
- 검증 단계(Verify Stage)에서만 대형 VLM이 전체 해상도의 시각 인코딩과 텍스트 후보 토큰을 결합한다. 그리고 단일 패스로 엄밀히 검증한다. 시각적 세부 정보(숫자, 고유명사)가 틀린 위치만 검증 모델의 분포로 즉시 교정된다.
SPD-MLLM이 초안 쪽 비용을 깎는 방식이라면, HSD는 검증을 영역별로 쪼개 병렬화한다.
- HSD (Hierarchical Speculative Decoding — 장문 문서 영역별 병렬 Draft-Verify): 장문 문서 변환 작업이다.
- 복잡한 표와 다단 레이아웃이 포함된 문서를 마크다운으로 바꿀 때는 초경량 OCR/레이아웃 파서를 1차 초안 모델(Drafter)로 배치한다.
- 문서를 바운딩 박스 영역(헤더, 표, 본문 단락)별로 분할한다. 그 뒤 경량 파서가 각 영역의 마크다운 초안을 동시에 생성한다. 대형 VLM은 영역 배치 단위로 병렬 Draft-Verify를 수행하여 장문 문서 파싱 처리량을 높인다.
4.3 TypeSafe System One(Jev) 기반 동적 드래프터 깊이 및 백엔드 제어
실제 VLM 서빙 클러스터에서는 최적의 양자화 커널과 추측 디코딩 전략이 상황마다 달라진다. 판단 기준은 두 가지다. 입력 이미지의 시각적 복잡도(단순 UI 스크린샷인지, 미세한 숫자가 빼곡한 재무제표인지)와 현재 GPU 노드의 활성 배치 크기(Batch Size)다.
라우팅 규칙을 생성형 LLM에게 추론시키는 대신 다른 방법이 있다. TypeSafe AI의 비생성형 판단 모델인 System One(POST /v1/systemone, Jev)12을 서빙 컨트롤 플레인 앞단에 배치하는 것이다. 이 모델은 단일 순전파(70~120ms)로 입력 문서 상태와 클러스터 텔레메트리를 평가한다. 그러면 결정론적 호스트 코드가 그 결과를 받아 서빙 파라미터를 전환한다.
컨트롤 플레인이 /v1/systemone 엔드포인트로 보내는 HTTP JSON 페이로드는 두 부분으로 나뉜다. 원시 런타임 텔레메트리(state)와 순수 판단 규칙(questions)이다. 구조는 다음과 같다.
{
  "state": {
    "request_id": "req-vlm-90812",
    "active_gpu_batch_size": 48,
    "visual_token_count": 3240,
    "ocr_layout_preview": "연결재무제표 주석 제14호: 2026년 3분기 파생상품 평가손익 명세표 (12열 x 45행 조밀 수치 테이블)"
  },
  "questions": {
    "visual_density": {
      "type": "score",
      "instructions": "입력 문서 프리뷰에 나타난 시각적 텍스트 및 수치 밀도를 평가하시오.",
      "criteria": {
        "0": "단일 객체 사진, 아이콘, 또는 텍스트가 10단어 미만인 단순 이미지 상태",
        "1": "일반 문서 단락이나 슬라이드처럼 표준 크기의 텍스트와 제목 위주로 구성된 상태",
        "2": "다단 표, 재무제표, 미세 좌표나 조밀한 수치 행렬이 포함되어 글자 하나만 틀려도 의미가 훼손되는 상태"
      }
    },
    "drafting_mode": {
      "type": "choice",
      "instructions": "입력 문서의 구조적 특성에 따라 적용할 멀티모달 초안 생성 모드를 분류하시오.",
      "criteria": {
        "spd_visual_bypass": "일반 질의응답이나 시각 요약 요청으로 초안 단계에서 시각 토큰 생략이 가능한 경우",
        "hsd_region_parallel": "표, 양식, 다단 문서를 마크다운으로 구조화 변환해야 하여 영역별 경량 파서 초안이 필요한 경우"
      }
    },
    "bypass_speculative_on_heavy_batch": {
      "type": "noul",
      "instructions": "현재 GPU 활성 배치 크기가 32 이상이면서 동시에 시각 토큰 수가 2048개를 초과하는 상태인가?"
    }
  }
}
이 계약을 Python SDK(Choice, Score, Noul)로 선언할 수 있다. 그러면 호스트 코드가 실행 백엔드와 드래프터 깊이($K$)를 결정론적으로 분기한다. 분기 기준은 홀드아웃 데이터셋에서 보정(Calibration)한 확률 임계값이다. 그 코드는 다음과 같다.
from typesafe import SystemOne, Choice, Score, Noul

client = SystemOne()

def select_vlm_serving_execution_plan(telemetry: dict) -> dict:
    judgment = client.evaluate(
        state={
            "active_gpu_batch_size": telemetry["batch_size"],
            "visual_token_count": telemetry["visual_tokens"],
            "ocr_layout_preview": telemetry["layout_summary"],
        },
        questions={
            "visual_density": Score(
                instructions="입력 문서 프리뷰에 나타난 시각적 텍스트 및 수치 밀도를 평가하시오.",
                criteria={
                    0: "단일 객체 사진, 아이콘, 또는 텍스트가 10단어 미만인 단순 이미지 상태",
                    1: "일반 문서 단락이나 슬라이드처럼 표준 크기의 텍스트와 제목 위주로 구성된 상태",
                    2: "다단 표, 재무제표, 미세 좌표나 조밀한 수치 행렬이 포함되어 글자 하나만 틀려도 의미가 훼손되는 상태",
                },
            ),
            "drafting_mode": Choice(
                instructions="입력 문서의 구조적 특성에 따라 적용할 멀티모달 초안 생성 모드를 분류하시오.",
                criteria={
                    "spd_visual_bypass": "일반 질의응답이나 시각 요약으로 초안 단계에서 시각 토큰 생략이 가능한 경우",
                    "hsd_region_parallel": "표나 다단 문서를 마크다운으로 구조화 변환해야 하여 영역별 파서 초안이 필요한 경우",
                },
            ),
            "bypass_speculative_on_heavy_batch": Noul(
                instructions="현재 GPU 활성 배치 크기가 32 이상이면서 동시에 시각 토큰 수가 2048개를 초과하는 상태인가?"
            ),
        },
    )
    quant_backend = "fp8_cutlass_w8a8" if telemetry["batch_size"] >= 16 else "nvfp4_humming_w4a16"
    if judgment.bypass_speculative_on_heavy_batch.prob >= 0.85:
        return {"backend": quant_backend, "spec_mode": "disabled", "draft_k": 0}
    if judgment.visual_density.score == 2 and judgment.drafting_mode.choice == "hsd_region_parallel":
        return {"backend": quant_backend, "spec_mode": "hsd_region_parallel", "draft_k": 3}
    return {"backend": quant_backend, "spec_mode": "spd_visual_bypass_dflash", "draft_k": 6}
핵심 요약 — VLM 서빙에서 수천 개 시각 토큰이 초안 모델을 지연시키는 병목은 두 갈래로 풀린다. 초안 단계에서 시각 토큰을 생략하는 SPD-MLLM과 영역별 병렬 초안을 생성하는 HSD다. 여기에 TypeSafe System One(Jev)을 붙이면 문서 밀도와 배치 부하를 스냅 판정해 드래프터 깊이($K$)를 동적으로 제어할 수 있다.
5. 실전 아키텍처 비교 노트: Ollama 배포 6종 오픈 웨이트 모델 해부
같은 4비트 파일을 올렸는데 어떤 모델은 VRAM이 빠듯하고 어떤 모델은 여유롭다. 모델마다 어텐션 구조가 달라 KV 캐시가 차지하는 몫이 크게 갈리기 때문이다.
이 절은 실제로 배포한 모델들의 구조를 나란히 놓고 비교한다. 같은 4비트 양자화라도 어텐션 구조가 다르면 KV 캐시와 연산 프로파일이 달라진다. 표를 먼저 보고, 그 아래에서 대표 모델 세 개의 설계를 뜯어본다.
5.1 ollama.com/ingu627 배포 6종 모델 양자화 및 어텐션 구조 비교
저자는 로컬 및 엣지-클라우드 하이브리드 서빙 실험을 위해 6종의 주요 오픈 웨이트 양자화 모델을 직접 패키징해 배포하고 있다. 배포처는 ollama.com/ingu627(포트폴리오4)다. 2026년 10월 기준 도합 15,293회의 다운로드(Pulls)가 발생했다. 각 모델의 양자화 포맷을 검증하는 과정에서 확인한 어텐션 토폴로지와 추론 특성은 아래 표와 같다.
배포 모델 식별자 (ollama.com/ingu627) |
누적 Pulls | 파라미터 규모 (총 / 활성) | 기본 양자화 구성 | 핵심 어텐션 및 위치 인코딩 아키텍처 | 프로덕션 서빙 및 KV 캐시 특성 |
|---|---|---|---|---|---|
Qwen2.5-VL-7B-Instruct-Q5_K_M |
4,962회 | 7.6B Dense | GGUF Q5_K_M (중요 가중치 6비트 보존) |
동적 해상도 ViT + M-RoPE (Multimodal RoPE) | 비전 투영 레이어를 4비트로 내리면 OCR 좌표 오차가 증가하여 Q5_K_M 채택 |
llama4-scout-q4 |
4,839회 | 109B Total / 17B Active (16 Experts) | INT4 / NVFP4 혼합 양자화 | Early Fusion MoE + iRoPE (Interleaved RoPE) | 17B 활성 가중치만 연산에 참여하나 109B 전체 가중치가 VRAM을 점유 |
exaone4.0 |
4,556회 | 32B / 1.2B Dense | 4비트 그룹 양자화 | 3:1 Hybrid Attention + NoPE 결합 + QK-Reorder-Norm | 4개 레이어 중 3개를 슬라이딩 윈도우로 처리하여 장문 KV 캐시 75% 절감 |
phi-4-mini-instruct-q4 |
568회 | 3.8B Dense | INT4 Group-128 | 고밀도 GQA + 장문 확장 RoPE | 소형 초안 모델(Drafter) 및 엣지 경량 분류기로 활용 시 높은 산술 효율 |
qwen3 |
309회 | 235B Total / 22B Active (8~32B Dense 포함) | FP8 (W8A8) / Q4_K_M | Thinking / Non-Thinking 듀얼 모드 토글 | <think> 토큰 예산에 따라 디코드 길이가 5~10배 변동되어 동적 배칭 제어 필수 |
EXAONE-Deep-7.8B |
59회 | 7.8B Dense | GGUF Q4_K_M |
심층 추론(Reasoning) 특화 체인 구조 | 다단계 수리·코드 검증 시 출력 시퀀스가 길어 추측 디코딩 가속 체감이 큼 |
표의 75% 절감은 3:1 비율이 만든 값이다. 윈도우 $W$가 시퀀스 길이 $N$보다 아주 작으면 레이어당 평균 참조 길이는 $N/4$로 수렴해, 글로벌 어텐션만 쓰는 경우보다 KV 캐시가 4분의 1 수준까지 내려간다.
5.2 EXAONE 4.0의 3:1 Hybrid Attention·NoPE·QK-Reorder-Norm 해부
4,556회 다운로드된 EXAONE 4.0(32B 및 1.2B)은 장문 컨텍스트 서빙에서 KV 캐시 메모리와 연산량을 줄이려 했다. 이를 위해 세 가지 구조적 설계를 결합했다. 아래 세 항목은 각각 윈도우, 위치 인코딩, 정규화 순서를 건드린다.
- 3:1 하이브리드 어텐션(Hybrid Attention — Sliding Window : Global Attention):
- 전체 트랜스포머 블록을 4개 레이어 단위로 묶는다. 앞의 3개 레이어는 고정된 로컬 윈도우 크기 $W$ 내부의 토큰만 참조하는 슬라이딩 윈도우 어텐션(SWA, Sliding Window Attention)으로 실행한다. 4번째 레이어 단 1개만 전체 시퀀스 $N$을 참조하는 글로벌 어텐션(Global Attention)으로 배치한다.
- 이에 따라 시퀀스 길이 $N \gg W$인 장문 구간에서 레이어당 평균 어텐션 복잡도와 KV 캐시 요구량 $M_{\text{KV, EXAONE}}$은 다음과 같이 축소된다. \(M_{\text{KV, EXAONE}} = L \cdot H_{kv} \cdot d_h \cdot b_{\text{kv}} \cdot \left( \frac{3}{4} W + \frac{1}{4} N \right)\)
여기까지가 윈도우 크기를 제한하는 설계다. 다음 두 항목은 위치 정보와 정규화 순서를 다룬다.
- RoPE 생략(NoPE 구조 결합):
- 글로벌 어텐션 레이어에서는 회전 위치 임베딩(RoPE)을 의도적으로 생략한다. 이것이 NoPE(No Positional Embedding) 방식이다. 이렇게 하면 학습 시 본 컨텍스트 길이를 넘어서는 외삽(Length Extrapolation) 구간에서 어텐션 스코어가 발산하는 문제를 막을 수 있다. 원인은 회전 주파수 왜곡이다.
- QK-Reorder-Norm:
- 어텐션 내적 직전에 쿼리(Query)와 키(Key)의 정규화(RMSNorm) 순서를 재배치한다. FP8이나 INT4 양자화를 적용하면 어텐션 로짓에서 활성화 이상치(Outlier) 스파이크가 생기는데, 이 순서 변경이 그 스파이크를 구조적으로 억제한다.
5.3 Llama 4 Scout의 Early Fusion MoE·iRoPE 및 Qwen3 듀얼 모드 특성
두 모델은 서로 다른 방식으로 연산 예산과 컨텍스트를 다룬다. 하나는 전문가 라우팅으로 연산량을 줄이고, 다른 하나는 추론 깊이를 토글한다. 아래 목록은 그 차이를 정리한 것이다.
- Llama 4 Scout (109B Total / 17B Active, 16 Experts):
- 텍스트와 이미지/비디오 토큰을 초기 트랜스포머 레이어부터 단일 백본으로 통합 처리한다. 조기 융합(Early Fusion) MoE 구조다.
- 위치 인코딩이 적용된 어텐션 레이어와 온도 스케일링(Temperature Scaling)이 적용된 NoPE 레이어를 교차 배치한다. 이 iRoPE(Interleaved RoPE) 아키텍처 덕분에 최대 1,000만(10M) 토큰 컨텍스트 확장을 지원한다.
- 서빙 관점에서는 토큰당 17B 파라미터만 활성화되어 연산량이 가볍다. 반면 라우팅 가능한 16개 전문가(109B 전체)는 HBM에 상주해야 한다. 그래서 대배치 환경에서는 FP8 가중치 + NVFP4 KV 캐시 조합이 사실상 필수다.
Llama 4 Scout가 라우팅으로 연산량을 줄였다면, Qwen3는 응답 길이 자체를 조절한다.
- Qwen3 (235B-A22B 및 Dense 라인업):
- 단일 체크포인트 내부에 듀얼 모드 토글을 내장했다. 심층 추론을 수행하는 Thinking 모드와 즉각 응답을 반환하는 Non-Thinking 모드다.
- 앞서 4.3절에서 구성한 System One(
Jev) 컨트롤 플레인과 결합할 수 있다. 이때 단순 질의는 Non-Thinking 모드 + DFlash $K=6$ 추측 디코딩으로 처리한다. 고난도 수리 추론만 Thinking 모드로 분기하면 평균 TPOT과 토큰 소모량을 동시에 줄일 수 있다.
핵심 요약 — EXAONE 4.0은 3:1 하이브리드 어텐션·NoPE·QK-Reorder-Norm으로 KV 캐시를 줄인다. Llama 4 Scout는 Early Fusion MoE·iRoPE로 컨텍스트를 늘린다. Qwen3는 듀얼 모드로 응답 길이를 조절한다. 세 모델의 프로파일이 다르므로 양자화 정밀도와 추측 디코딩도 모델 구조에 맞춰 결합해야 한다.
6. 엔지니어링 한계와 트레이드오프
추측 디코딩을 켠 뒤 트래픽이 몰리는 시간대에 처리량이 오히려 떨어졌다는 알람이 온다. 성능 기법이 한가한 조건에서만 유효했다는 뜻이다.
앞의 기법들을 프로덕션에 그대로 붙이면 예상 밖의 지점에서 발목이 잡힌다. 아래 다섯 가지는 실제 통합 과정에서 반드시 설계에 반영해야 하는 한계다. 각 항목은 언제 그 기법을 끄거나 조정해야 하는지를 알려준다.
여유 연산력을 빌려 쓰는 기법은 비어 있는 회의실을 빌려 쓰는 일과 같다. 회의실이 다 찼는데도 같은 방식을 고집하면 예약만 늘고 회의는 진행되지 않는다.
- 대배치 고부하 구간에서의 추측 디코딩 처리량 역전점 (Speculative Batch Crossover):
- 추측 디코딩은 유휴 상태인 텐서 코어의 여분 연산력을 사용하는 기법이다. 그 여력으로 $K$개의 후보 토큰을 병렬 검증한다. 따라서 활성 배치 크기 $B$가 이미 32~64를 넘어 GPU가 완전한 연산 바운드(Compute-bound) 상태에 도달하면 상황이 달라진다. 검증 모델이 $B \times (K+1)$개의 토큰을 계산하느라 소모하는 추가 FLOPs가 그대로 지연 시간으로 전가된다. 클러스터 부하가 임계치를 넘으면 추측 디코딩을 동적으로 비활성화(
draft_k = 0)해야 한다. 그래야 전체 시스템 처리량이 보호된다.
- 추측 디코딩은 유휴 상태인 텐서 코어의 여분 연산력을 사용하는 기법이다. 그 여력으로 $K$개의 후보 토큰을 병렬 검증한다. 따라서 활성 배치 크기 $B$가 이미 32~64를 넘어 GPU가 완전한 연산 바운드(Compute-bound) 상태에 도달하면 상황이 달라진다. 검증 모델이 $B \times (K+1)$개의 토큰을 계산하느라 소모하는 추가 FLOPs가 그대로 지연 시간으로 전가된다. 클러스터 부하가 임계치를 넘으면 추측 디코딩을 동적으로 비활성화(
- 양자화 캘리브레이션 데이터셋 편향 (Calibration Dataset Bias):
nvidia-modelopt로 FP8이나 NVFP4 스케일 팩터를 산출할 때 영문 일반 코퍼스만 쓰면 편향이 생긴다. 한국어 고유 어미, 도메인 특화 JSON 스키마, 다국어 코드 토큰이 입력되면 특정 활성화 채널에서 클리핑(Clipping) 오차가 커진다. 따라서 실제 프로덕션 트래픽 분포를 반영한 다국어·멀티모달 샘플로forward_loop캘리브레이션을 수행해야 한다.
- VLM 시각 토큰 생략(SPD-MLLM) 시 미세 OCR 좌표 오차와 수락률 하락:
- SPD-MLLM에서 초안 단계의 시각 토큰을 생략하면 수락률 $\alpha$가 구간에 따라 갈린다. 일반 서술문에서는 0.75 이상이 유지된다. 반면 바운딩 박스 좌표(
[x1, y1, x2, y2])나 일련번호를 연속 출력하는 구간에서는 $\alpha$가 0.25 이하로 급락한다. 초안 모델이 시각 정보를 보지 못하기 때문이다. 검증 모델이 최종 출력을 교정하므로 무손실성은 유지된다. 다만 잦은 거부(Rejection)로 추측 디코딩의 속도 이득은 사라진다.
- SPD-MLLM에서 초안 단계의 시각 토큰을 생략하면 수락률 $\alpha$가 구간에 따라 갈린다. 일반 서술문에서는 0.75 이상이 유지된다. 반면 바운딩 박스 좌표(
여기까지가 성능과 정확도에 관한 한계다. 나머지 두 항목은 운영 규칙과 하드웨어 세대에 관한 것이다.
- System One(Jev) 신뢰도 임계값의 홀드아웃 보정(Holdout Calibration) 필수성: 임계값은 고정 상수로 둘 수 없다.
- 4.3절의 라우팅 코드에서 사용한
prob >= 0.85같은 값이 예다. 도메인별 홀드아웃(Held-out) 데이터셋에서 정밀도-재현율(Precision-Recall) 곡선을 실측해야 한다. 그리고 클러스터 SLA에 맞는 임계값을 주기적으로 재보정해야 한다.
- 4.3절의 라우팅 코드에서 사용한
- 타입 안정성(Type Safety)과 판정 무오류성(Infallibility)의 분리 및 하드웨어 세대 제약: 두 개념은 분리해서 봐야 한다.
- System One은
Choice,Score,Noul로 타입 안전 응답을 보장한다. 스키마 오류율 0%를 보장하는 수준이다. 그러나 그것이 모델의 판단 자체가 항상 참(Truth)임을 의미하지는 않는다. 하드웨어 제약도 남는다. NVFP4 네이티브 텐서 코어 가속은 NVIDIA Blackwell(B200) 아키텍처에서 온전히 지원된다. Hopper(H100/H200) 세대에서는 FP8(W8A8)을 주력으로 삼아야 한다. NVFP4는 KV 캐시 압축이나 Humming W4A16 커널 위주로 제한 적용한다.
- System One은
핵심 요약 — 추측 디코딩과 저정밀 양자화는 만능이 아니다. 대배치 연산 포화 시의 검증 오버헤드와 VLM 수치 구간에서의 초안 수락률 급락을 먼저 따져야 한다. 홀드아웃 데이터셋 기반 임계값 보정도 필요하다. 마지막으로 GPU 세대별(Hopper vs Blackwell) 하드웨어 지원 범위를 함께 고려해야 한다.
References
-
ingu627.github.io: 대규모 언어 모델(LLM) 서빙을 위한 경량화 아키텍처: 양자화·프루닝·증류의 엔지니어링 트레이드오프 (2025). /llm/quantization1/ ↩ ↩2
-
ingu627.github.io: LLM 추론 라우팅과 요청 캐스케이딩: 지능형 트래픽 제어로 지연 시간과 서빙 비용 최적화하기 (2026). /llm/inference-routing-cascading/ ↩
-
ingu627.github.io: 커스텀 모델 서빙 파이프라인: QLoRA 파인튜닝부터 Multi-LoRA 동적 어댑터 배포까지 (2026). /llm/custom-model-serving-pipeline/ ↩
-
Hyunseok Jung (
ingu627): Ollama Quantized Open-Weight Model Hub (15,293 Pulls) & Technical Portfolio (2026). https://ollama.com/ingu627 / /portfolio/ ↩ ↩2 -
Spheron Network Engineering Report: LLM Serving Throughput vs. Latency Trade-offs on NVIDIA H100 GPUs (2026.10). https://www.spheron.network ↩
-
NVIDIA Developer Technical Blog & GitHub: NVIDIA Model Optimizer (
nvidia-modeloptv0.21.1) & TensorRT-LLM v0.15 Quantization Benchmarks on H200 (2025.12–2026). https://github.com/NVIDIA/Model-Optimizer ↩ ↩2 -
Lin et al.: AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration (MLSys 2024). arXiv:2306.00978 ↩
-
NVIDIA Research: Nemotron-3-Nano-30B-A3B Compression via Pruning, Two-Stage Knowledge Distillation, and FP8 Quantization (2026). https://developer.nvidia.com/blog ↩ ↩2
-
Leviathan et al.: Fast Inference from Transformers via Speculative Decoding (ICML 2023). arXiv:2211.17192 ↩
-
Li et al. & vLLM Project: EAGLE-3: Scaling up Inference Acceleration of Large Language Models via Training-Time Test & vLLM Speculators v0.5.0 Release (2026.05.28). https://github.com/vllm-project/speculators ↩ ↩2
-
Preprints Survey: Multimodal Speculative Decoding for Vision-Language Models: SPD-MLLM and Hierarchical Speculative Decoding (HSD) (Preprints 202603.2344, 2026). https://www.preprints.org/manuscript/202603.2344 ↩
-
TypeSafe AI Official Documentation: System One (
POST /v1/systemone) & Jev Question Design Guide (2026). https://docs.typesafe.ai ↩
댓글남기기