
MySQL 문법 및 예제 정리 - UNION, UNION ALL, join
SQL에서 UNION과 UNION ALL은 두 개 이상의 SELECT 결과를 하나로 결합하는 연산자다. 둘은 유사하지만 중복 처리와 성능에서 중요한 차이가 있으며, 이 차이를 모르면 코테와 실무 양쪽에서 버그와 성능 저하를 유발한다. 이 글에서는 차이점, 문법, 실전 예제를 정리한다.
UNION 과 UNION ALL 에 대한 정리 및 설명
1. UNION
UNION연산자는 두 개 이상의 SELECT 쿼리 결과를 결합하고, 중복된 행을 제거해 반환한다.-
즉, 중복을 제거한 유니크한 결과만 반환한다.
- 특징:
- 중복 제거: 결과에서 중복된 행을 제거한다.
- 정렬 수행: 중복을 제거하기 위해 내부적으로 정렬 또는 해시 기반 중복 제거 단계를 거치므로, 결과 집합이 크면 상대적으로 더 많은 리소스를 사용한다1.
- 컬럼 수와 타입 일치: 결합하는 모든 쿼리의 컬럼 수와 데이터 타입이 동일해야 한다.
- 문법:
SELECT column_name(s) FROM table1
UNION
SELECT column_name(s) FROM table2;
- 예제: 두 테이블에서 서로 다른 고객 목록을 결합하기
# `Customers_Online`과 `Customers_Offline` 테이블에서 중복되는 고객을 제거해 유일한 고객 목록을 반환한다.
SELECT customer_id, customer_name FROM Customers_Online
UNION
SELECT customer_id, customer_name FROM Customers_Offline;
2. UNION ALL
UNION ALL연산자는 두 개 이상의 SELECT 쿼리 결과를 결합하며, 중복된 행을 제거하지 않고 모두 반환한다. 따라서 중복된 데이터도 그대로 출력된다.- 특징:
- 중복 허용: 중복된 행도 그대로 반환한다.
- 성능: 중복 제거 단계가 생략되므로 일반적으로
UNION보다 빠르다. 실제 차이는 데이터 양·중복률·인덱스 유무에 따라 달라지므로 특정 배수로 단정할 수 없다. - 컬럼 수와 타입 일치: 결합하는 모든 쿼리의 컬럼 수와 데이터 타입이 동일해야 한다.
- 문법:
SELECT column_name(s) FROM table1
UNION ALL
SELECT column_name(s) FROM table2;
- 예제: 두 테이블에서 중복을 허용하여 고객 목록 결합하기
# `Customers_Online`과 `Customers_Offline` 테이블의 고객 목록을 중복된 행까지 포함해 모두 반환한다.
SELECT customer_id, customer_name FROM Customers_Online
UNION ALL
SELECT customer_id, customer_name FROM Customers_Offline;
3. UNION UNION ALL의 차이점
| 특징 | UNION | UNION ALL |
|---|---|---|
| 중복된 행 | 중복된 행을 제거 | 중복된 행을 제거하지 않음 |
| 성능 | 중복 제거를 위해 더 많은 리소스 사용 | 중복 제거를 하지 않으므로 더 빠름 |
| 정렬 작업 | 중복을 제거하기 위해 정렬이 필요함 | 정렬 작업이 필요하지 않음 |
| 사용 목적 | 중복 없는 결과를 원할 때 사용 | 모든 데이터를 그대로 출력할 때 사용 |
4. 사용 시 주의사항
- 컬럼 수와 데이터 타입:
UNION또는UNION ALL을 사용할 때, 결합하는 쿼리의 컬럼 수와 데이터 타입이 동일해야 한다.- 각 컬럼의 순서도 동일해야 한다. 예를 들어 첫 번째 컬럼이 숫자 타입이면, 두 번째 쿼리의 첫 번째 컬럼도 숫자 타입이어야 한다.
UNION의 중복 제거는 값과 타입(콜레이션)을 기준으로 하므로, 콜레이션이 대소문자를 구분하지 않으면'a'와'A'가 같은 행으로 취급되어 하나만 남는다1.
- 성능 차이:
UNION ALL은 중복을 제거하지 않으므로 일반적으로 더 빠르다.UNION은 중복 제거를 위한 정렬 또는 해시 작업이 추가로 필요해 더 많은 리소스를 쓴다. 데이터 양이 많을수록 두 연산자의 차이가 커진다.- 성능 비교는 엔진 버전·데이터 분포·인덱스에 좌우되므로 특정 배수로 단정하지 말고, 실행 계획(
EXPLAIN)으로 실제 처리 방식을 확인하는 편이 안전하다.
- 중복 처리 여부:
UNION은 중복된 데이터를 제거해 반환하므로, 결과에서 중복을 원치 않을 때 유용하다.- 반대로, 모든 데이터를 반환하고자 할 때는
UNION ALL을 사용하는 것이 적합하다. ORDER BY는 결합된 전체 결과의 맨 끝에 한 번만 지정할 수 있고, 개별SELECT에는 붙일 수 없다1.
JOIN
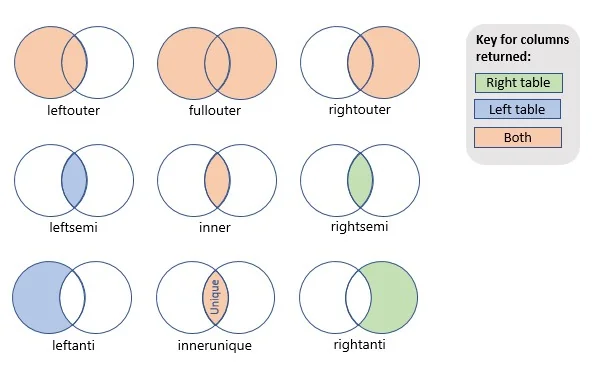
출처: Microsoft Learn — Kusto 쿼리 언어 join 연산자 문서 (https://learn.microsoft.com/en-us/kusto/query/join-operator). 표기는 Kusto 기준이며 inner=INNER JOIN, leftouter=LEFT OUTER JOIN, rightouter=RIGHT OUTER JOIN, fullouter=FULL OUTER JOIN, innerunique는 Kusto의 중복 제거 기본값에 대응한다.
JOIN 유형 선택 가이드:
────────────────────────────────────────────────────────────
 양쪽 테이블 모두 일치하는 행만       ──> INNER JOIN
 왼쪽 전체 + 일치 행 (없으면 NULL)    ──> LEFT JOIN
 오른쪽 전체 + 일치 행 (없으면 NULL)  ──> RIGHT JOIN
 양쪽 전체 (미일치 포함)              ──> FULL OUTER (MySQL은 UNION으로 에뮬레이션)
 모든 행 조합 (데카르트 곱)           ──> CROSS JOIN
 같은 테이블을 자기 자신과 결합       ──> SELF JOIN
────────────────────────────────────────────────────────────
CROSS JOIN
- CROSS JOIN은 한쪽 테이블의 모든 행을 다른 쪽 테이블의 모든 행과 짝지어 출력한다. 결과 행 수는 두 테이블 행 수의 곱이 된다.
- 콤마(
,)로 두 테이블을 이어 쓰는 것도 같은 동작이며,WHERE로 결합 조건을 걸지 않으면 CROSS JOIN과 동일한 결과가 나온다.
-- cross join
SELECT *
    FROM EMP
    CROSS JOIN DEPT;

-- ,로 연결
SELECT *
    FROM EMP, DEPT;
1. 집계 함수와 JOIN의 조합
- 서브쿼리에서 부서별 최대 급여를 구한 뒤, 이를 JOIN해 해당 급여를 받는 직원을 찾는다.
# 예제: 부서별로 가장 높은 급여를 받는 직원 찾기
SELECT e.employee_name, e.salary, e.department_id
FROM employees e
JOIN (
    SELECT department_id, MAX(salary) AS max_salary
    FROM employees
    GROUP BY department_id
) AS dept_max
ON e.department_id = dept_max.department_id AND e.salary = dept_max.max_salary;
2. SELF JOIN 활용
- 자기 자신과의 JOIN을 통해 같은 부서에 속하지만 자신은 아닌 다른 직원들을 조회할 수 있다.
# 예제: 직원 테이블에서 같은 부서에 속한 직원을 찾기
SELECT e1.employee_name AS employee, e2.employee_name AS colleague
FROM employees e1
JOIN employees e2
ON e1.department_id = e2.department_id
WHERE e1.employee_id <> e2.employee_id;
3. EXISTS 서브쿼리와 JOIN의 결합
EXISTS는 서브쿼리가 행을 하나라도 반환하면TRUE로 평가된다. 따라서 직원이 있는 부서만 결과에 남는다.
# 예제: 부서에 직원이 존재하는 부서만 조회하기
SELECT d.department_name
FROM departments d
WHERE EXISTS (
    SELECT 1
    FROM employees e
    WHERE e.department_id = d.department_id
);
WHERE vs ON vs HAVING
| 절 | 적용 시점 | 목적 |
|---|---|---|
WHERE |
조인/그룹화 이전 | 개별 행 단위 필터링 |
ON |
조인 시점 | 테이블 간 결합 조건 지정 |
HAVING |
그룹화 이후 | 집계(그룹) 결과에 대한 조건 |
1. WHERE 절
- 목적: 개별 행을 필터링한다.
- 적용 시점: 테이블에서 데이터를 조인하기 전에 각 행에 조건을 적용한다.
- 사용 위치: 일반적으로
SELECT,UPDATE,DELETE문에서 사용한다. - 예시:
# 주문 날짜가 2024년 1월 1일 이후인 행만 선택한다.
SELECT *
FROM Orders
WHERE order_date > '2024-01-01';
2. ON 절
- 목적: 테이블 간의 조인 조건을 지정한다.
- 적용 시점: 두 테이블을 조인할 때 조건을 적용한다.
- 사용 위치:
JOIN문과 함께 사용한다. - 예시:
# `Orders`와 `Customers` 테이블을 고객 ID를 기준으로 결합한다.
SELECT *
FROM Orders O
JOIN Customers C
ON O.customer_id = C.customer_id;
ON 절의 조건은 테이블을 결합하는 시점에 평가된다. INNER JOIN이라면 조건에 맞는 행만 결과에 남고, 맞지 않는 행은 제외된다. 반면 LEFT/RIGHT OUTER JOIN이라면 매칭되지 않은 쪽의 컬럼이 NULL로 채워지고, 기준이 되는 테이블의 행은 그대로 유지된다. 즉 “조건이 맞지 않으면 NULL“이라는 동작은 OUTER JOIN에 해당하고, INNER JOIN에는 적용되지 않는다.
3. HAVING 절
- 목적: 그룹화된 데이터를 필터링한다.
- 적용 시점: 그룹화 및 집계된 후 조건을 적용한다.
- 사용 위치:
GROUP BY문 뒤에 사용한다. - 예시:
# 고객별로 주문 금액을 합산한 뒤, 그 합계가 1000을 초과하는 그룹만 선택한다. SELECT customer_id, SUM(order_amount) AS total_spent FROM Orders GROUP BY customer_id HAVING total_spent > 1000; -
세 절의 비교 요약
절 주요 목적 적용 시점 사용 위치 WHERE개별 행 필터링 조인 전 또는 그룹화 전 SELECT,UPDATE,DELETEON테이블 간의 조인 조건 지정 조인 시점 JOINHAVING그룹화된 데이터 필터링 그룹화 및 집계 후 GROUP BY뒤
한계와 트레이드오프
- 성능은 조건에 따라 달라진다:
UNION ALL이 항상 빠르다고 단정할 수는 없다. 중복 제거 비용은 결과 집합 크기와 중복률에 비례하고,UNION ALL이 만든 중복을 애플리케이션에서 다시 제거하면 총비용이 오히려 커질 수 있다. UNION의 중복 판정은 값·타입·콜레이션에 의존한다: 콜레이션이 대소문자나 후행 공백을 무시하면 서로 다른 문자열이 같은 행으로 취급되어 결과에서 하나만 남는다1.- MySQL은
FULL OUTER JOIN을 지원하지 않는다: LEFT/RIGHT JOIN 결과를UNION으로 합쳐 에뮬레이션해야 하며, 이때UNION ALL을 쓰면 중복 제거를 별도로 처리해야 한다2. ORDER BY위치 제약: 결합된 결과 전체에 대해서만 정렬할 수 있고, 개별SELECT별 정렬은 지원되지 않는다1.- 실행 계획 확인 권장: 위 차이는 엔진 버전과 데이터 분포에 따라 달라지므로 특정 수치로 단정하지 말고,
EXPLAIN으로 실제 처리 방식을 확인하는 편이 안전하다.
댓글남기기