
대규모 언어 모델(LLM) 서빙을 위한 경량화 아키텍처: 양자화·프루닝·증류의 엔지니어링 트레이드오프
대규모 언어 모델(LLM)을 프로덕션 환경에 배포할 때 가장 먼저 마주하는 장벽은 연산량(FLOPs) 자체가 아니라 GPU 메모리 용량(VRAM)과 메모리 대역폭(Memory Bandwidth)이다. 수십억~수천억 파라미터에 달하는 모델 가중치를 VRAM에 적재하고, 오토리그레시브(Auto-regressive) 디코딩 과정에서 매 토큰마다 수십 기가바이트의 텐서를 HBM(High Bandwidth Memory)에서 SRAM으로 로드하는 과정은 전형적인 메모리 대역폭 바운드(Memory Bandwidth Bound) 문제를 유발한다.
모델 경량화(Model Compression)는 단순히 모델 크기를 줄여 저장 공간을 아끼는 기술이 아니다. 서빙 엔진의 MFU(Model FLOPs Utilization)를 극대화하고, 토큰 생성 지연시간(TTFT, Time-to-First-Token 및 TPOT, Time-per-Output-Token)을 단축하며, 동시 처리 가능한 요청 수(Throughput)를 확장하기 위한 핵심 시스템 최적화 파이프라인이다. 이 글에서는 대표적인 경량화 축인 양자화(Quantization), 프루닝(Pruning), 지식 증류(Knowledge Distillation), 저랭크 적응(LoRA)의 수학적 원리와 실제 서빙 아키텍처에서의 엔지니어링 트레이드오프를 분석한다.
1. LLM 서빙의 물리적 병목: Compute-bound vs. Memory-bound
LLM 추론 파이프라인은 성격이 상이한 두 단계로 나뉜다.
- 프리필(Prefill) 단계: 사용자 프롬프트 전체를 한 번에 인코딩하는 단계로, 행렬-행렬 곱셈(GEMM, General Matrix Multiply)이 주를 이룬다. 산술 강도(Arithmetic Intensity, FLOPs/Byte)가 높아 GPU의 텐서 코어를 완전히 활용하는 Compute-bound 영역이다.
- 디코딩(Decoding) 단계: 이전 토큰들을 기반으로 다음 토큰을 하나씩 순차 생성하는 오토리그레시브 단계다. 단일 토큰 생성을 위해 모델 전체 가중치를 매번 메모리에서 읽어와야 하므로, 행렬-벡터 곱셈(GEMV) 형태를 띤다. 산술 강도가 극도로 낮아 연산 유닛이 가중치 메모리 전송을 기다리는 Memory-bound 영역이다.
추론 단계별 특성 비교:
┌─────────────────┬─────────────────────────────┬─────────────────────────────┐
│ 구분            │ 프리필 (Prefill)            │ 디코딩 (Decoding)           │
├─────────────────┼─────────────────────────────┼─────────────────────────────┤
│ 주 연산         │ GEMM (행렬-행렬 곱)         │ GEMV (행렬-벡터 곱)         │
│ 병목 요인       │ 연산 처리량 (TFLOPs)        │ 메모리 대역폭 (TB/s)        │
│ 지연 시간 지표  │ TTFT (Time to First Token)  │ TPOT (Time per Output Token)│
│ 주 해결 기법    │ 병렬 처리, FP8 Tensor Core  │ 가중치 양자화 (INT4/INT8)   │
└─────────────────┴─────────────────────────────┴─────────────────────────────┘
단일 70B 모델(FP16 기준 약 140GB 가중치)에서 배치 사이즈가 작을 때, 초당 1개 토큰을 생성하려면 140GB의 메모리 전송이 필요하다. NVIDIA H100의 메모리 대역폭(3.35TB/s)을 고려해도 단일 스트림에서의 생성 속도에는 물리적 한계가 존재한다. 따라서 가중치 비트 수를 낮추는 것은 단순히 VRAM 점유를 줄이는 것을 넘어, 메모리 버스 전송 병목을 직접 해소하여 TPOT을 가속하는 결정적인 방법이 된다.
2. 양자화(Quantization): 정밀도 압축과 오차 제어
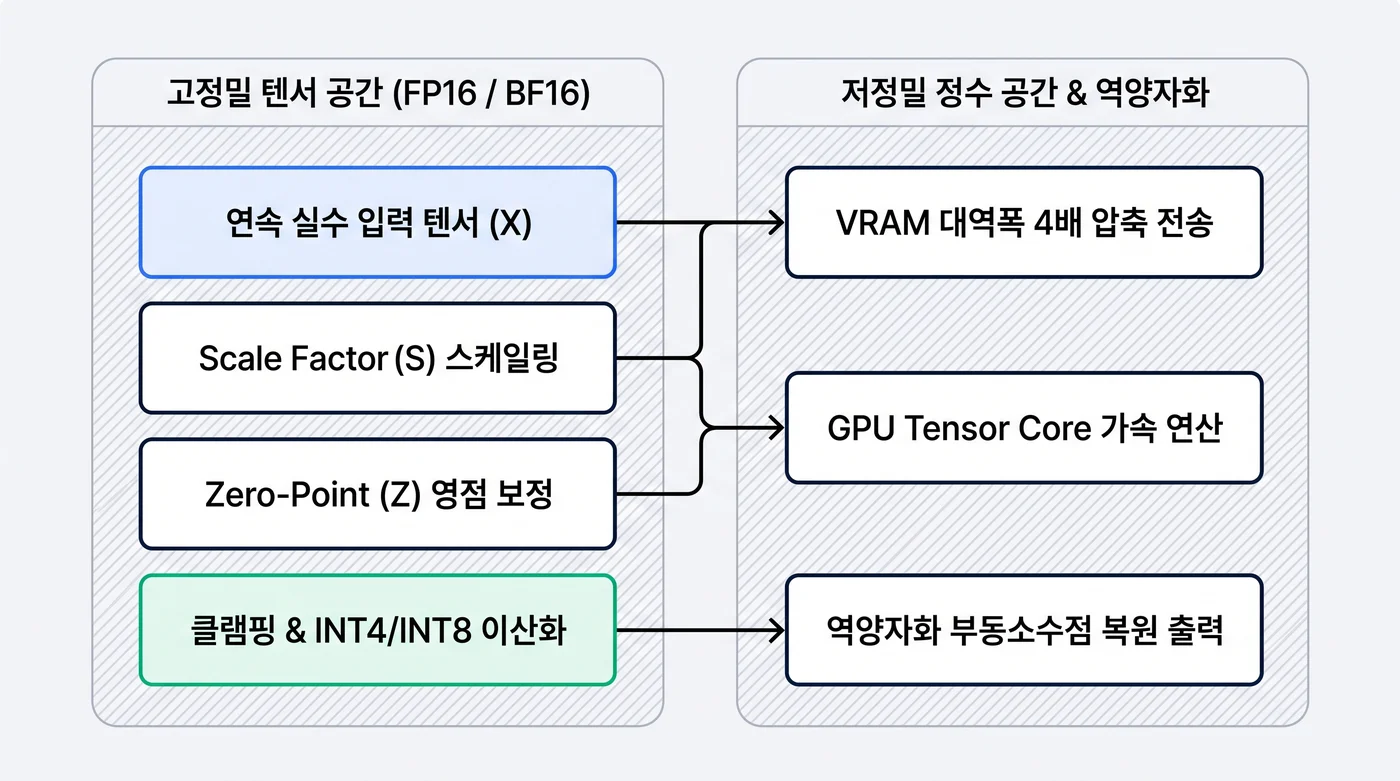
양자화는 고정밀 부동소수점(FP32, FP16, BF16)으로 표현된 텐서를 더 적은 비트의 정수(INT8, INT4)나 저정밀 부동소수점(FP8, FP4)으로 사상하는 기법이다.
2.1 수학적 정식화와 매핑 함수
연속적인 실수 범위 $[a, b]$의 텐서 $x$를 $b$-비트 정수 공간으로 사상하는 기본 수식은 다음과 같다.
\[q = \text{clamp}\left( \left\lfloor \frac{x}{S} \right\rceil + Z, -2^{b-1}, 2^{b-1}-1 \right)\]여기서 $S$(Scale Factor)는 실수 간격을 정수 단위로 환산하는 스케일 파라미터이며, $Z$(Zero-Point)는 실수의 0이 사상되는 정수 값이다. 역양자화(Dequantization)는 다음과 같이 수행된다.
\[\hat{x} = S \times (q - Z)\]- 대칭 양자화(Symmetric Quantization): 실수 범위를 $[-x_{\max}, x_{\max}]$로 설정하여 $Z = 0$으로 고정한다. 연산 시 영점 보상 오버헤드가 없어 하드웨어 구현이 단순하고 빠르다.
- 비대칭 양자화(Asymmetric Quantization): 텐서의 실제 최소값과 최대값 $[\min(x), \max(x)]$을 사용하므로 표현 범위의 낭비가 적지만, 추론 시 $Z$를 고려한 추가 감산 연산이 발생한다.
- 그루핑 단위: 텐서 전체에 단일 $S$를 적용하는 Per-tensor 방식은 극단값(Outlier)에 취약하다. 실무에서는 채널 단위(Per-channel) 또는 $g=64, 128$ 단위의 가중치 블록마다 독립적인 스케일을 부여하는 Group-wise 방식을 채택하여 양자화 잡음(Quantization Noise)을 억제한다.
2.2 Activation Outlier 문제와 PTQ 알고리즘
가중치만 양자화하는 Weight-Only Quantization(W4A16, W8A16)은 메모리 대역폭을 줄여 디코딩 속도를 높이지만, 연산 직전 FP16으로 역양자화되므로 텐서 코어 자체의 연산 가속은 누리지 못한다. 반면 가중치와 활성화 값 모두를 양자화하는 Weight-Activation Quantization(W8A8)은 INT8 텐서 코어를 직접 활용할 수 있으나, LLM 특유의 활성화 이상치(Activation Outlier) 문제에 직면한다.
LLM의 크기가 6.7B 이상으로 커지면 은닉 상태(Hidden States)의 특정 채널에서 다른 채널 대비 최대 100배 이상의 거대한 크기를 가진 활성화 이상치가 일관되게 발생한다. 이 이상치를 일반적인 방식으로 INT8 양자화하면 대부분의 정상 채널 정보가 0으로 뭉개지며 퍼플렉시티(Perplexity)가 치명적으로 폭증한다.
이를 극복하기 위해 제안된 현대적 PTQ(Post-Training Quantization) 전략들은 다음과 같다.
현대 PTQ 핵심 알고리즘 비교:
┌─────────────────┬─────────────────────────────────────────────────────────────────────────────┐
│ 알고리즘        │ 핵심 메커니즘 및 특징                                                      │
├─────────────────┼─────────────────────────────────────────────────────────────────────────────┤
│ SmoothQuant     │ 활성화 채널의 이상치 크기를 수학적 동치 변환을 통해 가중치로 이전 (W8A8 달성)│
│                 │ W' = diag(s) · W,  X' = X · diag(s)⁻¹ (가중치는 채널별 분산이 적어 흡수 용이)│
├─────────────────┼─────────────────────────────────────────────────────────────────────────────┤
│ GPTQ            │ 2차 테일러 전개(Hessian 역행렬 H⁻¹) 기반 순차적 가중치 업데이트 (W4A16 주력) │
│                 │ 한 가중치를 INT4로 반올림할 때 발생하는 오차를 남은 가중치들에 보상 반영   │
├─────────────────┼─────────────────────────────────────────────────────────────────────────────┤
│ AWQ             │ 모든 가중치가 동등하지 않다는 점에 착안, 활성화 텐서 절대값이 큰 상위 1%     │
│                 │ Salient Weight를 식별하여 가중치 채널별 보호 스케일링 적용 (W4A16 고성능)    │
└─────────────────┴─────────────────────────────────────────────────────────────────────────────┘
2.3 FP8 (E4M3 vs. E5M2)의 급부상
NVIDIA Ada Lovelace 및 Hopper, Blackwell 아키텍처부터 네이티브 FP8 연산 유닛이 탑재되면서, 정수 양자화(INT8) 일변도에서 부동소수점 양자화(FP8)로 생태계가 급격히 재편되었다.
- E4M3 (1 Sign, 4 Exponent, 3 Mantissa): 표현 범위는 좁지만($\pm 448$) 정밀도가 높아, 주로 이상치가 통제된 순전파 연산 및 가중치/활성화 양자화에 채택된다.
- E5M2 (1 Sign, 5 Exponent, 2 Mantissa): FP16과 동일한 지수 비트를 공유하여 표현 범위가 넓으므로($\pm 57344$), 그라디언트 및 역전파 단계와 동적 범위가 큰 어텐션 연산에 적합하다.
FP8은 복잡한 캘리브레이션이나 가중치 재조정 없이도 FP16 대비 99% 이상의 정확도를 유지하면서 서빙 처리량을 2배 이상 끌어올릴 수 있어, vLLM과 TensorRT-LLM의 현대 프로덕션 표준으로 정착했다.
3. 프루닝(Pruning): 구조적 vs. 비구조적 희소성
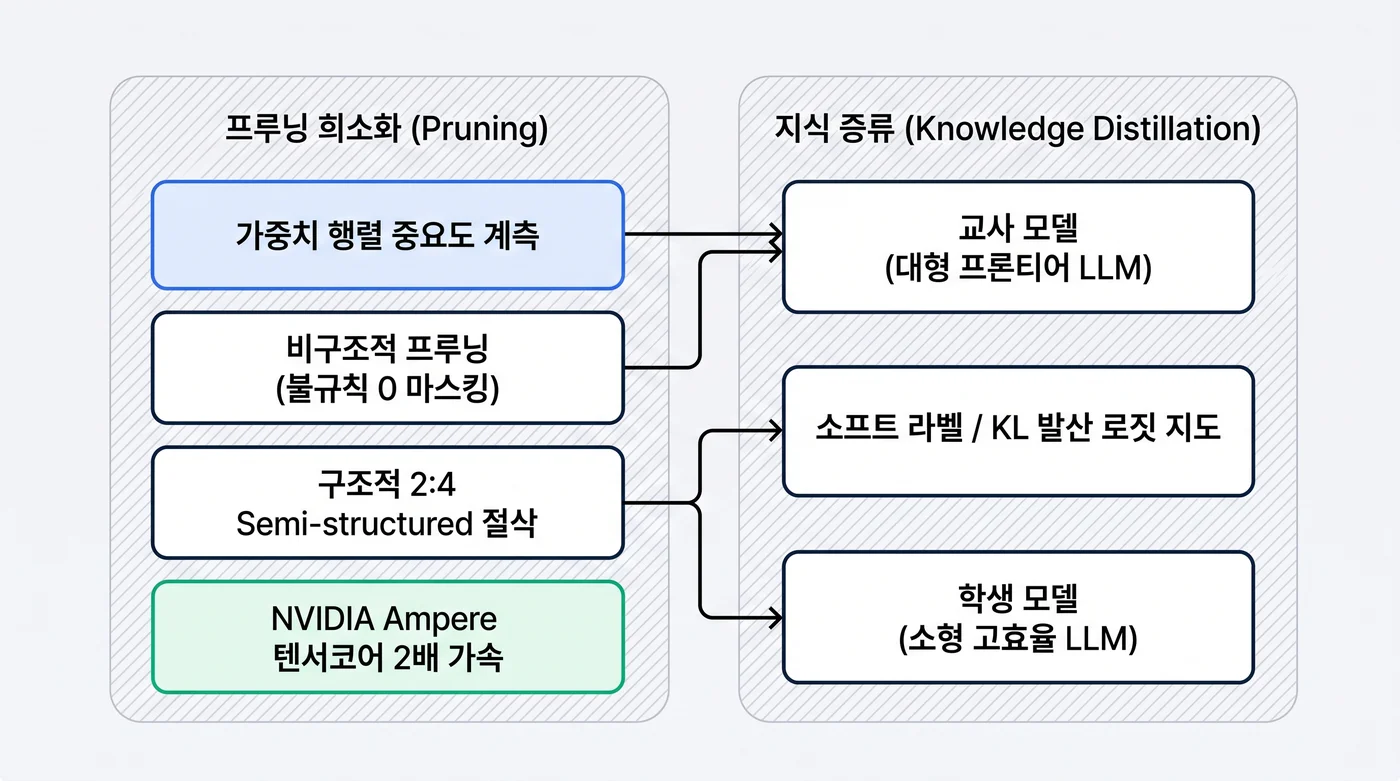
프루닝은 파라미터 값 자체를 0으로 마스킹하거나 모델 레이어/헤드를 물리적으로 절삭하여 희소성(Sparsity)을 부여하는 기법이다.
3.1 비구조적 희소성(Unstructured Sparsity)의 하드웨어 한계
가중치 행렬에서 절대값이 작은 요소를 개별적으로 0으로 만드는 방식이다. 이론적인 압축률은 매우 높고(50~80% 가중치 제거 후에도 성능 복원 가능), 알고리즘적으로 단순하다.
그러나 GPU 하드웨어 관점에서 비구조적 희소 행렬은 치명적인 결함을 갖는다. 0이 불규칙하게 분포된 행렬을 연산하려면 CSR(Compressed Sparse Row)과 같은 인덱스 포인터 구조를 사용해야 하며, 이는 메모리 연속 접근(Coalesced Memory Access)을 파괴하고 분기 워프(Warp Divergence)를 유발한다. 결과적으로 50%의 가중치를 0으로 날려도 연산 속도는 전혀 빨라지지 않거나 오히려 느려진다.
3.2 구조적 희소성(Structured Sparsity)과 2:4 Sparse Tensor Core
하드웨어 친화적 프루닝을 위해 두 가지 방향이 실무에서 활용된다.
- NVIDIA 2:4 Semi-structured Sparsity:
- 연속된 4개의 값 중 정확히 2개를 0으로 만드는 패턴이다.
- NVIDIA Ampere 이후 텐서 코어는 이 메타데이터를 직접 해석하여 연산 처리량을 물리적으로 2배 가속한다.
- 단, 모델 훈련 단계 또는 정밀한 재학습(Sparse Fine-tuning) 없이는 초기 정확도 손실이 발생할 수 있다.
- 블록 및 레이어 단위 절삭 (Block/Layer Pruning):
- 어텐션 헤드, FFN 중간 차원, 또는 연속된 트랜스포머 블록 전체를 제거한다.
- 최근 연구인 SliceGPT나 BlockPruner는 레이어 간 코사인 유사도와 입력 신호의 주성분 분석(PCA)을 통해 중복도가 높은 트랜스포머 계층을 선별하고, 재학습 없이도 파라미터의 20~30%를 영구 삭제하여 순수 지연시간을 단축한다.
4. 지식 증류(Knowledge Distillation)와 저랭크 적응(LoRA)
4.1 지식 증류: 확률 분포 모방과 손실 함수 설계
대규모 교사 모델(Teacher) $T$의 풍부한 표현력을 경량화된 학생 모델(Student) $S$로 전달하는 기법이다.
전통적인 분류 문제에서는 로짓(Logit) 벡터 간의 쿨백-라이블러 발산(KLD, Kullback-Leibler Divergence)을 최소화하는 방식을 썼으나, 수만 개 이상의 어휘(Vocabulary)를 다루는 LLM 생성 환경에서는 다음과 같은 문제에 직면한다.
\[\mathcal{L}_{\text{KD}} = \alpha \mathcal{L}_{\text{CE}}(y, S(x)) + (1 - \alpha) T^2 \cdot D_{\text{KL}}\left( \sigma\left(\frac{T(x)}{T_{\text{temp}}}\right) \parallel \sigma\left(\frac{S(x)}{T_{\text{temp}}}\right) \right)\]- Forward KLD의 과대평가 편향: 순방향 KLD는 교사 모델이 낮은 확률을 부여한 영역에서 학생 모델이 확률을 부여할 때 매우 큰 페널티를 부과하므로, 생성 모델의 어휘 다양성이 무너질 위험이 있다.
- Reverse KLD (Mode-seeking): 생성형 LLM에서는 교사 모델의 주요 모드(High-probability mode)를 정확히 추종하도록 유도하는 Reverse KLD나 온-폴리시(On-policy) 강화학습 기반의 시퀀스 레벨 증류(MiniLLM, Sequence-level KD)가 훨씬 우수한 생성 일관성을 보인다.
4.2 LoRA와 QLoRA의 메모리 효율 파인튜닝
가중치 업데이트 행렬 $\Delta W$를 두 개의 저랭크 행렬의 곱으로 분해한다.
\[W = W_0 + \Delta W = W_0 + \frac{\alpha}{r} (B \times A), \quad B \in \mathbb{R}^{d \times r}, A \in \mathbb{R}^{r \times k} \quad (r \ll \min(d, k))\]- QLoRA(Quantized Low-Rank Adaptation):
- 기저 가중치 $W_0$를 정보 이론적으로 균일한 정보량을 갖도록 설계된 NF4(NormalFloat 4) 데이터 타입으로 4비트 양자화한다.
- 양자화 상수(Scale) 자체를 다시 8비트 FP로 압축하는 이중 양자화(Double Quantization)를 적용하여 파라미터당 0.37비트의 오버헤드를 추가 절감한다.
- 활성화 피크 시 GPU OOM을 방지하기 위해 CPU-GPU 간 페이징을 지원하는 Paged Optimizer를 결합하여, 단일 48GB GPU에서 70B 모델의 미세 조정을 가능하게 만들었다.
5. 프로덕션 서빙 아키텍처와 트레이드오프 매트릭스
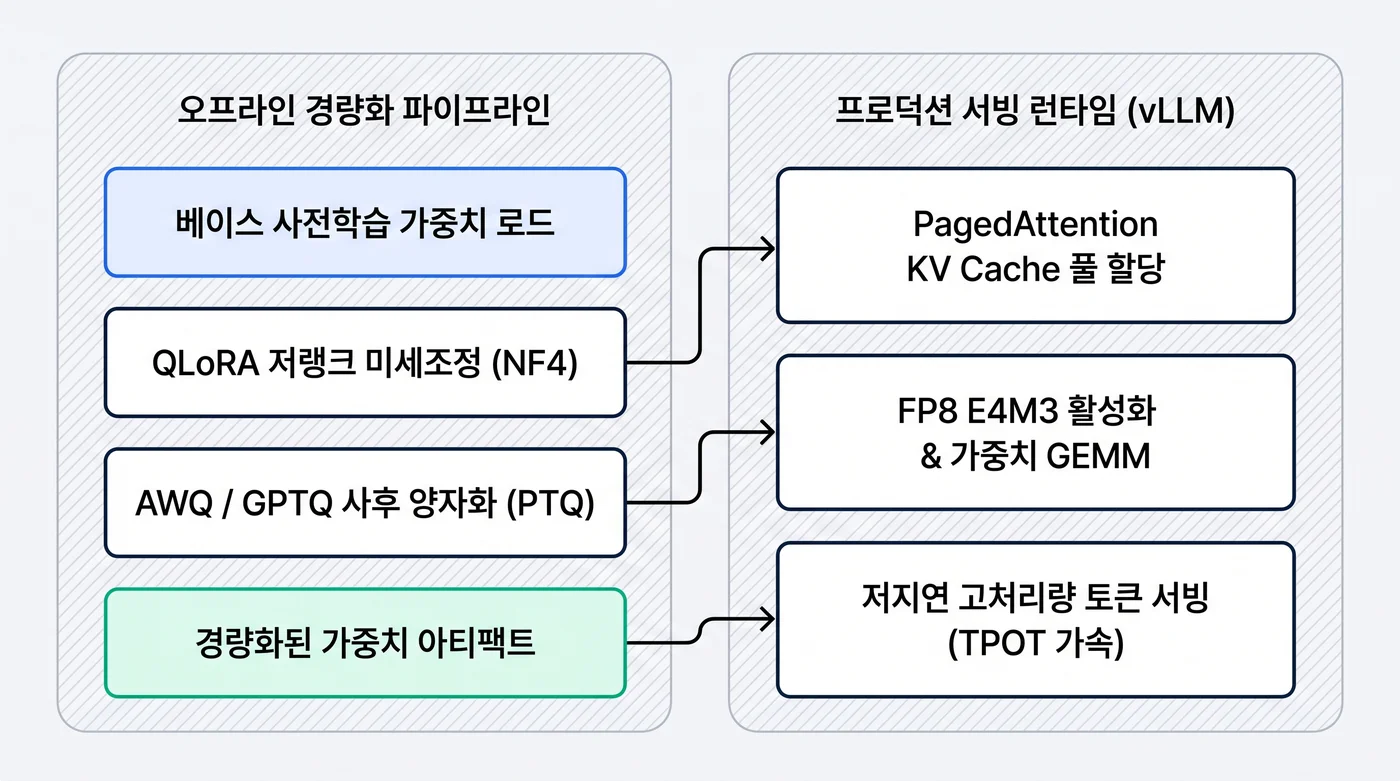
경량화 기법은 개별적으로 적용되는 단편적 트릭이 아니라, 타깃 인프라와 서비스 지연시간 요구사항에 맞춰 조합되는 엔지니어링 파이프라인이다.
경량화 기법별 프로덕션 서빙 트레이드오프 매트릭스:
┌─────────────────┬───────────┬──────────────┬──────────────┬──────────────┬────────────────────────────┐
│ 기법            │ 정밀도    │ 메모리 절감  │ Throughput   │ 정확도 보존  │ 권장 프로덕션 시나리오     │
├─────────────────┼───────────┼──────────────┼──────────────┼──────────────┼────────────────────────────┤
│ FP8 (E4M3)      │ FP8       │ ~50%         │ 1.8x ~ 2.2x  │ 99%+         │ H100/L40S 기반 범용 고성능 │
│ AWQ             │ W4A16     │ ~70%         │ 1.5x ~ 2.0x  │ 97% ~ 99%    │ 배치 사이즈 작고 VRAM 제약 │
│ GPTQ            │ W4A16     │ ~70%         │ 1.4x ~ 1.8x  │ 96% ~ 98%    │ 오픈소스 모델 대량 서빙    │
│ SmoothQuant     │ W8A8      │ ~50%         │ 1.6x ~ 2.0x  │ 98%+         │ INT8 텐서코어 가속 최적화  │
│ 2:4 Sparsity    │ FP16/INT8 │ ~50% (연산)  │ 1.3x ~ 1.6x  │ 95% ~ 98%    │ 사전 훈련/정밀 재학습 인프라│
│ QLoRA 서빙      │ W4 + r16  │ 가중치 공유  │ 다중 테넌트  │ 100% (LoRA)  │ 단일 인스턴스 멀티 어댑터  │
└─────────────────┴───────────┴──────────────┴──────────────┴──────────────┴────────────────────────────┘
5.1 서빙 프레임워크와의 통합 전략
- vLLM 및 PagedAttention 결합:
- 가중치를 AWQ나 FP8로 줄이면 남는 VRAM 공간이 고스란히 KV Cache 풀(Pool)로 전환된다.
- KV Cache 풀이 커지면 최대 동시 처리 가능한 배치 크기(Continuous Batching Concurrency)가 비례하여 증가하므로, 서빙 시스템 전체의 처리량(Throughput)이 극대화된다.
- KV Cache 자체의 양자화(FP8 / INT8 KV Cache):
- 가중치 경량화 후에는 긴 컨텍스트(32K~128K) 처리 시 KV Cache가 전체 VRAM 점유의 70% 이상을 차지하게 된다.
- FP8 E4M3 또는 Per-head INT8 방식으로 KV Cache를 압축하면 동일 GPU에서 동시 처리 가능한 컨텍스트 길이를 2배로 확장할 수 있다.
6. 결론: 워크플로우 설계 원칙
LLM 경량화의 핵심은 “무조건 가장 작은 비트로 압축하는 것”이 아니라, 서비스의 트래픽 프로파일에 맞는 병목 지점을 해소하는 것이다.
- 실시간 응답(Low Latency, Low Batch): 메모리 대역폭이 주 병목이므로 W4A16(AWQ) 또는 FP8 가중치 압축을 통해 토큰당 HBM 전송 시간을 최소화한다.
- 고처리량 배치 서빙(High Throughput, Large Concurrency): 연산 유닛 가속과 KV Cache 풀 확보가 핵심이므로 W8A8(SmoothQuant) 또는 네이티브 FP8 GEMM과 FP8 KV Cache 조합을 최우선으로 고려한다.
- 도메인 특화 경량화: 거대 모델의 능력을 소형 모델로 이전해야 하는 경우, 무리한 4비트 이하 극단 양자화 대신 시퀀스 레벨 지식 증류 + QLoRA를 선행한 후 FP8로 서빙하는 복합 파이프라인이 산업계의 표준 모범 사례로 확립되어 있다.
댓글남기기