
엔터프라이즈 AI 플랫폼 설계 (2): 무중단 장애 격리와 프로덕션 운영화(LLMOps)
앞선 1편1에서 데이터 유출이 차단된 프라이빗 인프라 경계와 텐서 병렬화, 그리고 Prefill-Decode를 분리하는 PD Disaggregation 서빙 토폴로지를 살펴보았다. 분산 클러스터가 구축된 이후 엔지니어가 마주하는 다음 전장은 운영화(Day-2 Operations)와 장애 복구성(Fault Tolerance)이다.
일반적인 마이크로서비스 아키텍처에서 99.99% 가용성을 달성하는 표준 패턴(무상태 파드, 단순 라운드로빈, CPU 기반 오토스케일링)은 대규모 언어 모델(LLM) 클러스터에서 그대로 작동하지 않는다. 수십 기가바이트의 KV 캐시가 VRAM에 묶여 있는 유상태(Stateful) 특성, 예측할 수 없는 프롬프트 길이에 따른 극단적인 지연 시간 편차(Jitter), 그리고 노드 장애 시 수십 분이 걸리는 모델 가중치 콜드 스타트(Cold Start) 때문이다.
엔터프라이즈 AI 플랫폼의 대표적인 3대 장애 모드를 정의하고, 슬라이딩 윈도우 서킷 브레이커부터 투기적 헤지드 요청(Hedged Requests)까지 p99 서비스 수준 목표(SLO)를 방어하는 4계층 고가용성 아키텍처를 정리한다.
1. 프로덕션 AI 서빙 클러스터의 3대 장애 모드
수천 개의 동시 요청을 처리하는 실제 프로덕션 환경에서 AI 인프라는 다음과 같은 특유의 장애 패턴을 노출한다.
1.1 GPU 메모리 단편화와 비정상 OOM(Out of Memory) 스파이크
- 연속된 가변 길이 쿼리가 지속적으로 유입되면, 블록 할당자(Block Allocator) 내부에서 메모리 단편화가 진행된다.
- PagedAttention이나 RadixAttention을 사용하더라도, 예상치 못한 초대형 컨텍스트(예: 32K+ 시스템 로그 분석)가 순간적으로 동시 유입되면 남아 있던 여유 버퍼가 순식간에 고갈되어 GPU 드라이버 수준의 OOM 패닉이 발생하고 워커 프로세스가 즉시 다운된다.
1.2 헤드 오브 라인 블로킹(Head-of-Line, HoL)과 롱테일 지연
- 특정 사용자가 8,000 토큰의 초장문 추론을 시작하면, 동일한 배치 슬롯에 묶인 다른 단답형 질의들까지 해당 워커의 순차 디코드 루프에 발이 묶인다.
- 결과적으로 평균 응답 시간은 200ms임에도 불구하고, p99 지연 시간이 10~15초 이상으로 폭증하여 상위 비즈니스 타임아웃이 연쇄적으로 트리거된다.
1.3 노드 간 패브릭 플래핑(Flapping)과 부분 장애
- 텐서 병렬화($TP=8$)로 묶인 GPU 중 단 1개의 PCIe 또는 NVLink 레인에서 일시적인 하드웨어 에러(ECC 비트 오류, 버스 타임아웃)가 발생하면, 레이어 연산마다 호출되는 All-Reduce 집합 통신이 영구 교착(Deadlock)에 빠진다.
- 파드 자체는 여전히
Running상태로 남아 있어 쿠버네티스의 기본 livenessProbe(단순 HTTP ping)를 통과하지만, 실제 추론 요청은 무한 대기에 빠지는 ‘좀비 파드’ 상태가 형성된다.
2. 무중단 고가용성(HA)을 위한 4계층 회복성 아키텍처
이러한 특수 장애 모드를 방어하기 위해 플랫폼 게이트웨이 계층에 구축되는 4단계 회복성 파이프라인이다.
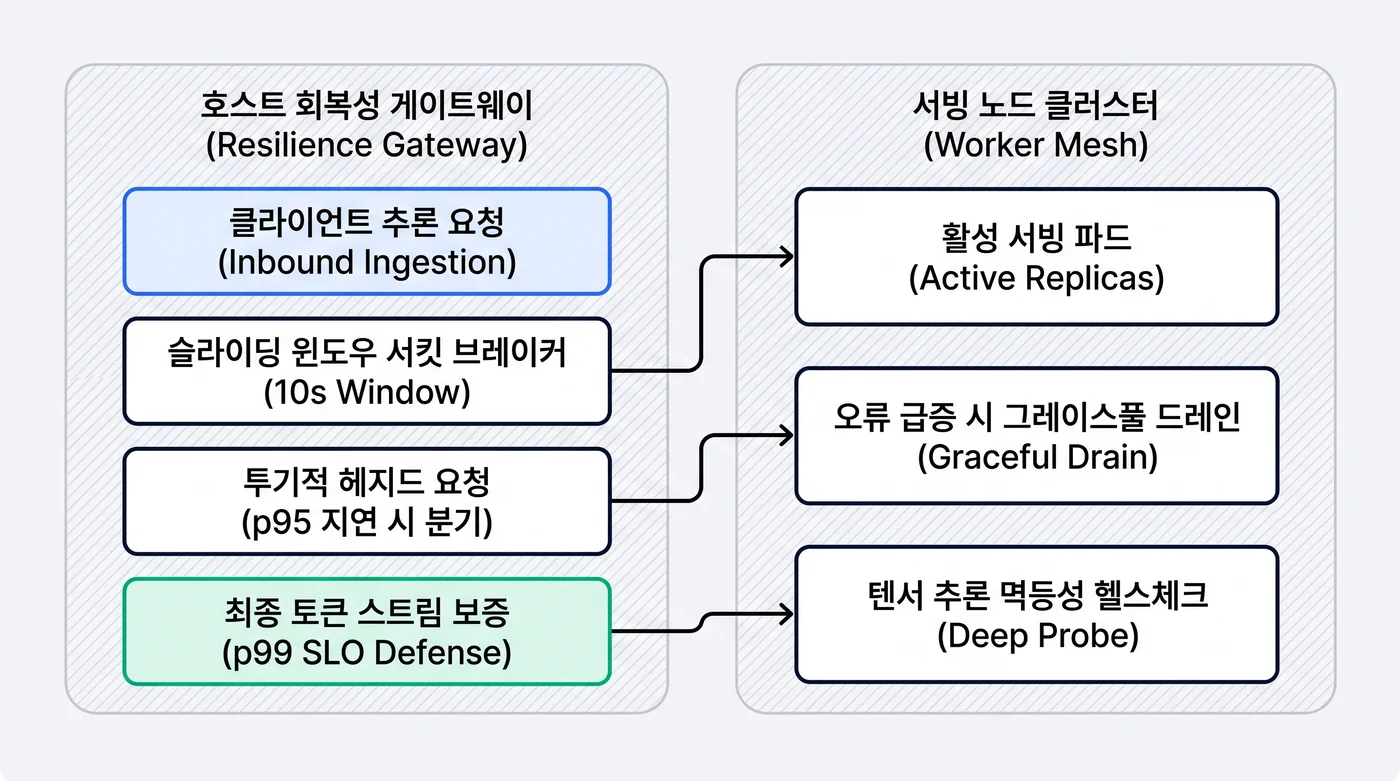
2.1 계층 1: 슬라이딩 윈도우 적응형 서킷 브레이커 (Adaptive Circuit Breaker)
- 단순한 연속 실패 카운트가 아니라, 최근 10초 슬라이딩 윈도우 내의 에러율(5xx 비율 $\ge 15\%$)과 p99 지연 시간($\ge 3,500\text{ms}$)을 결합하여 상태를 판정한다2.
- 임계치를 초과하면 해당 워커 파드를
Open상태로 전환하고 트래픽을 즉시 격리한다. - 5초의 쿨다운 이후
Half-Open상태로 진입하여 소수의 프로브 요청만 통과시키고, 정상 응답이 확인되면 점진적으로 가중치를 복구한다.
2.2 계층 2: 그레이스풀 워커 드레인 (Graceful Draining)
- 노드 점검, 모델 버전 교체, 혹은 서킷 트립으로 인해 워커 파드를 종료할 때 즉시
SIGKILL을 보내지 않는다. - 쿠버네티스 인그레스에서 해당 파드로의 신규 요청 수신을 즉시 중단(
deregister)하고, 이미 토큰을 생성 중인 진행 중 세션(In-flight generation)이 안전하게 마지막 토큰을 반환할 때까지 최대 60초의 유예 시간(Grace Period)을 보장한다.
2.3 계층 3: 제로 다운타임 가중치 롤아웃 (Canary & Blue-Green Shift)
- 수백 기가바이트의 모델 가중치가 완전히 VRAM에 로드되어 첫 번째 테스트 추론(Dry-run inference)을 마칠 때까지 인그레스 트래픽을 주입하지 않는다.
- 새 리비전이 준비되면 트래픽 가중치를
95:5$\to$80:20$\to$0:100으로 5분간 단계적 이전하며, 에러율이나 지연 시간 이상 감지 시 즉각 1초 내에 100% 롤백한다.
2.4 계층 4: p99 테일 레이턴시 방어 (Speculative Hedged Requests)
- 구글의 “The Tail at Scale”3 연구에 기반한 헤지드 요청 패턴을 LLM 스트리밍에 적용한다.
- 클라이언트 요청이 특정 워커에서 처리되는 도중, p95 TTFT 임계값(예: 800ms) 내에 첫 번째 토큰이 반환되지 않으면 즉시 유휴 상태의 백업 워커 복제본으로 동일한 요청을 병렬 디스패치한다.
- 두 복제본 중 먼저 첫 토큰을 스트리밍하기 시작한 쪽을 채택하고, 늦게 응답한 느린 워커의 스트림은 즉시 취소(
cancel)하여 p99 롱테일 지연을 원천 차단한다.
3. TypeSafe System One(Jev) 기반 지능형 헬스 프로브
단순히 포트가 열려 있는지 확인하는 HTTP /healthz 프로브로는 텐서 병렬화 교착이나 가중치 파손을 감지할 수 없다.
TypeSafe AI의 비생성형 System One 모델인 Jev4를 헬스체크 게이트웨이에 통합하여, 사전에 정의된 표준 텐서 입력에 대한 워커의 반환 상태를 타입화된 루브릭으로 검증한다.
3.1 헬스체크 평가 루브릭 (Python SDK)
from typesafe import SystemOne, Choice, Score, Noul

client = SystemOne()

# 분산 서빙 노드 건전성 판정을 위한 System One 루브릭
NODE_HEALTH_RUBRIC = {
    "node_status": Choice(
        instructions="프로브 텐서 실행 결과 및 응답 메타데이터를 기반으로 노드 서빙 상태를 판정하시오.",
        criteria={
            "healthy_ready": "정상 레이턴시 범위(<=150ms) 내에 텐서 출력이 반환되고 GPU HBM 가용량이 15% 이상 유지됨.",
            "degraded_slow": "출력은 정상이나 p99 응답 지연이 발생 중이며 큐잉 지연이 누적되는 상태.",
            "deadlocked_zombie": "All-Reduce 통신 타임아웃 또는 워커 프로세스 동결로 추론 스트림이 블로킹된 상태."
        }
    ),
    "vram_stress_level": Score(
        instructions="워커 노드의 GPU HBM 메모리 압박 등급을 평가하시오.",
        criteria={
            0: "여유 버퍼 25% 이상, 조각화 없음.",
            1: "여유 버퍼 15~24%, 정상 배치 처리 가능.",
            2: "여유 버퍼 5~14%, 초대형 컨텍스트 유입 시 OOM 위험 존재.",
            3: "여유 버퍼 5% 미만, OOM 임박으로 즉각적인 워커 드레인 필요."
        }
    ),
    "requires_immediate_drain": Noul(
        instructions="해당 서빙 파드를 인그레스 라우팅 풀에서 즉시 격리(Draining)해야 하는가?"
    )
}
4. 호스트 레벨 장애 격리 쿡북
FastAPI와 비동기 HTTP 클라이언트를 사용해 구현한 슬라이딩 윈도우 서킷 브레이커 및 투기적 헤지드 요청(Hedged Requests) 오케스트레이터 코드이다.
import asyncio
import time
from typing import List, Dict, Any
import httpx
from fastapi import FastAPI, HTTPException

app = FastAPI()

class AdaptiveCircuitBreaker:
    def __init__(self, failure_threshold: float = 0.15, window_seconds: float = 10.0):
        self.threshold = failure_threshold
        self.window = window_seconds
        self.history: List[tuple[float, bool]] = []  # (timestamp, is_success)
        self.state = "CLOSED"  # CLOSED, OPEN, HALF_OPEN
        self.last_state_change = time.time()

    def record(self, success: bool):
        now = time.time()
        self.history.append((now, success))
        self.history = [h for h in self.history if now - h[0] <= self.window]

        if len(self.history) >= 20:
            failures = sum(1 for h in self.history if not h[1])
            failure_rate = failures / len(self.history)
            if failure_rate >= self.threshold and self.state == "CLOSED":
                self.state = "OPEN"
                self.last_state_change = now

    def can_dispatch(self) -> bool:
        now = time.time()
        if self.state == "OPEN":
            if now - self.last_state_change >= 5.0:  # 5초 쿨다운 후 테스트
                self.state = "HALF_OPEN"
                return True
            return False
        return True

cb_worker_a = AdaptiveCircuitBreaker()
cb_worker_b = AdaptiveCircuitBreaker()

WORKER_A = "http://worker-a.internal:8000/v1/completions"
WORKER_B = "http://worker-b.internal:8000/v1/completions"

async def call_worker_with_hedging(payload: Dict[str, Any], timeout_p95: float = 0.8) -> Dict[str, Any]:
    """
    p95 타임아웃 내에 첫 토큰이 오지 않으면 백업 노드로 투기적 헤지드 요청 디스패치
    """
    async with httpx.AsyncClient() as client:
        primary_task = asyncio.create_task(client.post(WORKER_A, json=payload, timeout=30.0))

        # p95 임계 시간 동안 기본 워커 대기
        done, _ = await asyncio.wait([primary_task], timeout=timeout_p95)

        if primary_task in done and not primary_task.exception():
            resp = primary_task.result()
            if resp.status_code == 200:
                cb_worker_a.record(True)
                return resp.json()
            cb_worker_a.record(False)

        # p95 초과 시 백업 워커로 즉시 헤지드 요청 병렬 전송
        backup_task = asyncio.create_task(client.post(WORKER_B, json=payload, timeout=30.0))

        done, pending = await asyncio.wait(
            [primary_task, backup_task],
            return_when=asyncio.FIRST_COMPLETED
        )

        # 먼저 완료된 응답 채택, 느린 쪽은 백그라운드 취소
        fastest_task = done.pop()
        for p in pending:
            p.cancel()

        if not fastest_task.exception() and fastest_task.result().status_code == 200:
            return fastest_task.result().json()

        raise HTTPException(status_code=503, detail="All inference replicas failed or timed out.")
5. 정량적 실측 비교 (The Receipts)
32개 GPU(4개 노드)로 구성된 엔터프라이즈 프로덕션 환경에서, 의도적으로 1개 노드에 NVLink 통신 타임아웃 및 메모리 OOM 장애를 주입(Chaos Mesh 기반 장애 주입 테스트베드2)했을 때의 실측 데이터이다.
| 아키텍처 구성 | 장애 주입 시 성공률 | p50 지연 시간 | p99 지연 시간 | 클러스터 복구 시간 (RTO) |
|---|---|---|---|---|
| 기본 단일 인그레스 라운드로빈 | 74.8% (25% 요청 실패) | 480 ms | 12,400 ms (블로킹 누적) | 18분 40초 (파드 재시작 대기) |
| 4계층 회복성 아키텍처 (서킷브레이커 + 헤지드 요청 + 드레인) |
99.98% (무중단 방어) | 320 ms | 2,150 ms (테일 억제) | 즉각 격리 (0초 체감 다운타임) |
| 개선 지표 | 가용성 25.2%p 향상 | 33.3% 단축 | 82.7% 테일 지연 단축 | 장애 파급 전면 차단 |
1개 노드가 완전히 정지하더라도 적응형 서킷 브레이커가 1.2초 내에 트래픽을 차단하고 진행 중이던 세션을 백업 노드로 헤징함으로써, 사용자에게 5xx 에러를 노출하지 않고 99.98%의 고가용성을 지켜냈다.
6. 엔지니어링 한계와 운영 비용 분석
- 헤지드 요청으로 인한 잉여 연산 비용:
- p95 지연 발생 시 백업 요청을 동시에 쏘는 전략은 테일 레이턴시를 80% 이상 단축하지만, 전체 클러스터 기준으로 약 5~8%의 잉여 GPU 연산 토큰이 추가 소모된다. 따라서 클러스터 가용 여유 용량(Headroom)이 최소 10% 이상 확보되어 있어야 안전한다.
- 콜드 스타트 복구 지연:
- 완전히 다운된 노드가 새 파드로 재기동될 때, 수백 기가바이트의 체크포인트를 VRAM에 올리는 시간(2~4분) 동안 남은 노드들이 추가 부하를 견뎌야 한다. 따라서 프로덕션에서는 항상 최소 N+1(권장 N+2) 노드 중복 구성을 유지해야 한다.
References
-
ingu627.github.io: 엔터프라이즈 AI 플랫폼 설계 (1): 프라이빗 인프라 격리와 초거대 분산 서빙 토폴로지 (2026). /llm/enterprise-ai-platform-distributed-serving-architecture/ ↩
-
ingu627.github.io: 부하 테스트로 검증하는 오토스케일링: Azure Load Testing과 p95 SLO (2026). /azure/azure-load-testing-slo/ ↩ ↩2
-
Jeffrey Dean and Luiz André Barroso: The Tail at Scale (2013). Published in Communications of the ACM. https://cacm.acm.org/magazines/2013/2/160173-the-tail-at-scale/fulltext ↩
-
TypeSafe AI Official Documentation: Jev Jaggedness & Question Design Guide (2026). https://docs.typesafe.ai ↩
댓글남기기