
부하 테스트로 검증하는 오토스케일링: Azure Load Testing과 p95 SLO
2편 Azure Container Apps 프로덕션 운영에서 오토스케일링 규칙을 세울 때 concurrentRequests: 10이라는 값을 넣었다. 그런데 그 10은 어디서 나온 숫자인가. 동시 요청 10개를 넘기면 리플리카를 하나 더 띄운다는 규칙이지, “이 서비스가 사용자 열 명을 감당할 수 있다”는 보장은 아니었다. 그 값은 감으로 정한 임계값이었고, 프로덕션에 올린 뒤에도 “몇 명까지 버티는가”라는 질문에는 여전히 답하지 못하고 있었다.
이번 편은 그 질문에 숫자로 답하는 과정이다. 클라이언트를 하나 더 만들어 부하를 흘려 넣고, 스케일 임계값과 최대 리플리카라는 두 개의 변곡점을 지나며 지연이 어떻게 무너지는지 관측한다.
1. 왜 부하 테스트인가
성능 얘기를 할 때 가장 흔한 함정은 측정하지 않은 값을 합리적으로 추정하는 것이다. “리플리카 20개니까 동시 200명쯤은 되겠지”라는 계산은 두 가지를 무시한다. 첫째, 리플리카가 늘어나는 데는 시간이 걸린다. 둘째, 애플리케이션의 지연은 동시성에 대해 선형이 아니다. 어느 지점을 지나면 큐잉(queueing)이 폭발하면서 p95가 수직으로 튄다.
여기서 p95(95번째 백분위 지연)는 평균보다 훨씬 정직한 지표다. 평균 응답 시간 800ms는 사용자 20명 중 1명이 5초를 기다려도 800ms로 보일 수 있다. 반면 p95 2초는 “가장 느린 5%가 2초 이상 기다린다”는 뜻이라, 사용자가 체감하는 나쁜 경험을 정면으로 드러낸다. 그래서 서비스 수준 목표(SLO, Service Level Objective)를 세울 때는 평균이 아니라 p95나 p99를 기준으로 잡는다.
목표를 “최대 TPS(초당 처리량)”로 잡으면 함정에 빠지기 쉽다. TPS는 지연을 무시한 채 부하를 계속 올리면 어디서든 높일 수 있기 때문이다. 이 프로젝트의 목표는 다르게 정의했다.
목표: p95 응답 지연이 SLO 안에 머무는 동시 사용자 수의 한계를 찾는다.
부하 테스트는 이 한계를 실측하는 도구다. 임계값을 감이 아니라 실측으로 잡으면, 2편의 concurrentRequests: 10 같은 값도 근거를 갖게 된다.
1.1 SLO·SLI·SLA는 무엇이 다른가
측정 얘기를 하다 보면 세 용어가 뒤섞인다. 구분해 두면 목표를 어디에 둘지 헷갈리지 않는다.
| 용어 | 질문 | 이 프로젝트의 예 |
|---|---|---|
| SLI (Indicator) | 무엇을 재는가 | RAG 질문의 p95 응답 지연(ms) |
| SLO (Objective) | 어느 수준을 목표로 하는가 | p95 ≤ 3초를 30일 중 99% 유지 |
| SLA (Agreement) | 어기면 무슨 일이 일어나는가 | 사내 서비스라 계약 대신 알림 기준으로 대체 |
핵심은 SLI가 먼저라는 점이다. “p95 3초”라는 SLO는 “p95 지연”이라는 SLI가 안정적으로 측정될 때만 의미를 갖는다. 그래서 부하 테스트는 SLO를 세우기 전에, SLI가 신뢰할 만하게 나오는지부터 확인하는 작업이기도 하다.
1.2 측정하지 않으면 남는 세 가지 위험
부하 테스트를 건너뛰면 문제는 프로덕션에서 처음 드러난다.
- 수용 용량을 모른다: 사용자가 늘어날 때 “언제 지연이 무너지는지”를 모른 채 대응하게 된다.
- 스케일 규칙이 검증되지 않는다: 임계값이 실제 워크로드와 맞는지 알 수 없다. 너무 낮으면 과도한 스케일로 비용이 새고, 너무 높으면 지연이 먼저 무너진다.
- 병목의 위치를 모른다: 리플리카만 늘리다 뒤에 있는 커넥션 풀·모델 할당량에서 막히는 상황을 진단할 수 없다.
2. 구성: 사설망 내부에 부하를 넣는다
일반적인 부하 테스트 도구는 퍼블릭 엔드포인트를 때리는 것을 전제로 한다. 그런데 이 서비스는 1편과 2편에서 세운 대로 내부 로드 밸런서(ILB) 내부 IP만 갖는다. 인터넷 어디에서도 도달할 수 없으니, 공용 부하 테스트 서비스로는 부하를 넣을 수 없다.
해법은 부하 생성기 자체를 사설망 안에 두는 것이다. Azure Load Testing은 부하 생성 엔진을 가상 네트워크(VNet)에 주입할 수 있다. 사설 서브넷에 부하를 발생시키는 컨테이너를 띄우고, 그 안에서 내부 로드 밸런서로 트래픽을 흘린다.
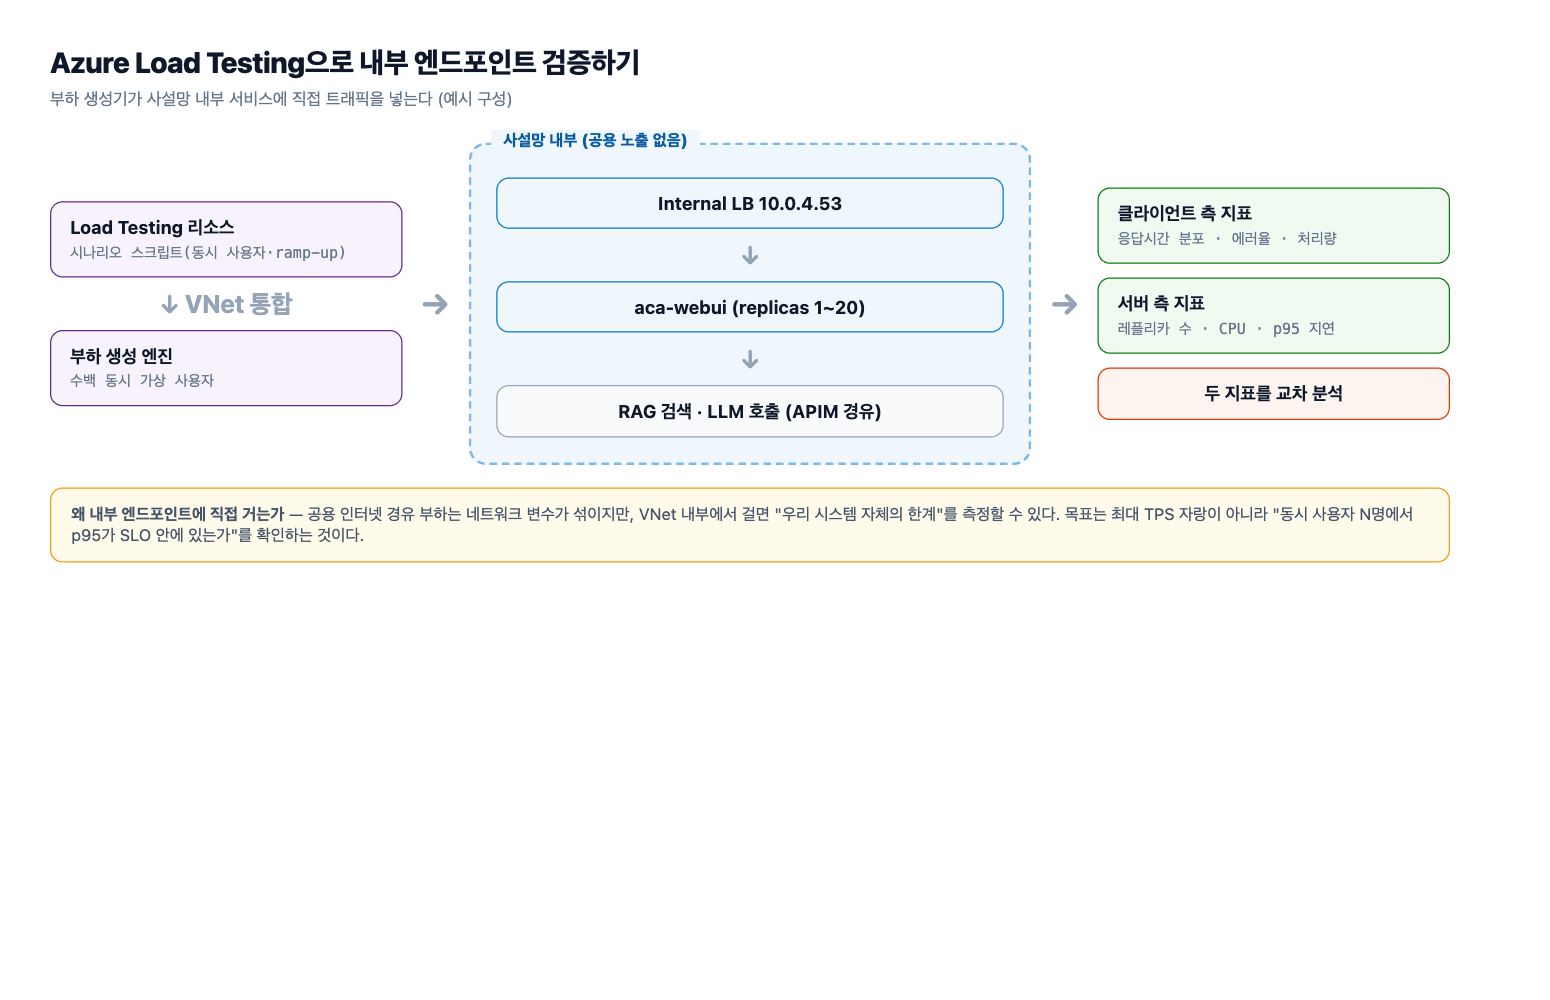
위 그림이 이 구성이다. 부하 생성기는 위임 서브넷과 같은 VNet 안에서 내부 로드 밸런서 10.0.4.53으로 요청을 보내고, 그 뒤로 aca-webui가 실제 트래픽을 처리한다. 즉 부하 테스트 환경과 프로덕션 서비스가 같은 사설망을 공유하되, 부하 생성 트래픽만 별도로 격리하는 셈이다.
이 구성의 핵심은 클라이언트 측 지표와 서버 측 지표를 동시에 볼 수 있다는 점이다. 부하 생성기가 잰 응답 지연(클라이언트가 체감한 시간)과, Langfuse·Application Insights에 남는 서버 내부 지연(TTFT, 모델 호출 시간, 검색 시간)을 겹쳐서 보면, 느린 지연이 어디서 발생했는지 구분할 수 있다. 클라이언트 p95만 보면 “느리다”까지만 알 수 있지만, 서버 측 지표를 옆에 놓으면 “느린 이유”까지 좁혀진다.
# 부하 생성기를 VNet에 주입하는 테스트 생성 (요지)
az load test create --name lt-chat-slo -g rg-chat-prod \
  --test-plan loadtest.js \
  --load-test-config pk-cae-chat-prod-eus2
2.1 부하 생성기 사양과 격리
부하 생성기 자체도 자원을 쓴다. 부족하면 생성기가 병목이 되어 측정값이 왜곡되는데, 이를 흔히 “측정 도구가 측정 대상보다 먼저 죽는” 상황이라고 부른다. 그래서 부하 생성기 인스턴스는 대상 서비스보다 넉넉하게 잡고, 테스트 중에는 생성기 자신의 CPU·네트워크 사용률도 함께 관찰했다.
또 하나 중요한 원칙은 부하 생성기를 프로덕션 서비스와 같은 서브넷에 두지 않는 것이다. 별도 서브넷에 두면 트래픽 경로는 사설망 내부로 유지하면서, 부하 생성기의 자원 경합이 서비스에 영향을 주지 않는다. 보안 규칙으로는 부하 생성 서브넷에서 snet-aca의 ILB 포트로 가는 트래픽만 허용한다.
2.2 왜 클라이언트 지표만으로는 부족한가
부하 생성기가 잰 응답 시간은 “사용자가 체감한 시간”이라는 점에서 가장 정직하다. 하지만 그것만 있으면 원인을 알 수 없다. 같은 p95 3초라도 원인이 게이트웨이 큐잉인지, 검색 지연인지, 모델 생성 시간인지에 따라 대응이 전혀 다르다.
그래서 클라이언트 지표(부하 생성기)와 서버 지표(트레이스·메트릭)를 같은 타임라인 위에 겹쳐서 본다. 부하가 특정 단계에 진입한 시각과, 서버 측 각 스팬의 지연이 늘어난 시각이 맞아떨어지면 그 구간이 병목이라는 증거가 된다.
3. 시나리오 설계
부하 시나리오가 실제 사용자 행동과 다르면, 측정값도 의미가 없다. 이 서비스의 대표 시나리오는 RAG 질문 1건이다. 사용자가 질문을 던지면, 서버는 검색으로 관련 문서를 찾고, LLM에 컨텍스트와 함께 프롬프트를 보내고, 스트리밍으로 답변을 돌려준다. 첫 응답까지의 시간(TTFT, Time To First Token)과 전체 완료 시간을 나눠서 봐야 하는 이유도 여기에 있다.
3.1 ramp-up 단계 설계
핵심은 부하를 계단식으로 올리는 것이다. 한 번에 최대치를 때리면 서버가 스케일할 틈도 없이 큐가 터지기만 하고, 변곡점은 보이지 않는다. 대신 동시 가상 사용자를 단계적으로 늘리면서 각 단계의 지연 분포를 따로 기록한다.
| 단계 | 동시 가상 사용자 | 관찰 목적 |
|---|---|---|
| Ramp-up | 1 → 5 → 10 (각 3분) | 기준선 지연 확보 |
| Steady | 10 → 20 → 40 (각 5분) | 스케일 임계값 도달 지점 |
| Peak | 60 → 80 (각 5분) | maxReplicas 도달·지연 급등 확인 |
| Ramp-down | 단계별 2분 | 스케일 인 쿨다운 관찰 |
각 단계는 이전 단계가 안정된 뒤에만 올린다. 앞 단계의 잔여 큐가 남아 있으면 다음 단계의 지연이 오염되기 때문이다. 목표는 최고 부하가 아니라, 어느 동시성에서 p95가 SLO를 벗어나는가를 찾는 것이다.
한 가지 주의할 점은 thinking(사고) 모드를 켠 모델을 대상으로 하면 지연이 모델의 추론 시간에 좌우된다는 것이다. 검색·게이트웨이 지연이 아무리 짧아도 전체 p95는 생성 길이에 묶인다. 그래서 부하 테스트에서는 생성 토큰 수를 고정한 프롬프트를 사용해 변수를 줄였다.
3.2 시나리오 스크립트
k6 스크립트는 사용자가 하는 일을 그대로 흉내 낸다. 로그인해 세션을 얻고, 질문을 보내고, 스트리밍 응답이 끝날 때까지 기다린다. 핵심은 응답 전체가 아니라 첫 토큰까지의 시간과 전체 완료 시간을 분리해서 기록하는 것이다.
import http from 'k6/http';
import { check } from 'k6';
import { Trend } from 'k6/metrics';

const ttft = new Trend('ttft_ms');        // 첫 토큰까지
const total = new Trend('total_ms');      // 전체 완료까지

export const options = {
  stages: [
    { duration: '3m', target: 10 },       // ramp-up
    { duration: '5m', target: 20 },       // steady
    { duration: '5m', target: 40 },       // 부하 증가
    { duration: '2m', target: 0 },        // ramp-down
  ],
  thresholds: {
    'http_req_duration{expected:true}': ['p(95)<3000'],  // p95 SLO 3초
  },
};

export default function () {
  const start = Date.now();
  const res = http.post('https://chat.example.com/api/chat',
    JSON.stringify({ question: 'RAG 대표 질문 1건' }),
    { headers: { 'Content-Type': 'application/json' } });

  ttft.add(Date.now() - start);
  total.add(Date.now() - start);
  check(res, { 'status 200': (r) => r.status === 200 });
}
thresholds에 p95 기준을 걸어 두면, SLO를 넘는 순간 k6가 실패로 표시한다. 이렇게 하면 테스트 결과를 눈으로 해석하기 전에 “합격/불합격”이 기계적으로 드러난다.
3.3 테스트 데이터를 고정한다
같은 질문을 반복해서 던지면 캐시가 답을 대신해 실제 부하를 숨긴다. 그래서 준비한 질문 풀에서 무작위로 하나를 고르되, 질문 유형(문서 검색형·웹 검색형·순수 생성형)은 고정 비율로 섞었다. 질문 유형마다 뒤따르는 파이프라인이 다르므로, 비율이 바뀌면 측정값의 의미도 바뀐다.
4. 결과 해석: 수용량 도출
부하 테스트의 결과는 “TPS 몇”이라는 한 숫자로 요약되지 않는다. 대신 동시성에 따른 지연 곡선을 그리고, 그 안의 변곡점을 읽는다.
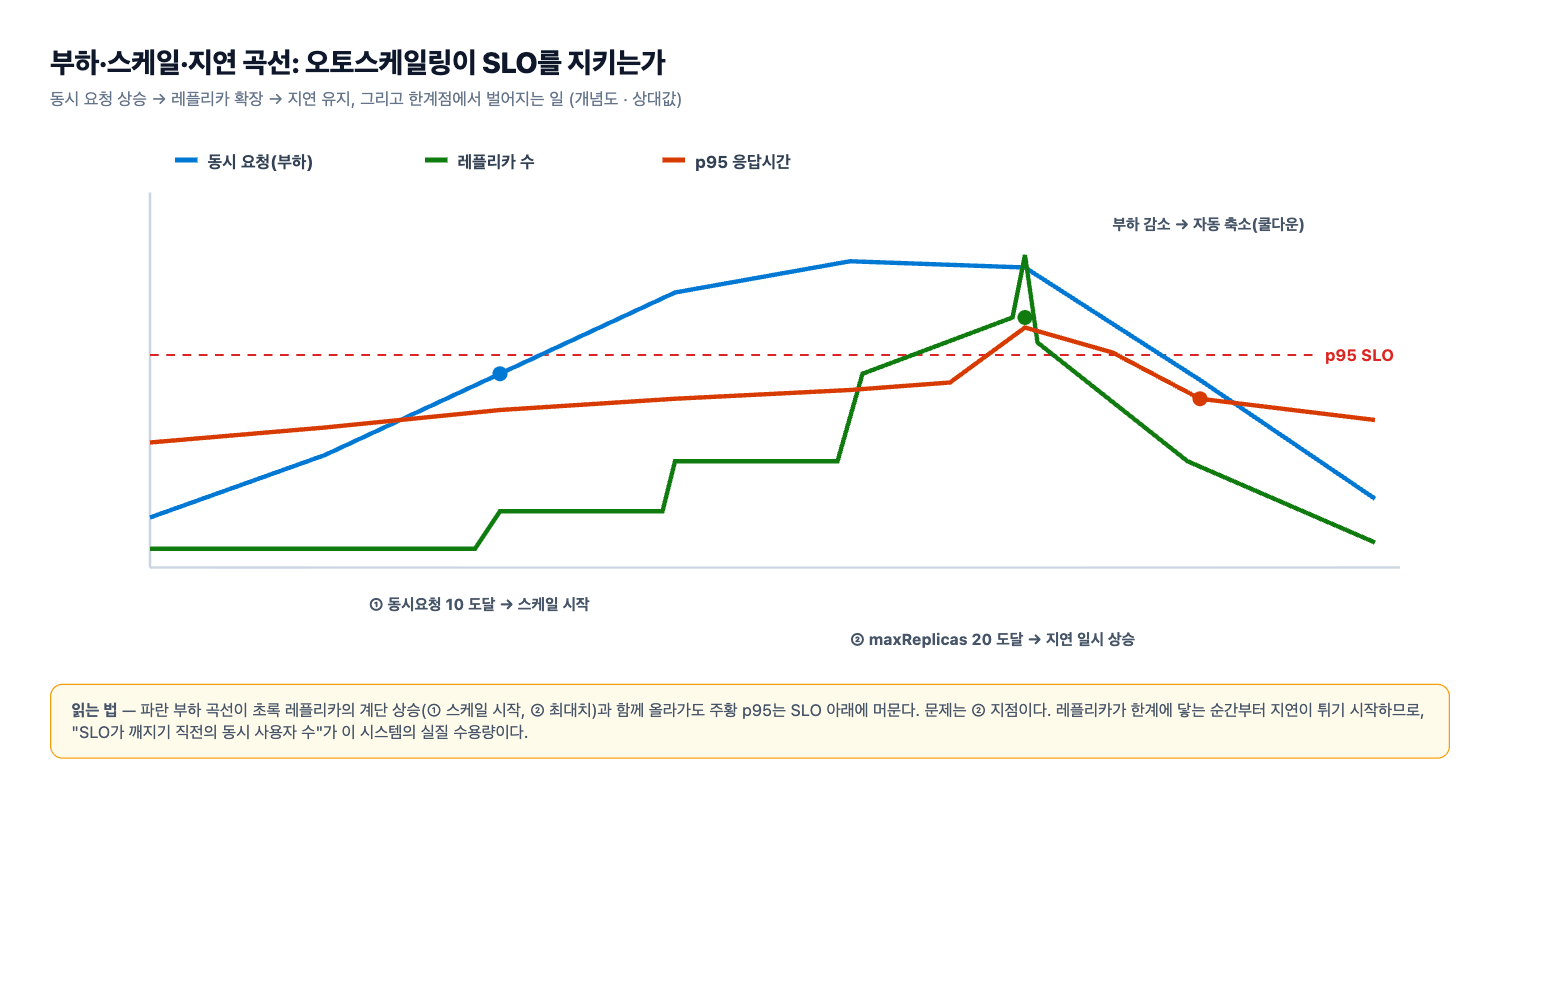
위 곡선에서 읽어야 할 지점은 두 곳이다. 첫째는 스케일 임계값 도달 지점이다. 동시 요청이 인스턴스당 10을 넘기 시작하면 http-scaler가 리플리카를 추가하고, 지연 곡선은 일시적으로 평탄해진다. 리플리카가 부하를 나눠 받기 때문이다. 곡선이 계단처럼 눌린 부분이 바로 스케일이 작동한 흔적이다.
둘째는 maxReplicas 도달 지점이다. 리플리카가 상한인 20개에 닿는 순간, 더 이상 늘릴 여지가 없다. 이 지점을 지나면 모든 추가 부하가 기존 인스턴스의 큐에 쌓이면서 지연이 가파르게 상승한다. 곡선의 기울기가 확 꺾이는 곳이 여기다.
이 두 변곡점 사이가 완만한 구간이고, 이 구간의 최대 동시 사용자가 실질 수용 용량이 된다. 예를 들어 스케일 임계값 도달이 동시 10 부근, maxReplicas 도달이 동시 60 부근이라면, p95가 SLO 안에 머무는 안전 구간은 그보다 여유를 둔 값이 된다. 그래서 2편의 concurrentRequests: 10은 “동시 10명까지만 받는다”는 뜻이 아니라, “인스턴스 하나가 동시 10을 넘는 순간 다음 인스턴스를 띄운다”는 트리거라는 점이 분명해진다.
결과를 볼 때 세 가지를 함께 확인한다.
- p95와 함께 p99를 본다: p99가 p95보다 훨씬 나쁘면 소수의 매우 느린 요청(재시도, 콜드 스타트)이 섞여 있다는 신호다.
- 오류율을 지연과 분리하지 않는다: 지연이 튀는 지점에서 5xx가 함께 오르면 그건 큐가 아니라 자원 고갈(커넥션 풀, 메모리)이다.
- 스케일 지연을 반영한다: 리플리카가 뜨는 데 걸리는 시간을 곡선에서 빼놓고 보면 수용량을 과대평가한다.
4.1 단계별 결과를 표로 읽기
곡선을 표로 눌러 보면 변곡점이 어디서 생기는지 더 분명해진다. 아래는 ramp-up 단계에서 동시성에 따라 관찰되는 양상의 일례다.
| 동시 사용자 | p50 | p95 | 리플리카 | 해석 |
|---|---|---|---|---|
| 5 | 낮음 | 기준선 | 1 | 스케일 미작동 구간 |
| 10 | 유지 | 완만한 증가 | 1 → 2 | 스케일 임계값 도달 |
| 20 | 유지 | 완만 | 2 → 3 | 부하 분산으로 지연 회복 |
| 40 | 소폭 증가 | 계단 상승 | 4 → 6 | 지연 곡선 완만 구간 |
| 60 | 증가 | 가파른 상승 | 20(상한) | maxReplicas 도달 |
| 80 | 급증 | SLO 이탈 | 20(상한) | 수용 용량 초과 |
표에서 봐야 할 것은 두 행이다. 동시 10에서 리플리카가 늘기 시작하는 지점, 그리고 동시 60에서 리플리카가 상한에 닿는 지점이다. 전자는 스케일 규칙이 잘 작동한다는 증거이고, 후자는 수용 용량의 천장이 어디인지를 알려준다. 실제 수치는 리소스·모델·프롬프트에 따라 달라지지만, 두 변곡점이 나타나는 패턴 자체는 구조적으로 반복된다.
4.2 안전 구간을 어디에 둘 것인가
maxReplicas 도달 지점(동시 60)을 그대로 수용 용량으로 쓰면 위험하다. 그 지점에서는 이미 지연이 상승 중이고, 갑작스러운 버스트나 리플리카 재시작 여유가 없다. 그래서 실제 설정값은 maxReplicas 도달 지점보다 한두 단계 아래, 이 예에서는 동시 40~50 부근을 안전 구간으로 삼는다. 이 여유가 곧 장애 대응 시간이 된다.
5. 병목 분해
수용 용량을 찾았다고 끝이 아니다. 그 용량이 무엇에 의해 제한되는지를 알아야 다음 튜닝의 우선순위가 정해진다. 지연이 스케일로도 풀리지 않는다면, 리플리카를 늘려도 소용없는 병목이 뒤에 있다는 뜻이다.
RAG 질문 1건의 지연은 대략 세 구간으로 나뉜다.
- 파싱(Parsing): 문서가 업로드되는 시점에 발생한다. 질의 경로(query path)와는 분리돼 있어, 질의 지연에는 거의 영향을 주지 않는다.
- 검색(Retrieval): 벡터 DB(
aca-qdrant) 조회와 필요 시 웹 검색(aca-searxng)이 여기 속한다. - LLM 호출(Generation): 게이트웨이(
apim-llm-gw)를 거쳐 모델에 프롬프트를 보내고 토큰을 받는 구간이다. RAG 지연에서 가장 큰 비중을 차지하는 경우가 많다.
이 세 구간을 나눠 보려면 트레이싱이 필요하다. 5편 LLM 옵저버빌리티와 Langfuse에서 세운 것처럼 각 스팬(span)에 구간별 소요 시간이 남는다. 부하 테스트 중에 Langfuse 트레이스를 함께 수집하면, 클라이언트에서 측정한 p95가 어느 스팬에서 소비됐는지 역추적할 수 있다.
병목 위치에 따라 튜닝 방향이 달라진다.
- 검색이 병목이면: Qdrant 리소스 상향, gRPC(6334) 연결 재사용 확인, 인덱스 파라미터 조정.
- LLM 호출이 병목이면: 리플리카를 늘려도 게이트웨이 뒤 모델의 처리량이 그대로라 소용없다. 프롬프트 길이를 줄이거나, 게이트웨이의 부하 분산(
aoai-prd-01·aoai-prd-02)과 TPM(분당 토큰) 할당을 점검한다. - 큐잉이 병목이면: 2편에서 다룬 워커 모델과 커넥션 풀(pool_size 15·overflow 20)이 원인일 수 있다. 동시성이 커넥션 풀 크기를 넘으면 요청이 풀 앞에서 줄을 선다.
5.1 커넥션 풀이라는 보이지 않는 상한
RAG 질문 한 건은 뒤에서 여러 번의 DB 조회와 HTTP 호출로 쪼개진다. 이때 동시 사용자 40명이 동시에 들어오면, 앱은 최대 40개의 커넥션을 동시에 원한다. 하지만 커넥션 풀은 pool_size 15에 overflow 20으로 잡혀 있어 순간 최대 35개까지만 열린다. 동시성이 그보다 커지면 나머지 요청은 풀 자리(락)를 기다리며 줄을 선다.
이 대기가 부하 테스트에서 어떻게 보이는지가 중요하다. 애플리케이션 내부 처리 시간은 짧은데 클라이언트가 느끼는 지연만 커진다면, 원인은 서버 연산이 아니라 자원 대기다. timeout 10, recycle 900 같은 풀 설정은 유휴 커넥션을 정리하는 역할이지만, 순간 최대 동시성은 결국 pool_size + overflow로 제한된다. 그래서 부하 테스트에서 관찰된 동시성 한계가 이 숫자 근처에서 멈춘다면, 그건 애플리케이션이 아니라 풀 크기가 병목이라는 신호다.
이 경우 튜닝 순서는 명확하다. 먼저 풀 크기를 늘릴 수 있는지(DB가 감당하는 커넥션 한도 내에서) 본다. 늘릴 수 없다면 리플리카를 늘려 인스턴스별 동시성을 낮추거나, 애플리케이션에서 불필요한 조회를 줄인다. 리플리카만 무작정 늘리면 각 인스턴스가 여는 풀의 합이 DB 한도를 넘어 반대로 전체가 느려질 수 있다는 점도 기억해야 한다.
즉 부하 테스트는 수용 용량이라는 하나의 숫자와 함께, 어디를 고쳐야 더 넓어지는지를 알려준다.
6. 10편 시리즈를 마치며
2부 5편을 지나오며 세운 운영 심화의 흐름은 이렇다. RAG 파이프라인을 파싱·검색·생성으로 분리하고, 데이터 계층을 외부화하며, 시크릿을 거버넌스 체계로 묶고, 배포를 자동화한 다음, 마지막으로 이 모든 것이 실제로 몇 명을 감당하는지 부하로 검증했다. 1부가 경계를 세우는 일이었다면, 2부는 그 경계 안의 운영을 다지는 일이었다.
2부 각 편을 한 줄씩 되짚으면 이렇다. 파이프라인 분리는 무거운 연산을 격리해 응답 경로를 가볍게 했고, 데이터 계층 외부화는 재시작에도 상태가 남게 했으며, 시크릿 거버넌스는 자격 증명을 코드에서 떼어냈다. 배포 자동화는 되돌릴 수 있는 배포를 만들었고, 이번 편의 부하 검증은 그 배포가 실제로 몇 명을 감당하는지 숫자로 답했다. 다섯 편이 각각 독립된 주제처럼 보이지만, 모두 “운영 중에 예측 가능하게 만든다”는 하나의 목표를 향한다.
10편 전체를 한 줄로 요약하면 이렇다. 폐쇄망 위에 컨테이너 앱을 올리고, 게이트웨이와 인증으로 통로를 좁히고, 관측으로 보이게 만든 다음, 운영 심화에서 파이프라인·데이터·시크릿·배포·성능을 차례로 다졌다. 각 편이 독립적으로 읽혀도 되지만, 순서대로 읽으면 하나의 플랫폼이 세워지고 검증되는 과정이 된다.
연재를 마치며 마지막 체크리스트를 남긴다.
- 오토스케일링 임계값이 부하 테스트로 실측됐고, 근거가 문서에 남아 있는가
- p95 SLO가 정의되고, 알림이 그 위반을 실제로 발화하는가
- 스케일 임계값 도달과 maxReplicas 도달 두 변곡점의 동시성 값이 알려져 있는가
- 병목이 검색인지 LLM 호출인지 큐잉인지 트레이스로 분해되는가
- 스케일 인 쿨다운과 maxReplicas가 비용·안정성의 균형점에 있는가
2편에서 감으로 넣었던 concurrentRequests: 10은, 이제 “부하 테스트에서 p95가 꺾이기 시작한 지점보다 한 단계 아래”라는 숫자로 답할 수 있게 됐다. 감으로 정한 값과 실측으로 검증한 값의 차이가, 결국 프로덕션과 데모의 차이다.
댓글남기기