
AI 챗백엔드의 데이터 계층: PostgreSQL 커넥션 풀과 Redis 세션 설계
직전 글 RAG 파이프라인을 마이크로서비스로 분리하기에서는 문서 파싱·벡터 검색·웹 검색을 각각 별도 컨테이너 앱으로 떼어냈다. 연산 덩어리는 분리했지만, 그 컴포넌트들이 최종적으로 읽고 쓰는 상태는 여전히 한 곳에 모여 있었다. 이번 편은 그 상태를 어디에 얼마나 오래 두느냐, 즉 데이터 계층 설계를 다룬다.
프로덕션 챗백엔드에는 성격이 정반대인 데이터가 뒤섞여 있다. 몇 년을 보관해야 하는 사용자 계정과 대화 이력도 있고, 컨테이너가 재시작되면 사라져도 아무 문제 없는 8시간짜리 세션도 있다. 이 둘을 같은 저장소에 넣으면 확장할 때 반드시 부딪힌다. 무상태(stateless)를 전제로 리플리카를 늘렸는데, 상태가 컨테이너 안에 남아 있으면 늘린 리플리카가 곧바로 불일치를 만든다.
1. 데이터를 두 종류로 나누는 기준
설계의 출발점은 “이 데이터가 사라지면 어떤 일이 벌어지는가”라는 질문 하나다. 답에 따라 저장소를 완전히 다르게 가져가야 한다.
영속 상태(persistent state) 는 사용자 계정, 대화방, 메시지 이력, 모델 설정처럼 서비스가 재시작돼도 반드시 남아야 하는 데이터다. 유실되면 복구 불가능한 손실이고, 트랜잭션과 제약 조건이 필요하며, 백업·복원 정책의 대상이 된다. 반대로 일시 상태(ephemeral state) 는 로그인 세션 토큰, 웹소켓 연결 상태, 임베딩 결과 캐시처럼 짧게 살고 언제든 버려도 되는 데이터다. 유실되면 사용자가 다시 로그인하거나 캐시가 한 번 미스 나는 정도의 불편밖에 없다.
두 종류를 같은 PostgreSQL에 넣으면 무슨 문제가 생기는가. 리플리카가 1개에서 20개로 늘어나는 순간을 생각해 보자. 세션 조회는 초당 수천 건의 읽기인데, 이 읽기가 대화 이력 쓰기와 같은 커넥션 풀을 두고 경쟁한다. 캐시성 읽기가 트랜잭션 락(lock)을 잡고 있는 쓰기를 기다리게 되면, 대화 저장 하나가 수백 밀리초씩 밀린다. 게다가 세션은 TTL(Time To Live)로 자동 만료되는 게 자연스러운데, 관계형 테이블에서 만료를 흉내 내려면 주기적 삭제 배치가 필요하다.
또 다른 차이는 확장 방식에 있다. 영속 저장소는 리플리카를 늘린다고 같이 늘리지 않는다. DB는 보통 하나의 주 인스턴스에 연결이 몰리므로, 애플리케이션이 늘어날수록 연결을 아껴 쓰는 게 중요해진다. 반면 일시 저장소는 애플리케이션과 함께 수평 확장하는 쪽이 자연스럽다. 즉 “영속 = 아껴 쓰는 자원, 일시 = 함께 늘리는 자원”이라는 대비가 저장소 선택을 다시 한번 갈라 준다.
그래서 이 프로젝트는 저장소를 둘로 갈랐다. 영속 상태는 관리형 PostgreSQL(일반화 이름 psql-chat-prod)에, 일시 상태는 컨테이너로 띄운 Redis(aca-redis)에 둔다. 데이터를 복제하는 게 아니라, 데이터의 수명 주기에 맞춰 저장소를 배정하는 것이다. 이 기준 하나만 세워 두면 “새 필드를 어디에 넣지”라는 질문이 대부분 자동으로 풀린다.
1.1 저장소 선택 기준표
| 데이터 | 성격 | 저장소 | 근거 |
|---|---|---|---|
| 사용자·권한 매핑 | 영속 | PostgreSQL | 트랜잭션·제약 조건·감사 필요 |
| 대화방·메시지 이력 | 영속 | PostgreSQL | 관계 조회·백업 대상 |
| 모델·프롬프트 설정 | 영속 | PostgreSQL | 배포 간 일관성 필요 |
| 로그인 세션 토큰 | 일시 | Redis | TTL 자동 만료, 다중 리플리카 공유 |
| 웹소켓 채널 상태 | 일시 | Redis (pub/sub) | 리플리카 간 스트리밍 전달 |
| 임베딩·검색 결과 캐시 | 일시 | Redis | 재계산 비용 절감, 미스 허용 |
2. 토폴로지
두 저장소가 네트워크 어디에 놓이고 누가 접근하는지부터 고정하자. 폐쇄망 VNet 안에서 PostgreSQL은 프라이빗 엔드포인트로만, Redis는 같은 컨테이너 앱 환경 내부 이름으로만 접근한다.
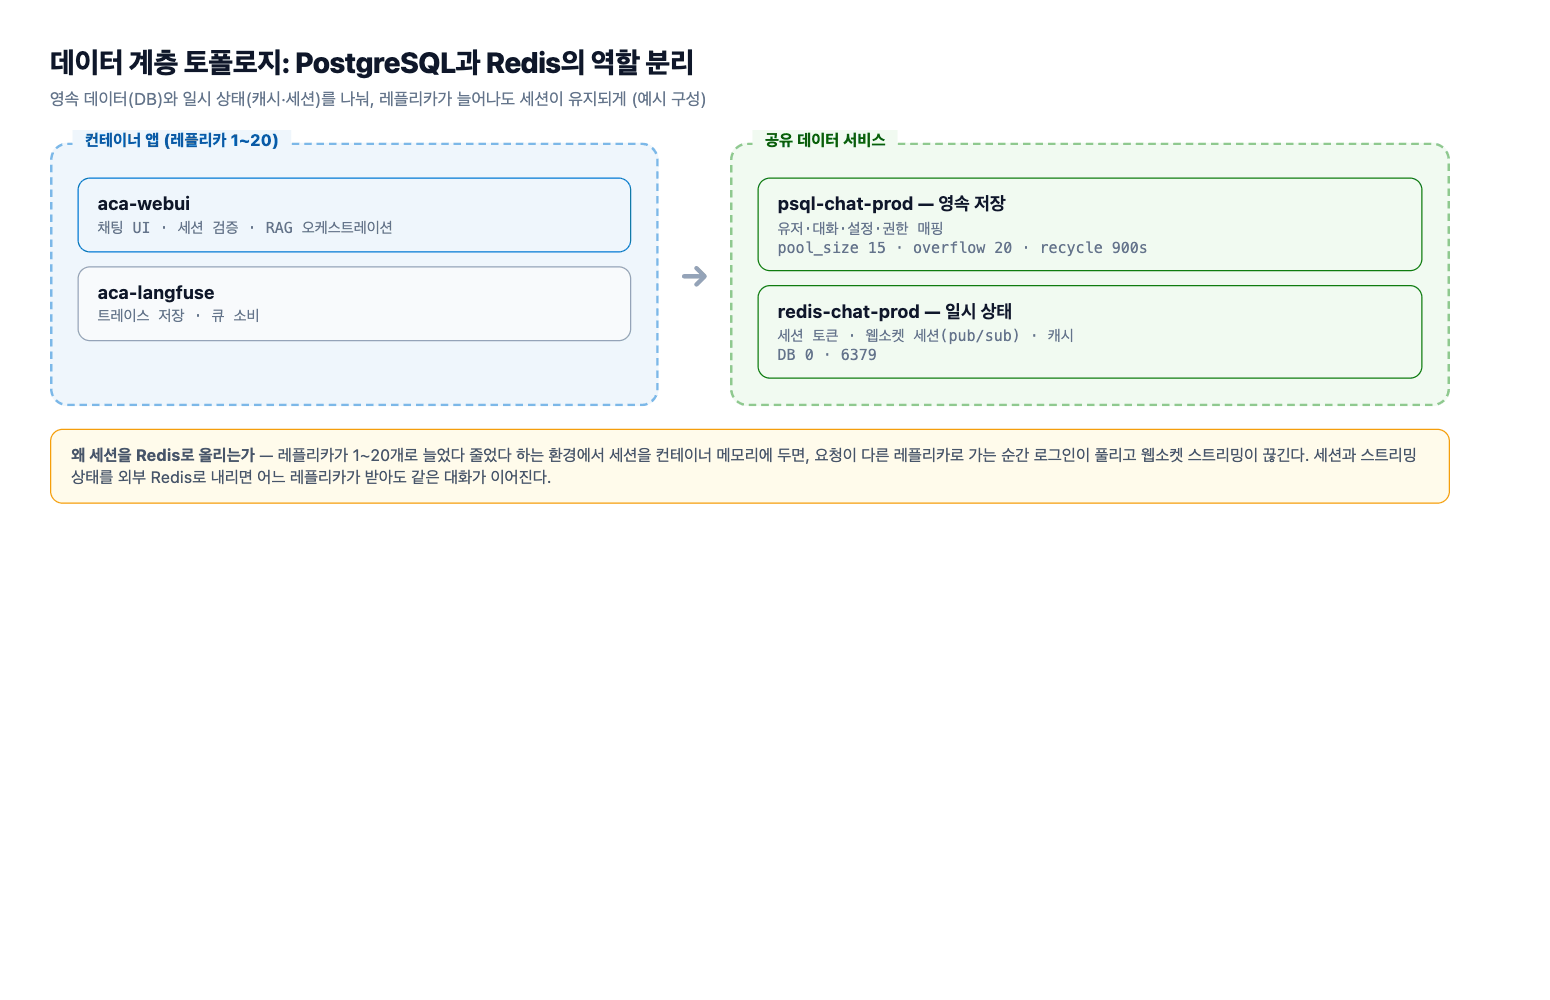
위 그림의 흐름을 문장으로 다시 짚으면 이렇다. 사용자 요청은 aca-webui로 들어오고, 이 앱은 세 가지 경로로 저장소를 쓴다. 첫째, 대화방과 이력 같은 영속 데이터는 pe-psql 프라이빗 엔드포인트를 통해 psql-chat-prod로 간다. 둘째, 세션·웹소켓·캐시는 같은 환경 안의 aca-redis로 간다. 셋째, RAG 파이프라인의 임베딩 결과와 검색 캐시도 같은 Redis를 공유한다. PostgreSQL은 aca-webui만 직접 연결하고, 나머지 RAG 컴포넌트는 API 계층 너머에서 간접적으로만 접근한다.
2.1 왜 PostgreSQL은 관리형이고 Redis는 컨테이너인가
두 저장소의 운영 방식이 다른 데는 이유가 있다. PostgreSQL은 백업·고가용성·버전 패치·디스크 장애 복구가 전부 중요하므로 Azure Database for PostgreSQL Flexible Server를 쓴다. 데이터가 사라지면 서비스가 끝나기 때문에, 자동 백업과 특정 시점 복원(point-in-time restore)을 관리형에 위임하는 편이 합리적이다.
Redis는 반대로 데이터가 날아가도 서비스가 죽지 않는다. 세션이 사라지면 사용자가 다시 로그인하면 되고, 캐시가 비면 원본에서 다시 계산한다. 그래서 굳이 고가용성 관리형 서비스를 쓸 필요 없이 aca-redis 컨테이너 앱 하나로 띄워 환경 내부 통신만 허용했다. 접근 경로도 노출 지점을 줄이는 원칙에 맞춰 인그레스 없이 환경 DNS 이름(redis://aca-redis:6379/0)으로만 연결한다.
2.2 환경 변수로 주입되는 접속 정보
두 접속 정보는 컨테이너 앱 시크릿과 환경 변수로 주입한다. 커넥션 문자열에는 자격 증명이 들어가므로 매니페스트에 평문으로 두지 않는다.
env:
  - name: DATABASE_URL
    secretRef: database-url          # postgresql://user:pass@psql-chat-prod:5432/chat
  - name: REDIS_URL
    value: redis://aca-redis:6379/0
  - name: WEBSOCKET_MANAGER
    value: redis
  - name: WEBSOCKET_REDIS_URL
    value: redis://aca-redis:6379/0
3. 커넥션 풀: DB 연결을 재사용한다
여기서부터가 실전이다. PostgreSQL은 연결 하나를 맺는 비용이 싸지 않다. TCP 핸드셰이크, TLS 협상, 인증, 백엔드 프로세스 생성까지 합치면 연결 하나에 수 밀리초가 든다. 게다가 PostgreSQL은 연결마다 서버 프로세스를 하나씩 띄우기 때문에, 요청이 올 때마다 연결을 새로 맺고 끊으면 동시 사용자가 몰리는 순간 연결 생성 자체가 병목이 된다. 그래서 애플리케이션과 DB 사이에 커넥션 풀(connection pool) 을 두고, 미리 맺어 둔 연결을 재사용한다.
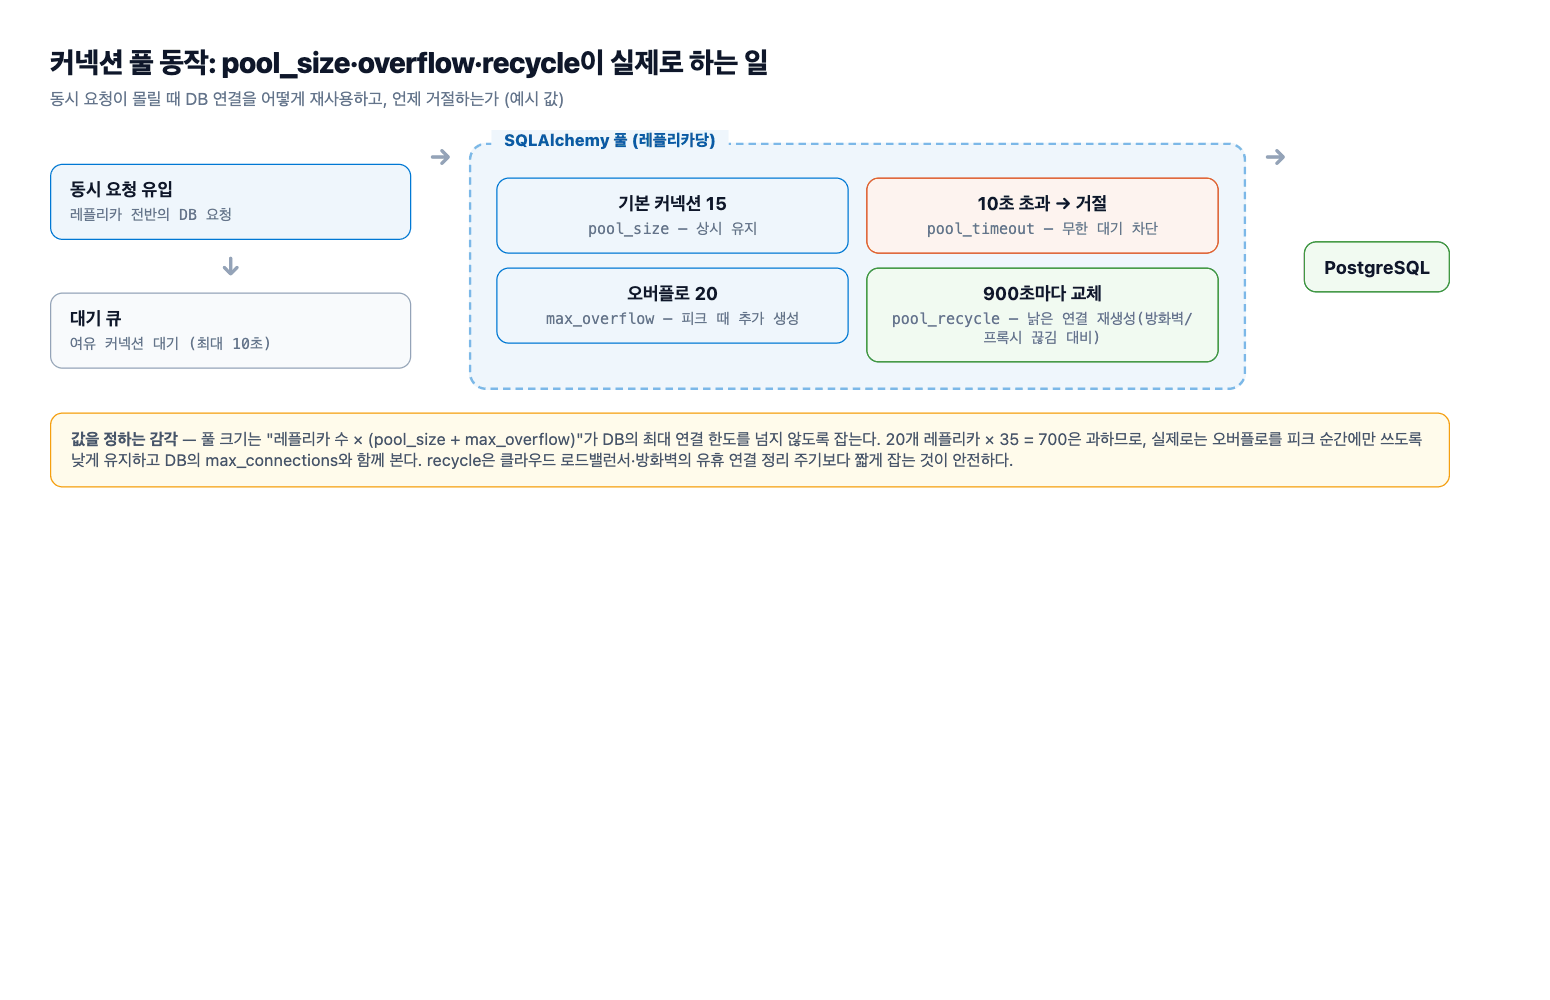
위 그림처럼 요청이 들어오면 풀에서 유휴 연결을 꺼내 쓰고, 쓰고 나면 닫지 않고 풀에 반납한다. 연결이 부족하면 설정된 상한까지 새로 만들고, 그마저 넘으면 대기한다. 이 그림의 네 숫자가 실제 동작을 결정한다.
| 파라미터 | 값 | 하는 일 |
|---|---|---|
pool_size |
15 | 평상시 유지하는 상시 연결 수. 재사용의 기본 단위 |
max_overflow |
20 | 피크에 임시로 추가로 열 수 있는 연결 수 |
pool_timeout |
10 | 유휴 연결이 없을 때 기다리는 최대 시간(초) |
pool_recycle |
900 | 연결을 15분마다 교체(재생성)하는 주기(초) |
3.1 pool_size: 재사용할 연결의 기본 수
pool_size=15는 “리플리카 하나가 평상시 15개의 DB 연결을 열어 두고 돌려 쓴다”는 뜻이다. 연결을 새로 맺는 비용을 요청마다 지불하지 않기 위한 값이다. 너무 작으면 트래픽이 조금만 올라도 대기가 생기고, 너무 크면 놀고 있는 유휴 연결이 DB 자원을 잡아먹는다.
적정값은 워커 수에서 역산한다. 동시 요청 10개를 처리하는 리플리카에서 각 요청이 임베딩 저장과 이력 조회로 연결을 한두 번 잡으면, 순간 동시 사용 연결은 대략 15~25개 사이다. 상시 15개를 열어 두면 평상시 트래픽은 대기 없이 소화된다.
네 파라미터는 보통 엔진 생성 시점에 한 번에 지정한다. SQLAlchemy 계열이라면 아래처럼 넘긴다.
engine = create_engine(
    DATABASE_URL,
    pool_size=15,        # 상시 유지 연결
    max_overflow=20,     # 피크 시 임시 추가
    pool_timeout=10,     # 연결 대기 상한(초)
    pool_recycle=900,    # 15분마다 연결 교체
    pool_pre_ping=True,  # 반환 전 연결 생존 확인
)
pool_pre_ping=True는 눈에 잘 안 띄지만 실무에서 체감이 큰 옵션이다. 풀에서 꺼낸 연결이 이미 죽어 있으면 조용히 새 연결로 교체한 뒤 넘겨준다. 위에서 말한 좀비 연결 문제를 pool_recycle과 함께 이중으로 막아 준다.
3.2 max_overflow: 피크를 흡수하는 완충
max_overflow=20은 평상시 15개가 모두 사용 중일 때 임시로 추가로 열 수 있는 연결 수다. 즉 리플리카 하나가 순간적으로 최대 15 + 20 = 35개까지 연결을 쓸 수 있다. 여기서 중요한 건 “임시”라는 점이다. 피크가 지나면 초과분은 닫혀서 다시 15개로 돌아온다. 상시 연결을 늘리지 않고도 짧은 버스트를 흡수하는 완충 장치인 셈이다.
3.3 pool_timeout: 무한 대기를 막는 안전장치
pool_timeout=10은 풀에 유휴 연결도 없고 초과 생성도 한계에 도달했을 때, 요청이 최대 10초까지만 기다린다는 뜻이다. 이걸 무한대로 두면 어떻게 되는가. DB가 느려져 연결 반환이 밀리는 순간 모든 요청이 연결을 기다리며 큐에 쌓이고, 큐가 무한히 자라면서 애플리케이션 메모리가 터진다. 10초 후 타임아웃 예외를 던지면 요청이 빠르게 실패하고 스레드가 반환되므로, 장애가 전체로 번지는 것을 막는다. 실패를 빨리 하는 것이 느리게 성공하는 것보다 낫다는 원칙이 그대로 적용된다.
3.4 pool_recycle: 낡은 연결을 갈아 끼운다
pool_recycle=900은 연결을 15분마다 폐기하고 새로 맺는다는 뜻이다. 풀에 오래 산 연결을 그대로 두면 문제가 생긴다. 중간의 로드밸런서나 DB 측 방화벽이 유휴 연결을 조용히 끊어도 애플리케이션은 살아 있다고 착각하고, 다음 요청에서 죽은 소켓을 잡아 “connection reset” 오류가 난다. 15분 주기로 미리 교체하면 이런 좀비 연결이 쌓이기 전에 걸러진다.
3.5 레플리카 수와 DB max_connections의 관계
여기가 가장 많이 사고가 나는 지점이다. 리플리카 하나가 최대 35개 연결을 쓸 수 있다면, 리플리카가 20개로 늘었을 때 이론상 최대 연결은 20 × (15 + 20) = 700개다. 그런데 PostgreSQL의 기본 max_connections는 100 근처다. 그대로 두면 리플리카가 늘어나는 순간 DB가 “too many clients already”로 연결을 거부하고, 스케일 아웃이 오히려 장애를 만든다.
해결은 두 갈래다. 첫째, DB의 max_connections를 올리고 서버 메모리를 그에 맞춰 키운다. 연결마다 작업 메모리(work_mem 등)가 붙으므로 연결 수를 늘리는 것은 공짜가 아니다. 둘째, 애플리케이션과 DB 사이에 PgBouncer 같은 연결 풀러(pooler)를 두고 애플리케이션 연결 수와 DB 연결 수를 분리한다. 이 프로젝트는 리플리카당 상시 연결(15개)을 기준으로 총합을 계산해 DB 상한을 여유 있게 잡고, 순간 초과분(overflow)은 동시에 모든 리플리카에서 터지지 않는다는 전제로 관리했다. 스케일 아웃을 설계할 때는 항상 “최대 리플리카 × 최대 연결”을 먼저 계산해 DB 상한과 비교해야 한다.
4. Redis: 세션과 웹소켓의 외부화
DB 연결을 재사용하는 이야기를 마쳤으니, 이번엔 일시 상태를 컨테이너 밖으로 꺼내는 이야기다. 챗 서비스에서 리플리카를 늘릴 때 가장 먼저 깨지는 것이 로그인 세션과 웹소켓이다.
4.1 세션을 컨테이너 메모리에 두면 안 되는 이유
세션을 애플리케이션 프로세스 메모리에 저장한다고 하자. 사용자가 세션 A로 리플리카 1에 로그인했다. 트래픽이 몰려 리플리카가 늘고 스케일 인 쿨다운이 지나 리플리카 1이 줄어든다. 이때 다음 요청이 세션 정보가 없는 리플리카 3으로 라우팅되면 사용자는 로그인 화면으로 튕긴다. 리플리카가 자주 바뀌는 환경에서 로컬 세션은 곧 “랜덤 로그아웃”이다.
세션을 Redis로 외부화하면 이 문제가 사라진다. 어느 리플리카로 요청이 가든 동일한 세션을 읽는다. 세션 키에는 TTL을 걸어 8시간(JWT_EXPIRES_IN과 동일한 주기) 뒤 자동 만료시킨다. 만료 관리를 Redis에 위임하면 세션 정리 배치를 따로 돌릴 필요가 없다.
4.2 웹소켓 pub/sub으로 스트리밍 공유
LLM 응답은 토큰 단위로 스트리밍되므로 연결이 길게 유지된다. 웹소켓 연결은 특정 리플리카에 물리적으로 붙어 있는데, 그 리플리카가 재시작되면 연결이 끊긴다. Redis의 pub/sub(publish/subscribe) 를 쓰면 리플리카들은 같은 채널을 구독하고, 어떤 리플리카가 만든 토큰 스트림을 다른 리플리카가 받아 자신에게 붙은 클라이언트로 흘려보낼 수 있다. WEBSOCKET_MANAGER=redis 설정이 이 역할을 한다.
즉 웹소켓의 실제 소켓은 리플리카에 있지만, 그 상태와 라우팅은 Redis가 공유하는 셈이다. 덕분에 리플리카를 늘리거나 줄여도 스트리밍 세션이 특정 인스턴스에 묶이지 않는다.
4.3 캐시 TTL 설계
Redis는 임베딩 결과 캐시로도 쓴다. 같은 문서를 다시 임베딩하거나 같은 질의를 반복 검색하는 일은 비용 낭비이므로 결과를 캐싱한다. 이때 데이터마다 신선도(freshness) 요구가 다르므로 TTL을 다르게 잡는다.
- 임베딩 벡터: 모델 버전이 바뀌지 않는 한 재사용 가능. 상대적으로 길게.
- 검색 결과: 문서가 갱신되면 낡는다. 문서 변경 이벤트 시 무효화하고 TTL은 짧게.
- 세션·토큰: 보안이 걸려 있으므로 짧고 명확하게(8시간).
TTL을 길게 잡으면 신선도가 떨어지고, 짧게 잡으면 캐시 효과가 줄어든다. 정답은 없고 “이 데이터가 낡으면 사용자가 어느 정도 불편을 감수하는가”로 정한다.
4.4 Redis 메모리 정책
세션·캐시를 한 Redis 인스턴스에 담으면 메모리 상한을 반드시 정해야 한다. maxmemory에 상한을 걸지 않으면 캐시가 무한히 자라 결국 노드 메모리를 압박한다. 상한에 도달했을 때 무엇을 버릴지 정하는 것이 maxmemory-policy인데, 캐시와 세션을 함께 담는 환경에서는 allkeys-lru(가장 오래 안 쓴 키부터 제거)가 무난하다. 다만 세션이 밀려나면 사용자가 로그아웃되므로, 세션과 캐시를 논리적으로 다른 DB 인덱스로 분리하거나 정책을 신중히 고른다. 또한 Redis 자체를 재시작하면 메모리 데이터가 사라지므로, 세션 유실을 감수할 수 있는지도 함께 판단해야 한다. 이 프로젝트는 세션 유실을 “재로그인”으로 흡수할 수 있다고 보고 영속성보다 단순성을 택했다.
5. 장애 시나리오
설계가 맞았는지는 정상일 때가 아니라 저장소가 아플 때 드러난다. 두 저장소의 장애를 각각 어떻게 흡수하는지 정리한다.
5.1 DB 지연·다운: 풀 타임아웃으로 빠르게 실패
DB가 느려지기 시작하면 풀의 유휴 연결이 빠르게 소진된다. 이때 pool_timeout=10이 동작한다. 10초 안에 연결을 못 잡은 요청은 예외로 실패하고, 사용자는 오류를 보지만 애플리케이션 전체가 큐로 멈추지는 않는다. 만약 이 값이 무한대라면 모든 워커가 연결 대기에 갇혀 헬스 프로브까지 실패하고, 리플리카가 재시작되는 악순환이 시작된다.
DB가 완전히 다운되면 영속 데이터를 쓰는 요청(대화 저장)은 실패하는 수밖에 없다. 다만 이미 만들어진 대화 이력을 읽는 것은 Redis 캐시에서 흡수할 수 있고, 스트리밍 중이던 대화는 클라이언트가 재시도하도록 유도한다. 핵심은 “DB 장애가 웹소켓 연결 자체를 끊지 않도록” 하는 것, 즉 저장 실패와 실시간 통신 실패를 분리하는 것이다.
5.2 Redis 다운: 캐시는 미스로 강등
Redis는 훨씬 관대하다. Redis가 죽으면 세션 조회가 실패하고 사용자가 다시 로그인해야 할 수 있지만, 원본 데이터(PostgreSQL)는 멀쩡하다. 캐시 계층의 실패는 캐시 미스(cache miss) 로 강등되어 원본에서 다시 계산한다. 임베딩 캐시가 비면 재임베딩으로 느려질 뿐, 틀린 답을 주지는 않는다. 이 “강등 가능성”이 앞에서 Redis를 관리형 대신 컨테이너 하나로 둔 근거이기도 하다. 중요한 것은 캐시를 정답의 원천으로 취급하지 않는 설계다. 캐시가 없어도 서비스가 논리적으로 맞게 동작해야 한다.
5.3 풀 고갈을 미리 보는 지표
장애는 갑자기 오지 않는다. 커넥션 풀 고갈은 항상 먼저 신호를 보낸다. 풀에서 연결을 얻기까지 걸린 대기 시간(pool wait time), 현재 사용 중인 연결 수, pool_timeout으로 실패한 요청 수를 지표로 노출해 두면, 실제 장애 전에 “연결이 부족해지고 있다”는 것을 알 수 있다. 사용 중 연결이 pool_size에 붙어 있고 overflow까지 자주 올라간다면, 리플리카당 풀 크기를 늘리거나 DB 상한을 다시 계산할 시점이다.
6. 정리
데이터 계층 설계의 핵심은 저장소를 고르는 게 아니라 데이터의 수명 주기를 먼저 판단하는 것이다. 영속 상태는 PostgreSQL에 두고 트랜잭션과 백업에 위임하며, 일시 상태는 Redis로 외부화해 무상태 리플리카 확장을 가능하게 한다. 커넥션 풀은 그 사이에서 연결 비용을 줄이고 피크를 흡수하는 완충이며, 네 파라미터(pool_size·max_overflow·pool_timeout·pool_recycle)가 각각 재사용·완충·조기 실패·교체라는 서로 다른 역할을 맡는다. 무엇보다 스케일 아웃을 설계할 때 “최대 리플리카 수 × 최대 연결 수”가 DB 상한을 넘지 않는지 계산하는 습관이 필요하다.
다음 편에서는 이 환경의 자격 증명, 즉 DB 커넥션 문자열과 스토리지 키를 어떻게 회전·감사하는지 다룬다. 시크릿을 코드와 매니페스트에서 완전히 떼어내고 Key Vault와 관리 ID로 거버넌스하는 과정을 정리할 예정이다.
댓글남기기