
사설망 RAG 파이프라인 설계: Docling·Qdrant·리랭커 분리 운영기
1부(구축편)에서는 사내 서비스가 공용 인터넷에 노출되지 않도록 VNet과 프라이빗 엔드포인트를 구성하고, 그 위에 Azure Container Apps 프로덕션 환경을 세웠다. 네트워크 경계와 실행 기반이 준비됐다면 이제 그 위에 실제 서비스 로직을 얹어야 한다. 이번 글부터 시작하는 2부(운영 심화)는 그 애플리케이션 계층, 그중에서도 RAG(검색 증강 생성, Retrieval-Augmented Generation) 파이프라인을 다룬다.
RAG는 오픈북 시험과 비슷하다. LLM이 답을 지어내는 대신, 먼저 관련 자료를 찾아 참고문헌으로 붙여 주는 방식이다. 문제는 이 “자료 찾기”가 생각보다 무겁다는 점이다. 수백 쪽 PDF를 텍스트로 바꾸고, 임베딩 벡터를 만들어 저장하고, 질문마다 유사 문서를 검색하고, 그 결과를 다시 순위 매기는 일은 성격이 전부 다르다. 이 글은 그 이질적인 작업들을 어떻게 떼어내고 연결했는지, 그리고 그렇게 나눈 구조가 운영에서 무엇을 바꾸는지를 정리한다.
1. RAG를 한 덩어리로 두면 생기는 일
이야기를 시작하기 전에, 왜 분리가 필요한지부터 짚는 게 좋다. 만약 파싱·검색·생성이 하나의 프로세스 안에서 돌아간다고 상상해 보자.
사내 직원 한 명이 300쪽짜리 매뉴얼 PDF를 업로드했다. 파서는 이 문서를 레이아웃 단위로 쪼개고 표를 복원하고 OCR을 돌리느라 CPU 코어를 몇 분간 붙잡는다. 같은 프로세스가 그 시간 동안 다른 사용자의 채팅 요청도 처리하고 있었다면, 그 사용자의 응답은 파싱이 끝날 때까지 큐에 갇힌다. 실제로 이 구조에서는 문서 하나를 올리는 순간 다른 대화의 체감 응답 속도가 눈에 띄게 튀었다. 무거운 작업이 가벼운 작업의 자원을 빼앗는 전형적인 자원 경합(contention)이다.
두 번째 문제는 자원 프로파일이 다르다는 점이다. 파서는 CPU에 몰빵해야 하고(레이아웃 분석·OCR), 벡터 DB는 인덱스를 메모리에 올려 두므로 RAM이 중요하며, 웹 검색 프록시는 네트워크 대기 시간이 대부분이다. 그런데 한 프로세스로 묶어 두면 이 셋이 같은 사양 위에서 함께 스케일된다. 파싱 폭주에 맞춰 인스턴스를 늘리면 놀고 있는 벡터 검색 자원까지 같이 늘어나고, 반대로 검색 부하에 맞추면 파싱이 병목으로 남는다.
세 번째는 장애 격리다. 파서가 특정 PDF에서 무한 루프에 빠지거나 웹 검색 엔진이 응답을 멈추면, 같은 프로세스에 얹힌 검색과 생성까지 함께 멈춘다. 반면 컴포넌트를 분리하면 하나가 죽어도 나머지는 살아 있고, 실패한 부분만 재시도하거나 우회할 수 있다.
결국 분리는 “예쁜 구조”를 위한 것이 아니라, 응답 지연·자원 낭비·장애 전파라는 세 가지 구체적 손실을 줄이기 위한 선택이었다.
2. 분리 아키텍처 개요
앞 절의 문제를 감안해 RAG 구성 요소를 각각 독립 컨테이너 앱(Container App)으로 떼어냈다. 전체 그림은 아래와 같다.
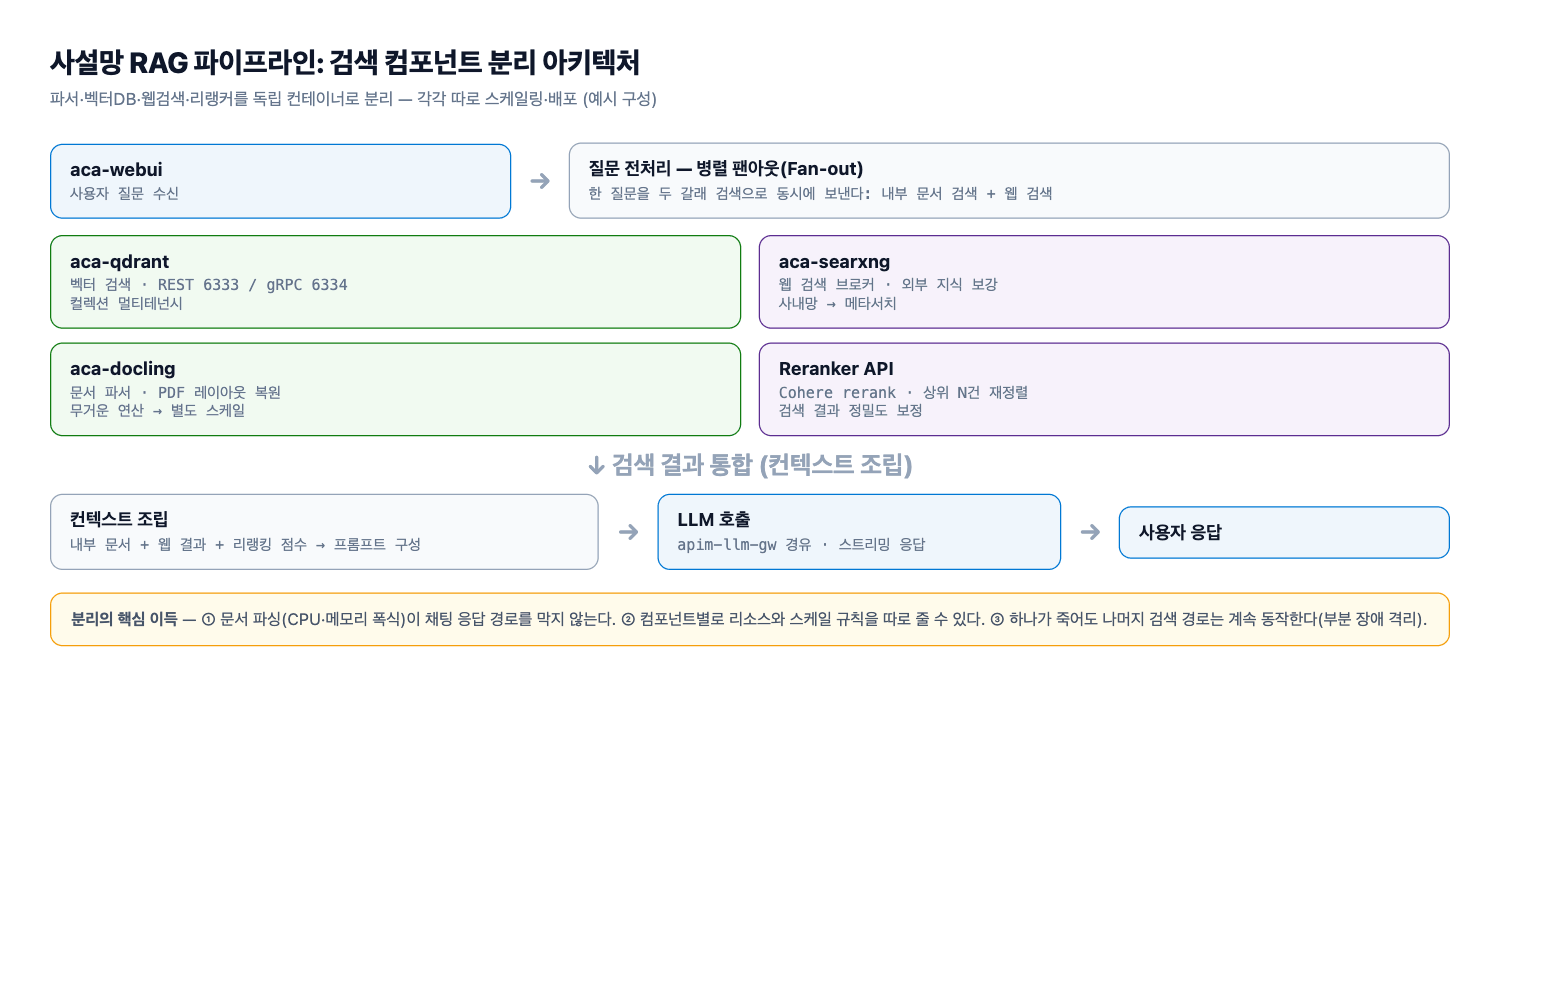
그림의 각 상자를 역할별로 풀어 보면 이렇다.
- aca-docling: 문서 파서(Document Parser). Open WebUI가 업로드한 PDF·DOCX 파일을 구조를 유지한 텍스트로 변환한다. 레이아웃 분석과 표 복원에 CPU를 많이 쓰는 워크로드다.
- aca-qdrant: 벡터 데이터베이스(Vector DB). 문서 조각(chunk)의 임베딩 벡터를 저장하고, 질문 벡터와 가장 가까운 조각들을 찾아 준다. HTTP 6333과 gRPC 6334 포트를 함께 노출한다.
- aca-searxng: 메타 검색 엔진(Meta Search Engine). 내부 문서에 없는 내용을 사내망 안에서 웹으로 보완할 때 쓰인다. 외부 검색 API에 직접 붙지 않고 자체 프록시를 둔 셈이다.
- Reranker: 검색으로 모아진 후보 문서들의 순위를 다시 매기는 재순위화 컴포넌트. Azure AI 서비스로 배포한 Cohere 계열 모델을 호출한다.
- aca-webui: 이 컴포넌트들을 조합하는 오케스트레이터. 사용자 질문을 받아 검색·리랭킹·생성 체인을 엮는다.
연결 방식에서 중요한 결정은 두 가지다. 첫째, 벡터 검색은 REST(6333) 대신 gRPC(6334) 를 우선 사용한다(QDRANT_PREFER_GRPC: true). gRPC는 프로토바이너리(protobuf) 기반 이진 직렬화를 쓰기 때문에, 검색 한 번에 오가는 수많은 벡터와 페이로드를 REST+JSON보다 훨씬 compact하게 주고받는다. 질문당 검색 지연이 수십 밀리초 수준에서 체감될 만큼 차이가 난다. 둘째, Qdrant는 멀티테넌시(multitenancy) 모드로 운영한다(ENABLE_QDRANT_MULTITENANCY_MODE: true). 사용자·조직별로 컬렉션을 격리해, 한 사용자의 문서가 다른 사용자의 검색 결과에 섞여 나오는 것을 구조적으로 막는다.
2.1 검색에서 생성까지의 흐름
다이어그램의 화살표를 문장으로 다시 따라가 보자. 사용자가 질문을 던지면, 먼저 질문이 임베딩 벡터로 변환된다. 이 벡터로 Qdrant에서 의미상 가까운 문서 조각 상위 후보를 뽑고, 동시에 SearXNG로 웹 검색을 병렬로 돌린다. 두 갈래 결과를 하나로 합친 뒤 Reranker에 넘겨 관련도 순으로 다시 정렬한다. 최종적으로 상위 몇 건만 컨텍스트로 삼아 LLM에 전달하고, LLM은 그 컨텍스트에 근거해 답을 생성한다. 핵심은 “넓게 모아서(Model recall) 좁게 고른다(precision)”는 2단 구조다. 검색은 재현율을 위해 후보를 넉넉히 모으고, 리랭킹이 정밀도를 책임진다.
3. 문서 수집(색인) 파이프라인
검색 품질은 결국 “무엇을 어떤 형태로 저장했는가”에서 결정된다. 아무리 좋은 리랭커를 붙여도 색인 단계에서 문서가 뭉개져 있으면 소용이 없다. 그래서 수집(ingestion) 파이프라인을 별도로 설계했다.
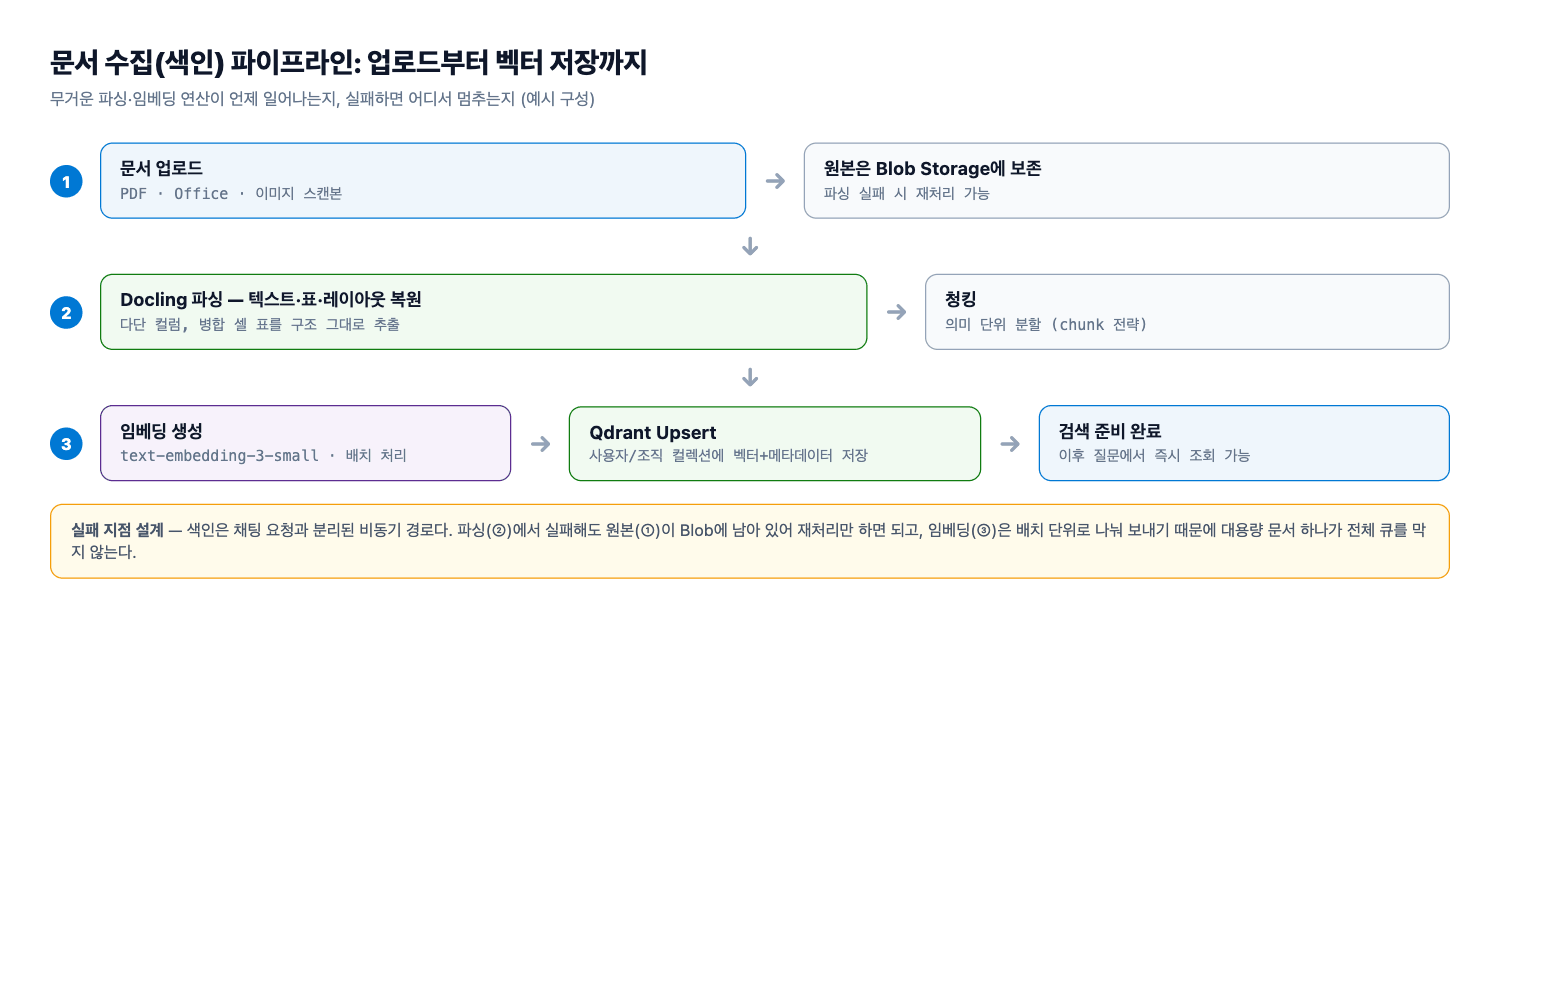
위 흐름을 순서대로 짚으면 다음과 같다.
- 사용자가 파일을 올리면 원본은 Azure Blob Storage에 그대로 보존된다. 이 원본은 절대 변형하지 않는다.
- 원본을 aca-docling에 넘겨 텍스트와 구조(제목·표·목록)를 추출한다.
- 추출된 텍스트를 임베딩(embedding) 모델로 벡터화한다.
- 벡터와 원문 조각을 메타데이터와 함께 aca-qdrant에 적재한다.
3.1 원본을 왜 따로 보존하는가
원본 Blob 보존은 단순한 백업이 아니다. 파싱 로직이나 임베딩 모델이 바뀌면 기존 색인을 통째로 다시 만들어야 하는데, 이때 원본이 남아 있어야 재색인(re-index) 이 가능하다. 파싱 결과만 저장해 두면 “그때 그 파서가 뽑아낸 텍스트”에 영원히 갇힌다. 원본을 불변 자산으로 두고, 파생물(텍스트·벡터)을 언제든 버리고 다시 만들 수 있게 하는 것이 핵심이다.
3.2 색인은 비동기로, 실패는 재처리로
파싱과 임베딩은 수 초에서 수 분이 걸린다. 이 작업을 사용자 요청과 동기로 묶으면 업로드 화면이 그 시간 내내 멈춘다. 그래서 색인은 비동기(asynchronous) 로 돌린다. 업로드는 즉시 끝내고, 파싱·임베딩은 백그라운드에서 진행하며, 완료 여부는 상태로 노출한다.
실패는 실패로 끝내지 않는다. Docling이 특정 페이지에서 예외를 던지거나 임베딩 호출이 일시적으로 타임아웃 나는 일은 흔하다. 이런 작업은 실패 큐에 남겨 두고 지수 백오프(exponential backoff)로 몇 차례 재시도한다. 재시도에도 실패하면 사용자에게 “이 문서는 색인에 실패했다”고 알려, 조용히 누락된 채 검색되지 않는 상황을 막는다.
문서를 어떤 크기로 쪼갤지(청킹, chunking)는 검색 품질을 좌우하는 별도 주제라 여기서는 다루지 않는다. 청킹 전략 자체는 청킹 정리에서 따로 정리해 두었다.
4. 검색 품질: 두 갈래 검색과 리랭킹
RAG의 답변 품질은 “얼마나 관련 있는 조각을 찾아냈는가”에 거의 전적으로 달려 있다. 그래서 검색 단계를 두 갈래로 나누고, 그 위에 리랭킹 단계를 얹었다.
4.1 내부 벡터 검색과 웹 검색의 병렬
첫 번째 갈래는 내부 벡터 검색이다. 사내 문서에서 질문과 의미상 가까운 조각을 Qdrant로 찾는다. 키워드가 정확히 일치하지 않아도 뜻이 통하면 찾아 주는 것이 벡터 검색의 강점이다. 벡터DB의 기본 원리가 낯설다면 벡터DB 정리를 먼저 보면 도움이 된다.
두 번째 갈래는 웹 검색이다. 사내 문서에 없는 최신 정보나 일반 상식을 SearXNG로 보완한다. 여기서 SearXNG를 쓴 이유는 사설망 제약 때문이다. 외부 상용 검색 API에 직접 붙으면 질의 내용이 외부로 나가고, 검색 제공자마다 인증·요금·약관이 제각각이다. SearXNG는 여러 검색 엔진의 결과를 하나로 모아 주는 자체 호스팅 메타 검색 엔진이라, 사내망 안에서 질의를 처리하고 필요한 결과만 받아올 수 있다.
두 갈래는 순서대로가 아니라 병렬로 돈다. 내부 검색이 끝나기를 기다렸다가 웹 검색을 시작하면 대기 시간이 그대로 합산되기 때문이다.
4.2 리랭커로 상위 N건 선별
두 갈래에서 모인 후보는 보통 수십 건이다. 이걸 전부 LLM에 넣으면 컨텍스트 창이 낭비되고, 관련 없는 문장이 섞여 답변 품질이 오히려 떨어진다. 그래서 리랭커(Reranker) 로 후보의 순위를 다시 매긴다.
벡터 검색이 “질문 벡터와 문서 벡터의 거리”라는 단일 신호로 빠르게 후보를 추리는 것과 달리, 리랭커는 질문과 문서를 함께 읽고 교차 인코딩(cross-encoding) 방식으로 관련도를 정밀하게 채점한다. 더 정확하지만 느리기 때문에, 전체 문서가 아니라 1차 후보에만 적용한다. 이 프로젝트에서는 Azure AI 서비스로 배포한 Cohere 계열 재순위 모델을 외부 엔진(RAG_RERANKING_ENGINE: external)으로 호출했다. 리랭킹 결과 상위 몇 건만 최종 컨텍스트로 남기고, 그 안에서만 LLM이 답을 만든다.
정리하면 검색은 넓게(recall), 리랭킹은 좁게(precision)다. 이 역할 분담이 없으면 “그럴듯하지만 근거가 약한” 답변이 나오기 쉽다.
5. 운영: 부분 장애와 재색인
분리 구조의 진짜 가치는 평상시가 아니라 무언가 잘못됐을 때 드러난다.
5.1 컴포넌트별 독립 배포와 스케일
각 컴포넌트는 별도 컨테이너 앱이므로 자원을 따로 준다. 파서(aca-docling)는 CPU에 몰빵하고, 벡터 DB(aca-qdrant)는 메모리 비중을 높이며, 웹 검색(aca-searxng)은 상대적으로 가볍게 둔다. 스케일도 독립적이다. 파싱 대기열이 길어지면 docling만 늘리고, 검색 부하가 오르면 qdrant 쪽을 조정한다. 앞 절에서 본 “함께 스케일되는 낭비”가 여기서 사라진다.
배포도 마찬가지다. 파서 이미지를 새로 올려도 벡터 DB는 리비전이 바뀌지 않으므로 재시작되지 않는다. 반대로 qdrant 설정을 바꿔도 진행 중인 파싱 작업은 영향을 받지 않는다.
5.2 하나가 죽었을 때
부분 장애(partial failure)에 대한 대응은 컴포넌트마다 다르게 설계했다.
- 파서 장애: 새 문서의 색인만 멈춘다. 이미 색인된 문서에 대한 질의응답은 정상 동작한다. 실패한 색인 작업은 큐에 남아 파서 복구 후 재처리된다.
- 벡터 DB 장애: 내부 검색이 불가능해지지만, 웹 검색 갈래는 살아 있으므로 웹 기반 답변은 계속 나간다. 완전한 무응답으로 떨어지지 않는다.
- 웹 검색 장애: 내부 문서 검색만으로 답한다. 사내 지식 질의에는 오히려 영향이 없다.
- 리랭커 장애: 순위 정밀도가 떨어질 뿐, 검색 후보를 그대로 쓰는 폴백(fallback)으로 답변은 이어진다.
핵심은 어느 하나가 죽어도 “전부 죽지 않는다”는 것이다. 한 덩어리 구조였다면 어느 컴포넌트의 장애든 서비스 전체 정지로 이어졌을 상황이다.
5.3 재색인 절차
파싱 로직을 고치거나 임베딩 모델을 교체하면 기존 색인은 신뢰할 수 없다. 이때는 원본 Blob을 소스로 새 컬렉션에 재색인하고, 완료 후 검색 대상을 새 컬렉션으로 전환한다. 같은 컬렉션을 덮어쓰며 재색인하면, 작업이 끝나기 전까지 검색 결과가 절반만 갱신된 어중간한 상태가 된다. 새 컬렉션에 채우고 한 번에 스위치하는 방식이 안전하고, 문제가 생기면 이전 컬렉션으로 되돌리기도 쉽다. 원본을 불변으로 보존해 둔 이유가 바로 이 재색인을 가능하게 하기 위함이다.
6. 정리
이번 글의 분리 원칙을 네 줄로 요약하면 이렇다.
- 부하 특성이 다르면 프로세스를 나눈다. CPU 집약 파싱과 메모리 집약 벡터 검색, 네트워크 대기형 웹 검색은 함께 스케일될 이유가 없다.
- 원본은 불변으로 남기고 파생물은 언제든 다시 만든다. 이 규칙 하나가 재색인과 모델 교체를 가능하게 한다.
- 검색은 넓게, 리랭킹은 좁게. 재현율과 정밀도를 다른 단계에 맡겨야 답변 근거가 단단해진다.
- 장애는 컴포넌트 단위로 격리하고, 폴백으로 서비스 전체 정지를 막는다.
RAG 구성 요소를 이렇게 떼어 놓고 나면, 다음 질문이 자연스럽게 따라온다. 이 컴포넌트들이 공유하는 데이터 계층 — 대화 기록을 담는 PostgreSQL, 세션과 캐시를 담는 Redis, 원본 문서를 담는 Blob — 은 어떻게 운영할 것인가. 다음 글에서는 커넥션 풀과 영구 스토리지, 그리고 데이터 계층의 확장 전략을 다룬다.
댓글남기기