
RAG 청킹(Chunking) 전략 아키텍처: 고정 길이 분할부터 시맨틱·레이트 청킹까지
검색 증강 생성(RAG, Retrieval-Augmented Generation) 파이프라인의 엔드-투-엔드 성능을 평가할 때, 흔히 최신 LLM의 성능이나 고도화된 프롬프트에 초점을 맞추기 쉽다. 그러나 프로덕션 환경에서 RAG 시스템이 환각(Hallucination)을 일으키거나 오답을 생성하는 원인은 검색 계층의 데이터 전처리 및 분할 단계에서 자주 비롯된다. 검색 단계에서 누락되거나 어긋난 문맥은 생성 단계에서 근거로 쓸 수 없기 때문이다.
그 중심에 있는 작업이 청킹(Chunking)이다. 청킹은 방대한 원시 문서(PDF, 기술 명세서, HTML, 로그)를 검색과 임베딩에 적합한 의미 단위로 분할한다. 최근 거대 언어 모델의 컨텍스트 윈도우가 128K~1M 토큰으로 확장되었음에도 불구하고, 여전히 정교한 청킹 전략이 필요한 이유와 다양한 청킹 알고리즘의 수학적·구조적 메커니즘, 그리고 최적의 파라미터 튜닝 플레이북을 분석한다.
1. 청킹의 근본적 딜레마: 검색 정밀도 vs. 생성 충실도
RAG 파이프라인에는 상호 상충하는 두 가지 최적화 목표가 존재한다.
청킹 크기(Chunk Size)에 따른 상충 트레이드오프:
[작은 청크 크기 (128~256 토큰)]
  (+) 검색 정밀도(Retrieval Precision) 극대화: 단일 주제에 집중되어 임베딩 벡터가 노이즈 없이 선명함.
  (-) 문맥 단절(Loss of Context): 전후 인과관계, 문맥 전제 조건이 소실되어 LLM이 전체 의미를 파악 불가.

[큰 청크 크기 (1024~2048 토큰)]
  (+) 풍부한 문맥(Rich Context): 배경 설명과 전제 조건이 온전히 보존되어 생성 충실도 향상.
  (-) 정보 희석(Information Dilution): 하나의 벡터에 여러 이종 주제가 뒤섞여 임베딩 유사도 검색 시 순위 하락.
청크 크기를 문자 수로 고정하지 않고 문장 단위로 자르면 청크 길이는 균일해지지 않는다. 아래는 Azure AI Search에서 NASA Earth at Night e-book을 textSplitMode=sentences로 분할했을 때의 청크 토큰 길이 분포다(총 13,361개 청크). 대부분의 청크가 수 토큰 구간에 몰려 있고 100토큰까지 완만한 긴 꼬리가 이어진다.
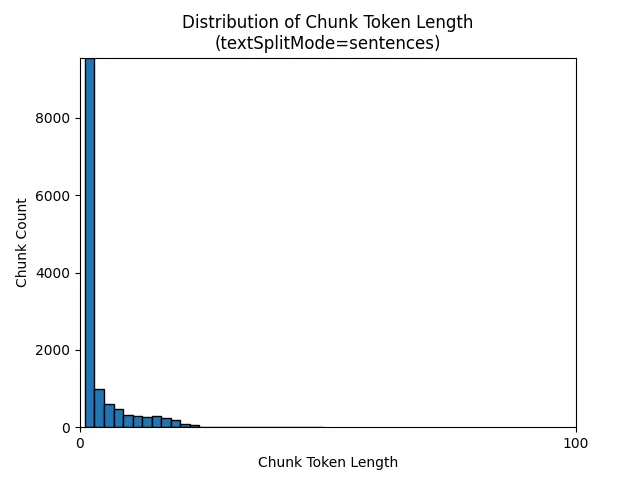
출처: Chunk Documents - Azure AI Search, Microsoft Learn (https://learn.microsoft.com/en-us/azure/search/vector-search-how-to-chunk-documents) · 이미지: MicrosoftDocs/azure-ai-docs (CC BY 4.0)
1.1 긴 컨텍스트 모델 시대에도 청킹이 필수적인 이유
- 정보 희석(Information Dilution)과 노이즈 대역폭:
- 밀집 벡터 검색은 질의와 문서를 각각 하나의 벡터로 인코딩해 유사도로 검색한다1. 임베딩 모델(예: 1536차원)의 단일 벡터 표현 공간은 제한적이라, 4000토큰짜리 거대한 문서를 단일 벡터로 압축하면 문서 내의 지엽적이지만 결정적인 세부 사실(Factoid)의 신호가 전체 평균에 묻혀버린다.
- ‘Lost in the Middle’ 현상:
- LLM이 수십만 토큰을 수용할 수 있더라도, 연구2에 따르면 관련 정보가 프롬프트 중간에 위치할 때의 성능이 양 끝단에 둘 때보다 떨어진다. 따라서 관련성이 높은 청크만 선별해 제공하는 편이 중간 위치의 정보가 묻힐 위험을 줄인다.
- 추론 비용 및 TTFT(Time-to-First-Token) 병목:
- 불필요한 비관련 문서를 무작정 컨텍스트에 쏟아부으면 프리필(Prefill) 연산량과 비용이 선형 증가하며, 응답 지연시간이 길어진다.
2. 청킹 전략 분류 및 알고리즘 정밀 해설
청킹 전략의 진화 스펙트럼:
[규칙 기반 (Rule-based)]           [구조 인식 (Structure-aware)]        [의미론적 적응 (Semantic-adaptive)]
1. Fixed-Size Sliding Window ──> 2. Recursive Character ──> 3. Markdown/HTML ──> 4. Semantic Splitter ──> 5. Late Chunking
   (고정 길이 분할)                 (구분자 재귀 분할)          (문서 계층 보존)        (임베딩 거리 급변점)       (전역 문맥 풀링)
2.1 고정 크기 분할 (Fixed-Size Sliding Window)
일정한 문자(Character) 또는 토큰 수를 기준으로 문서를 기계적으로 자르는 가장 단순한 기준선(Baseline)이다.
- 파라미터:
chunk_size,chunk_overlap(통상 10~20%). - 한계: 단어, 문장, 또는 수식의 한가운데가 잘려 의미가 훼손될 위험이 매우 높다. 로그나 정형화된 스트림 데이터 외의 자연어 문서에는 권장되지 않는다.
2.2 재귀적 문자 분할 (Recursive Character Splitting)
자연어의 계층적 구조를 반영하여 단락 $\rightarrow$ 문장 $\rightarrow$ 단어 순으로 구분자(Separator) 우선순위를 두어 분할하는 현대 RAG의 표준 기본 알고리즘이다.
# 계층적 구분자 기본 동작 순위
separators = ["\n\n", "\n", " ", ""]
- 먼저 가장 큰 논리적 단위인 단락 구분자(
\n\n)로 문서를 쪼갠다. - 결과 조각 중
chunk_size를 초과하는 조각이 있다면 다음 구분자(\n)로 재귀 분할한다. - 여전히 큰 조각은 공백(
"")까지 내려간다. - 문장이 임의로 잘리는 것을 방지하면서도 청크 크기를 목표치 이내로 제어한다.
2.3 문서 구조 인식 분할 (Document Structure-Aware)
Markdown의 헤딩(#, ##, ###)이나 HTML 태그, JSON 키-값 구조를 파싱하여 분할한다.
- 헤딩 메타데이터 전파: 각 청크에 상위 헤딩 경로(Breadcrumb:
H1 > H2 > H3)를 메타데이터로 부여하여, 분할 후에도 청크가 속한 상위 맥락을 보존한다. - 테이블(Table) 보호: 마크다운 표 구조 내부가 임의로 잘리면 행-열 관계가 붕괴된다. 표 전체를 단일 청크로 묶거나 HTML 형식으로 보존하는 파서가 필수적이다.
2.4 시맨틱 청킹 (Semantic Chunking)
사전 정의된 문자 수가 아니라, 의미적 주제의 전이(Topic Shift)가 일어나는 지점을 동적으로 탐지하여 분할한다.
시맨틱 청킹의 동작 원리:
1. 문장 단위 분할: [S1] [S2] [S3] [S4] [S5] [S6] ...
2. 슬라이딩 윈도우 결합 및 임베딩: E(S1+S2), E(S2+S3), E(S3+S4), ...
3. 인접 임베딩 간 코사인 거리 산출:
   Distance = 1 - CosineSimilarity(E_i, E_{i+1})
4. 임계값(Breakpoint) 계산:
   거리가 급격히 튀는 지점(예: 95th 백분위수)을 분할 경계로 지정
from langchain_experimental.text_splitter import SemanticChunker
from langchain_openai import OpenAIEmbeddings

# 백분위수 기반 시맨틱 청커 초기화
text_splitter = SemanticChunker(
    OpenAIEmbeddings(),
    breakpoint_threshold_type="percentile",
    breakpoint_threshold_amount=95
)
docs = text_splitter.create_documents([raw_text])
- 장점: 내용상 한 호흡으로 읽혀야 하는 단락이 인위적인 길이 제한 때문에 잘리지 않는다.
- 비용 트레이드오프: 모든 인접 문장 쌍에 대해 임베딩 모델을 호출해야 하므로, 인덱싱 단계의 연산 시간과 API 비용이 대폭 증가한다.
2.5 레이트 청킹 (Late Chunking)
2024년에 제안된 Late Chunking3은 기존 파이프라인의 처리 순서를 뒤집는다.
- 기존 방식: 텍스트 청킹 $\rightarrow$ 각 청크를 독립적으로 임베딩. (결과: 이전 청크의 대명사 “그것”, “해당 정책”이 무엇을 가리키는지 맥락 소실).
- Late Chunking 방식:
- 8K~32K의 긴 컨텍스트를 지원하는 임베딩 모델(예: jina-embeddings-v3)에 전체 문서를 입력한다.
- 양방향 트랜스포머 레이어를 거쳐 전체 문서의 모든 토큰에 대해 전역 문맥이 주입된 토큰 표현(Token Representations)을 얻는다.
- 그 후 목표 청크 스팬(Token Span)에 해당하는 토큰 벡터들만 평균 풀링(Mean Pooling)하여 청크 임베딩을 산출한다.
결과적으로 각 청크 벡터는 고유의 작은 크기를 유지하면서도 문서 전체의 문맥 정보(전역 어텐션)를 일부 내재화한다. 논문에서는 이렇게 만든 청크 임베딩이 청크를 따로 인코딩한 기존 방식보다 검색 성능이 높다고 보고한다3. 다만 전체 문서를 한 번에 인코딩해야 하므로, 문서 길이가 임베딩 모델의 최대 컨텍스트(예: 8K~32K 토큰)를 넘으면 그대로 적용할 수 없고, 인덱싱 비용도 문서 전체 길이에 비례해 늘어난다.
3. 문맥 보강 기법: Parent-Document & Sentence Window
청크 크기의 상충 딜레마를 시스템적으로 우회하기 위해 가장 널리 쓰이는 아키텍처 패턴은 검색 단위와 생성 단위의 분리다.
문맥 보강 검색 아키텍처:
[Parent-Document Retrieval]
  Query ──> [Small Chunk 검색 (256 토큰)] ──(ID 매핑)──> [Parent Chunk 반환 (1024 토큰)] ──> LLM

[Sentence Window Retrieval]
  Query ──> [중심 문장 검색 (Target Sentence)] ──> [앞뒤 K개 문장 결합 (Window)] ──> LLM
- Parent-Document Retrieval (계층형 청킹):
- 1024 토큰의 부모 청크를 256 토큰의 작은 자식 청크들로 나눈다.
- 벡터 인덱스에는 고정밀 검색을 위해 자식 청크만 등록한다.
- 검색 시 자식 청크가 매칭되면, LLM 컨텍스트에는 그 자식이 속한 부모 청크 전체를 전달한다.
- Sentence Window Retrieval:
- 단일 문장 단위로 임베딩을 생성하여 가장 밀도 높은 검색 정확도를 달성한다.
- 쿼리 매칭 후, 저장소에서 해당 문장의 앞뒤 $k$개(예: 전후 3문장)를 슬라이딩 윈도우로 결합하여 완성된 문맥을 구성한다.
4. 청킹 최적화 엔지니어링 플레이북
데이터셋의 특성에 따라 최적의 청킹 파라미터를 도출하기 위한 의사결정 프레임워크는 다음과 같다.
데이터 특성별 권장 청킹 전략:
┌───────────────────────┬─────────────────────────────┬─────────────────────────────┬──────────────────────────┐
│ 문서 유형             │ 권장 청킹 전략              │ 목표 Chunk Size             │ Overlap                  │
├───────────────────────┼─────────────────────────────┼─────────────────────────────┼──────────────────────────┤
│ 학술 논문 / 기술 문서 │ Markdown / Recursive Split  │ 512 토큰                    │ 100 토큰 (약 20%)        │
│ 법률 / 규정 / 계약서  │ Sentence Window / Semantic  │ 256 토큰 (윈도우 ±3문장)    │ 50 토큰                  │
│ Q&A / FAQ             │ Single Q-A 단위 유지        │ 원본 크기 (No Chunking)     │ 0                        │
│ 소프트웨어 코드 / API │ AST 기반 파서 (함수 단위)   │ 함수/클래스 경계 기준       │ 시그니처 상속            │
│ 다중 테마 복합 리포트 │ Parent-Document 계층 분할   │ 자식: 256, 부모: 1024       │ 10%                      │
└───────────────────────┴─────────────────────────────┴─────────────────────────────┴──────────────────────────┘
4.1 정량적 평가 프레임워크
RAG 품질은 검색 품질과 생성 충실도를 나눠 평가한다4. 청킹 전략을 변경할 때는 Ragas나 TruLens를 활용하여 다음 지표의 파레토 변화를 측정해야 한다.
- Context Precision (문맥 정밀도): 검색된 청크 중 실제 정답 생성에 기여한 유효 정보의 비율. (청크가 너무 크면 하락).
- Context Recall (문맥 재현율): 정답을 구성하는 데 필요한 모든 사실 정보가 검색된 청크 내에 포함되었는가. (청크가 너무 작거나 오버랩이 부족하면 하락).
- Faithfulness (충실도): 생성된 답변이 검색된 문맥에 엄밀히 근거하는가.
5. 결론: 청킹은 정적 설정이 아닌 동적 데이터 파이프라인
- 초기 출발점:
chunk_size = 512,chunk_overlap = 64의 Recursive Character Splitting을 기준선으로 설정하라. 512토큰을 출발점으로 잡는 것은 Azure AI Search 문서의 권장과도 일치한다. 같은 문서는 512토큰에 오버랩 25%(128토큰)를 기본값으로 제시하면서도, 최적값은 문서 유형과 질의 특성에 따라 달라진다고 밝힌다5. - 문서 구조 보존: 원본이 Markdown이나 HTML인 경우, 일반 텍스트로 평탄화(Flattening)하지 말고 구조 인식 스플리터를 사용해 헤딩 경로 메타데이터를 반드시 보존하라.
- 고난도 RAG 구축: 검색 재현율과 문맥 완전성을 동시에 달성해야 한다면, 무리한 단일 청크 튜닝 대신 Parent-Document Retrieval 또는 Late Chunking 아키텍처를 도입하라.
댓글남기기