
GraphRAG 시스템 아키텍처: 지식 그래프(Knowledge Graph)와 벡터 검색의 결합, Leiden 군집화 및 하이브리드 검색
전통적인 검색 증강 생성(RAG, Retrieval-Augmented Generation) 시스템은 문서를 독립적인 텍스트 청크(Chunk)로 분할하고, 고차원 임베딩 벡터로 변환한 뒤 코사인 유사도(Cosine Similarity)를 통해 상위 $k$개의 문서를 추출하는 벡터 검색(Vector Retrieval) 파이프라인에 의존해 왔다.
이 접근법은 “A 규정의 세부 조건은 무엇인가?”와 같이 명확한 사실 검색(Point Query)에서는 뛰어난 성능을 발휘한다. 그러나 코퍼스 전체를 조망해야 하는 질문(“이 데이터셋에 등장하는 주요 갈등 요인 3가지는 무엇인가?”, “A 기업의 공급망 리스크가 계열사들에 미치는 파급 효과는?”)과 같은 포괄적 의미 이해(Global Sensemaking) 및 다중 홉 관계 추론(Multi-hop Reasoning) 문제에서는 치명적인 한계를 드러낸다.
GraphRAG(Graph-based RAG)는 구조화되지 않은 텍스트로부터 엔티티(Entity)와 관계(Relationship)를 추출하여 지식 그래프(Knowledge Graph)를 구축하고, 이를 벡터 인덱스와 융합함으로써 이 병목을 돌파한다. 이 글에서는 Naive Vector RAG의 실패 모드, Microsoft GraphRAG의 핵심 파이프라인(Leiden 군집화 및 계층 요약), Neo4j의 Labeled Property Graph 아키텍처, 그리고 프로덕션 엔지니어링 트레이드오프를 심층 분석한다.
1. Naive Vector RAG의 한계와 실패 모드
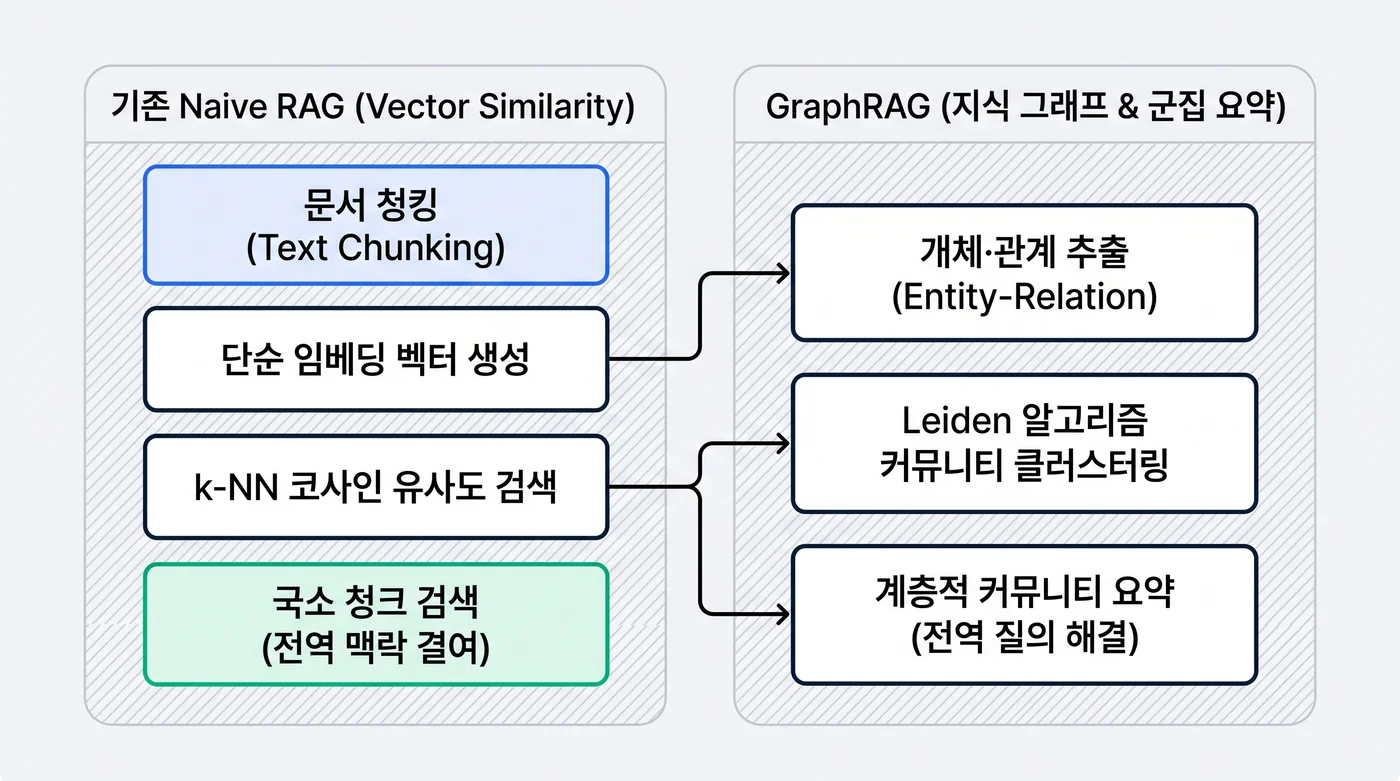
전통적인 벡터 검색 파이프라인이 실패하는 근본적인 원인은 다음과 같다.
Naive Vector RAG의 실패 모드:
1. 분산된 단편 정보의 결합 실패 (Multi-hop Failure):
   Doc 1: "Alice는 Project X의 총괄 책임자이다."
   Doc 2: "Project X는 Framework Y를 기반으로 구축되었다."
   Doc 3: "Framework Y는 취약점 CVE-1234를 보유하고 있다."
   Query: "Alice가 담당하는 프로젝트에 내재된 보안 취약점은?"
   ──> 쿼리 벡터와 Doc 3 간의 의미적 유사도가 낮아 Doc 3가 검색되지 않음 (추론 체인 단절).

2. 거시적 요약 실패 (Global Sensemaking Failure):
   Query: "수집된 10만 건의 고객 피드백에서 나타나는 핵심 개선 요구 5가지는?"
   ──> 특정 키워드에 매칭되는 국소 청크 $k$개만 검색되므로, 데이터셋 전체의 거시적 분포를 포착하지 못함.

3. 집계 및 구조적 연산 불가 (Aggregation Failure):
   Query: "지난 분기에 100만 달러 이상의 계약을 체결한 파트너사의 평균 매출은?"
   ──> 텍스트 유사도로는 수치 조건 필터링이나 평균 계산을 수행할 수 없음.
2. Microsoft GraphRAG: 추출, Leiden 군집화, 계층 요약
Microsoft Research가 제안한 GraphRAG12는 코퍼스 전체를 LLM으로 사전에 오프라인 색인하여 지식 그래프를 구성하고, 그래프 커뮤니티 단위의 요약 보고서를 사전에 생성하는 방식을 채택한다.
Microsoft GraphRAG 오프라인 색인 파이프라인:
  Source Docs ──> Text Chunks
                       │
                       ▼
            [LLM Extraction Phase]
            - Entity Extraction (Name, Type, Description)
            - Relationship Extraction (Source, Target, Description, Weight)
            - Covariate / Claim Extraction
                       │
                       ▼
            [Graph Construction]
            - Entity Resolution (동의어 및 개체 정합)
                       │
                       ▼
            [Hierarchical Community Detection]
            - Leiden Algorithm (계층적 커뮤니티 분할: Level 0 ──> Level 1 ──> Level 2)
                       │
                       ▼
            [Community Summarization]
            - LLM이 각 커뮤니티별 종합 보고서(Report) 생성
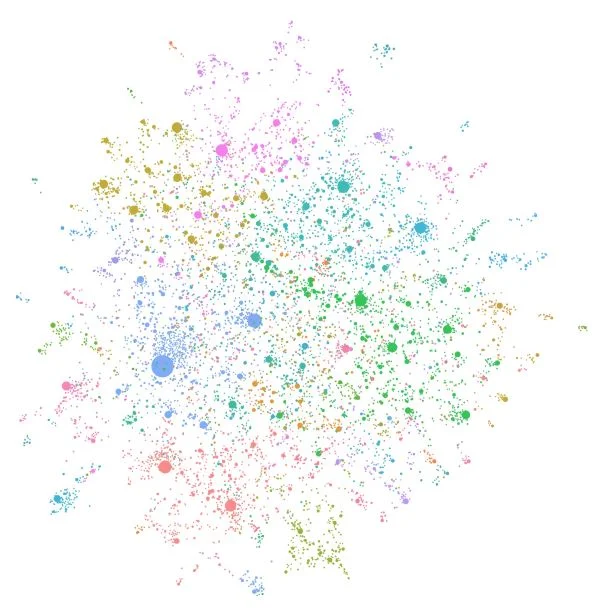
출처: Overview - GraphRAG 공식 문서 (https://microsoft.github.io/graphrag/)
2.1 Leiden 알고리즘을 통한 계층적 커뮤니티 분할
지식 그래프가 구축되면 수천~수십만 개의 노드와 간선이 형성된다. 이를 효율적으로 요약하기 위해 GraphRAG는 그래프 모듈성(Modularity)을 최적화하는 Leiden 알고리즘을 적용한다.
- 로컬 노드 이동: 노드들을 모듈성을 높이는 방향으로 이웃 커뮤니티로 재배치한다.
- 커뮤니티 정제(Refinement): 고립되거나 불완전하게 연결된 커뮤니티를 세부 분할한다.
- 그래프 축약(Aggregation): 각 커뮤니티를 상위 레벨의 단일 슈퍼 노드로 치환하여 계층 구조를 형성한다.
결과적으로 지식 그래프는 최하위 미시 커뮤니티(Level 0: 개별 팀, 프로젝트)부터 최상위 거시 커뮤니티(Level 2: 전사 전략, 산업 동향)까지 다층 계층으로 조직화된다.
2.2 Global Search vs. Local Search 쿼리 엔진
GraphRAG는 사용자 쿼리의 성격에 따라 완전히 다른 두 가지 검색 전략을 구사한다.
검색 전략 비교:
┌─────────────────┬──────────────────────────────────┬──────────────────────────────────┐
│ 구분            │ Global Search                    │ Local Search                     │
├─────────────────┼──────────────────────────────────┼──────────────────────────────────┤
│ 적합한 쿼리     │ "전체 문서의 주요 테마는 무엇인가?" │ "Alice의 보고 라인과 역할은?"     │
│ 쿼리 대상       │ 사전 생성된 커뮤니티 보고서들    │ 특정 엔티티의 이웃 서브그래프    │
│ 실행 방식       │ Map-Reduce 병렬 LLM 요약 평가    │ 엔티티 중심 $k$-hop 그래프 탐색  │
│ 토큰 소모량     │ 중간 (보고서만 입력 컨텍스트화)  │ 낮음 (관련 서브그래프만 조회)    │
└─────────────────┴──────────────────────────────────┴──────────────────────────────────┘
- Global Search:
- 질문이 들어오면 모든 커뮤니티 보고서를 여러 배치로 나누어 LLM에 입력한다(Map 단계).
- 각 배치는 점수(Score)와 함께 중간 요약 답변을 생성한다.
- 최상위 점수를 획득한 중간 답변들을 모아 최종 답변으로 종합한다(Reduce 단계). 원본 텍스트 청크를 일일이 검색하지 않고도 코퍼스 전체를 관통하는 거시적 답변을 도출한다.
- Local Search:
- 쿼리에서 핵심 엔티티를 식별한 후, 지식 그래프에서 해당 노드의 1~2홉(hop) 이웃 관계, 연관된 텍스트 청크, 연결된 공변량(Claims)을 수집하여 컨텍스트로 주입한다.
3. Neo4j GraphRAG 아키텍처: Labeled Property Graph + Vector
Microsoft GraphRAG가 정적 배치 인덱싱에 특화되어 있다면, Neo4j GraphRAG는 실시간 데이터 쓰기, 트랜잭션, 동적 스키마 쿼리를 지원하는 Labeled Property Graph (LPG) 기반 시스템이다.3
Neo4j GraphRAG 핵심 구성 요소:
┌────────────────────────────────────────────────────────────────────────┐
│ Neo4j 그래프 데이터베이스                                              │
│                                                                        │
│   ┌────────────────────────────────┐   ┌───────────────────────────┐   │
│   │ 지식 그래프 계층 (Nodes & Edges)│   │ 벡터 인덱스 (HNSW Index)  │   │
│   │ (:Person)-[:WORKS_AT]->(:Corp) │   │ Chunk 임베딩 공간         │   │
│   └────────────────────────────────┘   └───────────────────────────┘   │
└───────────────────────────────────┬────────────────────────────────────┘
                                    │
                                    ▼
       ┌────────────────────────────┼────────────────────────────┐
       ▼                            ▼                            ▼
[VectorRetriever]       [VectorCypherRetriever]      [Text2CypherRetriever]
 (단순 의미 검색)         (벡터 검색 후 2-hop 확장)     (자연어 ➔ Cypher 쿼리 변환)
3.1 3대 Retriever 전략
VectorRetriever:- 일반 벡터 데이터베이스와 동일하게 쿼리 임베딩과 문서 청크 간의 코사인 유사도를 계산하여 반환한다.
VectorCypherRetriever(하이브리드 확장):- 1단계: 벡터 인덱스를 통해 질문과 가장 유사한 상위 $k$개의 청크나 엔티티 노드를 식별한다.
- 2단계: 식별된 노드를 시작점(Entrypoint) 삼아 사전에 정의된 Cypher 쿼리를 실행하여 연결된 관계를 횡단(Traversal)한다.
// VectorCypherRetriever의 사후 탐색 쿼리 패턴
MATCH (node:Chunk)-[:MENTIONS]->(e:Entity)
MATCH (e)-[r:RELATION]-(neighbor:Entity)
RETURN node.text AS context, collect(DISTINCT e.name + ' - ' + type(r) + ' -> ' + neighbor.name) AS graph_context
Text2CypherRetriever:- 질문을 LLM을 통해 직접 Cypher 쿼리문으로 변환하여 실행한다. 집계, 정렬, 조건부 필터링 연산에 최적화되어 있다.
4. 실전 파이프라인 구축 예제 (Python SDK)
Neo4j GraphRAG 패키지를 사용하여 실전 지식 그래프 검색기를 구축하는 파이프라인이다.
from neo4j import GraphDatabase
from neo4j_graphrag.retrievers import VectorCypherRetriever
from neo4j_graphrag.embeddings import OpenAIEmbeddings
from neo4j_graphrag.llm import OpenAILLM

# 1. 드라이버 및 모델 초기화
driver = GraphDatabase.driver("bolt://localhost:7687", auth=("neo4j", "password"))
embeddings = OpenAIEmbeddings(model="text-embedding-3-small")
llm = OpenAILLM(model_name="gpt-4o")

# 2. 2-hop 지식 그래프 탐색 쿼리 정의
retrieval_query = """
MATCH (node:Chunk)-[:MENTIONS]->(e:Entity)
OPTIONAL MATCH (e)-[r:INTERACTS_WITH]-(target:Entity)
RETURN
    node.text AS text,
    score,
    {
        primary_entity: e.name,
        relationship: type(r),
        related_entity: target.name
    } AS metadata
"""

# 3. Vector-Cypher 하이브리드 리트리버 구성
retriever = VectorCypherRetriever(
    driver=driver,
    index_name="chunk_vector_index",
    embedder=embeddings,
    retrieval_query=retrieval_query,
)

# 4. 쿼리 실행
results = retriever.search(query_text="A 기업의 핵심 파트너와 공급망 위험요소", top_k=3)
for doc in results.items:
    print(f"[Score: {doc.score:.3f}] Content: {doc.content[:100]}...")
5. 프로덕션 엔지니어링 트레이드오프
Microsoft Research의 자체 평가에서는 GraphRAG가 팟캐스트 트랜스크립트 코퍼스의 전역 요약 질문에서 베이스라인 RAG보다 나은 결과를 보였다고 보고하지만1, 프로덕션 도입 시에는 다음과 같은 비용 및 운영 트레이드오프를 수반한다.
GraphRAG 도입 트레이드오프 매트릭스 (비용·지연은 개략 추정):
┌─────────────────┬─────────────────────────────┬─────────────────────────────┐
│ 평가 축         │ Naive Vector RAG            │ GraphRAG (Neo4j / MS)       │
├─────────────────┼─────────────────────────────┼─────────────────────────────┤
│ 오프라인 인덱싱 │ 빠름 (임베딩 모델 1회 호출) │ 느림 (청크마다 LLM 추출)    │
│ 인덱싱 비용     │ 임베딩 단가 수준            │ 추출 LLM 단가 × 전체 청크 수│
│ 데이터 동적 갱신│ 실시간 단일 청크 삽입 가능  │ 그래프 재연결 및 군집 재계산│
│ 쿼리 지연시간   │ 수 ms ~ 수십 ms             │ 수십ms~수백 ms (Cypher/LLM) │
│ 스키마 관리     │ 필요 없음 (단순 텍스트)     │ 온톨로지(Ontology) 관리 필요│
└─────────────────┴─────────────────────────────┴─────────────────────────────┘
표의 비용·지연 항목은 두 파이프라인의 호출 구조 차이(임베딩 호출 대비 청크당 LLM 추출 호출 추가)를 정리한 개략 추정이다. 실제 값은 사용 모델의 단가, 청크 크기, 코퍼스 규모, 동시 처리 수에 따라 크게 달라지며, 도입 판단 전에는 자체 코퍼스 일부를 표본으로 잡아 인덱싱 토큰과 응답 지연을 측정하는 편이 안전하다.
- 인덱싱 토큰 비용 증가:
- 모든 텍스트 청크에서 엔티티/관계를 추출하고 중복을 제거(Entity Resolution)하는 과정에서 청크 수에 비례하는 LLM 추출 호출이 발생한다. 임베딩 호출만 지불하는 벡터 인덱싱과 달리 추출 단계마다 입력·출력 토큰이 청구되므로, 초기 빌드 비용은 코퍼스 규모와 청크 크기에 따라 크게 늘어난다.
- 동적 쓰기 및 실시간성(Real-time Ingestion):
- 문서가 실시간으로 추가·수정되는 환경에서는 커뮤니티 계층 요약을 점진적으로(Incrementally) 갱신하는 파이프라인 구축이 매우 까다롭다.
- 스키마 드리프트(Schema Drift):
- 도메인 제약(Strict Ontology) 없이 LLM에게 자유롭게 관계 추출을 맡길 경우, 동일한 의미의 관계가 수십 가지 표현(
WORKS_AT,EMPLOYED_BY,AFFILIATED_WITH)으로 파편화되어 그래프 탐색 밀도가 훼손된다.
- 도메인 제약(Strict Ontology) 없이 LLM에게 자유롭게 관계 추출을 맡길 경우, 동일한 의미의 관계가 수십 가지 표현(
6. 결론: 언제 GraphRAG를 선택해야 하는가?
- Naive Vector RAG를 유지해야 하는 경우:
- FAQ 검색, 고객 지원 단일 문서 조회 등 사실 검색 위주의 워크로드.
- 데이터가 초당 수십 건씩 지속적으로 변경되며 색인 비용을 최소화해야 하는 환경.
- GraphRAG를 필수 도입해야 하는 경우:
- 법률 판례 분석, 복잡한 M&A 실사 보고서, 감사 데이터 분석 등 수많은 문서 간의 연결 고리와 인과 관계를 밝혀내야 하는 도메인.
- 전체 코퍼스의 거시적 주제와 경향성을 요약해야 하는 엔터프라이즈 인텔리전스 시스템.
- 관계 기반 그래프 탐색(2-hop Traversal)과 의미적 유사도 검색을 결합한 VectorCypher 하이브리드 패턴을 구축할 수 있을 때 가장 높은 투자 대비 효과(ROI)를 거둘 수 있다.
References
-
From Local to Global: A Graph RAG Approach to Query-Focused Summarization — Microsoft Research, 평가는 팟캐스트 트랜스크립트 코퍼스와 LLM 판정 기준으로 수행되었다. ↩ ↩2
-
Overview - GraphRAG 공식 문서 — 파이프라인·커뮤니티 요약 설명 및 지식 그래프 도식 출처. ↩
-
Neo4j GraphRAG for Python 공식 문서 —
VectorRetriever,VectorCypherRetriever,Text2CypherRetrieverAPI 및 LPG 기반 검색 패턴. ↩
댓글남기기