
LangGraph 아키텍처 심층 분석: StateGraph, 순환 제어, Checkpointer 및 멀티 에이전트 런타임 설계
생성형 AI 애플리케이션이 단순한 프롬프트-응답 질의응답을 넘어, 다단계 추론(Multi-step Reasoning)과 외부 도구 호출, 그리고 환경과의 상호작용을 수행하는 자율 에이전트(Autonomous Agent)로 진화하면서 기존 프레임워크들의 한계가 드러나기 시작했다.
LangChain이나 LlamaIndex의 초기 아키텍처는 주로 방향성 비순환 그래프(DAG, Directed Acyclic Graph) 형태의 선형 체인(Chain) 파이프라인에 최적화되어 있었다. 그러나 실제 엔터프라이즈 환경의 에이전트는 도구 실행 오류 시 재시도, 사용자의 중간 피드백 반영, 반성(Reflection) 및 자체 수정(Self-correction)과 같은 순환 루프(Cyclic Execution)와 상태 지속성(State Persistence)을 필수적으로 요구한다.
LangGraph는 이러한 구조적 병목을 해결하기 위해 분산 그래프 처리 엔진인 Google Pregel의 동시성 모델을 차용하여 설계된 에이전트 오케스트레이션 프레임워크다. 이 글에서는 LangGraph의 코어 런타임 메커니즘, 상태 리듀서(State Reducer)의 동작 원리, 체크포인터를 통한 상태 관리와 Human-in-the-loop 아키텍처, 그리고 대규모 멀티 에이전트 설계 패턴을 분석한다.
1. 패러다임 전환: 왜 DAG 체인에서 순환 그래프(Graph)인가?
전통적인 LLM 체인은 입력이 주어지면 프롬프트 템플릿 → 모델 호출 → 출력 파서로 이어지는 일방향 파이프라인으로 구성된다.
단순 체인(DAG) vs. 에이전트 그래프(Cyclic Graph):
[DAG Chain]
  User Input ──> Prompt ──> LLM ──> Tool Call ──> Output Parser ──> End (오류 발생 시 롤백 불가)

[Cyclic Graph]
                  ┌────────────┐
                  │ Plan/Draft │ <────────┐ (Self-Correction Loop)
                  └─────┬──────┘          │
                        ▼                 │
  User Input ──> ┌─────────────┐   Fail   │
                 │ Tool Execute ├─────────┤
                 └──────┬──────┘          │
                        │ Success         │
                        ▼                 │
                 ┌─────────────┐          │
                 │ Evaluation  ├──────────┘
                 └──────┬──────┘
                        │ Pass
                        ▼
                       End
DAG 기반 파이프라인으로 순환 에이전트를 억지로 구현할 경우 다음과 같은 시스템 결함이 발생한다.
- 상태 관리의 파편화: 루프가 돌 때마다 대화 컨텍스트, 도구 호출 결과, 중간 변수들이 전역 변수나 래퍼 클래스에 산발적으로 누적되어 상태 일관성이 깨진다.
- 동적 분기의 복잡도 폭증: 도구 실행 성공 여부나 에러 코드에 따라 분기할 때 체인 내부에 거대한 if-else 문이 중첩되어 제어 흐름(Control Flow) 추적이 불가능해진다.
- 트랜잭션 중단 및 복구 불가: 긴 실행 주기를 갖는 워크플로우 중간에 시스템이 재시작되거나 사람의 승인이 필요할 때, 정확한 중간 상태에서 실행을 일시정지하고 재개(Resume)할 방법이 부재하다.
LangGraph는 모든 실행 흐름을 명시적인 노드(Node, 연산 단위)와 엣지(Edge, 제어 전이), 그리고 전체를 관통하는 상태(State, 데이터 채널)로 추상화해, 복잡한 비선형 흐름을 코드로 추적하고 재현할 수 있는 형태로 관리한다.
2. LangGraph 런타임의 기원: Google Pregel과 BSP 모델
LangGraph의 내부 실행 엔진은 대규모 분산 그래프 알고리즘을 처리하기 위해 Google이 개발한 Pregel 논문1의 BSP(Bulk Synchronous Parallel) 계산 모델에 뿌리를 두고 있다.2
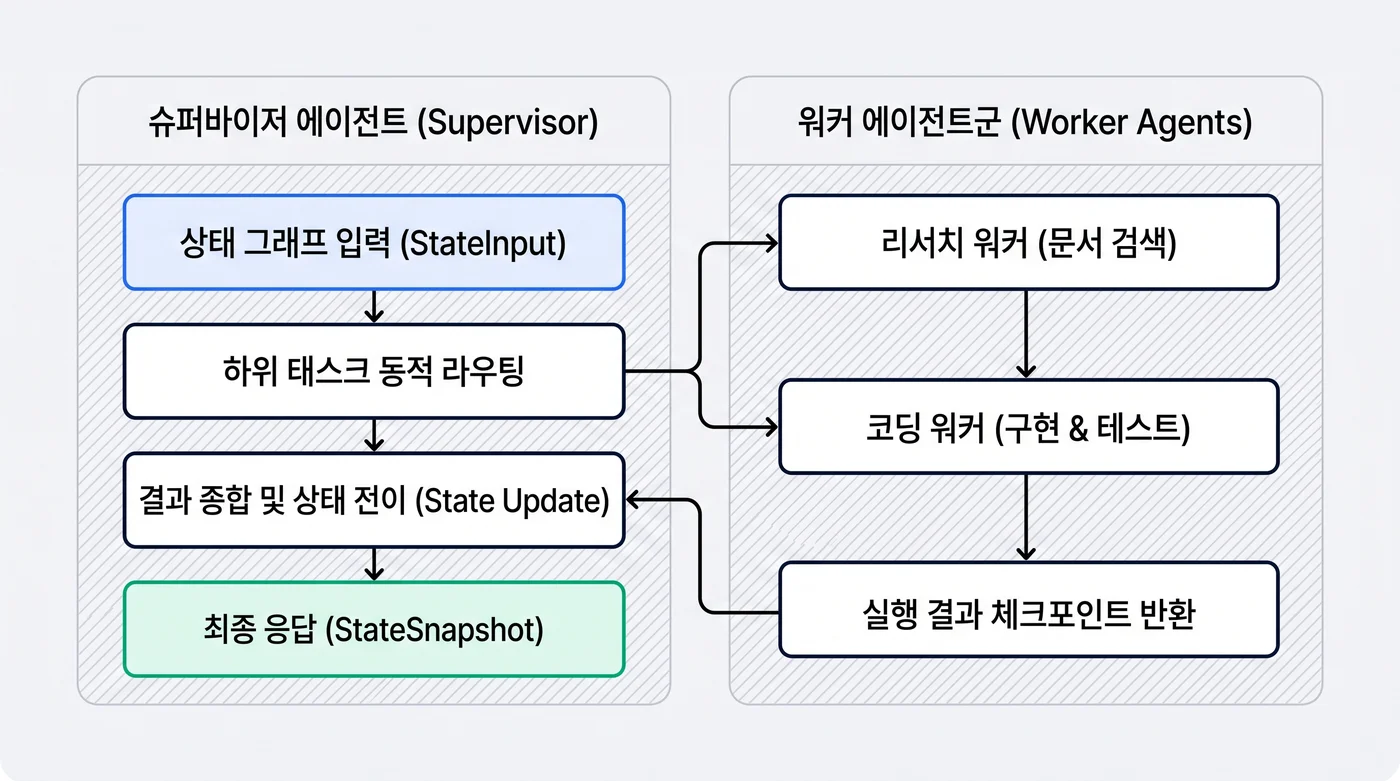
2.1 슈퍼스텝(Superstep) 기반 동시 실행
Pregel은 전체 연산을 일련의 순차적인 슈퍼스텝(Superstep)으로 나눈다. 각 슈퍼스텝 내에서 일어나는 과정은 다음과 같다.
- 동시 노드 실행(Local Computation): 활성화된 모든 노드가 이전 스텝에서 전달받은 상태(채널 데이터)를 읽고 자신의 로직을 병렬로 수행한다.
- 메시지 방출(Message Passing / State Mutation): 각 노드는 자신의 계산 결과를 특정 채널로 전달하는 업데이트 딕셔너리를 생성한다.
- 동기화 장벽(Barrier Synchronization): 현재 스텝의 모든 활성 노드가 연산을 마칠 때까지 대기한 후, 한 번에 채널 업데이트를 적용하고 다음 슈퍼스텝으로 진입한다.
이 동기화 장벽 덕분에 채널 갱신은 노드가 실행되는 도중이 아니라 슈퍼스텝 경계에서 한꺼번에 적용된다. 각 노드의 부분 갱신이 다른 노드에 즉시 노출되지 않으므로, 실행 상태는 매 슈퍼스텝 단위의 일관된 스냅샷으로 유지된다.
다만 같은 채널에 여러 노드가 동시에 쓸 때의 최종 값은 그 채널에 등록된 리듀서(Reducer) 함수가 결정하므로, 결과의 결정론(Determinism)은 리듀서 자체가 결정론적일 때만 성립한다.
3. 핵심 3대 구성요소와 State Reducer 메커니즘
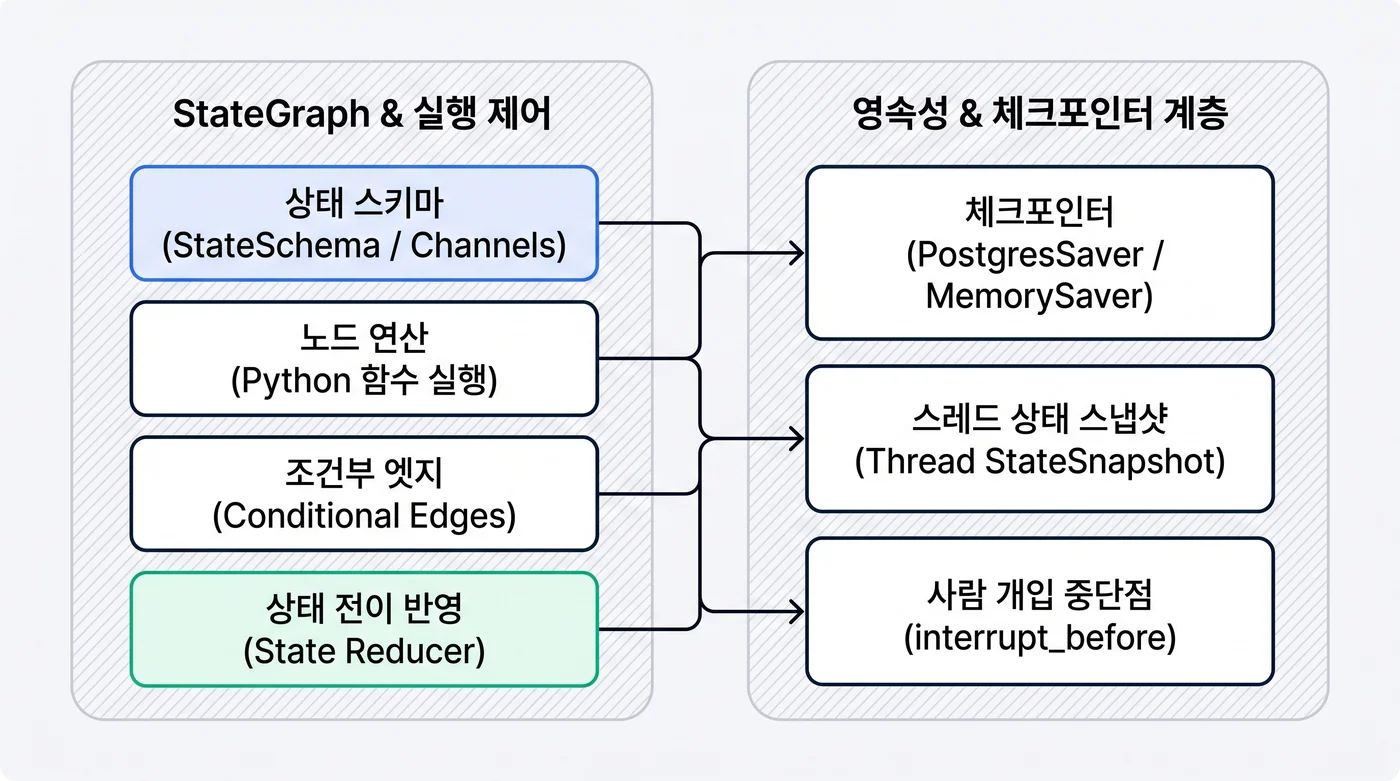
LangGraph 시스템은 State(상태), Node(연산), Edge(전이)의 세 가지 핵심 프리미티브로 조립된다.
from typing import Annotated, TypedDict
import operator
from langgraph.graph import StateGraph, START, END

# 1. State 정의: 채널별 Reducer 바인딩
class AgentState(TypedDict):
    # operator.add는 새 메시지를 기존 리스트 뒤에 추가(append)하는 리듀서
    messages: Annotated[list[str], operator.add]
    current_step: int
    is_completed: bool
3.1 채널(Channel)과 Reducer의 내부 동작
LangGraph의 State는 단순한 공유 딕셔너리가 아니라, 내부적으로 독립적인 채널(Channel)들의 집합이다. 기본적으로 상태 필드는 새로운 값이 들어오면 기존 값을 덮어쓴다(Overwrite).
그러나 대화 기록(Message History)이나 분기 노드들의 수집 결과처럼 데이터가 누적되어야 하는 경우, Python typing.Annotated를 통해 리듀서(Reducer) 함수를 명시적으로 등록한다.
operator.add: 리스트를 이어 붙인다(list1 + list2). 노드가{"messages": [new_msg]}를 반환하면, 해당 슈퍼스텝의 갱신 적용 단계에서 기존 리스트 뒤에 이어 붙는다.- 커스텀 리듀서: ID 기반 메시지 교체(Update-or-Append)나 중복 제거 등 복잡한 상태 병합 정책을 직접 구현할 수 있다.
def merge_documents(current: list[dict], new_docs: list[dict]) -> list[dict]:
    """문서 ID 기준 중복 방지 리듀서"""
    existing_ids = {doc["id"] for doc in current}
    return current + [doc for doc in new_docs if doc["id"] not in existing_ids]

class RAGState(TypedDict):
    query: str
    documents: Annotated[list[dict], merge_documents]
3.2 Node와 Conditional Edge의 분리
- Node: 현재 State를 입력받아 변경하고자 하는 상태 부분집합(Partial Update)을 반환하는 순수 함수 또는 비동기 함수다.
- Conditional Edge: 상태를 평가하여 다음으로 전이할 노드의 이름을 동적으로 결정한다. 라우팅 로직을 비즈니스 로직(Node) 내부에서 분리해 냄으로써 단일 책임 원칙(SRP)을 유지한다.
def route_after_evaluation(state: AgentState) -> str:
    if state["is_completed"]:
        return END
    elif state["current_step"] > 5:
        return "fallback_node"
    return "refine_node"

# 그래프 빌더 구성
builder = StateGraph(AgentState)
builder.add_node("agent", call_agent)
builder.add_node("refine_node", refine_answer)
builder.add_node("fallback_node", fallback_handler)

builder.add_edge(START, "agent")
builder.add_conditional_edges("agent", route_after_evaluation)
builder.add_edge("refine_node", "agent")  # 순환 엣지 (Feedback loop)
4. 영속성(Persistence)과 프로덕션 신뢰성 아키텍처
실제 프로덕션 환경에서 LangGraph의 차별점은 내장된 체크포인터(Checkpointer) 엔진이다.5
체크포인터 수명주기:
  Superstep 0 ──> [Save Checkpoint] ──> thread_id="session_101", checkpoint_id="step_0"
       │
  Superstep 1 ──> [Save Checkpoint] ──> thread_id="session_101", checkpoint_id="step_1"
       │
  [Human-in-the-Loop Interrupt] (실행 일시정지)
       │ ──> 사용자 피드백 대기 또는 상태 수정 (State Rewriting)
  [Resume Execution] (정확히 step_1 시점의 채널 상태에서 재개)
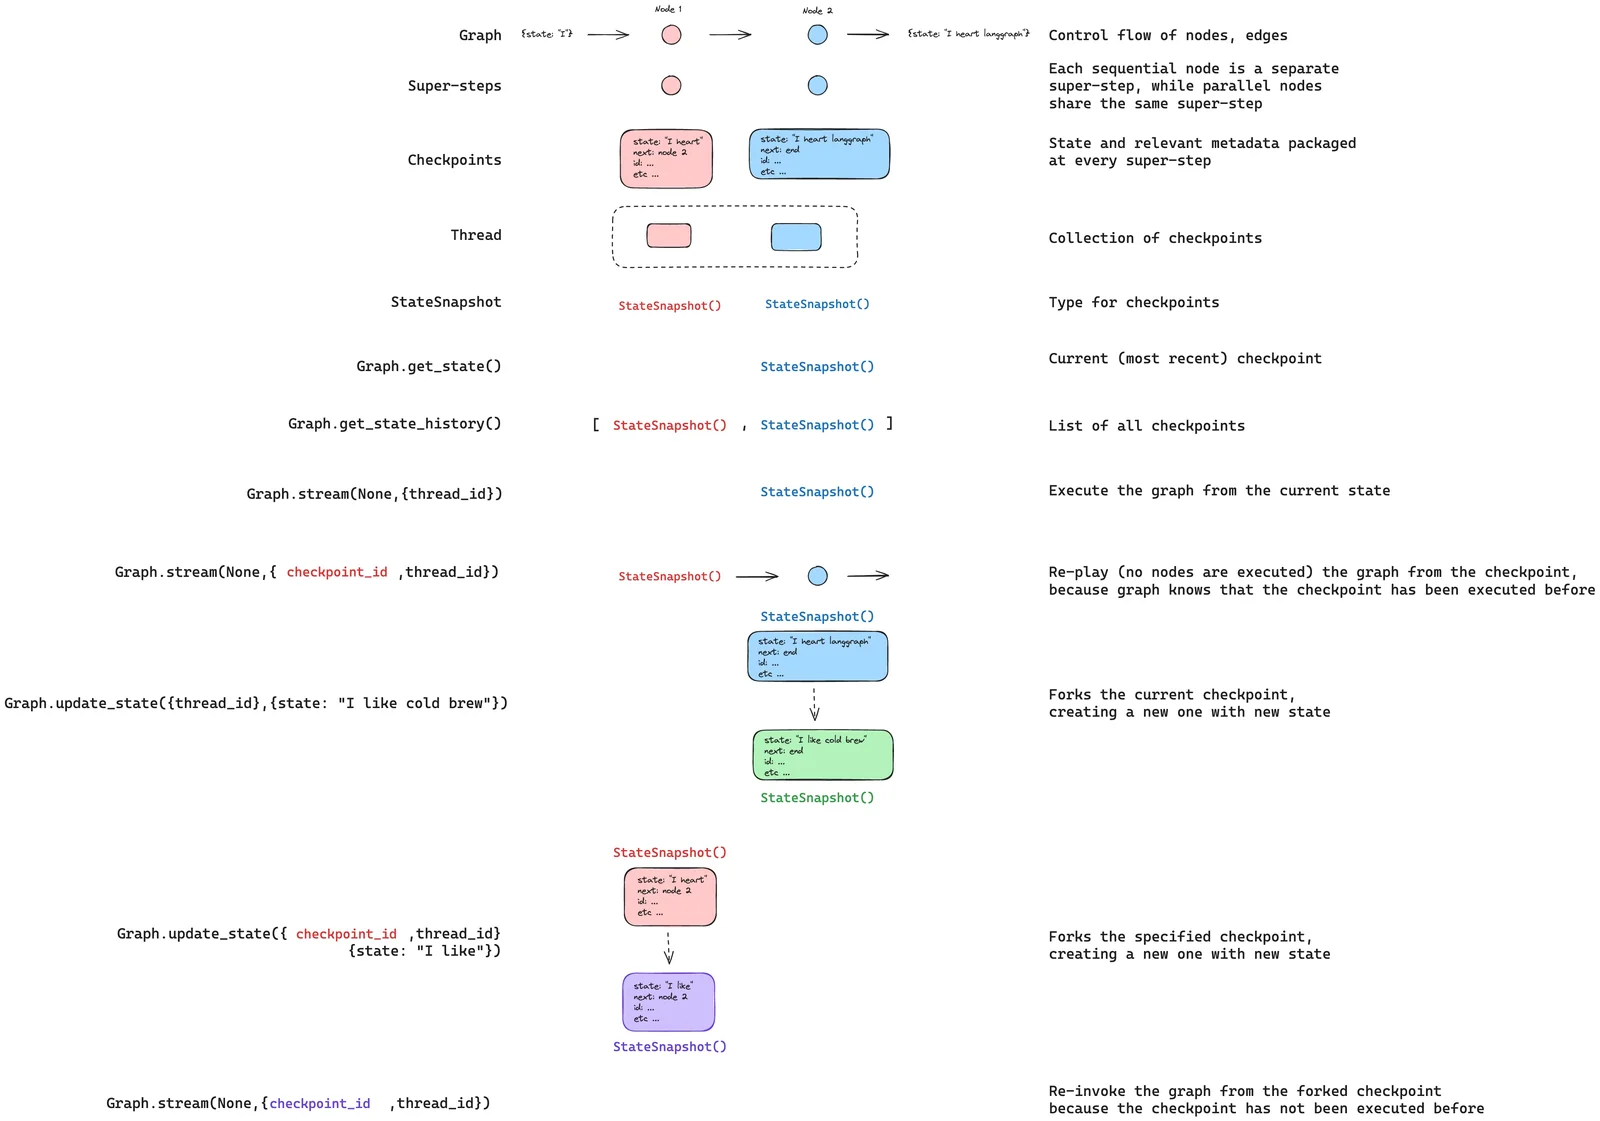
출처: LangGraph 공식 문서, Checkpointers (https://docs.langchain.com/oss/python/langgraph/checkpointers)
4.1 Checkpointer 메커니즘: MemorySaver vs. PostgresSaver
매 슈퍼스텝이 끝날 때마다 그래프의 전체 채널 상태는 스냅샷(Snapshot)으로 직렬화되어 체크포인터에 커밋된다.
MemorySaver/InMemorySaver: 체크포인트를 프로세스 메모리(RAM)에 저장하므로 재시작하면 모두 사라진다. 로컬 개발·단위 테스트용이며 운영에는 쓸 수 없다.5PostgresSaver/AsyncPostgresSaver: PostgreSQL에 스냅샷을 영구 보관한다. 컨테이너 장애나 Pod 재기동이 발생해도 같은thread_id로 중단 지점의 체크포인트에서 실행을 재개할 수 있다.5
4.2 Human-in-the-loop: 중단(Interrupt)과 상태 재작성
고위험 도구 호출(예: 금융 거래, DB 레코드 삭제, 이메일 전송)을 수행하기 전에 시스템은 안전장치를 필요로 한다. LangGraph는 interrupt_before와 interrupt_after 플래그를 통해 특정 노드 진입 직전/직후에 실행을 자동으로 중단한다.
from langgraph.checkpoint.memory import MemorySaver

memory = MemorySaver()
app = builder.compile(checkpointer=memory, interrupt_before=["sensitive_tool_node"])

# 1. 실행 중단 지점까지 진행
config = {"configurable": {"thread_id": "tx_994"}}
events = app.stream({"query": "운영 DB 롤백 실행"}, config)

# 2. 현재 상태 조회
state = app.get_state(config)
print("다음 실행 예정 노드:", state.next)  # ('sensitive_tool_node',)

# 3. 사람이 검토 후 승인하면 None 입력으로 이어서 실행 (Resume)
app.invoke(None, config)
4.3 Time Travel: 상태 되감기와 대체 분기 탐색
영속 백엔드에 연결한 체크포인터에서는 모든 체크포인트가 고유한 ID로 기록되므로, LangGraph에서는 과거 시점으로 상태를 되돌려 실행을 다시 분기시키는 타임 트래블(Time Travel)이 지원된다.
- 디버깅: 에이전트가 오답을 낸 3단계 이전 스텝으로 이동하여 상태 값을 검사하고, 프롬프트를 수정하여 재실행할 수 있다.
- What-If 시뮬레이션: 사용자가 “방금 답변을 기술적인 어조가 아니라 쉬운 어조로 다시 설명해줘”라고 요청했을 때, 처음부터 다시 실행하지 않고 해당 노드 직전의 체크포인트 상태만 업데이트하여 재분기할 수 있다.
4.4 체크포인터의 실패 조건과 운영 트레이드오프
체크포인터는 복구와 중단을 가능하게 하지만 제약이 따른다. 공식 문서에 명시된 조건을 알고 써야 한다.6
- 스냅샷은 슈퍼스텝 경계에서만 만들어진다: 노드 함수 내부에서 프로세스가 죽으면 그 노드는 이전 체크포인트를 기준으로 처음부터 다시 실행된다. 같은 슈퍼스텝에서 이미 끝난 다른 노드의 쓰기는 기록되어 있어 재실행되지 않는다. 결제·DB insert처럼 부작용이 있는 노드는 멱등(Idempotent)하게 만들거나 작은 노드로 쪼개야 한다.7
- 쓰기 시점(durability)을 선택해야 한다:
"sync"는 다음 스텝이 시작되기 전에 동기적으로 기록해 내구성이 가장 높고 성능 부담이 따르며,"async"는 다음 스텝 실행 중 비동기로 기록하므로 그 사이에 크래시가 나면 마지막 체크포인트가 유실될 수 있고,"exit"는 그래프 실행이 끝날 때만 기록해 빠르지만 중간 상태 복구가 불가능하다.5 - 상태는 직렬화 가능한 값이어야 한다: 체크포인트는 기본
JsonPlusSerializer로 직렬화되며 Pydantic 모델, dataclass, numpy 배열, datetime, enum 등은 자동 처리된다. 그 밖의 타입을 State에 담으려면 커스텀 직렬화기를 등록해야 한다.5 - 저장소는 계속 커진다: 기본 동작은 매 슈퍼스텝마다 모든 채널의 전체 값을 기록하는 방식이라 다중 턴 대화나 긴 루프에서는 조회 지연과 저장 비용이 함께 늘어난다. 보존 기간을 정하고 오래된 체크포인트를 주기적으로 정리해야 한다.6
thread_id에 형식 제약이 있다:PostgresSaver는thread_id를 길이 제한이 있는 컬럼에 저장하므로 255자를 넘기면 DB 오류가 발생한다. UUID나 해시를 쓰는 편이 안전하다.6- 순환은 스스로 끝나지 않는다: 그래프 실행은 종료 조건을 코드로 넣지 않으면 계속 돈다. 실행당 슈퍼스텝 수가
recursion_limit을 넘으면GraphRecursionError가 발생하며, 1.0.6 이후 기본값은 1000이다.7
5. 프로덕션 멀티 에이전트 오케스트레이션 패턴
단일 에이전트에 도구가 지나치게 많아지면 어떤 도구를 써야 할지 잘못 고르는 경우가 늘고, 도메인 지식과 긴 프롬프트가 필요한 작업에서는 컨텍스트 윈도우가 병목이 된다. LangChain 공식 문서도 이 두 상황을 멀티 에이전트 패턴이 유효해지는 조건으로 든다.8 LangGraph로 구현하는 대표적인 설계 패턴 3가지는 다음과 같다.
대표적인 멀티 에이전트 토폴로지:
1. Supervisor 패턴:       2. Network (Swarm) 패턴:      3. 계층형 팀 (Hierarchical):
     [Supervisor]              [Agent A] ── [Agent B]             [Top Supervisor]
     ┌────┼────┐                    │           │                    ┌────┴────┐
     ▼    ▼    ▼                    └── [Agent C]            [Dev Team]      [QA Team]
  [A1]  [A2]  [A3]                                             ┌─┴─┐           ┌─┴─┐
                                                             [W1] [W2]       [W3] [W4]
- Supervisor 패턴 (중앙 집중형 제어):
- 최상위 슈퍼바이저 LLM 노드가 현재 상태를 보고 다음 작업을 수행할 전문가 에이전트 노드(
Researcher,Coder,Reviewer)를 선택한다. - 각 하위 에이전트는 작업을 마치면 항상 슈퍼바이저에게 결과를 보고하며, 슈퍼바이저가 완료 여부를 판정한다.
- 최상위 슈퍼바이저 LLM 노드가 현재 상태를 보고 다음 작업을 수행할 전문가 에이전트 노드(
- Network / P2P 패턴 (분산 협업):
- 에이전트들이 서로를 직접 호출할 수 있는 메시지 패싱 네트워크다. 자율성이 높고 상호작용이 유연하지만, 무한 루프 탐지 및 발산 제어가 까다롭다.
- 계층형 팀(Hierarchical Agent Teams) 패턴:
- 하위 팀 자체가 하나의 독립된 컴파일된 LangGraph 서브그래프(Subgraph)로 구성된다.
- 상위 그래프 관점에서는 서브그래프 전체가 하나의 단일 노드로 추상화되므로, 에이전트 수가 늘어 팀 단위로 경계를 나눠 관리해야 하는 규모에 적합하다.
- 제약도 있다. 서브그래프는 자체 체크포인트 네임스페이스(
checkpoint_ns)를 관리하므로 서브그래프의 상태 변경이 부모 그래프에 즉시 보이지 않는다. 그래프 경계를 넘어 공유해야 하는 데이터는Store로 분리해야 한다.6
6. 결론: 에이전틱 AI 설계를 위한 아키텍처 체크리스트
LangGraph를 프로덕션에 도입할 때 점검해야 할 핵심 설계 지침은 다음과 같다.
- 상태의 최소화(Minimal State): 모든 대화와 도구 출력을 State에 무분별하게 누적하지 말고, 필요한 정보만 추출하여 저장하는 요약 및 필터링 채널을 설계하라.
- 결정론적 라우팅 우선: 모든 분기를 LLM 판단(Conditional Edge)에 맡기지 말고, 상태 플래그나 에러 코드 등 결정론적으로 판단 가능한 조건은 정적 파이썬 함수로 처리하여 지연시간과 비용을 줄여라.
- 영속적 체크포인터 바인딩: 분산 컨테이너 환경에서는 반드시
PostgresSaver와 같은 영속 백엔드를 연결하고,thread_id네임스페이스를 테넌트별로 엄격히 격리하라. - 안전 경계 수립: 파일 시스템 수정, API 키 발급, 데이터베이스 쓰기 등 부작용(Side-effect)이 큰 노드 앞에는
interrupt_before를 배치하여 운영 안정성을 확보하라.
References
-
(서드파티 블로그) Langgraph Chapter 2: Build a simple graph ↩
-
(서드파티 블로그) LangGraph for Beginners: A Comprehensive Guide to Building AI Agents ↩
-
LangGraph 공식 문서, Checkpointers — https://docs.langchain.com/oss/python/langgraph/checkpointers ↩ ↩2 ↩3 ↩4 ↩5
-
LangGraph 공식 문서, Persistence — https://docs.langchain.com/oss/python/langgraph/persistence ↩ ↩2 ↩3 ↩4
-
LangGraph 공식 문서, Graph API(노드 재실행·멱등성, recursion limit) — https://docs.langchain.com/oss/python/langgraph/graph-api ↩ ↩2
-
LangChain 공식 문서, Multi-agent — https://docs.langchain.com/oss/python/langchain/multi-agent ↩
댓글남기기