
엔터프라이즈 API 아키텍처와 FastAPI 프로덕션 엔지니어링: REST·GraphQL·gRPC 비교부터 무중단 서빙까지
엔터프라이즈 마이크로서비스 및 AI 플랫폼 아키텍처에서 API 계층은 단순한 엔드포인트의 모음이 아니다. 외부 사용자와 내부 분산 시스템 간의 지연시간(Latency), 네트워크 대역폭(Throughput), 시스템 가용성(High Availability), 그리고 개발자 경험(DX)을 결정짓는 핵심 관문이다.
특히 LLM 에이전트나 실시간 추론 파이프라인처럼 토큰 단위 스트리밍과 높은 동시성을 요구하는 워크로드가 결합되면, 전통적인 동기식(스레드 기반) 프레임워크는 워커 스레드가 모두 점유되는 순간 신규 요청이 큐에 쌓이며 지연이 급격히 늘어난다. 이 글에서는 REST, GraphQL, gRPC의 아키텍처 트레이드오프를 정밀 비교하고, FastAPI를 활용한 비동기 엔지니어링 패턴(SSE 스트리밍, 의존성 주입), Redis 기반 복원력 설계, 그리고 Gunicorn + Uvicorn 프로덕션 배포 스택을 심층 분석한다.
1. 분산 시스템에서의 3대 API 패러다임 트레이드오프
모든 유스케이스를 만족하는 단일 API 프로토콜은 존재하지 않는다. 각 패러다임은 서로 다른 계층의 문제를 해결하기 위해 최적화되어 있다.
API 패러다임별 직렬화 및 전송 계층 매트릭스:
┌─────────────────┬──────────────────────┬──────────────────────┬───────────────────────────────────────┐
│ 패러다임        │ REST                 │ GraphQL              │ gRPC                                  │
├─────────────────┼──────────────────────┼──────────────────────┼───────────────────────────────────────┤
│ 페이로드 직렬화 │ JSON (텍스트)        │ JSON (텍스트)        │ Protocol Buffers (바이너리 압축)      │
│ 기본 전송 계층  │ HTTP/1.1 또는 HTTP/2 │ HTTP/1.1 중심        │ HTTP/2 (다중화·프레이밍)              │
│ 네트워크 효율   │ 보통 (헤더 오버헤드) │ 높음 (필요 필드만)   │ 높음 (바이너리 인코딩, 페이로드 의존) │
│ 엣지 캐싱       │ 네이티브 HTTP 캐싱   │ 어려움 (POST 기반)   │ 불가 (애플리케이션 캐싱)              │
│ 스트리밍 지원   │ SSE, WebSockets      │ Subscriptions        │ 단방향 및 양방향 네이티브 스트림      │
│ 주 권장 도메인  │ 외부 공개 B2B/BC API │ 복잡한 프런트엔드 UI │ 내부 마이크로서비스 간 고속 통신      │
└─────────────────┴──────────────────────┴──────────────────────┴───────────────────────────────────────┘
1.1 gRPC: 내부 서비스 간 고속 RPC
- Protocol Buffers (Protobuf): 스키마 파일(
.proto)로부터 엄격한 타입의 바이너리 인코딩 코드를 생성한다. 공식 문서는 JSON보다 “작고 빠르다”는 정성적 비교만 제시하고 구체적인 배수는 밝히지 않는다1. 실제 격차는 페이로드의 필드 밀도, 문자열 비중, 언어 런타임에 따라 달라지므로 직렬화 시간과 대역폭 절감폭은 대상 페이로드로 직접 측정해야 한다. - HTTP/2 멀티플렉싱(Multiplexing): 단일 TCP 커넥션 위에서 요청/응답 스트림을 프레임 단위로 교차 전송해, HTTP/1.1 파이프라이닝이 안고 있던 애플리케이션 계층 Head-of-Line Blocking을 완화한다. 동시 스트림 수는 서버가 광고하는
SETTINGS_MAX_CONCURRENT_STREAMS가 제한하며, RFC 9113은 이 값의 권고 하한을 100으로 둔다2. TCP 계층의 Head-of-Line Blocking은 그대로 남는다.
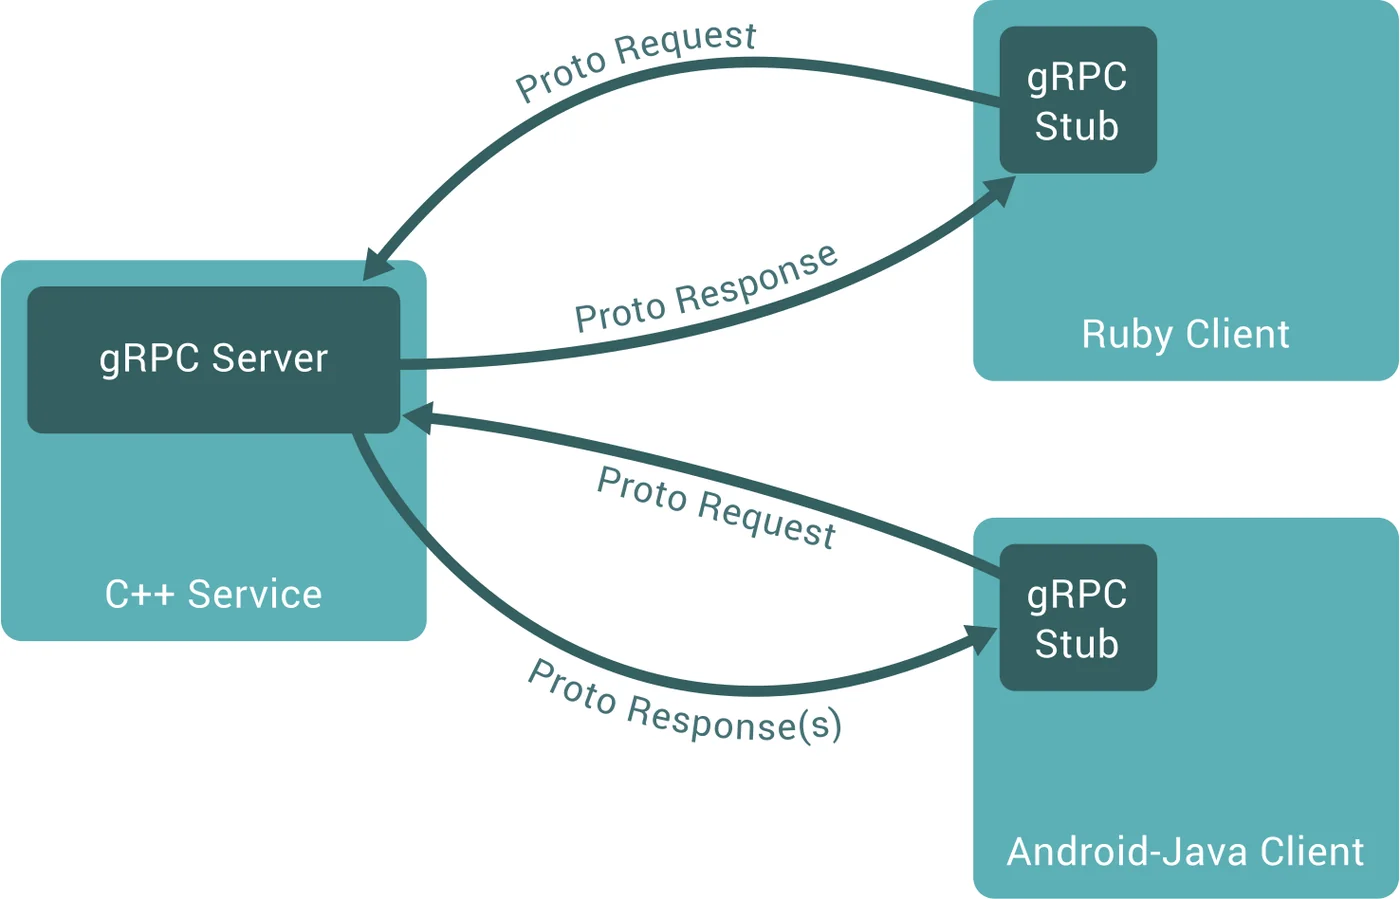
도식은 여러 언어의 클라이언트가 각자의 gRPC 스텁으로 하나의 서버와 요청/응답을 주고받는 구조를 보여준다3. 출처: Introduction to gRPC (https://grpc.io/docs/what-is-grpc/introduction/) — gRPC 문서 콘텐츠는 CC BY 4.0.
1.2 GraphQL: 프런트엔드 데이터 소비의 유연성
- Over/Under-fetching 방지: 클라이언트가 필요한 데이터 형태를 정확히 지정하므로 단일 쿼리로 여러 엔티티를 한 번에 조회할 수 있다.
- 아키텍처 트레이드오프: 백엔드에서 관계형 데이터를 매핑할 때 $N+1$ 쿼리 폭증 문제가 빈번히 발생하므로, DataLoader 패턴을 통한 배치(Batch) 룩업 최적화가 필수적이다.
1.3 선택을 뒤집는 제약 조건
프로토콜 선택은 성능표만으로 끝나지 않는다. 아래 조건이 하나라도 걸리면 앞의 우위는 뒤집힌다.
- 브라우저에서 직접 호출할 수 없다: gRPC는 브라우저가 노출하지 않는 HTTP/2 프레이밍과 트레일러에 의존한다. 웹 클라이언트가 필요하면 gRPC-Web과 별도 프록시(공식 퀵스타트는 Envoy를 쓴다)를 함께 운영해야 하므로4, 외부 공개 API를 gRPC 단독으로 노출하는 구성은 성립하지 않는다.
- L4 로드 밸런싱으로는 스트림이 분산되지 않는다: 하나의 장수명 HTTP/2 커넥션에 여러 스트림이 실리므로 커넥션 단위로만 분산하는 L4 계층에서는 특정 백엔드로 부하가 쏠린다. 스트림 단위 분산이 필요하면 L7 프록시나 클라이언트 사이드 LB를 추가해야 한다5.
- 디버깅과 캐싱 비용: 바이너리 페이로드는 프록시 로그나 브라우저 개발자 도구에서 읽기 어렵고, 위 매트릭스대로 엣지 캐싱도 성립하지 않는다. 사람이 눈으로 확인해야 하는 공개 API에는 REST가 여전히 유리하다.
- GraphQL도 비용이 0이 아니다: 스키마와 리졸버 계층이 늘고, DataLoader로 N+1을 막지 못하면 DB 부하는 REST보다 커진다. POST 단일 엔드포인트라 CDN 캐싱과 엔드포인트별 지표 수집에도 별도 설계가 필요하다.
2. 프로덕션 FastAPI 엔지니어링 아키텍처
FastAPI는 Starlette의 비동기 코어와 Pydantic의 데이터 검증 엔진을 결합해, I/O 대기 비중이 큰 워크로드에서 동시 처리량을 높인다. 다만 엔드포인트 안에서 동기 블로킹 호출을 그대로 부르면 이벤트 루프가 멈추므로, 아래 패턴은 비동기 드라이버 사용을 전제로 한다.
2.1 AI 토큰 스트리밍을 위한 SSE(Server-Sent Events) 아키텍처
LLM 텍스트 생성은 첫 토큰부터 마지막 토큰까지 수 초 이상 소요된다. 전체 응답을 모아 한 번에 반환하면 첫 토큰까지의 체감 지연시간(TTFT)이 전체 생성 시간만큼 늘어난다. FastAPI의 StreamingResponse를 활용하여 표준 SSE 스트림을 구현해야 한다.
from fastapi import FastAPI
from fastapi.responses import StreamingResponse
import asyncio
import json

app = FastAPI()

async def generate_token_stream(prompt: str):
    """비동기 LLM 토큰 생성 제너레이터 시뮬레이션"""
    tokens = ["대규모 ", "언어 ", "모델의 ", "추론 ", "결과입니다."]
    for token in tokens:
        await asyncio.sleep(0.05)  # 실제 서빙 엔진(vLLM) 스트리밍 연동 지점
        payload = {"token": token, "done": False}
        yield f"data: {json.dumps(payload, ensure_ascii=False)}\n\n"
    yield f"data: {json.dumps({'done': True})}\n\n"

@app.post("/v1/chat/completions/stream")
async def chat_stream(prompt: str):
    return StreamingResponse(
        generate_token_stream(prompt),
        media_type="text/event-stream",
        headers={
            "Cache-Control": "no-cache",
            "Connection": "keep-alive",
            "X-Accel-Buffering": "no"  # Nginx 역방향 프록시의 버퍼링 방지 필수
        }
    )
엔지니어링 팁: Nginx나 리버스 프록시 뒤에 배포할 때
X-Accel-Buffering: no헤더를 누락하면, Nginx가 청크를 일정 버퍼 크기까지 모았다가 전달하므로 클라이언트에서 실시간 스트리밍이 작동하지 않는다.
한 가지 제약을 같이 기억해 두자. SSE 연결은 응답이 끝날 때까지 워커 슬롯과 커넥션을 점유한다. 탭을 여러 개 열어 두는 사용자층이 있다면 브라우저당 연결 수가 곱해지므로, HTTP/2 이상으로 서빙하고 서버·프록시 양쪽의 동시 연결 상한을 별도로 관리해야 한다.
2.2 의존성 주입(Dependency Injection)과 DB 커넥션 풀링
Depends 메커니즘은 단순한 코드 재사용 도구가 아니라, 요청 단위(Per-request)의 트랜잭션 격리와 자원 라이프사이클 관리자다.
from typing import AsyncGenerator
from fastapi import Depends
from sqlalchemy.ext.asyncio import create_async_engine, async_sessionmaker, AsyncSession

engine = create_async_engine(
    "postgresql+asyncpg://user:pass@db:5432/prod",
    pool_size=20,
    max_overflow=10,
    pool_pre_ping=True
)
AsyncSessionLocal = async_sessionmaker(engine, expire_on_commit=False)

async def get_db_session() -> AsyncGenerator[AsyncSession, None]:
    async with AsyncSessionLocal() as session:
        try:
            yield session
            await session.commit()
        except Exception:
            await session.rollback()
            raise
3. API 복원력(Resilience): 분산 속도 제한(Rate Limiting)
특정 악의적 클라이언트나 무한 루프에 빠진 내부 서비스가 전체 API 클러스터를 다운시키지 못하도록 보호해야 한다.
3.1 Redis 기반 Token Bucket 알고리즘
단순 고정 윈도우(Fixed Window)는 경계 시점에 트래픽이 2배로 몰리는 스파이크를 허용한다. 그래서 널리 쓰이는 방식이 토큰 버킷(Token Bucket) 알고리즘을 Redis Lua 스크립트로 원자적(Atomically) 처리하는 구성이다.
여기에도 트레이드오프는 있다. 매 요청마다 Redis를 한 번 왕복하므로 그만큼 지연이 더해지고, Redis가 응답하지 않을 때 제한 로직을 통과시킬지(fail-open) 거부할지(fail-closed)는 서비스 성격에 맞춰 먼저 정해야 한다. 지연 예산이 매우 빡빡하면 노드 로컬 카운터에 근사치를 두고 주기적으로 동기화하는 방식도 검토 대상이다.
-- Redis Token Bucket Lua Script
local key = KEYS[1]
local capacity = tonumber(ARGV[1])
local refill_rate = tonumber(ARGV[2])
local now = tonumber(ARGV[3])
local requested = tonumber(ARGV[4])

local data = redis.call('HMGET', key, 'tokens', 'last_updated')
local tokens = tonumber(data[1])
local last_updated = tonumber(data[2])

if tokens == nil then
    tokens = capacity
    last_updated = now
else
    local delta = math.max(0, now - last_updated)
    tokens = math.min(capacity, tokens + delta * refill_rate)
end

if tokens >= requested then
    tokens = tokens - requested
    redis.call('HMSET', key, 'tokens', tokens, 'last_updated', now)
    redis.call('EXPIRE', key, math.ceil(capacity / refill_rate))
    return 1 -- 허용
else
    return 0 -- 속도 제한 초과 (HTTP 429)
end
4. 무중단 프로덕션 서빙 스택: Gunicorn + Uvicorn
FastAPI 애플리케이션을 단일 uvicorn main:app으로 실행하는 것은 프로덕션 환경에서 금물이다. 단일 프로세스가 치명적인 세그멘테이션 오류(C-extension)나 메모리 누수로 크래시되면 전체 서버가 중단된다.
프로덕션 서빙 프로세스 토폴로지:
[Client] ──> [Cloud Load Balancer] ──> [Nginx Reverse Proxy]
                                                │
                                                ▼ (Unix Domain Socket / TCP)
                                   [Gunicorn Master Process] (PID 1)
                                   (하트비트 감시, 장애 워커 재기동, HUP 시그널 기반 설정 리로드)
                                        ┌───────┼───────┐
                                        ▼       ▼       ▼
                                      [W1]    [W2]    [W3] (UvicornWorker: uvloop 비동기 루프)
4.1 워커 프로세스 수 산정 공식
- CPU 집약적 연산이 없는 순수 비동기 I/O 바운드 워커: \(\text{Workers} = (2 \times \text{CPU Cores}) + 1\)
- 위 식은 Gunicorn 문서가 제시하는 출발점이다. 같은 문서는 워커를 늘리면 자원만 낭비되고 처리량이 오히려 떨어질 수 있다며, 이 식으로 시작한 뒤 부하 테스트로 조정하라고 명시한다6. 워커당 메모리(모델·커넥션 풀 포함)도 상한을 정하는 변수라 CPU 코어만 보고 결정하면 안 된다.
- 단, 컨테이너 환경(K8s)에서는 컨테이너당 단일 프로세스(
WEB_CONCURRENCY=1또는 2)로 띄우고, 오토스케일링(HPA)을 통해 수평 확장하는 것이 리소스 격리 관점에서 더 안전하다.
4.2 Graceful Shutdown 설정
K8s 롤링 배포 시 Pod가 종료될 때 진행 중인 트랜잭션이 강제 종료되지 않도록 SIGTERM 시그널을 우아하게 처리해야 한다.
# 경량 프로덕션 Multi-stage Dockerfile
FROM python:3.11-slim AS builder
WORKDIR /app
COPY requirements.txt .
RUN pip install --no-cache-dir --user -r requirements.txt

FROM python:3.11-slim AS runner
WORKDIR /app
COPY --from=builder /root/.local /root/.local
COPY . .
ENV PATH=/root/.local/bin:$PATH
EXPOSE 8000

# Gunicorn 마스터와 UvicornWorker 실행
CMD ["gunicorn", "main:app", \
     "-k", "uvicorn.workers.UvicornWorker", \
     "-w", "4", \
     "-b", "0.0.0.0:8000", \
     "--timeout", "60", \
     "--graceful-timeout", "30", \
     "--access-logfile", "-"]
--graceful-timeout 30:SIGTERM수신 후 신규 연결 접수를 즉시 중단하고, 이미 인입된 요청을 완료할 수 있도록 30초의 대기 시간을 부여한다. 이 시간을 넘긴 요청은 강제로 끊기므로, K8s의terminationGracePeriodSeconds는--graceful-timeout보다 넉넉하게 잡아야 한다(그렇지 않으면 컨테이너가 먼저 종료된다)7. SSE처럼 응답이 길게 유지되는 엔드포인트는 별도 상한과 종료 신호 처리를 함께 설계해야 한다.
5. 결론: 엔터프라이즈 API 구축 아키텍처 체크리스트
- 프로토콜 적합성: 내부 마이크로서비스 간 빈번한 RPC는 gRPC로, 공개 인터페이스와 AI 토큰 스트리밍은 FastAPI (REST + SSE)로 계층을 이원화하라.
- I/O 블로킹 격리: 엔드포인트 함수 내에서 무거운 동기식 라이브러리를 직접 호출하지 말고, 반드시 비동기 드라이버를 채택하거나 Celery/Temporal 작업 큐로 오프로드하라.
- 분산 상태 격리: 속도 제한, 세션 캐싱, 멱등성 검증은 애플리케이션 메모리가 아닌 Redis 클러스터에서 원자적으로 처리하라8.
- 운영 프로세스 안정성: 단일 Uvicorn 단독 구동을 피하고, Gunicorn 프로세스 매니저와 Graceful Shutdown 정책을 적용해 롤링 배포 중 진행 중인 요청이 끊기지 않도록 하라9.
댓글남기기