쿠버네티스 프로덕션 네트워킹과 스토리지 아키텍처: Ingress, CSI·StorageClass 및 관리형 클러스터(EKS·GKE) 엔지니어링
이 글을 30초에 파악하기
한 줄로 — 로컬에서 컨테이너 몇 개를 띄우던 단계에서, 실제 서비스가 외부 트래픽과 데이터를 감당해야 하는 단계로 넘어갈 때 무엇이 달라지는지를 정리한다.
읽고 나면 알게 되는 것
- 로컬의 여러 컨테이너를 파일 하나로 묶어 띄우는 방법과, 그 안에서 서비스끼리 이름으로 통신하는 원리
- 파드마다 주소가 계속 바뀌는 환경에서 외부 요청을 하나의 입구로 받아 경로별로 나눠 보내는 구조
- 컨테이너가 다시 뜨더라도 데이터가 남도록 디스크를 요청해 할당받는 절차와, EKS·GKE가 그 뒤에서 무엇을 대신하는지
용어 먼저 보기
| 용어 | 한 줄 설명 | 이 글에서의 역할 |
|---|---|---|
| Docker Compose | 여러 컨테이너의 구성과 연결 관계를 파일 하나로 선언하는 도구 | 1절 로컬 멀티 컨테이너 명세 |
| 파드(Pod) | 컨테이너를 담아 클러스터에서 실행하는 최소 단위 | 주소가 계속 바뀌는 대상이라는 점이 2절의 출발점 |
| Service | 여러 파드를 하나의 고정 주소로 묶는 L4 진입점 | 2절에서 Ingress와 비교하는 기준 |
| Ingress | 외부 요청을 어느 서비스로 보낼지 적어 둔 라우팅 규칙 | 2.1절 규칙과 실행 주체의 구분 |
| Ingress Controller | Ingress 규칙을 읽어 실제로 트래픽을 처리하는 프로그램 | 규칙만 배포해서는 트래픽이 흐르지 않는 이유 |
| PV / PVC | 실제 디스크 볼륨과, 그 볼륨을 요청하는 티켓 | 3.1절 관리자와 개발자의 역할 분리 |
| StorageClass / CSI | 요청이 오면 디스크를 만들어 주는 템플릿과 그 표준 규격 | 3.2절 동적 프로비저닝 |
| EKS / GKE | 컨트롤 플레인을 클라우드가 대신 운영하는 관리형 쿠버네티스 | 4절 네트워크·확장 방식 비교 |
이런 분께 — 컨테이너 한두 개는 띄워 봤지만 서비스가 커지면서 네트워크와 스토리지를 어떻게 잡아야 할지 막막한 개발자. 처음 읽을 때는 1·3절로 감을 잡고 4절 표만 훑어도 전체 그림이 잡힌다.
단일 컨테이너 실행(docker run)을 넘어 실제 엔터프라이즈 프로덕션 환경으로 진입할 때 엔지니어가 직면하는 문제는 크게 네 가지 시스템 계층으로 집약된다.
- 로컬 멀티 컨테이너 명세: 상호 의존성을 갖는 웹, API, DB, 캐시 서비스를 어떻게 단일 선언으로 오케스트레이션할 것인가?
- L7 외부 인그레스 네트워킹: 분산된 수백 개의 백엔드 파드(Pod)로 들어오는 외부 HTTP/HTTPS 트래픽을 어떻게 호스트·경로 기준으로 라우팅하고 SSL/TLS를 종단할 것인가?
- 스토리지 영속성(Persistence): 컨테이너가 예기치 않게 종료되거나 재스케줄링되어도 데이터베이스와 로그의 데이터를 유실 없이 보존할 수 있는 추상화는 무엇인가?
- 클라우드 인프라 거버넌스: 복잡한 etcd와 컨트롤 플레인의 고가용성을 유지하기 위해 관리형 쿠버네티스(EKS, GKE, AKS)를 어떻게 평가하고 채택할 것인가?
이 글에서는 Docker Compose의 선언적 메커니즘과 쿠버네티스 Ingress Controller의 트래픽 라우팅 원리를 다룬다. 이어서 CSI(Container Storage Interface) 기반의 동적 스토리지 프로비저닝을 설명한다. 마지막으로 AWS EKS와 GCP GKE의 핵심 아키텍처 차이점을 심층 분석한다.
1. 선언적 멀티 컨테이너 오케스트레이션: Docker Compose
로컬 개발 환경에서 다수의 컨테이너를 개별 명령어로 띄우는 방식은 환경 변수 누락, 네트워크 미연결, 실행 순서 경합(Race Condition)으로 인한 실패를 초래한다.
Docker Compose는 인프라를 코드로 관리(IaC)하는 기본 철학을 로컬 컨테이너 환경에 적용한다.
# docker-compose.yml: 서비스, 독립 네트워크, 볼륨의 선언적 정의
services:
  web:
    build: .
    ports:
      - "8000:8000"
    environment:
      - REDIS_HOST=cache
    depends_on:
      cache:
        condition: service_healthy
    networks:
      - backend-net

  cache:
    image: redis:7-alpine
    healthcheck:
      test: ["CMD", "redis-cli", "ping"]
      interval: 5s
      timeout: 3s
      retries: 5
    volumes:
      - redis-data:/data
    networks:
      - backend-net

networks:
  backend-net:
    driver: bridge

volumes:
  redis-data:
1.1 내부 네트워킹과 내장 DNS 디스커버리
Docker Compose는 docker compose up 실행 시 전용 사용자 정의 브리지 네트워크(backend-net)를 생성한다.
- 서비스 디스커버리(Service Discovery): 임베디드 DNS 서버(
127.0.0.11)가 각 서비스 이름을 컨테이너의 동적 가상 IP로 자동 매핑한다. 웹 애플리케이션은 IP가 바뀌어도http://cache:6379와 같이 고정된 호스트명으로 통신할 수 있다1. - 네트워크 격리: 외부 포트 포워딩(
ports)을 명시하지 않은 백엔드 컨테이너는 오직 Compose 네트워크 내부에서만 접근 가능하므로 로컬 보안 경계가 확립된다.
2. 쿠버네티스 외부 트래픽 진입로: L4 Service vs. L7 Ingress
쿠버네티스 내부에서 파드는 일시적인(Ephemeral) 객체로, 생성과 파괴가 반복되며 IP 주소가 끊임없이 바뀐다. 내부 서비스들을 안정적으로 외부 세계와 연결하기 위한 네트워킹 프리미티브는 계층별로 분화되어 있다.
L4 Service vs. L7 Ingress 트래픽 라우팅:
[L4 서비스 (LoadBalancer)]
  External Client ──> [Cloud L4 LB (AWS NLB)] ──> NodePort ──> kube-proxy (iptables) ──> Pod IP
  * 한계: 서비스마다 클라우드 LB가 하나씩 생성되어 LB 과금이 서비스 수만큼 늘고, URL 경로 기반 라우팅은 불가.

[L7 인그레스 (Ingress Controller)]
  External Client ──> [단일 L7 LB / Ingress Controller (Nginx / Envoy)]
                           │
                           ├─ /api/v1/auth ──> [Auth Service] ──> Pods
                           ├─ /api/v1/llm  ──> [LLM Service]  ──> Pods
                           └─ /static/     ──> [Web Service]  ──> Pods
  * 장점: 단일 엔트리포인트에서 SSL/TLS 종단, 호스트/경로 기반 라우팅, Rate Limiting을 함께 처리.
공식 문서의 Ingress 개념도는 클라이언트 요청이 Ingress가 관리하는 로드밸런서를 거치는 단일 진입 경로를 도식으로 보여준다. 요청은 Ingress 규칙에 따라 Service, 다시 Pod로 전달된다.
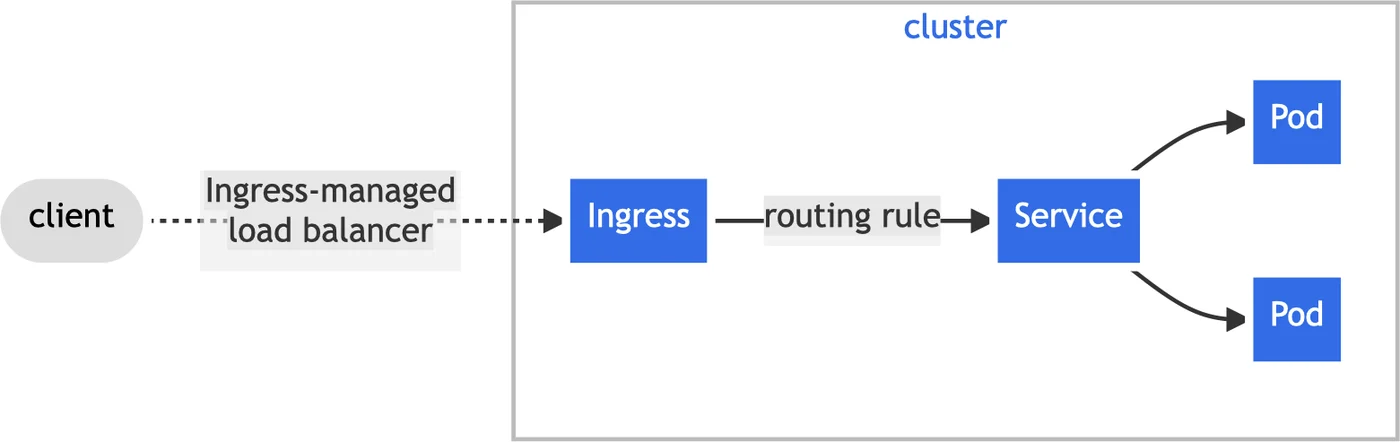
출처: Kubernetes Documentation — Ingress Concepts
2.1 Ingress 리소스 vs. Ingress Controller
쿠버네티스에서 Ingress는 단순한 선언적 라우팅 규칙(Rule)을 담은 매니페스트일 뿐이다2. 이 규칙을 실제로 읽어 트래픽을 처리하는 주체가 Ingress Controller다. Nginx Ingress, Traefik, Envoy 기반 Gateway API, AWS Load Balancer Controller 같은 구현을 클러스터에 배포해야 한다.
apiVersion: networking.k8s.io/v1
kind: Ingress
metadata:
  name: production-ingress
  annotations:
    kubernetes.io/ingress.class: "nginx"
    nginx.ingress.kubernetes.io/ssl-redirect: "true"
    nginx.ingress.kubernetes.io/proxy-body-size: "50m"
spec:
  tls:
    - hosts:
        - api.service.domain.com
      secretName: tls-cert-secret
  rules:
    - host: api.service.domain.com
      http:
        paths:
          - path: /v1/infer
            pathType: Prefix
            backend:
              service:
                name: llm-serving-service
                port:
                  number: 8000
- TLS Termination: Ingress 계층에서 클라이언트와의 HTTPS 암호화를 종단하고, 클러스터 내부는 평문 HTTP로 라우팅해 백엔드 파드가 TLS 핸드셰이크 연산을 직접 수행하지 않도록 한다.
- Connection Draining & Graceful Reload: 엔드포인트 변경 시 Nginx 설정을 핫 리로드(Hot-reload)하거나 Lua 모듈을 통해 파드 IP 변경을 동적으로 반영한다.
3. 상태 데이터의 영속성: PV, PVC, StorageClass 및 CSI
컨테이너가 크래시되거나 노드에서 축출(Evicted)되어 다른 노드로 이동할 때, 컨테이너 내부의 파일 시스템(emptyDir)에 저장된 데이터는 영구 소실된다. 상태 저장(Stateful) 애플리케이션(PostgreSQL, Redis, Elasticsearch)을 운영하려면 인프라 스토리지와 애플리케이션 요구를 분리해야 한다. 쿠버네티스는 이를 위한 3단계 스토리지 추상화를 제공한다.
스토리지 프로비저닝 수명주기:
[클러스터 관리자 / 클라우드 인프라]
  AWS EBS, GCP Persistent Disk, 온프레미스 SAN/NFS
       │
       ▼
  [StorageClass (동적 프로비저닝 템플릿)] ──> 프로비저너: ebs.csi.aws.com, 타입: gp3
                                                     │
                                                     ▼ (동적 생성)
[애플리케이션 개발자]                                [PersistentVolume (PV)]
  PersistentVolumeClaim (PVC)  <──(바인딩 1:1)──  실제 물리 디스크 볼륨
       │                                             │
       ▼                                             ▼
  [Pod 볼륨 마운트] ───────────────────────────> /var/lib/postgresql/data
3.1 PV vs. PVC의 역할 분리
PersistentVolume (PV): 클러스터 관리자가 수동 또는 동적으로 프로비저닝한 실제 물리적 저장소 리소스다. 수명주기는 볼륨을 마운트한 파드와 독립적이다.PersistentVolumeClaim (PVC): 개발자가 요청하는 스토리지 티켓이다 (“용량 100Gi, 접근 모드 ReadWriteOnce의 스토리지가 필요하다”). 쿠버네티스 바인더는 조건을 만족하는 PV를 찾아 1:1로 매핑한다3.
3.2 Dynamic Provisioning과 CSI(Container Storage Interface)
과거 쿠버네티스는 클라우드 벤더별 스토리지 드라이버 코드를 코어 바이너리(in-tree)에 내장했다. 그래서 드라이버 하나를 고치려 해도 코어 릴리스 주기를 함께 따라야 하는 유지보수 부담이 있었다. 현대 아키텍처는 이를 표준 gRPC 스펙인 CSI(Container Storage Interface) 플러그인(out-of-tree)으로 완전히 분리했다.
StorageClass를 선언해 두면 개발자는 PVC만 만들면 된다. CSI 컨트롤러가 클라우드 API(AWS CreateVolume)를 비동기 호출해 실제 EBS 볼륨을 생성하고, 이를 PV로 자동 등록한다.
3.3 Access Modes와 Reclaim Policy 트레이드오프
볼륨 접근 모드(Access Modes) 분류:
┌─────────────────────────┬──────────────────┬────────────────────────────────────────────────────────┐
│ Access Mode             │ 지원 스토리지 유형│ 특성 및 사용 사례                                      │
├─────────────────────────┼──────────────────┼────────────────────────────────────────────────────────┤
│ ReadWriteOnce (RWO)     │ 블록 스토리지    │ 단일 노드에서만 읽기/쓰기 마운트 가능 (AWS EBS, GCP PD)│
│                         │ (Block Storage)  │ 블록 디바이스 직접 마운트라 지연이 낮아 DB 단일 인스턴스에 주로 사용  │
├─────────────────────────┼──────────────────┼────────────────────────────────────────────────────────┤
│ ReadWriteMany (RWX)     │ 네트워크 파일계층│ 다수 노드의 다수 파드가 동시 읽기/쓰기 (AWS EFS, NFS)  │
│                         │ (Shared File)    │ 네트워크 파일시스템 특성상 지연이 더 큼, 공용 미디어/정적 자산│
├─────────────────────────┼──────────────────┼────────────────────────────────────────────────────────┤
│ ReadOnlyMany (ROX)      │ 공유 스토리지    │ 다수 노드에서 읽기 전용으로 마운트 (공통 머신러닝 모델)│
└─────────────────────────┴──────────────────┴────────────────────────────────────────────────────────┘
- Reclaim Policy:
Delete: PVC 삭제 시 기반 물리 PV 디스크도 즉시 영구 삭제 (개발/임시 환경).Retain: PVC가 삭제되어도 물리 PV와 데이터는 보존되어 수동 백업 및 복구 가능 (프로덕션 기본 권장).
4. 관리형 쿠버네티스(Managed K8s) 아키텍처: EKS vs. GKE
직접 컨트롤 플레인을 구축(Hard way)하는 것은 etcd 쿼럼 유지, apiserver 패치 중 가용성 유지, 노드 인증서 갱신 등 막대한 운영 비용을 초래한다. 현대 엔터프라이즈는 컨트롤 플레인의 고가용성을 SLA로 약속하는 관리형 쿠버네티스를 주로 채택한다.
주요 관리형 쿠버네티스 엔지니어링 비교:
┌─────────────────┬─────────────────────────────────┬─────────────────────────────────┐
│ 평가 항목       │ Amazon EKS                      │ Google Cloud GKE                │
├─────────────────┼─────────────────────────────────┼─────────────────────────────────┤
│ 컨트롤 플레인 SLA│ 99.95% (Standard)      │ 99.95% (리전)             │
│ Pod 네트워킹    │ AWS VPC CNI (파드가 VPC IP 직접 할당)│ Datapath V2 (Cilium eBPF 네이티브)│
│ IAM 인증/인가   │ IRSA (OIDC 기반 ServiceAccount 연동)│ Workload Identity (GCP IAM 연동)│
│ 오토스케일링    │ Karpenter (인스턴스 직접 프로비저닝)       │ Cluster Autoscaler / Autopilot   │
│ 운영 복잡도     │ 모듈식 조립형 (애드온 수동 구성 많음)│ 고도로 통합된 턴키 솔루션       │
└─────────────────┴─────────────────────────────────┴─────────────────────────────────┘
표의 SLA 수치는 각 벤더가 공개한 SLA 문서 기준이다. EKS의 99.95%는 Standard 컨트롤 플레인의 월간 업타임 약속이다4. GKE의 99.95%는 리전 클러스터 컨트롤 플레인 기준이며, 단일 존(zonal) 클러스터에는 99.5%가 적용된다5. 두 수치 모두 벤더의 서비스 약속이므로, 실제 관측 가용성은 클러스터 구성·리전·워크로드에 따라 달라질 수 있다.
- Amazon EKS 아키텍처 특성:
- AWS VPC CNI: 모든 파드가 오버레이 네트워크를 거치지 않고 실제 AWS VPC 서브넷의 보조 ENI IP를 직접 할당받는다. VPC 내부의 다른 RDS나 EC2와 네이티브 통신이 가능하지만, 서브넷 IP 고갈(IP Exhaustion) 문제에 유의해야 한다.
- Karpenter: 노드 그룹(ASG) 같은 중간 오케스트레이션 계층 없이 파드의 미스케줄 리소스 요청(CPU/GPU, Spot 여부)을 관측해 EC2 인스턴스를 직접 생성한다. Karpenter 공식 문서는 이 구조 덕분에 용량이 없을 때 재시도가 분 단위가 아니라 밀리초 단위로 이뤄진다고 설명한다6. 다만 실제 노드 준비 시간은 인스턴스 타입 가용성과 서브넷 IP 여유에 좌우되므로, 프로비저닝 지연을 상수로 가정하면 안 된다.
- Google Cloud GKE 아키텍처 특성:
- Datapath V2: Cilium 기반의 eBPF(Extended Berkeley Packet Filter) 프로그램을 각 노드 커널에 설치해 패킷 라우팅과 네트워크 폴리시를 처리한다7. kube-proxy와 iptables 서비스 라우팅을 쓰지 않는 GKE 버전에서는 서비스 개수 같은 iptables 병목이 제거되지만, eBPF 맵이 전체 서비스 합산 26만 개 엔드포인트로 제한되는 등 별도의 한계가 있다7.
- Autopilot 모드: 워커 노드의 관리, OS 패치, 크기 조정을 구글이 전담하며, 사용자는 순수 파드 리소스(Request) 소비량 기준으로만 과금된다.
5. 결론: 프로덕션 인프라 체크리스트
쿠버네티스 기반 프로덕션 인프라를 구축할 때 필수 점검해야 할 사항은 다음과 같다.
- 네트워크 진입로: 단일 L4 LoadBalancer 서비스 남발을 중단하고, L7 Ingress Controller를 통해 TLS 종단과 경로 라우팅을 중앙 집권화하라.
- 스토리지 결합도 분리: 상태 저장 파드에 고정 PV를 수동 매핑하지 말고,
StorageClass와 CSI 드라이버를 통한 동적 프로비저닝을 구성하고 프로덕션 환경의reclaimPolicy를Retain으로 검증하라. - 보안 자격증명 격리: 노드 전체에 광범위한 클라우드 IAM 권한을 부여하지 말고, 파드 단위 최소 권한 원칙을 강제하는 IRSA(EKS) 또는 Workload Identity(GKE)를 반드시 적용하라.
References
-
Amazon EKS Service Level Agreement — 벤더 SLA 문서(Standard 컨트롤 플레인 월간 업타임 99.95%) ↩
-
Google Kubernetes Engine Service Level Agreement — 벤더 SLA 문서(리전 클러스터 컨트롤 플레인 99.95%, 단일 존 99.5%) ↩
-
Karpenter Documentation: Concepts — 벤더/프로젝트 자체 문서(노드 프로비저닝 재시도 지연 설명) ↩
-
GKE Dataplane V2 — 벤더 문서(eBPF/Cilium 구현, iptables 병목 제거 조건, eBPF 맵 26만 엔드포인트 제한) ↩ ↩2
댓글남기기