
Azure API Management 기반 LLM 게이트웨이: 토큰 거버넌스·백엔드 풀·스트리밍 중계
이 시리즈는 사내 엔터프라이즈 AI 채팅 플랫폼을 사설망 위에 올리면서 마주친 설계 결정들을 정리한 기록이다. 1편에서는 VNet과 Private Endpoint로 폐쇄망 경계를 세우는 방법을, 2편에서는 그 위에 Container Apps로 서비스를 올리고 오토스케일링·SSO·감사 로깅을 붙이는 과정을 다뤘다.
이번 편은 그 사이에 놓인 한 계층, LLM 게이트웨이(LLM Gateway) 이야기다. 애플리케이션이 Azure OpenAI를 직접 호출하지 않고 API Management를 경유하도록 만들면 무엇을 얻고, 그 대가로 무엇을 관리해야 하는지를 실제 정책(Policy) XML 수준까지 내려가서 살펴본다.
1. LLM 게이트웨이라는 패턴
1.1 직접 호출의 네 가지 비용
애플리케이션이 https://aoai-prd-01.openai.azure.com 같은 엔드포인트를 직접 호출하면, 처음에는 단순해서 좋다. 문제는 사용자가 늘고 모델이 바뀌고 조직이 커질 때 터진다.
- 키 배포 문제: Azure OpenAI 호출 키를 애플리케이션 환경 변수에 넣는 순간, 그 키는 로그·배포 파이프라인·개발자 노트북으로 흩어진다. 폐기 회전(rotation)을 하려면 모든 소비자를 동시에 재배포해야 한다.
- 무분별한 사용량: 누가 얼마나 토큰을 쓰는지, 어떤 팀이 비용을 유발하는지 알 방법이 없다. 청구서는 월말에 한 덩어리로 도착한다.
- 모델 교체의 전면 수정:
gpt-5.4를 새 배포명으로 옮기면 이를 참조하는 모든 클라이언트 코드와 설정을 고쳐야 한다. 배포 이름이 곧 계약(Contract)이 되어버린다. - 관측 불가: 프롬프트가 어디로 갔는지, 어떤 요청이 429로 떨어졌는지, 지연이 어디서 발생하는지에 대한 단일 지점이 없다.
1.2 게이트웨이가 돌려주는 것
LLM 게이트웨이는 이 네 가지를 한 계층에서 흡수한다. 클라이언트는 게이트웨이의 단일 주소와 게이트웨이가 발급한 키만 알면 되고, 실제 Azure OpenAI 키와 백엔드 토폴로지는 게이트웨이 내부로 숨는다.
| 얻는 것 | 메커니즘 |
|---|---|
| 키 은닉 | 백엔드 인증을 Managed Identity로 위임, 실제 키 미배포 |
| 쿼터 | 구독(Subscription) 단위 + 토큰 단위 레이트 리밋 |
| 단일 관측 지점 | 모든 호출이 APIM을 통과, 메트릭·로그 일원화 |
| 무중단 교체 | 배포 라우팅과 백엔드 풀을 게이트웨이에서만 수정 |
핵심은 클라이언트 계약과 백엔드 구현의 분리다. 클라이언트는 /openai/v1이라는 안정된 경로만 보면 되고, 그 뒤에서 모델 버전이 바뀌든 백엔드 인스턴스가 늘든 클라이언트는 모른다.
2. 게이트웨이 구조
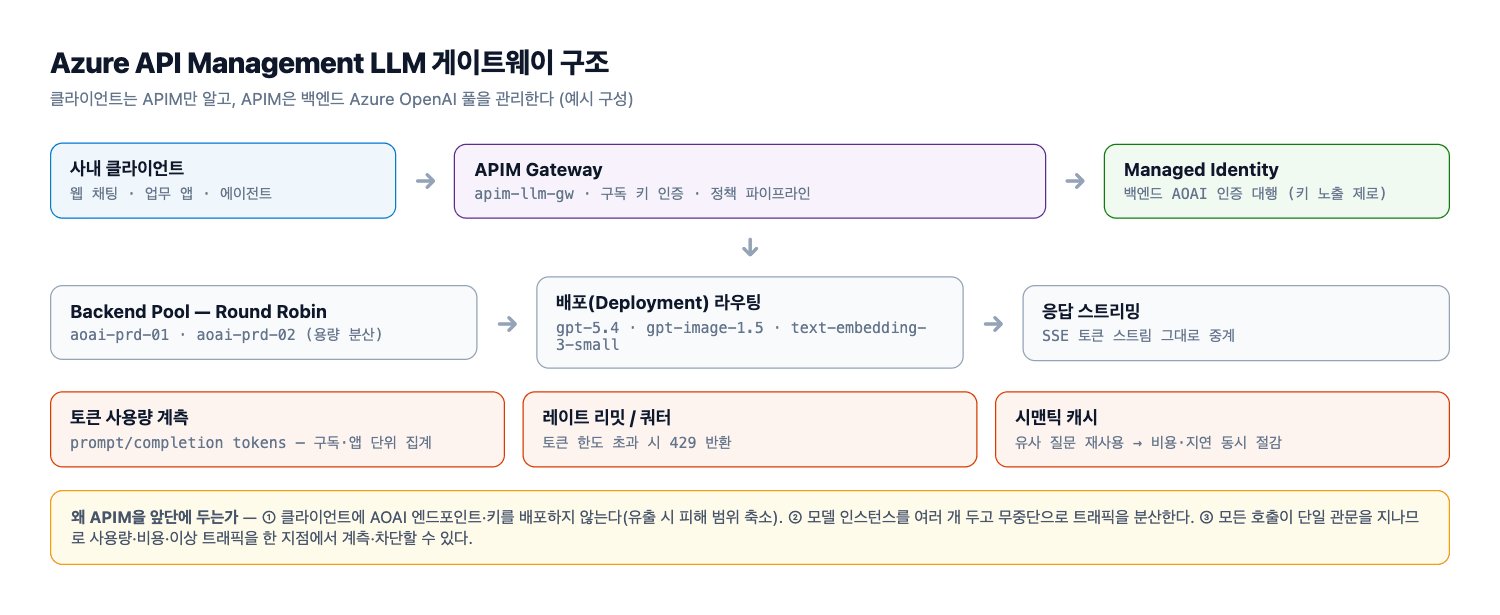
위 다이어그램은 컨테이너 앱(aca-webui)이 사설망 내부에서 게이트웨이(apim-llm-gw)를 호출하고, 게이트웨이가 백엔드 풀을 통해 Azure OpenAI로 요청을 넘기는 흐름을 보여준다. 클라이언트는 게이트웨이 주소와 구독 키만 알고, 실제 모델 엔드포인트와 인증 자격 증명은 게이트웨이 뒤에 숨는다.
2.1 백엔드 풀과 Round Robin
단일 Azure OpenAI 인스턴스는 리전 단위 처리량 한도(TPM, Tokens Per Minute)에 묶인다. 프로덕션에서는 보통 동일 모델을 두 개 이상의 인스턴스에 배포해 두고, 게이트웨이가 그 사이를 분산한다.
<backend>
  <set-backend-service backend-id="aoai-pool-prod" />
</backend>
백엔드 풀은 APIM의 backends 그룹으로 정의하고, 각 멤버가 aoai-prd-01, aoai-prd-02를 가리키게 한다. 기본 분산 방식은 Round Robin이며, 멤버별 우선순위(Priority)와 가중치(Weight)를 줄 수 있다. 인스턴스 하나가 429를 연발하면 회로 차단기(Circuit Breaker) 규칙을 붙여 일정 시간 풀에서 제외하고 트래픽을 남은 멤버로 몰아준다.
2.2 Managed Identity로 인증하기
가장 큰 이득은 여기다. APIM이 시스템 할당 관리 ID(Managed Identity)를 갖고, 그 ID에 대상 Azure OpenAI 리소스의 Cognitive Services OpenAI User 역할을 부여하면, 게이트웨이는 키 없이 Entra ID 토큰으로 백엔드에 인증한다.
<authentication-managed-identity
    resource="https://cognitiveservices.azure.com"
    output-token-variable-name="msi-access-token"
    ignore-error="false" />
이렇게 하면 Azure OpenAI 키가 그 어떤 클라이언트 설정에도 등장하지 않는다. 키 유출 시나리오 자체가 사라지고, 회전도 필요 없다. 클라이언트 쪽에는 APIM 구독 키만 남는데, 이건 게이트웨이가 언제든 폐기·재발급할 수 있는 1차 방어선일 뿐 실제 자원 접근 권한은 아니다.
2.3 배포 단위 라우팅
게이트웨이의 URL 경로를 모델 용도별로 나누면 클라이언트는 의도만 표현하면 된다.
| 클라이언트 경로 | 백엔드 배포 | 용도 |
|---|---|---|
/openai/v1/chat/completions |
gpt-5.4 |
대화·요약·RAG 생성 |
/openai/v1/images/generations |
gpt-image-1.5 |
이미지 생성 |
/openai/v1/embeddings |
text-embedding-3-small |
문서 임베딩 |
클라이언트는 gpt-5.4라는 이름조차 몰라도 된다. 나중에 더 좋은 모델이 나오면 이 매핑 테이블만 바꾸면 되고, 애플리케이션 배포는 필요 없다.
3. 정책 파이프라인 실전
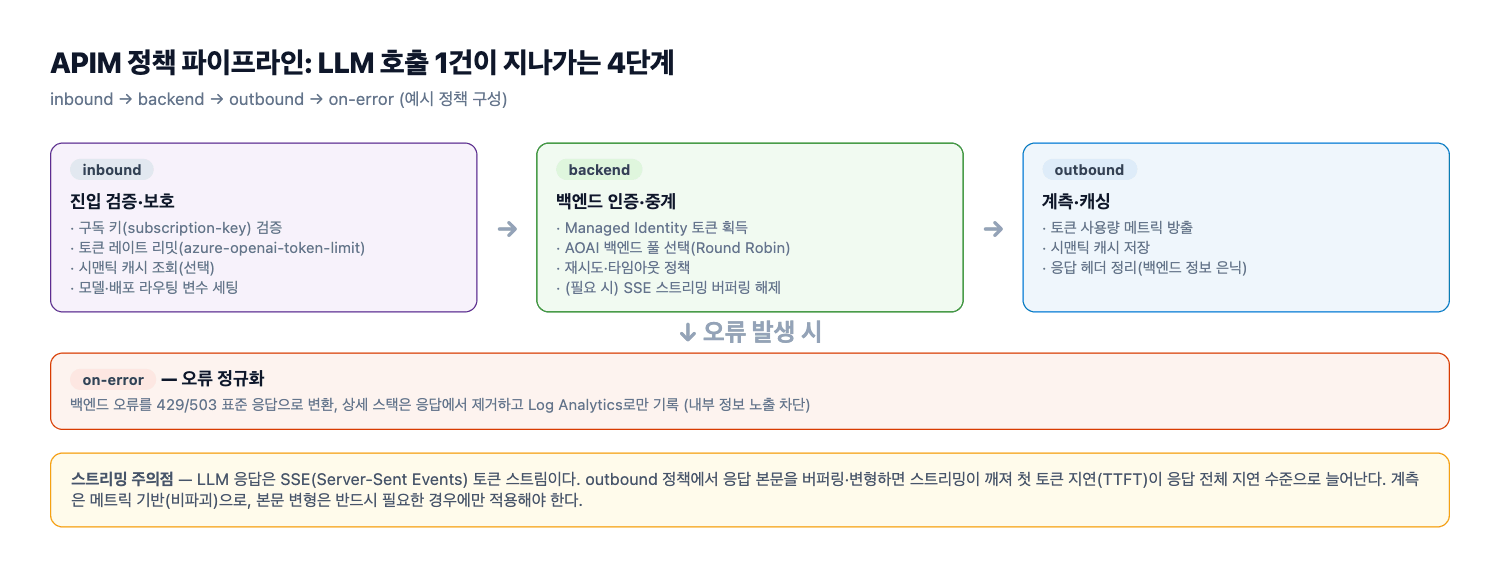
위 그림은 하나의 요청이 인바운드(Inbound) → 백엔드(Backend) → 아웃바운드(Outbound) → 오류(On-error) 순으로 통과하는 정책 파이프라인을 나타낸다. 각 단계에서 무엇을 검사하고 변형하는지가 게이트웨이의 실질적인 동작을 결정한다. APIM 정책은 이 네 구역으로 나뉜 XML로 기술된다.
3.1 인바운드: 토큰 리밋과 세만틱 캐시
요청이 들어오는 즉시 토큰 쿼터를 건다. azure-openai-token-limit은 요청 본문의 프롬프트를 추정 토큰으로 환산해 분당 한도를 초과하면 즉시 429를 돌려준다.
<inbound>
  <base />
  <azure-openai-token-limit
      counter-key="@(context.Subscription.Id)"
      tokens-per-minute="20000"
      estimate-prompt-tokens="true"
      remaining-tokens-header-name="x-ratelimit-remaining-tokens"
      tokens-consumed-header-name="x-ratelimit-consumed-tokens" />

  <azure-openai-semantic-cache-lookup
      score-threshold="0.85"
      embeddings-backend-id="aoai-embedding-backend"
      embeddings-backend-auth="system-assigned"
      ignore-system-messages="true"
      max-message-count="8" />
</inbound>
azure-openai-semantic-cache-lookup는 선택이다. 임베딩 모델로 프롬프트를 벡터화해 유사 요청을 캐시에서 찾고, 임계 점수를 넘으면 백엔드로 가지 않고 캐시 응답을 반환한다. 반복 질의가 많은 사내 챗봇에서는 토큰 비용을 눈에 띄게 줄인다. 다만 캐시 적중은 프롬프트·응답 쌍을 Redis에 저장한다는 뜻이므로, 민감 정보 처리 정책과 반드시 함께 검토해야 한다.
3.2 백엔드 구간: 풀 선택과 인증
백엔드 구간에서 실제 목적지를 정하고 자격 증명을 주입한다.
<backend>
  <set-backend-service backend-id="aoai-pool-prod" />
</backend>
정책에서 backend-id로 풀을 지정하면, 풀 정의에 등록된 멤버 중 하나가 선택된다. 선택된 멤버가 aoai-prd-01이든 aoai-prd-02이든 정책 XML은 바뀌지 않는다. 인증은 앞서 본 authentication-managed-identity 블록이 담당하고, 경로 재작성(Rewrite URI)으로 클라이언트의 /openai/v1/...을 백엔드가 기대하는 /openai/deployments/gpt-5.4/... 형태로 변환한다.
<rewrite-uri template="/openai/deployments/gpt-5.4/chat/completions?api-version=2025-01-01-preview" />
3.3 아웃바운드와 오류 정규화
오류 처리는 게이트웨이의 숨은 가치다. 백엔드가 뱉는 원시 오류를 클라이언트가 이해하는 일관된 스키마로 바꿔주면, 클라이언트는 백엔드가 두 대인지 열 대인지, 어느 인스턴스가 죽었는지 알 필요가 없다.
<on-error>
  <base />
  <set-header name="Content-Type" exists-action="override">
    <value>application/json</value>
  </set-header>
  <set-body>@{
    var status = context.Response.StatusCode;
    var code = status == 429 ? "rate_limit_exceeded" : "upstream_error";
    return new JObject(
      new JProperty("error", new JObject(
        new JProperty("code", code),
        new JProperty("status", status),
        new JProperty("message", context.LastError?.Message ?? "upstream failure")
      ))
    ).ToString();
  }</set-body>
</on-error>
이 정규화가 있으면 백엔드 풀의 멤버가 교체되거나 Azure OpenAI가 일시적으로 429를 돌려줘도, 클라이언트의 재시도 로직은 단일한 규칙으로 대응할 수 있다.
4. 토큰 거버넌스 설계
4.1 왜 요청 수가 아니라 토큰 수인가
전통적인 API 레이트 리밋은 “초당 요청 수”를 센다. LLM에서는 이 지표가 거의 무의미하다. 짧은 질문 하나와 5만 토큰짜리 문서 요약은 요청 수로는 똑같이 1이지만, 백엔드 부하와 비용은 수백 배 차이 난다. 그래서 게이트웨이의 리밋 기준은 요청 수가 아니라 분당 토큰 수(TPM)여야 한다.
토큰 한도는 두 층으로 나눠 걸면 운영이 편하다. 하나는 구독별 분당 한도(tokens-per-minute)로 순간 폭주를 막고, 다른 하나는 주기별 총량(token-quota)으로 월 예산을 지킨다.
<azure-openai-token-limit
    counter-key="@(context.Subscription.Id)"
    tokens-per-minute="20000"
    token-quota="5000000"
    token-quota-period="Daily" />
4.2 구독 키 발급 전략
APIM의 구독(Subscription)은 키 단위로 쿼터·메트릭을 분리하는 자연스러운 경계다. 설계 원칙은 하나다. 폐기 범위가 한 애플리케이션으로 한정되도록 키를 쪼갠다.
- 애플리케이션별로 구독을 발급한다. 챗 UI용, 임베딩 파이프라인용, 배치 요약용을 각각 별도 구독으로 둔다.
- 키 하나가 유출되면 그 구독만 폐기·재발급한다. 다른 서비스는 영향을 받지 않는다.
- 구독에
counter-key를 걸어두면 쿼터·메트릭이 자동으로 분리되므로, 어느 앱이 예산을 태우는지 즉시 보인다.
키를 클라이언트에 넣는 순간부터 그 키는 비밀이 아니라 1차 필터다. 그래서 키에는 아무 권한도 주지 않고, 실제 Azure OpenAI 접근은 게이트웨이의 관리 ID가 담당한다. 키가 새도 자원 탈취로 이어지지 않는다.
4.3 429 응답 처리
토큰 한도를 넘으면 게이트웨이는 표준적인 429 Too Many Requests를 반환한다. 이때 유용한 정보를 헤더로 실어 보내면 클라이언트가 똑똑하게 물러설 수 있다.
Retry-After: 몇 초 뒤에 다시 시도하면 되는지.x-ratelimit-remaining-tokens: 남은 토큰.x-ratelimit-consumed-tokens: 이번 요청이 소비한 토큰.
클라이언트는 429를 “실패”가 아니라 “지금은 안 된다”로 다뤄야 한다. 지수 백오프(Exponential Backoff)로 물러서고, 사용자에게는 “잠시 후 다시 시도해 주세요”라는 상태를 명확히 보여준다. 무한 재시도나 즉시 재시도는 백엔드 부하를 증폭시킬 뿐이다.
5. 스트리밍(SSE) 중계 주의점
5.1 버퍼링 금지와 본문 불변
챗 UI의 체감 품질을 좌우하는 것은 최종 응답이 아니라 첫 토큰이 도착하는 시간(TTFT, Time To First Token)이다. Azure OpenAI는 SSE(Server-Sent Events)로 토큰을 조각조각 흘려보내는데, 게이트웨이가 이를 중간에 모았다가 한꺼번에 내보내면 스트리밍의 의미가 사라진다.
가장 흔한 실수는 아웃바운드 정책에서 응답 본문을 변형하는 것이다. <set-body>나 응답 로깅을 위한 전체 버퍼링은 text/event-stream을 통째로 읽어들여 스트림을 깨뜨린다. 스트리밍 경로에서는 본문을 건드리지 말고, 필요한 계측은 헤더나 별도 로깅으로 처리한다.
<outbound>
  <base />
  <!-- 스트리밍 경로에서는 본문 변형 금지 -->
  <set-header name="X-Gateway-Model" exists-action="override">
    <value>gpt-5.4</value>
  </set-header>
</outbound>
5.2 타임아웃과 첫 토큰 지연 보존
긴 응답은 수십 초가 걸린다. 백엔드 타임아웃이 기본값(보통 30초~100초)에 묶여 있으면, 긴 답변이 중간에 끊긴다. 대화형 서비스에서는 게이트웨이·백엔드 양쪽 타임아웃을 240초 수준으로 올려 잡는 편이 안전하다. APIM 백엔드 정책의 timeout 속성과 백엔드 풀 멤버의 타임아웃을 함께 맞춘다.
<backend>
  <forward-request timeout="240" buffer-response="false" />
</backend>
buffer-response="false"가 중요하다. 이 값이 참이면 APIM이 전체 응답을 버퍼링한 뒤 내보내므로, 타임아웃을 늘려도 TTFT는 그대로 나빠진다. 스트리밍 경로에서는 반드시 버퍼링을 끄고, 앞단 로드 밸런서나 리버스 프록시에서도 응답 버퍼링이 꺼져 있는지 확인한다.
6. 운영과 관측
6.1 메트릭에서 Log Analytics까지
APIM은 모든 요청에 대해 게이트웨이 메트릭과 진단 로그를 남긴다. Azure Monitor 진단 설정으로 이를 Log Analytics 작업 영역에 흘려보내면, 토큰 사용량을 애플리케이션·구독·모델 단위로 집계할 수 있다.
- 게이트웨이 메트릭: 총 요청, 4xx/5xx 비율, 백엔드 지연,
GatewayResponseCode분포. - 토큰 메트릭:
azure-openai-token-limit이 내보내는 소비 토큰량으로 앱별 비용 추정. - 진단 로그: 요청별 구독 키, 백엔드 선택, 응답 코드. 여기서 백엔드 풀 멤버별 성공률을 뽑는다.
이 데이터를 대시보드로 묶으면 “이번 주 어떤 앱이 토큰을 가장 많이 썼는가”, “429가 몰리는 시간대는 언제인가”에 즉답할 수 있다.
6.2 장애 시나리오: 백엔드 한 대가 죽으면
aoai-prd-01이 응답하지 않는다고 하자. 회로 차단기를 붙여두면 게이트웨이가 연속 실패를 감지해 해당 멤버를 풀에서 잠시 제외하고, 트래픽을 aoai-prd-02로 전부 몰아준다. 클라이언트는 429나 5xx를 보지 못하고, 실패 횟수만 로그에 남는다.
<backend>
  <set-backend-service backend-id="aoai-pool-prod" />
</backend>
이 동작이 성립하려면 두 가지가 필요하다. 첫째, 풀에 살아 있는 멤버가 최소 둘 이상이어야 한다. 둘째, 클라이언트가 상태를 들고 있지 않아야 한다(무상태). 게이트웨이가 목적지를 바꿔도 클라이언트는 같은 경로로 계속 요청하면 된다. 이것이 게이트웨이에 투자하는 실질적인 이유—장애를 사용자에게 보이지 않게 흡수하는 것—이다.
References
- Microsoft Learn — Azure OpenAI API를 관리하는 Azure API Management 정책
- Microsoft Learn — Azure API Management에서 백엔드 풀 구성
- Microsoft Learn — API Management 정책 참조: azure-openai-token-limit
- Microsoft Learn — API Management의 의미 체계 캐싱(Semantic Caching)
- Microsoft Learn — Azure OpenAI Service의 할당량과 한도
댓글남기기