
사설망 LLMOps 옵저버빌리티: Langfuse 트레이싱과 Azure Monitor 로그 파이프라인
이 글은 사내 엔터프라이즈 AI 채팅 플랫폼을 사설망에 구축한 연재의 다섯 번째 글이자, 구축편(1부)의 마지막 글이다. 1편 VNet과 Private Endpoint에서 네트워크 경계를 세웠고, 2편 Azure Container Apps 프로덕션 구성에서 컴퓨트를 올렸으며, 3편 APIM LLM 게이트웨이에서 모델 호출을 단일 창구로 묶었고, 4편 Entra ID 인증에서 “누가 쓰는가”를 통제했다. 이번 편에서는 마지막 조각인 “무슨 일이 일어났는가”를 관측하는 계층을 다룬다.
서비스를 띄우는 것과 운영하는 것은 다른 문제다. 특히 LLM은 요청 하나하나가 비용과 직결되고, 사용자 질문 하나가 어떤 검색·리랭킹·생성 단계를 거쳐 답으로 이어졌는지가 성능 개선의 유일한 단서가 된다. 이 글에서는 사설망 안에 Langfuse를 배포해 트레이스를 수집하고, 컨테이너 로그를 Azure Monitor로 흘려보내는 파이프라인을 정리한다.
1. LLM 시스템에서 무엇을 관측할 것인가
1.1 전통 APM이 놓치는 것
일반적인 애플리케이션 성능 관리(APM, Application Performance Monitoring) 도구는 HTTP 요청의 상태 코드와 응답 지연, 트랜잭션 처리량을 잘 알려준다. 하지만 LLM 서비스에서는 이것만으로 운영이 불가능하다.
- APM은 “이 API가 4.2초 걸렸다”까지는 말해주지만, 그 4.2초가 검색(Retrieval) 때문인지 리랭킹(Rerank) 때문인지 생성(Generation) 때문인지 구분하지 못한다.
- HTTP 계층에는 프롬프트 본문과 모델 출력, 토큰 사용량, 단가 기반 비용이 남지 않는다. 결국 “이번 달 모델 호출에 얼마를 썼는가”라는 질문에 답하려면 별도의 계층이 필요하다.
- 사용자 만족도는 200 OK와 무관하다. 답변 품질(Quality)과 그 품질을 만든 프롬프트 버전을 연결해 남기지 않으면, 프롬프트 개선이 감(感)에 의존하게 된다.
이 격차를 메우는 것이 LLM 트레이싱(LLM Tracing)이다. 대화 1건을 단위로 입력 프롬프트, 출력, 토큰, 비용, 지연, 평점을 하나의 트리로 묶어 남긴다.
1.2 4대 관측 축: 토큰·비용·지연·품질
운영 관점에서 LLM 시스템의 관측 대상은 네 축으로 정리된다.
| 축 | 핵심 질문 | 대표 지표 |
|---|---|---|
| 토큰(Token) | 얼마나 많은 컨텍스트를 태우고 있는가 | prompt tok, completion tok, 컨텍스트 재사용률 |
| 비용(Cost) | 누가/어떤 모델이 예산을 소모하는가 | 요청당 비용, 부서·사용자별 집계, 일/월 추이 |
| 지연(Latency) | 어느 단계가 느린가 | TTFT(첫 토큰까지의 시간), 전체 지연, 스팬별 소요 |
| 품질(Quality) | 답이 실제로 도움이 되었는가 | 사용자 평점, 프롬프트 버전별 상관, 재질문율 |
네 축은 따로 보면 의미가 약하다. 토큰과 비용이 사용자·부서 단위로 집계될 때 “어느 팀이 예산을 쓰는가”가 보이고, 지연이 스팬(Span) 단위로 분해되어야 병목 구간이 드러나며, 품질이 프롬프트 버전과 함께 누적되어야 개선의 방향이 데이터로 정해진다.
2. Langfuse 배포와 연동
위 4대 축을 수집하려면 트레이싱 백엔드가 필요하다. 여기서는 오픈소스 Langfuse를 사설망(Internal VNet) 안에 배포한다. 외부 SaaS 트레이싱 도구는 프롬프트 원문을 외부로 내보내야 하므로, 기밀 데이터가 오가는 폐쇄망 환경에서는 선택지가 되지 못한다.
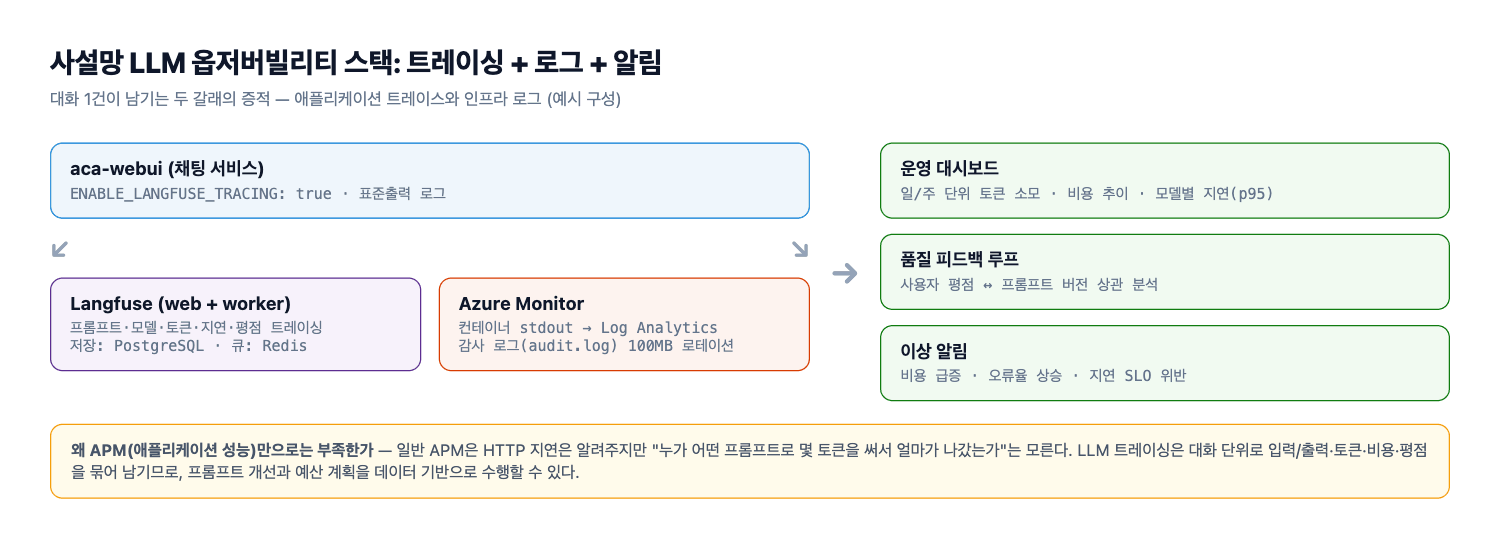
대화 1건이 남기는 두 갈래의 증적을 도식화한 것이다. 애플리케이션 트레이스는 Langfuse로, 인프라 로그는 Azure Monitor로 흐른다. 둘은 목적이 다르다. Langfuse는 “무엇을 물었고 얼마가 나갔는가”를, Azure Monitor는 “컨테이너가 정상이었는가”를 답한다.
2.1 컨테이너 구성: web + worker 분리
Langfuse는 단일 프로세스가 아니라 web과 worker 두 컨테이너로 나눠 배포한다. 트레이스 수집 API를 받아 응답하는 경로(web)와, 수집된 데이터를 비동기로 가공·집계하는 경로(worker)를 분리하면 채팅 서비스의 응답 지연에 트레이싱 부하가 전파되지 않는다.
- web: 트레이스/스팬 수집 엔드포인트와 대시보드 UI를 제공한다. 채팅 서비스가
ENABLE_LANGFUSE_TRACING으로 호출하는 대상이다. - worker: 수집 큐를 소비해 집계·스코어 계산·보존 정책 처리를 수행한다.
- 두 컨테이너 모두
cae-chat-prod-eus2환경 내부, 즉 사설 서브넷에 배치되어 외부에서 직접 접근할 수 없다.
2.2 저장소(PostgreSQL)와 큐(Redis)
Langfuse는 상태를 자체 메모리에 두지 않는다. 영속 저장과 메시지 큐를 각각 외부 리소스로 분리한다.
- 저장소: PostgreSQL. 컨테이너가 재시작되어도 트레이스가 유실되지 않도록 반드시 외부 관리형 DB를 사용한다. 커넥션 정보는 Secret으로 주입한다.
- 큐: Redis. web이 받은 트레이스를 worker가 소비하는 사이를 중계한다. 여기서 사용하는
aca-redis는 채팅 서비스의 웹소켓 세션 캐시와도 공유할 수 있지만, 부하 격리를 위해 논리 DB 인덱스를 분리하는 편이 안전하다. - 두 리소스 모두 사설 엔드포인트(
pe-blob, 사설 DNS)를 통해 접근하므로 공용 인터넷을 경유하지 않는다.
2.3 채팅 서비스 연동
채팅 서비스 쪽에서는 트레이싱을 켜고 Langfuse 엔드포인트를 환경 변수로 가리키기만 하면 된다.
# aca-webui 컨테이너 환경 변수 (예시)
ENABLE_LANGFUSE_TRACING: "true"
LANGFUSE_HOST: "http://aca-langfuse"
LANGFUSE_PUBLIC_KEY: "<secret: langfuse-public-key>"
LANGFUSE_SECRET_KEY: "<secret: langfuse-secret-key>"
ENABLE_LANGFUSE_TRACING: true 한 줄로 채팅 서비스는 모든 대화 턴에 대해 트레이스를 생성하기 시작한다. 중요한 점은 이 호출이 사설망 내부 주소(aca-langfuse)로 향한다는 것이다. 프롬프트 원문이 공용 인터넷으로 나가는 경로가 애초에 존재하지 않는다.
3. 트레이스 구조 해부
Langfuse의 자료구조는 세션 → 트레이스 → 스팬 → 제너레이션 → 스코어의 계층으로 되어 있다. 이 계층을 이해해야 “4.2초가 어디서 나왔는가”라는 질문에 답할 수 있다.
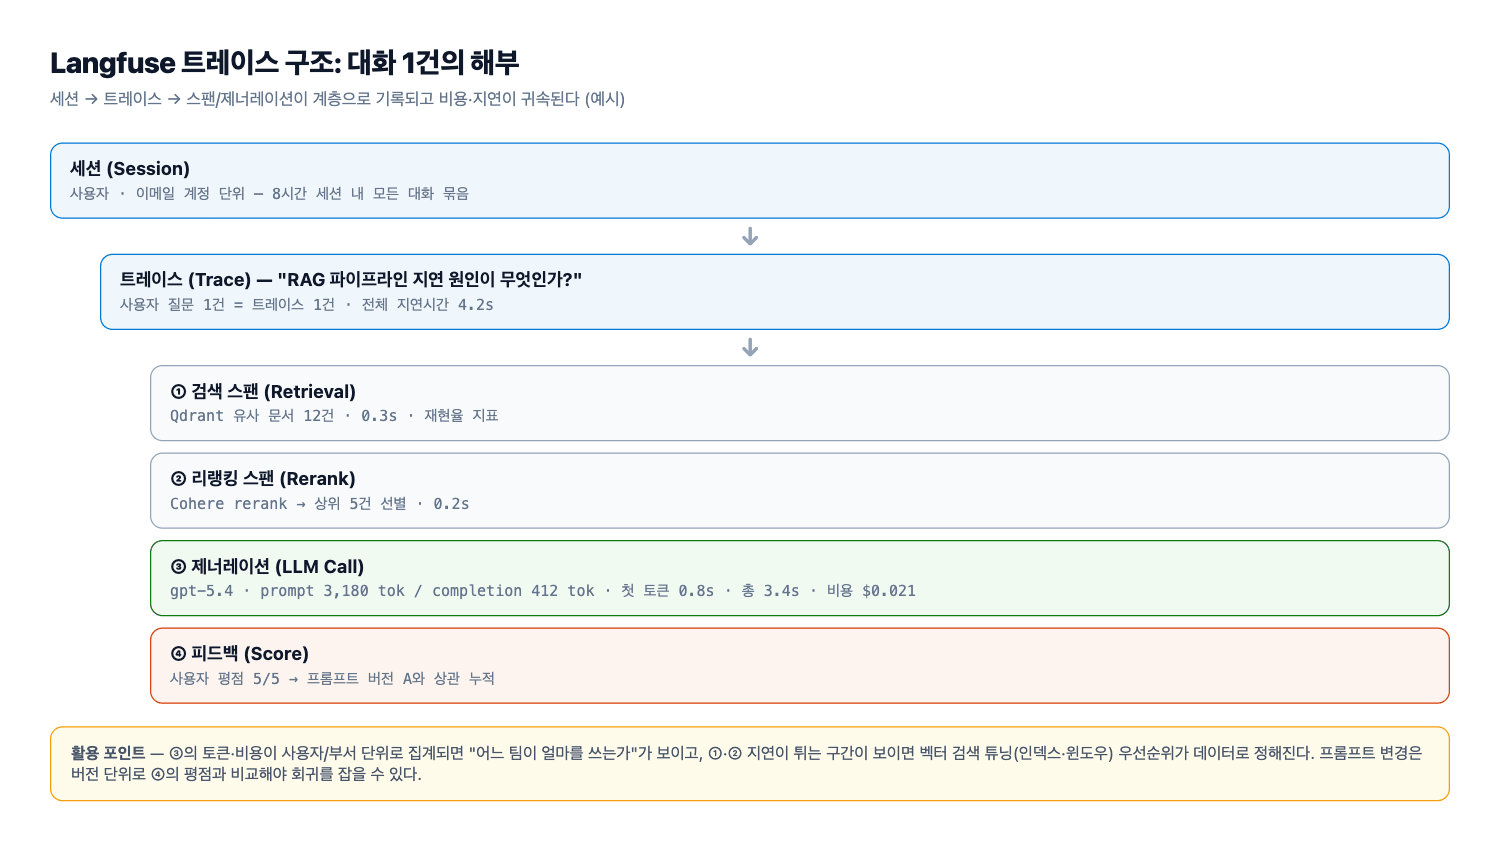
대화 1건이 계층적으로 기록되고 비용·지연·품질이 각각 다른 층위에 귀속되는 구조를 나타낸 것이다. 아래에서 각 계층을 위에서 아래로 짚는다.
3.1 계층 구조
- 세션(Session): 사용자·이메일 계정 단위다. 하나의 인증 세션, 예컨대 8시간짜리 로그인 세션 동안의 모든 대화 묶음이 여기에 대응한다. 세션 단위로 보면 한 사람이 하루에 어떤 주제를 얼마나 파고들었는지가 드러난다.
- 트레이스(Trace): 사용자 질문 1건에 대응한다. “RAG 파이프라인 지연 원인이 무엇인가?”라는 질문 하나가 트레이스 하나이고, 트레이스에는 전체 지연시간이 붙는다.
- 스팬/제너레이션(Span / Generation): 트레이스 내부의 단계별 작업이다. 검색, 리랭킹, LLM 호출이 각각 스팬으로 기록된다.
- 스코어(Score): 사용자 평점이나 자동 평가 결과다. 특정 제너레이션에 붙어 품질을 수치화한다.
3.2 예시 트레이스: 질문 1건의 해부
한 질문이 남긴 실제 항목을 단계별로 풀어보면 다음과 같다.
- 검색 스팬(Retrieval): Qdrant에서 유사 문서 12건을 가져온다. 0.3초가 걸렸고, 이 단계에는 재현율(Recall) 지표가 붙는다.
- 리랭킹 스팬(Rerank): Cohere rerank가 12건을 상위 5건으로 추린다. 0.2초가 소요된다.
- 제너레이션(LLM Call):
gpt-5.4에 프롬프트 3,180 토큰, 완성 412 토큰이 오갔다. 첫 토큰까지(TTFT) 0.8초, 총 3.4초, 비용은 $0.021이다. - 피드백(Score): 사용자가 5/5 평점을 남겼다. 이 평점은 프롬프트 버전 A와 함께 누적된다.
합산하면 검색 0.3 + 리랭킹 0.2 + 생성 3.4 ≈ 4.2초로, 트레이스의 전체 지연시간과 일치한다.
| 단계 | 소요 시간 | 부가 정보 |
|---|---|---|
| 검색 (Retrieval) | 0.3s | Qdrant 유사 문서 12건 |
| 리랭킹 (Rerank) | 0.2s | 상위 5건 선별 |
| 생성 (LLM Call) | 3.4s | prompt 3,180 tok / completion 412 tok, TTFT 0.8s, $0.021 |
| 트레이스 합계 | 4.2s | 사용자 평점 5/5 → 프롬프트 버전 A |
이 구조가 주는 실무적 이점은 세 가지다. 첫째, ③의 토큰·비용이 사용자/부서 단위로 집계되면 “어느 팀이 얼마를 쓰는가”가 보인다. 둘째, ①② 지연이 튀는 구간이 보이면 벡터 검색의 튜닝(인덱스·원도우) 우선순위가 데이터로 정해진다. 셋째, 프롬프트를 바꿀 때는 버전을 달리해 ④의 평점과 비교해야 개선이 회귀로 되돌아가는 것을 막을 수 있다.
4. 감사 로그와 Azure Monitor
Langfuse가 “무엇을 물었고 얼마가 나갔는가”를 담당한다면, Azure Monitor는 “컨테이너가 정상이었는가, 누가 무엇을 했는가”라는 컴플라이언스 관점을 담당한다.
4.1 감사 로그(Audit Log) 이중 기록
감사 로그는 유실을 막기 위해 파일과 표준 출력에 동시에 기록한다.
# 채팅 서비스 감사 로그 설정 (예시)
ENABLE_AUDIT_STDOUT: "true"      # 컨테이너 stdout으로 전달 → Azure Monitor 수집
ENABLE_AUDIT_LOGS_FILE: "true"   # 파일로 기록
# 파일 경로: /app/backend/data/audit.log  (Azure Files 영구 볼륨 마운트)
# 로그 레벨: METADATA
- 파일 경로
/app/backend/data/audit.log는 영구 볼륨(vol-webui-data, Azure Files 기반)에 놓여 컨테이너가 재시작되어도 남는다. - 로그 파일이 100MB에 도달하면 자동 로테이션되어 디스크를 무한정 점유하지 않는다.
- 감사 레벨은 METADATA로 두어 “어떤 사용자가 어떤 모델과 상호작용했는가”를 추적하되, 프롬프트 원문 자체는 감사 로그에 남기지 않는다.
표준 출력으로 나간 로그는 Container Apps 환경의 로그 파이프라인을 타고 Log Analytics 워크스페이스로 수집된다.
4.2 로그 수집 경로
수집 경로는 단순하다. 컨테이너의 stdout/stderr → Container Apps 환경의 로그 에이전트 → Log Analytics 워크스페이스 순으로 흐른다. 이때 로그는 ContainerAppConsoleLogs_CL 테이블에 적재된다. 별도의 사이드카나 에이전트 설치 없이 환경 단위 설정만으로 수집이 시작된다는 점이 관리형 서비스의 장점이다.
4.3 KQL 쿼리 예시
수집된 로그로 실제 운영 질문에 답하는 쿼리 두 개를 정리한다.
// 1) 모델별 호출 수 (최근 24시간)
ContainerAppConsoleLogs_CL
| where TimeGenerated > ago(24h)
| where Log_s contains "chat.completions"
| extend Model = extract(@"model=([a-zA-Z0-9\.\-]+)", 1, Log_s)
| summarize Calls = count() by Model
| order by Calls desc
// 2) 오류율 (5분 버킷, 최근 6시간)
ContainerAppConsoleLogs_CL
| where TimeGenerated > ago(6h)
| extend IsError = Log_s contains "ERROR" or Log_s contains "Traceback"
| summarize Total = count(), Errors = countif(IsError) by bin(TimeGenerated, 5m)
| extend ErrorRate = todouble(Errors) / todouble(Total) * 100
| project TimeGenerated, Total, Errors, ErrorRate
| order by TimeGenerated desc
첫 쿼리는 어떤 모델이 얼마나 호출되는지, 둘째는 오류율이 언제 치솟는지 보여준다. 오류율이 특정 시간대에 튀면 그 구간의 Langfuse 트레이스를 같은 타임스탬프로 조회해 실패한 요청의 프롬프트를 역추적할 수 있다. 로그와 트레이스가 동일한 사건을 두 각도에서 가리키는 셈이다.
5. 알림과 데이터 거버넌스
관측은 대시보드로 끝나지 않는다. 사람이 보지 않는 시간에도 이상을 감지해야 하고, 남긴 데이터는 규정에 맞게 다뤄야 한다.
5.1 비용 급증 알림
LLM 비용은 조용히 새는 성격이 있다. 컨텍스트가 길어지거나 사용자가 늘면 요금이 계단식으로 뛴다.
- 일/주 단위 토큰 소모와 비용 추이를 Langfuse 대시보드에서 집계하고, 전일 대비 임계치(예: +50%)를 넘으면 알림을 발생시킨다.
- 모델별 지연(p95) 도 함께 본다. 특정 모델의 p95 지연이 상승하면 그 모델로 트래픽이 몰리고 있다는 신호일 수 있다.
5.2 지연 SLO 위반 알림
사용자 체감은 평균이 아니라 꼬리(tail)에서 결정된다. p95 지연이 SLO(예: 5초)를 넘는 상태가 일정 시간 지속되면 알림을 올린다. 이때 Langfuse 트레이스의 스팬 분해가 알림의 원인 분석을 돕는다. 지연이 생성 단계에서 온 것인지 검색 단계에서 온 것인지에 따라 대응이 완전히 달라진다.
5.3 프롬프트 로그의 민감정보와 보존
가장 조심해야 할 지점은 프롬프트 로그 자체가 민감정보의 저장소가 될 수 있다는 사실이다.
- 기록 수준: 설정값
ENABLE_AUDIT_LOGS_FILE,metadata수준 기록 지침에 맞춰 상세 본문 대신 METADATA(사용자·모델·시각)를 남긴다. 원문 프롬프트의 보관 필요성이 없다면 트레이싱 단계에서 마스킹하거나 본문 수집을 끄는 편이 안전하다. - 보존 정책: 트레이스와 감사 로그 모두 보존 기간(Retention)을 명시한다. Log Analytics는 테이블별 보존 기간을, Langfuse는 프로젝트 단위 보존 설정을 지원한다. “무기한 보관”은 비용과 규정 리스크를 동시에 키운다.
- 접근 통제: 트레이스 대시보드는 관리자 역할(
openwebui-admin상당)에게만 열어 두고, 일반 사용자에게는 본인 세션에 한정된 피드백 기능만 노출한다.
6. 1부를 마치며
1부 5편을 통과하며 세운 아키텍처는 다음과 같이 하나의 흐름으로 연결된다.
- VNet & Private Endpoint — 외부로 나가는 경로를 물리적으로 차단한다.
- Container Apps — 내부 전용 모드로 컴퓨트를 격리하고 오토스케일링한다.
- APIM LLM Gateway — 모든 모델 호출을 단일 창구로 묶어 키와 비용을 통제한다.
- Entra ID 인증 — “누가 쓰는가”를 중앙에서 관리하고 역할을 매핑한다.
- 관측(Observability) — “무슨 일이 일어났는가”를 트레이스와 로그로 남긴다.
앞의 네 편이 경계를 세우는 일이었다면, 이번 편은 그 경계 안에서 일어나는 일을 가시화하는 일이다. 보안과 관측은 대립하지 않는다. 오히려 폐쇄망이라서 프롬프트 원문을 안심하고 트레이싱할 수 있고, 그 데이터가 프롬프트 개선과 예산 계획의 근거가 된다.
1부를 마치며 운영자가 마지막으로 점검할 항목을 정리한다. 2부에서는 이 플랫폼을 운영하며 마주친 주제들 — RAG 파이프라인 분리, 데이터 계층, 시크릿 거버넌스, 배포 자동화, 부하 검증 — 을 이어서 다룬다.
- Langfuse web/worker가 분리되고 저장소(PostgreSQL)·큐(Redis)가 외부화되어 재시작에도 트레이스가 유실되지 않는가
ENABLE_LANGFUSE_TRACING과LANGFUSE_HOST가 사설망 내부 주소를 가리키는가- 감사 로그가 stdout과 파일에 이중 기록되고 100MB 로테이션이 걸려 있는가
- 비용 급증·오류율 상승·지연 SLO 위반 3종 알림이 실제로 발화하는가
- 프롬프트 로그 기록 수준(METADATA)과 보존 기간이 규정과 일치하는가
댓글남기기