
[Spark] 스트림 처리 및 정형 스트리밍(Structured Streaming) 기초와 카프카 예제
 [Spark The Definitive Guide - BIG DATA PROCESSING MADE SIMPLE] 책을 중심으로 스파크를 개인 공부를 위해 요약 및 정리해보았습니다. 다소 복잡한 설치 과정은 도커에 미리 이미지를 업로해 놓았습니다. 즉, 도커 이미지를 pull하면 바로 스파크를 사용할 수 있습니다.
- 도커 설치 및 활용하는 방법 : [Spark] 빅데이터와 아파치 스파크란 - 1.2 스파크 실행하기
- 도커 이미지 링크 : https://hub.docker.com/r/ingu627/hadoop
- 예제를 위한 데이터 링크 : FVBros/Spark-The-Definitive-Guide
예제에 대한 실행 언어는 파이썬 기반인 pyspark를 이용했습니다.
기본 실행 방법
- 예제에 사용 될 데이터들은 도커 이미지 생성 후
spark-3.3.0안의 하위 폴더data를 생성 후, 이 폴더에 추가합니다.- 1.1 데이터와 도커 설치 및 활용하는 방법은 위에 링크를 남겼습니다.
- 터미널에서
pyspark을 입력해 프로그램을 시작합니다.
글에서 사용되는 파일 경로는 다를 수 있습니다.
- 이 글에서 다루는 것
- 스트림 처리의 개념과 장점, 선언형 API의 특징
- 연속형 처리(Continuous Processing)와 마이크로 배치(Micro-batch)의 동작 방식 비교
- 정형 스트리밍(Structured Streaming)의 기초와 핵심 개념(소스, 싱크, 출력 모드, 이벤트 시간, 워터마크)
- 활동 데이터셋을 활용한 PySpark 정형 스트리밍 실습과 스트림 트랜스포메이션(선택, 필터링, 집계, 조인)
- 카프카(Kafka) 소스 및 싱크 연동 방법과 메시지 읽기/쓰기 옵션
- 소켓, 콘솔, 메모리 등 테스트용 소스/싱크 활용법과 출력 모드 및 트리거 제어
1. 스트림 처리
- 스트림 처리(stream processing)는 신규 데이터를 끊임없이 처리해 결과를 만들어내는 행위이다.
- 스트림 처리 시스템에 도착한 일련의 이벤트를 입력 데이터로 받아 다양한 쿼리 연산을 수행한다. 그 후 다양한 버전의 결과를 출력하거나 최신 데이터를 저장할 수 있다.
- 스트림 처리는 다음과 같은 장점을 가지고 있다.
- 지연 시간(latency)가 짧다.
- 자동으로 연산 결과의 증분(incremental)을 생성하기 때문에 결과를 수정하는 데 효율적이다.
- 선언형(declarative) API를 사용하면 애플리케이션을 정의할 때 ‘어떻게’ 신규 데이터를 처리하고 장애 상황에서 복구할지 지정하는 대신 ‘무엇’을 처리할지 지정한다.
- 선언형 API의 예시로 스파크의 DStream API는 맵(Map), 리듀스(Reduce), 필터(Filter)같은 연산을 기반으로 하는 함수형 API을 제공한다.
- DStream API는 내부적으로 각 연산자의 데이터 처리량과 연산 관련 상태 정보를 자동으로 추적하고 관련 상태를 저장한다.
2. 연속형 처리와 마이크로 배치 처리
- 연속형 처리(Continuous processing) 기반의 시스템에서 각 노드는 다른 노드에서 전송하는 메시지를 끊임없이 수신하고 새로 갱신된 정보를 자신의 하위 노드로 전송한다.
- 연속형 처리는 레코드별로 처리하는 것이 핵심 개념이다.

-
연속형 처리는 각 노드가 신규 메시지에 즉시 반응하기 때문에 전체 입력량이 적을 때 빠르게 응답하지만 최대 처리량(throughput)은 적다.
- 마이크로 배치(micro-batch) 기반의 시스템은 입력 데이터를 작은 배치로 모으기 위해 대기한다.
- 그리고 다수의 분산 태스크를 이용해 각 배치를 병렬로 처리한다.
- 마이크로 배치 시스템은 더 적은 노드로 같은 양의 데이터를 처리할 수 있다.
- 또한 워크로드 변화에 대응할 수 있도록 부하 분산 기술을 동적으로 사용할 수 있다.

3. 정형 스트리밍의 기초
- 정형 스티리밍(Structured Streaming)은 스파크 SQL 엔진 기반의 스트림 처리 프레임워크이다.
- 정형 스티리밍은 스파크의 정형 API(DataFrame, Dataset, SQL)를 사용한다.
-
스트리밍 연산은 배치 연산과 동일하게 표현한다.
- 사용자가 스트림 처리용 코드와 목적지를 정의하면 정형 스트리밍 엔진에서 신규 데이터 대한 증분 및 연속형 쿼리를 실행한다.
- 그리고 카탈리스트 엔진(코드 생성, 쿼리 최적화 등의 기능을 지원)을 사용해 연산에 대한 논리적 명령을 처리한다.

- 정형 스트리밍은 스트림 데이터를 계속해서 추가되는 테이블처럼 다루는 것이 핵심 개념이다.
- 스트리밍 잡(job)은 계속해서 신규 입력 데이터를 확인 및 처리한다.
4. 정형 스트리밍의 핵심 개념
- 스파크는 복잡한 처리를 자동으로 제어하면서 스트림에 모든 스파크 연산을 사용할 수 있는 단순한 방법을 제공하려는 목적을 가지고 있다.
4.1 입력 소스
- 스파크에서 지원하는 입력 소스는 다음과 같다.
- 아파치 카프카
- HDFS나 S3 등 분산 파일 시스템의 파일(디렉터리의 신규 파일을 계속해서 읽는다.)
- 테스트용 소켓 소스
4.2 싱크
- 싱크(sink)을 이용해 스트림의 결과를 저장할 목적지를 명시한다.
- 싱크와 실행 엔진은 데이터 처리의 진행 상황을 신뢰도 있고 정확하게 추적하는 역할을 한다.
4.3 출력 모드
- 출력 모드는 데이터의 출력 방식을 정의한다.
-
스파크가 지원하는 출력 모드은 다음과 같다.
- append : 싱크에 신규 레코드만 추가
- update : 변경 대상 레코드 자체를 갱신
- complete : 전체 출력 내용 재작성하기
4.4 이벤트 시간 처리
- 정형 스트리밍은 이벤트 시간 기준의 처리를 지원한다.
- 처리 방식은 무작위로 도착한 레코드 내부에 기록된 타임스탬프를 기준으로 한다.
- 이벤트 시간(event-time) 데이터
- 스파크는 데이터가 유입된 시간이 아니라 데이터 생성 시간을 기준으로 처리한다.
- 따라서 데이터가 늦게 업로드되거나 네트워크 지연으로 데이터의 순서가 뒤섞인 채 시스템으로 들어와도 처리할 수 있다.
- 시스템은 입력 데이터를 테이블로 인식하기 때문에 이벤트 시간은 테이블에 있는 하나의 컬럼뿐이므로, 표준 SQL 연산자를 이용해 그룹화, 집계, 그리고 윈도우 처리를 할 수 있다.
- 워터마크(Watermarks)
- 워터마크는 시간 제한을 설정할 수 있는 스트리밍 시스템의 기능이다.
- 예로, 늦게 들어온 이벤트를 어디까지 처리할지 시간을 제한할 수 있다.
5. 정형 스트리밍 예제
- 다음은 정형 스트리밍을 어떻게 사용되는지 예제를 통해 알아본다.
- 예제에서는 인간 행동 인지를 위한 이기종 데이터셋을 사용한다.
-
데이터는 스마트폰과 스마트워치의 다양한 장치에서 지원하는 최대 빈도로 샘플링한 센서 데이터로 구성되어 있다.
-
스파크를 pyspark 기반의 파이썬으로 실행하기 위해 먼저 sparksession을 이용해 앱을 초기화해준다.
from pyspark.sql import SparkSession spark = SparkSession.builder \ .appName('streaming1') \ .master("local") \ .config("spark.some.config.option", "some-value") \ .getOrCreate() - 정적인 방식으로 데이터를 읽는다.
- 데이터 경로는 각자 환경에 맞게 입력한다.
-
그리고 스키마 결과는 다음과 같다.
static = spark.read.json('/Users/hyunseokjung/data/spark_guide/activity-data/') dataSchema = static.schema dataScehma -
결과

-
예제 데이터는 타임스탬프와 모델, 사용자, 장비 정보, 해당 시점의 사용자 행동 유형(gt)를 가지고 있다.

- 이제 데이터셋을 스트리밍 방식으로 처리해본다.
- 이번 예제에서는 스트림 방식으로 데이터를 처리하는 상황을 가정하기 위해 각 입력 파일을 하나씩 읽는다.
- 스파크 애플리케이션에서 스트리밍 DataFrame을 생성한 후 트랜스포메이션을 통해 적합한 포맷의 데이터를 얻는다.
-
여기서는 정적 DataFrame에서 알아낸 dataSchema 객체를 스트리밍 DataFrame에 지정한다.
streaming = spark.readStream.schema(dataSchema) \ .option("maxFilesPerTrigger", 1) \ .json('/Users/hyunseokjung/data/spark_guide/activity-data/') - 스트리밍 DataFrame의 생성과 실행은 지연 처리 방식(lazy operation)으로 동작한다.
-
또한 파티션 수를 변경할 수 있다.
activityCounts = streaming.groupBy("gt").count() spark.conf.set("spark.sql.shuffle.partitions", 5) # default : 200 - 트랜스포메이션 정의 후 스트림 쿼리를 시작하는 액션을 정의한다.
- 쿼리 결과를 내보낼 목적지나 싱크를 지정해야 하는데, 이번 예제에서는 결과를 메모리에 저장하는 메모리 싱크(memory sink)를 사용한다.
-
그리고 싱크를 지정하는 과정에서 스파크가 데이터를 출력하는 방식도 함께 정의해야 한다.
activityQuery = activityCounts.writeStream \ .queryName("activity_counts") \ .format("memory").outputMode("complete") \ .start() -
awaitTermination()를 지정하여 쿼리 실행 중에 드라이버 프로세스가 종료되는 상황을 막을 수 있다.activityQuery.awaitTermination() - 다음 코드를 실행하면 실행 중인 스트림 목록을 확인할 수 있다.
spark.streams.active
-
결과

- 이제 스트림을 처리하고 있기 때문에 스트리밍 집계 결과가 저장된 메모리 테이블을 조회해 결과를 확인할 수 있다.
-
awaitTermination()가 있는 코드말고 다른 주피터 노트북 파일에 다음 코드를 실행하면 결과는 다음과 같다.
from time import sleep for _ in range(5): spark.sql('SELECT * FROM activity_counts').show() sleep(1) -
결과

6. 스트림 트랜스포메이션
- 스트리밍 트랜스포메이션은 정적 DataFrame의 트랜스포메이션을 대부분 포함한다.
- 하지만, 스트리밍 데이터에 맞지 않는 트랜스포메이션 제약들이 있을 수 있다.
- 예를 들어 사용자가 집계하지 않은 스트림을 정렬할 수 없다.
- 그리고 상태 기반 처리(stateful processing)를 사용하지 않으면 계층적 집계가 불가능하다.
6.1 선택과 필터링
- 정형 스트르밍은 DataFrame의 모든 함수와 개별 컬럼을 처리하는 선택(Selection)과 필터링(Filtering) 그리고 단순 트랜스포메이션을 지원한다.
- 먼저, 앞서 생성한
streaming의 컬럼들은 다음과 같다.streaming.columns: [‘Arrival_Time’, ‘Creation_Time’, ‘Device’, ‘Index’, ‘Model’, ‘User’, ‘gt’, ‘x’, ‘y’, ‘z’]
- 선택과 필터링을 사용하는 예제는 다음 코드와 같다.
- DataFrame의 트랜스포메이션에 대해 더 자세히 알고 싶다면 : [Spark] 집계 연산, 함수, SQL 명령어 정리
from pyspark.sql.functions import expr simpleTransform = streaming.withColumn("stairs", expr("gt like '%stairs%'")) \ .where("stairs") \ .where("gt is not null") \ .select("gt", "Model", "Arrival_Time", "Creation_Time") \ .writeStream \ .queryName("simple_transform") \ .format("memory") \ .outputMode("append") \ .start() -
정규 표현식 기본 구문 정리 그림 1

6.2 집계
-
정형 스트리밍은 집계 기능을 지원한다.
deviceModelStats = streaming.cube("gt", "model").avg() \
    .drop("avg(Arrival_Time)") \
    .drop("avg(Creation_Time)") \
    .drop("avg(Index)") \
    .writeStream.queryName("device_counts").format("memory") \
    .outputMode("complete") \
    .start()
6.3 조인
-
스트리밍 DataFrame과 정적 DataFrame의 조인(join)을 지원한다.
historicalAgg = static.groupBy("gt", "model").avg()
deviceModelStats = streaming.drop("Arrival_Time", "Creation_Time", "Index") \
    .cube("gt", "model").avg() \
    .join(historicalAgg, ["gt", "model"]) \
    .writeStream.queryName("device_counts").format("memory") \
    .outputMode("complete") \
    .start()
7. 정형 스트리밍의 입출력 (소스와 싱크)
지금까지 정형 스트리밍의 기본 동작 원리와 정적/스트리밍 DataFrame 간의 트랜스포메이션을 살펴보았다. 실제 엔터프라이즈 환경에서는 데이터가 파일 시스템이나 분산 메시징 큐를 통해 실시간으로 유입되고 다른 외부 저장소로 안전하게 전달되어야 한다. 이제 소스와 싱크가 정형 스트리밍에서 어떻게 동작하며, 대표적인 분산 스트리밍 플랫폼인 아파치 카프카(Apache Kafka)와 어떻게 연동하는지 구체적으로 살펴본다.
정형 스트리밍에서는 아파치 카프카, 파일 그리고 테스트 및 디버깅용 소스와 싱크를 지원한다.
7.1 파일 소스와 싱크
- 가장 간단한 소스는 실제에서 파일 소스로, 파케이, 텍스트, JSON, CSV 파일 등을 자주 사용한다.
- 스트리밍에서 파일 소스/싱크와 정적 파일 소스를 사용할 때 유일한 차이점은 트리거(Trigger) 시 읽을 파일 수를 결정할 수 있다는 것이다.
7.2 카프카 소스와 싱크
- 아파치 카프카(Apache Kafka)는 데이터 스트림을 위한 발행-구독(publish-subscribe) 방식의 메시지 큐 기반 분산형 시스템이다.
- 카프카는 레코드의 스트림을 발행하고 구독하는 방식으로 사용한다.
- 발행된 메시지는 내결함성을 보장하는 저장소에 저장된다.
-
카프카를 분산형 버퍼로 생각할 수 있다.
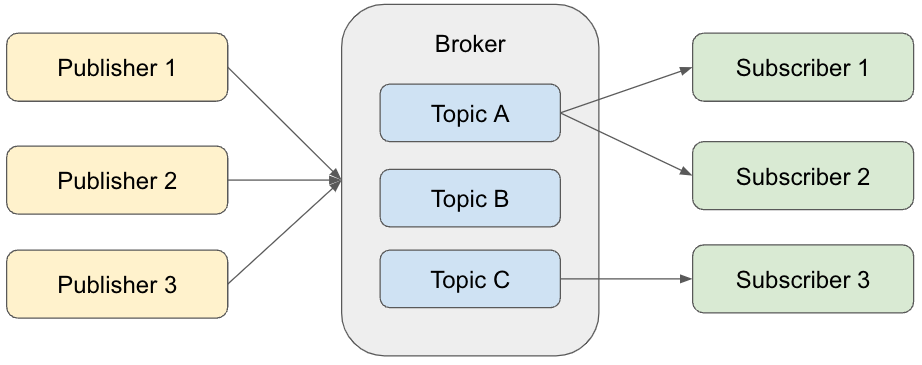
이미지출처 2 - 레코드(record)의 스트림은 토픽(topic)으로 불리는 카테고리에 저장한다.
- 카프카의 레코드는 키, 값, 타임스탬프로 구성된다.
- 레코드의 위치를 오프셋(offset)이라 한다.
- 토픽은 순서를 바꿀 수 없는 레코드로 구성된다.
- 카프카의 레코드는 키, 값, 타임스탬프로 구성된다.
- 데이터를 쓰는 동작을 발행(publish)이라 하며, 읽는 동작을 구독(subscribe)이라 한다.
- 스파크는 카프카에 저장된 스트림을 배치와 스트리밍 방식으로 읽어 DataFrame을 생성할 수 있다.
8. 카프카 소스에서 메시지 읽기
- 메시지를 읽기 위해 먼저 해야 할 일은 다음 옵션 중 하나를 선택하는 것이다.
- assign : 토픽뿐만 아니라 읽으려는 파티션까지 세밀하게 지정하는 옵션이다.
- ex.) JSON 문자열(
{"topicA":[0,1]}, "topicB":[2,4])
- ex.) JSON 문자열(
- subscribe : 토픽 목록을 지정해 여러 토픽을 구독하는 옵션이다.
- subscribePattern : 토픽 패턴을 지정해 여러 토픽을 구독하는 옵션이다.
- assign : 토픽뿐만 아니라 읽으려는 파티션까지 세밀하게 지정하는 옵션이다.
- 그 다음은 카프카 서비스에 접속할 수 있도록
kakfa.bootstrap.servers값을 지정하는 것이다. - 그 외 몇 가지 옵션을 더 설정해야 한다.
- startingOffsets 및 endingOffsets : 쿼리를 시작할 때 읽을 지점이다. 옵션값으로 earliest는 가장 작은 오프셋부터 읽으며 latest는 가장 큰 오프셋부터 읽는다.
- failOnDataLoss : 데이터 유실이 일어났을 때 쿼리를 중단할 것인지 지정한다. (default : True)
- maxOffsetPerTrigger : 특정 트리거 시점에 읽을 오프셋의 전체 개수이다.
-
카프카에서 메시지를 읽으려면 정형 스트리밍에서 다음 코드를 사용한다.
# topic1 구독 df1 = spark.readStream.format("kafka") \ .option("kafka.bootstrap.servers", "host1:port1, host2:port2") \ .option("subscribe", "topic1") \ .load() # 여러 개의 토픽 구독 df1 = spark.readStream.format("kafka") \ .option("kafka.bootstrap.servers", "host1:port1, host2:port2") \ .option("subscribe", "topic1, topic2") \ .load() # 패턴에 맞는 토픽 구독 df1 = spark.readStream.format("kafka") \ .option("kafka.bootstrap.servers", "host1:port1, host2:port2") \ .option("subscribe", "topic.*") \ .load() - 카프카 소스의 각 로우는 다음과 같은 스키마를 가진다.
- 키 : binary
- 값 : binary
- 토픽 : string
- 패턴 : int
- 오프셋 : long
- 타임스탬프 : long
9. 카프카 싱크에 메시지 쓰기
-
카프카로 메시지를 발행하는 쿼리와 읽는 쿼리는 매우 비슷하다.
  df1.selectExpr("topic", "CAST(key AS STRING)", "CAST(value AS STRING)") \
      .writeStream \
      .option("kafka.bootstrap.servers", "host1:port1, host2:port2") \
      .option("checkpointLocation", "/to/HDFS-compatible/dir") \
      .start()

  df1.selectExpr("CAST(key AS STRING)", "CAST(value AS STRING)") \
      .writeStream \
      .format("kafka") \
      .option("kakfa.bootstrap.servers", "host1:port1, host2:port2") \
      .option("checkpointLocation", "/to/HDFS-compatible/dir") \
      .option("topic", "topic1") \
      .start()
10. 테스트용 소스와 싱크
- 스파크는 스트리밍 쿼리의 prototype을 만들거나 debugging시 유용한 몇 가지 테스트용 소스와 싱크를 제공한다.
10.1 소켓 소스
- 데이터를 읽기 위한 호스트와 포트를 지정한 후, TCP 소켓을 통해 스트림 데이터를 전송할 수 있다.
- 스파크는 해당 주소에서 데이터를 읽기 위해 새로운 TCP 연결을 생성한다.
-
localhost:9999에서 데이터를 읽는 코드 예제는 다음과 같다.socketDF = spark.readStream.format("socket") \ .option("host", "localhost") \ .option("port", 9999).load() - 스파크 애플리케이션을 실행하면 9999 포트로 데이터를 전송할 수 있다.
-
소켓 소스는 입력 데이터 한 줄을 하나의 텍스트 문자열 로우로 구성한 테이블을 반환한다.
nc -lk 9999
10.2 콘솔 싱크
- 콘솔 싱크는 스트리밍 쿼리의 처리 결과를 콘솔로 출력할 때 사용한다.
-
기본적으로 append와 complete 출력 모드를 지원한다.
  activityCounts.writeStream.format("console") \
      .outputMode("complete") \
      .start()
10.3 메모리 싱크
- 메모리 싱크는 스트리밍 시스템을 테스트하는 데 사용하는 소스이다.
- 드라이버에 데이터를 모은 후 대화형 쿼리가 가능한 메모리 테이블에 저장한다.
-
append와 complete 출력 모드를 지원한다.
  activityCounts.writeStream.format("memory") \
      .queryName("my_device_table")
11. 데이터 출력 방법 (출력 모드)
- 정형 스트리밍 지원하는 세 가지 출력모드는 다음과 같다.
- append 모드
- 새로운 로우가 결과 테이블에 추가되면 사용자가 명시한 트리거에 맞춰 싱크로 출력된다.
- 이벤트 시간과 워터마크를 append 모드와 함께 사용하면 최종 결과만 싱크로 출력한다.
- complete 모드
- 결과 테이블의 전체 상태를 싱크로 출력한다.
- 모든 데이터가 계속해서 변경될 수 있는 일부 상태 기반 데이터(stateful data)를 다룰 때 유용하다.
- update 모드
- 이전 출력 결과에서 변경된 로우만 싱크로 출력한다. 나머지는 complete 모드와 유사하다.
12. 데이터 출력 시점 (트리거)
- 트리거(trigger)를 설정하면 데이터를 싱크로 출력하는 시점을 제어할 수 있다.
- 정형 스트리밍에서는 보통 직전 트리거가 처리를 마치자마자 즉시 데이터를 출력한다.
-
현재는 처리 시간 기반의 주기형 트리거(periodic trigger)와 처리 단계를 수동으로 한 번만 실행할 수 있는 일회성 트리거(once trigger)를 제공한다.
  # 처리 시간 기반 트리거
  activityCounts.writeStream.trigger(processingTime='5 seconds') \
      .format("console").outputMode("complete") \
      .start()

  # 일회성 트리거
  activityCounts.writeStream.trigger(once=True) \
      .format("console").outputMode("complete") \
      .start()
핵심 정리
- 스트림 처리와 마이크로 배치: 스트림 처리는 신규 데이터를 연속적으로 받아 증분 결과를 산출하며, 스파크 정형 스트리밍은 마이크로 배치 아키텍처를 기반으로 높은 처리량과 동적 부하 분산을 달성한다.
- 테이블로서의 스트림: 정형 스트리밍은 유입되는 스트림 데이터를 무한히 추가되는 테이블로 간주하고, 카탈리스트 옵티마이저를 통해 배치 연산과 동일한 DataFrame/SQL 선언형 API로 증분 쿼리를 최적화하여 실행한다.
- 이벤트 시간과 워터마크: 데이터 유입 시점이 아닌 생성 시점(이벤트 시간)을 기준으로 지연 도착 데이터를 정합성 있게 처리하며, 워터마크를 지정해 상태 메모리를 효율적으로 유지·해제한다.
- 다양한 소스와 싱크: 분산 파일 시스템(JSON, Parquet 등), 아파치 카프카, 테스트용 소켓·콘솔·메모리 싱크 등 폭넓은 소스와 싱크를 지원해 상황에 맞는 파이프라인 구성이 가능하다.
- 카프카 연동 옵션:
subscribe,assign,startingOffsets,failOnDataLoss등의 세밀한 옵션으로 메시지를 구독하고, 오프셋과 키-값 바이너리 데이터를 스트리밍 DataFrame으로 유연하게 다룬다. - 출력 모드(append, complete, update): 추가된 행만 출력하는 append, 전체 테이블 상태를 다시 쓰는 complete, 갱신된 행만 반영하는 update 모드로 비즈니스 요구사항에 맞춰 결과를 내보낸다.
- 트리거 제어: 기본 주기형 트리거(processingTime) 또는 배치형 1회 실행 트리거(once)를 통해 싱크 출력 주기를 상황에 맞게 유연하게 조율한다.
댓글남기기