
MCP 토큰 최적화 4가지 기법: 점진적 발견부터 코드 실행 호출까지
사내 AI 플랫폼에 MCP 서버를 붙여 나가면서 가장 먼저 이상해진 숫자는 응답 품질이 아니라 입력 토큰(input token) 이었다. 도구 세트를 하나 추가할 때마다 대화에 남는 공간이 줄었고, 같은 질문을 반복해도 요금이 줄지 않았다. 모델을 바꿔도, 프롬프트를 다듬어도 그래프의 기울기는 그대로였다. 문제는 도구 호출 자체가 아니라 호출되기도 전에 이미 실려 나가는 도구 “정의” 였다.
MCP의 토폴로지, 세 가지 프리미티브, 전송 계층, 보안 경계는 앞선 글에서 이미 다뤘다. 도구(Tool)라는 경계가 왜 위험한지도 보안 가이드에서 정리했다. 그래서 이 글은 그 위에 얹지 않고 다른 각도 하나만 판다. 도구 정의가 어떻게 청구서가 되고, 그 청구서를 어떤 순서로 깎아야 하는가다. MCP를 “동작하게” 만드는 문서는 많지만, 늘어난 도구가 만든 비용 구조를 처음부터 다시 세는 문서는 드물다.
이 글은 공개 매뉴얼 저장소의 MCP 토큰 최적화 문서1를 바탕으로, 업계 실측치와 MCP 공식 클라이언트 지침을 다시 정리한 독립 문서다. 결론을 먼저 말하면 순서가 중요하다. 측정 → 정의 토큰 줄이기 → 반환 데이터 줄이기 → 캐시 정합성 맞추기다. 네 기법은 서로 대체재가 아니라 서로 다른 지점을 깎는 도구다.
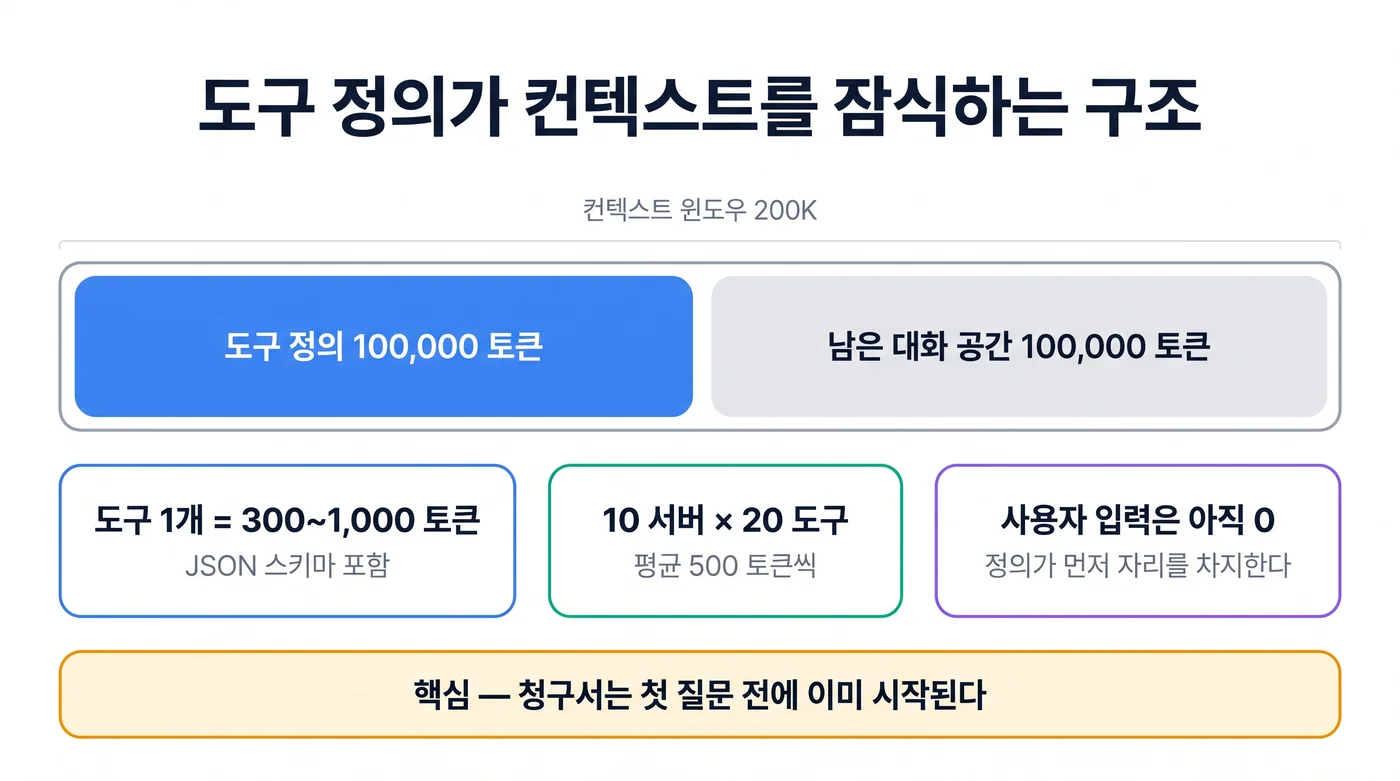
1. 도구 목록이 청구서가 되는 구조
1.1 도구 정의는 매 요청에 실려 간다
LLM은 함수 호출(function calling)을 하려면 그 함수의 이름과 파라미터 구조를 알아야 한다. 그래서 클라이언트는 도구마다 이름, 설명, JSON 스키마(JSON Schema)를 직렬화해 매 요청의 tools 배열에 담아 보낸다. 문제는 이 배열이 세션당 한 번이 아니라 요청마다 실린다는 점이다.
대화가 길어져도 이 부분은 줄지 않는다. 오히려 서버가 늘수록 함께 커진다. 사용자 발화 한 줄을 넣기 전에 이미 수만~수십만 토큰이 확정 지출되는 구조다.
1.2 업프론트 로딩(upfront loading)이라는 기본 동작
MCP 서버는 연결 시점에 list_tools를 호출하고, 그 결과인 도구 메타데이터 전체를 받아 둔다. 명세가 “필요할 때 가져오라”고 강제하지 않기 때문에, 대부분의 클라이언트는 이 목록을 그대로 시스템 프롬프트 쪽에 붙인다. 이것이 업프론트 로딩이다.
MCP 연결 → tools/list → 도구 메타데이터 전량 수신
                              │
                              ├─ 이름 · 설명 · JSON Schema
                              ├─ 파라미터 타입 · enum · 기본값
                              └─ annotation (읽기 전용 여부 등)
                              │
                              ▼
                    매 요청의 tools 배열에 직렬화
                              │
                              ▼
              "사용자 질문"보다 먼저 컨텍스트에 적재
도구 하나당 스키마는 대략 300~1,000+ 토큰을 쓴다. 파라미터가 많고 설명이 친절할수록 커진다. 즉 도구를 잘 설명해 준 친절함이 그대로 비용이 된다.
1.3 토폴로지가 아니라 청구서를 본다
앞선 글들에서 MCP의 위험은 “연결된 서버를 신뢰할 수 없다”는 데 있었다. 토큰 문제는 그와 직교한다. 서버가 100% 정직해도 도구가 200개면 컨텍스트는 그대로 잠식된다. 신뢰성과 효율은 다른 축이고, 최적화는 후자를 다룬다.
여기서 흔한 착각 하나. “도구를 적게 만들면 된다”는 답은 현실에서 잘 안 통한다. 도구는 늘어나는 방향으로만 움직이고, 줄이는 결정은 정치적 비용이 크다. 그래서 도구 수를 줄이는 대신 같은 도구 세트를 더 싸게 싣는 기법이 필요하다.
2. 문제 정량화: 무엇이 몇 토큰을 먹는가
2.1 세 가지 축으로 나눠 본다
토큰 오버헤드는 하나의 숫자가 아니라 세 축에서 각각 다른 방식으로 비용을 만든다. 최적화를 설계하기 전에 이 셋을 분리해야 한다.
| 축 | 무슨 일이 일어나는가 | 정량 예시 |
|---|---|---|
| 입력 토큰 비용 | 매 요청마다 도구 정의 전량을 재전송 | Claude Sonnet 4.5 기준 $3/M 토큰일 때 100k 정의 = 요청당 $0.302 |
| 컨텍스트 윈도우 소진 | 대화에 쓸 수 있는 실질 공간이 줄어든다 | 200k 윈도우에서 100k를 정의가 선점 → 실질 가용 50%3 |
| 프롬프트 캐시 히트율 | 도구 목록이 바뀔 때마다 접두부가 무효화된다 | 동적 도구 추가·제거가 캐시를 계속 깬다2 |
세 축은 서로 다른 기법으로 깎인다. 첫 번째는 3·4장(정의 압축·캐시), 두 번째는 5장(반환 데이터), 세 번째는 6장(캐시 정합성)이다. 하나의 기법이 세 축을 동시에 해결하지 않는다.
2.2 실측 기준점
업계에 공개된 측정값을 기준점(baseline)으로 삼는다. 숫자는 환경마다 다르지만 자릿수는 안정적으로 재현된다.
| 사례 | 구성 | 측정값 | 출처 |
|---|---|---|---|
| 중규모 멀티 서버 | 10개 서버 × 20개 도구 × 평균 500 토큰 | 사용자 입력 전 100,000 토큰 선점 | StackOne 분석3 |
| 단일 대형 서버 | GitHub MCP 서버 94개 도구, 무압축 | 17,600 토큰 | Atlassian Labs 실측4 |
| 대량 데이터 반환 | 10,000행 스프레드시트를 컨텍스트로 전달 | 150,000 토큰 | Anthropic 사례5 |
| 같은 작업, 코드 실행 | 샌드박스에서 필터링 후 5행만 전달 | 2,000 토큰 (98.7% 절감) | Anthropic 사례5 |
두 번째와 네 번째 행을 나란히 보면 기법의 성격 차이가 보인다. 툴 압축(Atlassian)은 정의를 깎아 자릿수를 한 단계 낮추고, 코드 실행(Anthropic)은 데이터를 깎아 자릿수를 두 단계 낮춘다. 적용 지점이 다르므로 둘은 경쟁하지 않는다.
2.3 먼저 재야 할 것
측정 없이 기법을 고르면 대개 잘못 고른다. 최적화 착수 전에 최소 세 가지를 같은 요청 집합에서 기록한다.
- 정의 토큰 / 총 입력 토큰 비율: 이 비율이 10% 미만이면 3·4장 기법의 상한 효익이 작다.
- 도구 반환 토큰 / 총 입력 토큰 비율: 5장(코드 실행)의 대상이 여기다. 도구가 큰 데이터를 뱉는 구조인지 확인한다.
- 프롬프트 캐시 히트율: 캐시가 이미 잘 맞고 있으면 6장은 손댈 필요가 없다. 반대로 히트율이 낮은데 동적 도구가 많다면 6장이 최우선이다.
이어지는 네 장은 각각 다른 지점을 깎는다. 정의를 깎는 기법(3·4장), 반환 데이터를 깎는 기법(5장), 단가와 재전송을 깎는 기법(6장)이다. 아래 그림이 그 지도다.
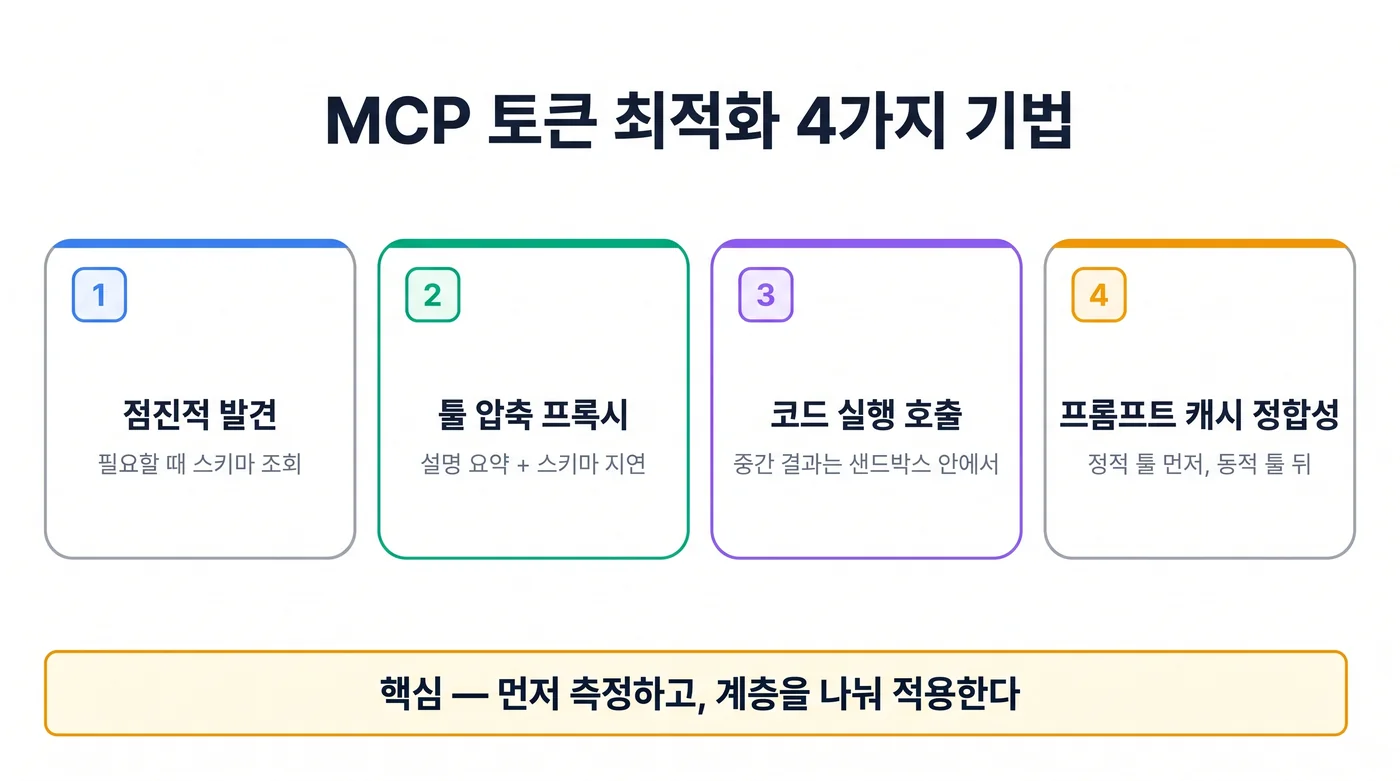
3. 기법 1: 점진적 발견(Progressive Discovery)
3.1 개념
도구 정의를 지연 로딩(lazy loading) 한다. 처음에는 도구 이름과 한 줄 설명만 싣고, 모델이 특정 도구를 쓰겠다고 판단한 시점에 그 도구의 상세 스키마를 조회해 온다. 업프론트 로딩과 정반대의 발상이다.
3.2 세 단계 플로우
MCP 공식 클라이언트 모범 사례는 이 흐름을 세 단계로 정리한다6.
- Catalog(검색):
search_tools(query="file operations")→ 관련 도구 이름 목록만 반환 - Inspect(조회):
get_tool_schema(tool_name="read_file")→ 그 도구의 JSON 스키마 반환 - Execute(실행):
invoke_tool(tool_name="read_file", args={...})→ 실제 호출
핵심은 1단계의 응답이 이름 수준이라는 점이다. 스키마는 2단계에서, 그것도 선택된 도구 하나만 온다. 컨텍스트에는 항상 “지금 쓰려는 도구 하나”의 스키마만 남는다.
3.3 임계값 기반 하이브리드
항상 지연 로딩하는 것이 답은 아니다. 도구가 세 개뿐인 서버에서는 왕복 지연만 늘어난다. MCP 공식 문서는 컨텍스트 윈도우의 1~5% 를 임계값으로 제시한다6. 정의 토큰이 이 선을 넘으면 지연 로딩으로 전환하는 하이브리드가 실용적이다.
# 개념 예시: 임계값을 넘는 도구만 지연 로딩으로 표시
def decide_loading(servers, context_window):
    budget = context_window * 0.05          # 윈도우의 5%
    used, plan = 0, []
    for server in servers:
        for tool in server.list_tools():
            cost = estimate_tokens(tool.schema)
            if used + cost <= budget:
                plan.append({**tool, "schema": "inline"})   # 업프론트 로딩 유지
                used += cost
            else:
                plan.append({"name": tool.name,               # 이름 + 한 줄 설명만
                             "description": tool.description,
                             "schema": "lazy"})               # 필요 시 조회
    return plan
3.4 트레이드오프
| 얻는 것 | 잃는 것 |
|---|---|
| 초기 컨텍스트에서 상세 스키마 제거 (절감 폭은 도구 세트 구성에 따라 상이) | 도구 호출마다 스키마 조회 왕복 1회가 추가되어 지연이 늘어난다 |
| 대화에 쓸 수 있는 윈도우 공간 확보 | 모델이 전체 도구 목록을 한눈에 보지 못해 선택 정확도가 흔들릴 수 있다 |
| 도구 목록이 요청마다 고정되어 캐시 안정성이 올라간다 | 멀티스텝 추론에서 같은 스키마를 반복 조회할 수 있다 |
4. 기법 2: 툴 압축 프록시
4.1 프록시가 하는 일
기존 MCP 서버 앞에 프록시(proxy) 를 세우고, 프록시가 도구 설명을 압축한 요약본만 내보낸다. 원본 서버와 에이전트 코드는 건드리지 않는다. Atlassian Labs가 공개한 mcp-compressor가 이 형태이며, 세 개의 API를 노출한다4.
list_tools— 압축된 목록(이름 + 초간단 설명)get_tool_schema— 특정 도구의 상세 스키마invoke_tool— 원본 서버로 호출 위임
프록시 방식의 장점은 배포 경계에 있다. 서버를 하나씩 고치지 않고 게이트웨이 한 곳에서 압축 강도를 정책으로 관리할 수 있다.
4.2 압축 강도별 실측
GitHub MCP 서버(94개 도구)를 대상으로 한 실측은 강도와 절감률의 관계를 잘 보여준다4.
| 강도 | 토큰 수 | 절감률 | 무엇을 남기는가 |
|---|---|---|---|
| 무압축 | 17,600 | 0% | 원본 |
| Low | 3,900 | 78% | 주요 파라미터 유지 |
| Medium | 3,300 | 81% | 선택적 파라미터 제거 |
| High | 2,200 | 87% | 필수 파라미터만 |
| Extreme | 500 | 97% | 이름 + 한 줄 설명 |
주목할 지점은 Low에서 이미 78% 라는 것이다. 즉 “설명을 조금만 줄여도” 절감의 대부분을 가져간다. 반대로 High를 넘어 Extreme으로 가면 스키마 정보가 거의 사라져 모델이 파라미터를 추측하게 되므로, 정확도 손실을 함께 측정해야 한다.
4.3 적합·부적합 시나리오
| 적합 | 부적합 |
|---|---|
| 도구가 50개 이상인 대형 세트 | 도구가 5개 미만이라 압축 이득이 없다 |
| 도구 목록이 자주 바뀌지 않는 환경 | 도구 구성이 매 요청 바뀌어 요약본도 함께 바뀐다 |
| 지연보다 비용이 중요한 워크로드 | 서브초 지연이 제품 요구사항인 대화형 UI |
5. 기법 3: 코드 실행형 도구 호출
5.1 왜 절감 폭이 가장 큰가
툴 압축이 정의를 깎는 기법이라면, 코드 실행(Code Execution)은 중간 결과를 깎는다. 도구를 JSON 스키마가 아니라 프로그래밍 API(예: TypeScript 파일 트리)로 노출하고, 모델이 샌드박스에서 코드를 작성·실행해 도구를 호출하게 한다. 결정적인 차이는 중간 데이터가 실행 환경 안에서 처리된다는 점이다.
[일반 도구 호출]                       [코드 실행형 호출]

  도구 → 10,000행 전체 반환              도구 → 샌드박스가 데이터 보유
      │                                     │
      ▼                                     ▼
  모델 컨텍스트에 10,000행 적재          코드가 필터·집계 수행
      │                                     │
      ▼                                     ▼
  모델이 다시 필터링                     최종 5행만 컨텍스트로 반환
      │                                     │
  150,000 토큰                          2,000 토큰
일반 경로에서 도구 반환값은 예외 없이 컨텍스트를 통과한다. 코드 실행 경로에서는 컨텍스트를 통과하는 것이 코드의 최종 출력뿐이다. 그래서 데이터 규모가 클수록 격차가 벌어진다.
5.2 실측 사례
Anthropic이 공개한 10,000행 스프레드시트 시나리오는 이 격차를 숫자로 보여준다5.
- 기존 방식: 데이터 전체를 컨텍스트로 전달 → 150,000 토큰
- 코드 실행: 샌드박스에서 필터링 후 5행만 전달 → 2,000 토큰 (98.7% 절감)
Cloudflare는 같은 발상을 Workers 샌드박스로 구현한 “Code Mode”를 공개했다. 툴 정의 대신 TypeScript API를 주고, 모델이 생성한 코드를 격리된 V8 런타임에서 실행한다7.
5.3 샌드박스 격리 요구사항
이 기법은 임의 코드 실행을 전제하므로 샌드박스 격리가 선택이 아니라 전제조건이다. 최소한 다음 네 가지를 함께 설계한다.
- 격리 경계: V8 isolate, 컨테이너, 전용 런타임 중 무엇으로 격리하는지 명시한다.
- 호출 가능 API 제한: 샌드박스가 접근할 수 있는 도구·엔드포인트를 허용목록으로 고정한다.
- 리소스 상한: CPU·메모리·실행 시간·출력 크기에 상한을 둔다. 출력 크기 상한이 없으면 컨텍스트 절감 효과 자체가 사라진다.
- 자격증명 분리: 샌드박스에 장기 자격증명을 넣지 않고, 호출 시점 발급 단기 토큰을 쓴다.
세 번째 항목을 놓치는 경우가 많다. 샌드박스가 결과를 무제한으로 뱉으면 “중간 결과를 컨텍스트로 보내지 않는다”는 이점이 그대로 무너진다.
6. 기법 4: 프롬프트 캐시 정합성
6.1 캐시가 깨지는 이유
프롬프트 캐시(prompt caching)는 접두부(prefix) 일치로 동작한다. 앞부분이 한 글자라도 달라지면 그 뒤는 전부 재계산 대상이다. 그런데 MCP에서는 세션 중에 도구가 추가·제거되는 일이 흔하다. tools 배열이 바뀌면 접두부가 바뀌고, 캐시는 매번 미스가 난다.
문제는 배열이 “대부분 같은데 일부만 다르다”는 상황이다. 서버 하나가 도구를 하나 추가했다고 캐시 전체를 버리는 건 낭비다.
6.2 정적·동적 분리 배치
해법은 변하지 않는 것을 앞으로, 변하는 것을 뒤로 모으는 것이다. 정적 도구 목록을 캐시 브레이크포인트(cache breakpoint) 앞에 고정하고, 동적 도구는 그 뒤에 덧붙인다.
┌─ 시스템 프롬프트 ────────────────────────────┐
│  정적 도구 정의 (search_kb, create_ticket…)  │  ← 캐시 대상
├─ 캐시 브레이크포인트 ────────────────────────┤
│  동적 도구 (세션별 커스텀 액션, 임시 도구)    │  ← 캐시 밖
├──────────────────────────────────────────────┤
│  대화 이력 / 사용자 요청                      │
└──────────────────────────────────────────────┘
분류 기준은 단순하다. 세션 간에 같으면 정적, 세션마다 다르면 동적이다.
| 유형 | 예시 | 배치 |
|---|---|---|
| 정적 | search_kb, create_ticket, get_weather |
캐시 브레이크포인트 앞 |
| 동적 | 사용자별 커스텀 액션, 세션 한정 임시 도구 | 캐시 브레이크포인트 뒤 |
여기에 3장의 점진적 발견을 겹치면 시너지가 난다. 지연 로딩되는 도구는 애초에 접두부에 없으므로 접두부가 흔들리지 않는다.
6.3 캐시가 만드는 단가 차이
Anthropic Prompt Caching은 캐시 히트 시 입력 토큰 단가를 크게 낮춘다. 공개된 수치 기준으로 일반 입력이 $3/M, 캐시 입력이 $0.30/M이며, 이는 약 90% 절감이다2. 정적 도구 100k 토큰을 캐시에 태우면 요청당 약 $0.27 를 아낀다.
주의할 점은 이 절감이 “토큰 수”가 아니라 “단가”에서 온다는 것이다. 그래서 캐시 절감과 컨텍스트 절감은 반드시 따로 집계해야 한다. 둘을 합쳐 놓으면 어느 기법이 실제로 얼마를 벌었는지 알 수 없다.
7. 게이트웨이 레벨에서 통합하기
7.1 계층별 책임 분담
네 기법을 클라이언트 코드에 흩어 놓으면 유지보수가 불가능해진다. 앞선 글들에서 다룬 게이트웨이 계층 구조 위에 각 기법의 책임을 나눠 얹는다.
| 계층 | 맡는 기법 | 구현 지점 |
|---|---|---|
| 에이전트 데이터 플레인(Agent Data Plane) | 점진적 발견 | search_tools / get_tool_schema API 제공 |
| LLM API 게이트웨이 | 툴 압축 프록시, 프롬프트 캐시 정합성 | 압축 프록시 래핑, 정적·동적 도구 분리 배치 |
| 클라이언트 SDK | 코드 실행형 호출 | 샌드박스 호출, 실행 결과 필터링 |
이 분담의 요점은 “어디서 무엇을 고칠 것인가”를 한 곳에서 정할 수 있다는 것이다. 압축 강도나 캐시 정책을 게이트웨이 정책 파일로 두면, 서버 20개를 각각 배포하지 않고도 바꿀 수 있다.
7.2 효율과 보안은 별개 축
토큰 최적화는 효율을 다루고, 도구 허용목록·스코프 토큰 같은 통제는 보안을 다룬다. 둘은 독립적이며 동시에 적용되어야 한다1. 특히 5장의 코드 실행은 “효율 기법”이면서 동시에 “임의 코드 실행 표면”이라는 이중 성격을 갖는다. 성능 목표를 위해 격리 수준을 낮추는 결정은 보안 결정이므로, 별도 승인 절차를 거치는 편이 안전하다.
7.3 Azure AI Gateway에서의 대응
같은 계층 분담은 Azure에서도 그대로 성립한다. Azure API Management(APIM)를 AI 게이트웨이로 쓰면 azure-openai-token-limit 정책으로 토큰 상한을, azure-openai-semantic-cache-lookup/store 정책으로 시맨틱 캐시를, azure-openai-emit-token-metric으로 토큰 계측을 게이트웨이 레벨에서 걸 수 있다. 즉 6장의 캐시 정합성과 7.1의 계측 책임을 애플리케이션 바깥으로 밀어낼 수 있다. 다만 프롬프트 캐시(접두부 일치 기반 단가 할인)와 시맨틱 캐시(의미 유사도 기반 응답 재사용)는 다른 계층의 다른 기법이므로, 지표를 볼 때 합산하지 않는다.
실무 적용: 토큰 예산 관리와 도입 순서
A. 토큰 예산 산정표
최적화는 “얼마를 아꼈다”가 아니라 “얼마를 쓰기로 정했다”에서 출발한다. 아래 표를 요청 집합 단위로 채운다.
| 예산 항목 | 계산식 | 예시(사내 기준) | 판단 |
|---|---|---|---|
| 도구 정의 예산 | 도구 수 × 도구당 토큰 | 60개 × 500 = 30,000 | 윈도우의 15% 초과 시 3·4장 적용 |
| 도구 반환 예산 | 평균 반환 토큰 × 평균 호출 수 | 4,000 × 3 = 12,000 | 정의 예산보다 크면 5장 우선 |
| 시스템·지침 예산 | 고정 프롬프트 토큰 | 3,000 | 캐시 브레이크포인트 앞으로 이동 |
| 대화 예산 | 남은 윈도우 | 잔여 전부 | 실사용 대화 길이 대비 2배 여유 확보 |
| 상한(게이트) | 정의+반환+지침 합계 | 45,000 | 이 값을 넘으면 요청 거부 또는 강등 |
마지막 행이 실무에서 가장 중요하다. 예산은 문서가 아니라 거부 조건으로 구현해야 지켜진다.
B. 기법별 도입 난이도와 효과
| 기법 | 도입 난이도 | 손대는 대상 | 기대 효과 | 리스크 |
|---|---|---|---|---|
| 프롬프트 캐시 정합성 | 낮음 | 배치 순서 | 캐시 히트 시 입력 단가 약 90% 절감2 | 정적·동적 분류를 잘못하면 효과 없음 |
| 툴 압축 프록시 | 낮음~중간 | 게이트웨이 1곳 | Low 강도에서 이미 78% 절감4 | 파라미터 설명 손실로 호출 정확도 하락 |
| 점진적 발견 | 중간 | 게이트웨이 + 클라이언트 | 정의 토큰을 이름 수준까지 축소6 | 스키마 조회 왕복으로 지연 증가 |
| 코드 실행형 호출 | 높음 | 샌드박스 인프라 | 반환 데이터 기준 최대 98.7% 절감5 | 격리·리소스 상한 미비 시 보안 사고 |
난이도와 효과가 단조 증가하지 않는다는 점이 중요하다. 가장 싸게 큰 절감을 얻는 조합은 6장(캐시 정합성) + 4장(압축 Low) 이다.
C. 도입 순서 체크리스트
한 번에 네 기법을 다 넣지 않는다. 각 단계는 이전 단계의 측정값이 있어야 판단할 수 있다.
| 기간 | 할 일 | 완료 판정 |
|---|---|---|
| 1주 | 토큰 계측(정의/반환/지침 분해) · 정적·동적 도구 분류 · 캐시 브레이크포인트 배치 | 요청 로그에서 세 축이 분리 집계됨, 캐시 히트율 상승 확인 |
| 1개월 | 툴 압축 프록시 도입(Low부터) · 도구 선택 정확도 음성 테스트 · 정의 예산 상한 게이트 | 정의 토큰 감소 + 도구 선택 정확도 하락 5%p 이내 |
| 1분기 | 점진적 발견 전환(1~5% 임계값 기반) · 반환 데이터 큰 도구부터 코드 실행 이관 | 스키마 조회 왕복 지연이 SLA 안, 대량 반환 도구의 컨텍스트 통과량 감소 |
| 상시 | 강도·임계값 재조정, 예산 재산정 | 월 1회 예산 대비 실측 리포트 |
체크리스트 사용법은 “항목 존재”가 아니라 거부되는 것을 확인하는 것이다. 정의 예산 상한을 넣었다면 상한을 넘긴 요청이 실제로 거부되는 로그가 있어야 완료로 본다.
D. 모니터링 지표와 롤백 기준
최적화는 정확도를 조용히 갉아먹는 방식으로 실패한다. 그래서 효율 지표와 품질 지표를 같은 대시보드에 둔다.
| 지표 | 의미 | 정상 방향 | 롤백 트리거 |
|---|---|---|---|
| 정의 토큰 / 총 입력 | 도구 메타데이터 비중 | 감소 | 감소하지 않으면 해당 기법 무효 → 제거 |
| 도구 선택 정확도 | 기대 도구 호출 비율 | 유지 | 베이스라인 대비 5%p 이상 하락 시 즉시 롤백 |
| 캐시 히트율 | 접두부 일치 비율 | 상승 | 상승 없으면 배치 순서 재검토 |
| 툴 호출 지연 p95 | 조회 왕복 포함 | SLA 이내 | SLA 초과 시 점진적 발견 임계값 상향 |
| 요청당 비용 | 단가 × 토큰 | 감소 | 증가 시 캐시·압축 설정 원복 |
롤백은 기법 단위로 한다. 네 기법은 서로 다른 계층에 있으므로 한꺼번에 되돌릴 필요가 없다. 예를 들어 코드 실행에서 품질 문제가 나면 샌드박스만 끄고, 압축 강도와 캐시 배치는 유지한다.
References
-
Engineering Playbook —
docs/agentic-ai-platform/design-architecture/advanced-patterns/mcp-token-optimization.md(저장소 매뉴얼, https://devfloor9.github.io/engineering-playbook/). 게이트웨이 계층별 최적화 책임 분담과 보안 통제(도구 허용목록·스코프 토큰)와의 관계를 이 문서에서 참고했다. ↩ ↩2 -
Anthropic, “Prompt Caching” — 입력 $3/M 대비 캐시 입력 $0.30/M, 약 90% 단가 절감. https://www.anthropic.com/engineering/advanced-tool-use ↩ ↩2 ↩3 ↩4
-
StackOne, “MCP Token Optimization” — 10개 서버 × 20개 도구 × 평균 500토큰 = 사용자 입력 전 100,000 토큰 선점 분석. https://www.stackone.com/blog/mcp-token-optimization/ ↩ ↩2
-
Atlassian Labs, “MCP Compression: Preventing Tool Bloat in AI Agents” —
mcp-compressor프록시, GitHub MCP 서버 94개 도구 실측(17,600 → 500 토큰). https://www.atlassian.com/blog/developer/mcp-compression-preventing-tool-bloat-in-ai-agents ↩ ↩2 ↩3 ↩4 -
Anthropic Engineering, “Code Execution with MCP” — 10,000행 스프레드시트 150,000 → 2,000 토큰(98.7% 절감), 샌드박스 아키텍처. https://www.anthropic.com/engineering/code-execution-with-mcp ↩ ↩2 ↩3 ↩4
-
Model Context Protocol, “Client Best Practices” — Progressive Discovery, Catalog→Inspect→Execute 플로우, 컨텍스트 윈도우 1~5% 임계값. https://modelcontextprotocol.io/docs/develop/clients/client-best-practices ↩ ↩2 ↩3
-
Cloudflare Blog, “Code Mode: MCP in Workers Sandbox” — Workers 샌드박스·V8 런타임 기반 Code Execution. https://blog.cloudflare.com/code-mode-mcp/ ↩
댓글남기기