
추론 라우팅과 요청 캐스케이딩: 2-Tier 게이트웨이와 시맨틱 캐싱
사내 LLM 플랫폼을 처음 열면 요청은 거의 항상 하나의 엔드포인트로 들어온다. IDE 플러그인, 사내 챗봇, 배치 스크립트가 모두 같은 base_url을 바라본다. 그리고 그 뒤에는 가장 비싼 모델 하나가 서 있다. “일단 제일 좋은 모델로 붙여 두자”는 결정은 첫 달에는 합리적으로 보이지만, 트래픽이 늘면 두 가지가 동시에 무너진다. 비용 그래프가 요청 수에 정비례해 올라가고, 아주 단순한 질문 하나의 응답 시간이 가장 무거운 요청에 맞춰 결정된다.
여기서 필요한 것이 추론 라우팅(inference routing) 이다. 요청을 어디로 보낼지 결정하는 계층을 따로 두고, 그 계층이 비용·지연·품질을 동시에 다루게 만드는 것이다. 사내 AI 플랫폼(Azure/Kubernetes 기반 서빙, 자체 vLLM과 외부 프로바이더를 함께 쓰는 구성)을 운영하면서 “게이트웨이를 한 겹 더 두는 게 정말 값어치가 있나”를 여러 번 따져 봤고, 결론은 조건부 찬성이었다. 조건은 게이트웨이를 역할이 다른 두 계층으로 쪼개는 것이다. 이 글은 그 구조와, 그 위에서 돌아가는 캐스케이딩·캐싱·관측성을 정리한다. 전제와 수치는 1, 2 문서를 기준으로 삼았고, 연구 인용은 원 논문을 확인해 표시했다.
1. 라우팅이 비용을 바꾸는 지점
1.1 모든 요청을 최상위 모델로 보내는 습관
LLM 요청의 실제 분포는 놀랄 만큼 편향되어 있다. 자동완성 수준의 짧은 질문, 포맷 변환, 이름 추출 같은 작업이 전체의 절반 이상을 차지하고, 코드 리팩터링·아키텍처 검토처럼 긴 추론이 필요한 요청은 소수다. 그런데 엔드포인트가 하나면 이 분포가 사라진다. 모든 요청이 최상위 모델의 단가와 최상위 모델의 지연을 지불한다.
라우팅이 건드리는 변수는 세 개다.
- 비용: 요청 단가가 “모델 단가 × 토큰 수”로 결정된다면, 토큰 수가 아니라 모델을 먼저 줄이는 편이 훨씬 큰 폭으로 움직인다.
- 지연: 작은 모델은 같은 프롬프트에서도 첫 토큰까지의 시간(TTFT, Time to First Token)이 짧다. 단순 요청을 무거운 모델에 보내는 것은 지연을 스스로 만드는 일이다.
- 품질: 반대로 어려운 요청을 작은 모델에 보내면 재시도가 늘고, 재시도가 늘면 절감분이 그대로 사라진다. 그래서 라우팅은 “싸게 보내기”가 아니라 품질 하한선을 지키면서 싸게 보내기로 정의해야 한다.
1.2 라우팅 결정이 일어나는 두 개의 레이어
이 글에서 계속 구분해서 쓸 개념이 있다. 라우팅 결정은 서로 다른 두 질문에 답하며, 이 둘은 물리적으로 같은 게이트웨이에 있어도 논리적으로는 다른 레이어다1.
| 레이어 | 결정하는 질문 | 사용하는 신호 | 선택 단위 |
|---|---|---|---|
| L1 — LLM 프록시 / 엣지 | 어느 프로바이더·모델·리전으로 보낼까 | 비용, 예산, 프로바이더 상태, 인증, PII, 시맨틱 유사도 | 모델/프로바이더 |
| L2 — 추론 라우팅 (KV-aware) | 같은 모델 안에서 어느 GPU Pod로 보낼까 | vLLM 내부 메트릭(KV 캐시 사용률, prefix 위치, 큐 깊이) | 개별 Pod |
L1은 “이 요청은 값싼 모델로 충분하다”를 판단하고, L2는 “같은 접두사를 이미 들고 있는 Pod가 어디인가”를 판단한다. 둘은 경쟁 관계가 아니라 보완 관계다. 그리고 중요한 제약이 하나 붙는다. L2는 반드시 vLLM과 같은 리전·같은 클러스터에 있어야 한다. KV 캐시 메트릭은 신선도가 수백 밀리초~수 초 단위라 크로스 리전 왕복(RTT 약 130~150ms)만으로도 판단 근거가 썩는다.
2. 2-Tier 게이트웨이 아키텍처
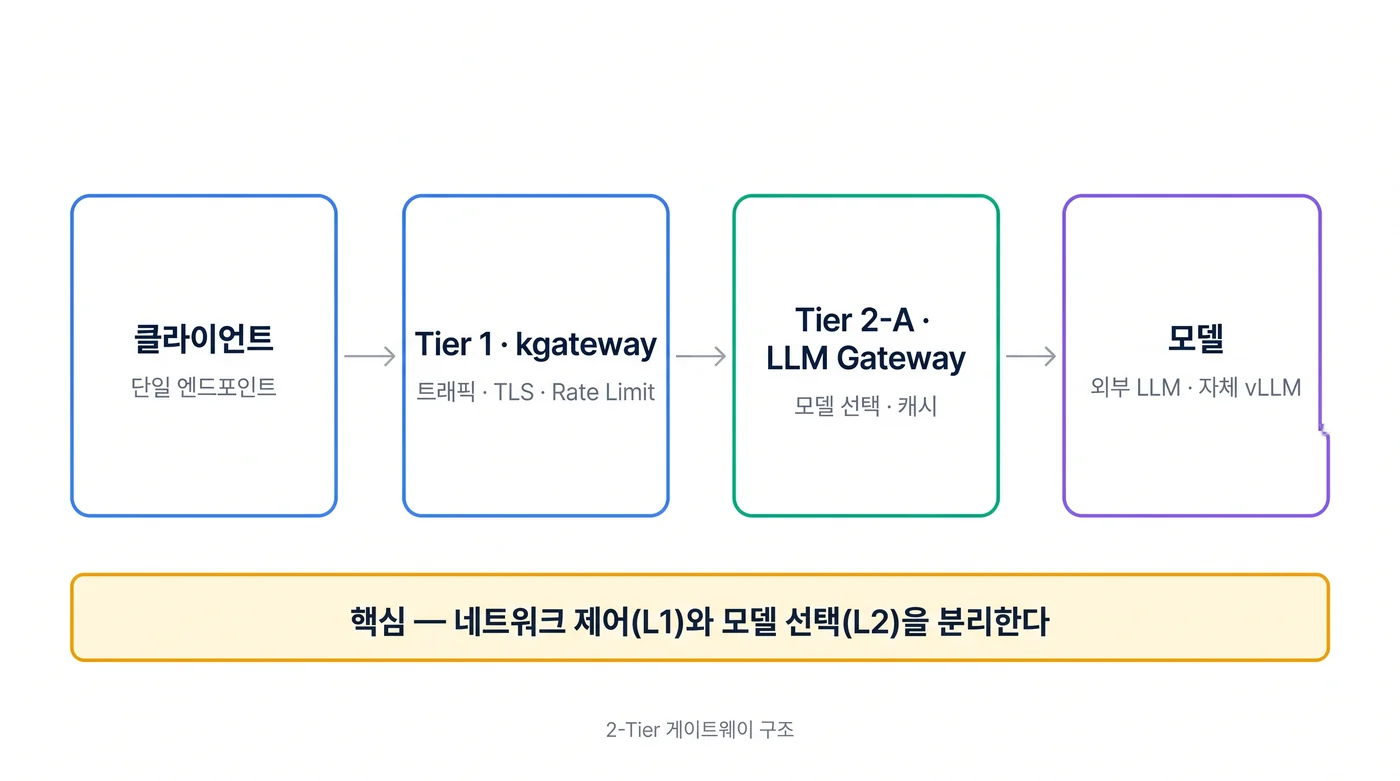
인프라 트래픽 관리와 LLM 프로바이더 추상화를 같은 컴포넌트에 밀어 넣으면, 네트워크 정책을 바꾸려는 팀과 모델 정책을 바꾸려는 팀이 같은 설정 파일을 잡고 싸운다. 2-Tier 구성은 이 소유권을 분리하기 위한 설계 선택이다. 모든 배포가 게이트웨이 두 개를 요구하는 것은 아니라는 점도 함께 기억해 둔다1.
2.1 Tier 1: Ingress Gateway (kgateway)
Tier 1은 네트워크 계층의 일만 한다. 외부 트래픽을 받아 TLS를 종료하고, 경로·헤더·가중치를 보고 뒤쪽으로 넘긴다. kgateway가 이 자리에 오는 이유는 쿠버네티스 Gateway API 표준을 구현하기 때문이다3. 벤더 중립적인 리소스로 설정하므로, 나중에 구현체를 바꿔도 애플리케이션 매니페스트는 그대로 남는다.
- 헤더 기반:
x-model-id,x-provider로 백엔드를 고른다. - 경로 기반:
/v1/chat/completions와/v1/embeddings를 다른 서비스로 보낸다. - 가중치 기반:
backendRef의 weight로 카나리·A/B를 만든다. - 복합 조건: 헤더 + 경로 + 고객 티어를 조합한다.
카나리 배포는 5~10% 트래픽으로 시작해서 올리고, 문제가 보이면 weight를 0으로 되돌려 즉시 롤백한다1. 버전 감각을 하나만 남기면, 문서 기준 Gateway API v1.6.0이 2026-06에 stable(UDPRoute/TCPRoute GA)이 되었고 kgateway 2.3.x는 1.3~1.5(v1.5.1 포함)를 공식 지원한다. 도입 시점에 지원 매트릭스를 다시 확인해야 하는 종류의 항목이다.
로드 밸런싱은 세 가지를 기억하면 된다.
| 전략 | 동작 | 어울리는 상황 |
|---|---|---|
| Round Robin | 순차 분배 | 인스턴스 성능이 균일할 때 |
| Random | 무작위 분배 | 백엔드 풀이 클 때 |
| Consistent Hash | 같은 키 → 같은 백엔드 | prefix 캐시 재사용, 세션 유지 |
세 번째가 LLM에서 유난히 중요하다. 같은 사용자의 요청을 같은 vLLM 인스턴스로 계속 보내면 prefix 캐시 적중률이 올라가고, 그게 곧 TTFT 개선으로 이어진다1. Kubernetes 1.33+의 topology-aware routing을 켜면 같은 가용 영역(AZ) 안의 Pod끼리 우선 연결해 크로스 AZ 전송 비용도 줄일 수 있다.
장애 대응 파라미터는 LLM 특성에 맞춰 늘려야 한다.
| 메커니즘 | 일반 설정 | LLM에서의 주의점 |
|---|---|---|
| 타임아웃 | 요청별 상한 | 긴 생성은 수십 초가 걸린다. 120초 이상을 잡는다 |
| 재시도 | 5xx·타임아웃·연결 실패 시 | 최대 3회. 무한 재시도는 과부하를 만든다 |
| 서킷 브레이커 | 연속 실패 시 백엔드 차단 | maxEjectionPercent 를 50% 이하로 두어 절반은 남긴다 |
스트리밍 응답에서는 타임아웃의 의미가 갈린다. backendRequest 는 첫 바이트까지의 시간이고, request 는 요청 전체 시간이다. 그리고 POST 재시도는 멱등성 보장이 필요하므로 도구 호출(tool call)이 섞인 요청에서는 재시도를 신중하게 다뤄야 한다.
2.2 Tier 2-A: LLM API Gateway
Tier 2-A는 모델 API를 추상화하는 프로바이더 프록시다. Bifrost나 LiteLLM이 이 자리에 온다. 하는 일은 네 가지다.
- 클라이언트가 던진 단일 모델명을 실제 프로바이더·모델로 해석한다.
- 요청 복잡도를 보고 모델을 고른다(캐스케이딩).
- 의미가 같은 이전 요청의 응답을 재사용한다(시맨틱 캐싱).
- 프로바이더가 죽으면 다른 프로바이더로 넘긴다(failover).
여기서 헷갈리기 쉬운 구분이 있다. Tier 2-A는 모델 간(across-model) 선택을 하고, 뒤에서 다룰 Gateway API Inference Extension은 모델 내(within-model) Pod 선택을 한다. 용도가 다르다.
2.3 Tier 2-B: Agent Data Plane (agentgateway)
기존 Envoy 데이터 플레인은 무상태(stateless) HTTP/gRPC에 최적화되어 있다. AI 에이전트는 그렇지 않다. 세션을 들고 있어야 하고, MCP·A2A 같은 프로토콜을 이해해야 하며, 도구 호출을 검증해야 한다. agentgateway가 이 자리를 맡는다1.
| 항목 | Envoy 데이터 플레인 | agentgateway |
|---|---|---|
| 세션 | 무상태, HTTP 쿠키 기반 | 상태 기반 JSON-RPC 세션, 인메모리 스토어 |
| 프로토콜 | HTTP/1.1, HTTP/2, gRPC | MCP, A2A |
| 보안 | mTLS, RBAC | 도구 포이즈닝 방지, 세션 단위 인가 |
| 라우팅 | 경로·헤더 기반 | 세션 ID 기반, 도구 호출 검증 |
| 관측성 | HTTP 메트릭, 액세스 로그 | 토큰 추적, 도구 호출 체인, 비용 |
세부 동작 몇 가지가 실무에서 바로 쓰인다. X-MCP-Session-ID 헤더로 세션을 추적하고 sticky 라우팅을 하며, 비활성 세션은 기본 30분 뒤 정리한다. /mcp/v1·/a2a/v1 경로를 네이티브로 처리한다. 도구 호출은 허용 목록으로 제한하고 exec_shell·read_credentials 같은 위험 도구를 막으며, 응답 크기 제한과 SHA-256 무결성 검증을 건다. 세션 단위 인가는 JWT 검증 위에서 동작한다.
계보를 하나만 짚으면, agentgateway는 kgateway v2.2 계보에서 분리된 AI 전용 데이터 플레인이고4, 2026년 2~3월경 v1.0부터 에이전트 제어 평면 컨트롤러가 이 저장소로 옮겨가 독립 릴리스 체계를 갖췄다1. MCP·A2A 프로토콜 자체가 빠르게 변하는 만큼 버전별 동작 차이를 전제로 봐야 한다.
2.4 트래픽 플로우와 L1/L2의 구분
두 갈래만 기억하면 된다.
[외부 LLM 경로]
Client → kgateway(L1) → Bifrost/LiteLLM(Tier 2-A: 캐스케이딩+캐시) → OpenAI/Anthropic/Bedrock → 응답 + 비용 기록

[자체 vLLM 경로]
Client → kgateway(L1) → agentgateway(Tier 2-B) → vLLM Pod → 응답
Tier 1은 네트워크 제어만 하고 모델 선택 로직은 넣지 않는다. 모델 선택은 Tier 2-A의 일이다. 이 분리가 무너지면 네트워크 정책 변경이 모델 정책을 건드리기 시작한다.
2.5 Gateway API Inference Extension과 EPP
쿠버네티스 쪽에는 L2를 표준 리소스로 다루는 길이 있다. Gateway API Inference Extension(GIE) 이 그것이다. 문서 기준 검토 시점은 llm-d v0.8.1, router v0.9.0, GIE v1.5.0, Gateway API v1.5.1이다1.
핵심 리소스는 네 개다.
| 리소스 | API 그룹 | 책임 |
|---|---|---|
| Deployment / LeaderWorkerSet | Kubernetes | 모델 이미지, GPU 요청, replica 수 |
| InferencePool | inference.networking.k8s.io/v1 |
같은 네임스페이스의 Pod 선택, 포트·EPP 참조 |
| InferenceObjective | llm-d.ai/v1alpha2 (alpha) |
pool 내 요청 우선순위 |
| HTTPRoute | gateway.networking.k8s.io/v1 |
경로·헤더·가중치로 pool 선택 |
여기서 자주 오해되는 이름이 있다. InferenceModel 은 예전 정책 API의 역사적 이름이고, LLMRoute 라는 kind는 GIE·llm-d Router CRD에 없다. router 저장소의 llmroute.yaml 테스트 파일도 실제로는 kind: HTTPRoute 다1. 파일 이름을 API kind로 읽으면 안 된다.
그리고 priority: 10 같은 값은 전용 GPU 예약도, Pod PriorityClass도 아니다. 같은 pool 안에서 우선순위 0인 요청보다 먼저 처리하겠다는 정책 표현일 뿐이다. Flow control을 쓰려면 EPP에서 feature gate를 켜고, 신뢰할 수 있는 인증 계층이 x-llm-d-inference-objective 헤더를 설정해야 한다. Objective를 만드는 것만으로 모든 요청에 자동 적용되지 않으며, 외부 사용자가 우선순위를 임의로 올리지 못하도록 헤더를 검증·재설정해야 한다.
EPP(Endpoint Picker) 는 GIE가 정의한 추론 스케줄러 서비스다. Envoy의 ext-proc(External Processing) gRPC 프로토콜을 구현하고, 게이트웨이가 매 요청마다 “InferencePool 안 어느 Pod로 보낼지”를 위임한다. 세 가지 사양이 EPP를 EPP이게 만든다.
- ext-proc gRPC 구현: Istio, kgateway, Envoy Gateway, GKE Gateway, agentgateway, NGINX Gateway Fabric 등이 호스트할 수 있다.
- InferencePool selector로 개별 Pod 주소(
podIP:port)를 다룬다: Service가 아니라 Pod 단위다. - 모델 서버 메트릭으로 스케줄링한다: 단순 LB가 아니라 KV 캐시·부하 인지다.
EPP 내부는 단일 함수가 아니라 계층 파이프라인이다. 데이터 계층이 Pod 목록과 vLLM 메트릭을 모으고, 라우팅/정책 계층이 pool 선택과 우선순위를 처리하고, 흐름 제어 계층이 포화 감지기(saturation detector)로 과부하를 막고, 마지막 스케줄링 계층의 scorer + picker 가 실제 Pod를 고른다. scorer에는 prefix-cache-scorer(프롬프트 블록을 해싱해 prefix를 들고 있는 Pod를 추정) 외에 부하·큐 깊이 인지 scorer, LoRA affinity 등이 있다. picker는 점수를 종합해 최종 Pod를 정하고, 미지정이면 기본 max-score-picker 가 쓴다. 결정은 x-gateway-destination-endpoint 헤더와 dynamic_metadata 로 함께 전달되며 둘이 일치해야 한다.
여기서 정확히 해 둘 것이 하나 있다. KV-cache-aware 라우팅에서 라우팅 결정 자체는 추론이 아니다. prefix 블록 해시와 인덱스 조회라는 기계적 연산이고 모델 forward pass가 없다. 반면 컨텍스트 인지(시맨틱) 라우팅은 인코더·분류 모델을 돌리므로 라우팅 경로에 경량 추론이 생긴다. 어느 쪽이든 선택된 Pod가 수행하는 최종 워크로드는 LLM 추론이다.
L2 구현은 세 갈래로 비교된다.
| 항목 | EPP(GIE) + Envoy | HyperPod Inference Operator | NVIDIA Dynamo |
|---|---|---|---|
| KV-aware 방식 | prefix-cache·kv-util scorer | kvaware/prefixaware | KV router(Radix tree) |
| 관리 | self-managed | AWS 관리형(EKS add-on) | self-managed |
| 노드 자동복구 | 별도(NMA+Auto Repair) | 딥헬스체크+스페어풀 통합 | 별도 |
| 분산 추론 | llm-d 연계 | DPD 관리형(EFA/GPUDirect RDMA) | prefill/decode + 3-tier KV offload |
| 백엔드 엔진 | vLLM/TGI 등 | vLLM 전용 | vLLM/SGLang/TRT-LLM |
| 비용 | EC2 단가 | EC2 대비 15~20% 프리미엄 | EC2 단가 |
| 락인 | 없음(표준) | 중간 | 없음 |
HyperPod의 관리형 KV-aware는 vLLM에 고정된다는 제약이 있고, TensorRT-LLM의 성능 천장이 필요하면 EKS 위에 Dynamo를 직접 올리고 HyperPod는 노드 복구 계층으로만 쓰는 하이브리드가 가능하다1.
멀티리전 구성은 L2의 물리적 제약을 그대로 드러낸다. 서울에서 인입해 시드니에서 추론하는 구성이라면, 서울은 L1(프로바이더·리전 라우팅, 인증, 예산, PII, failover, 세션 어피니티)을 맡고 시드니는 L2(EPP/HyperPod router/Dynamo) + vLLM을 맡는다. KV 캐시 이득은 시드니 클러스터 내부에서만 발생하고, 크로스 리전 홉은 캐시로 단축되지 않는다. 멀티턴 prefix 재사용을 살리려면 L1이 같은 세션을 같은 엔드포인트로 일관되게 보내는 세션 어피니티가 핵심이다.
3. 게이트웨이 솔루션 비교표
3.1 솔루션 비교
L1/Tier 2-A 자리에 올릴 수 있는 것들을 한 표에 모으면 이렇다1.
| 솔루션 | 언어 | 라이선스 | 캐스케이딩 | 특징 | 어울리는 환경 |
|---|---|---|---|---|---|
| Bifrost | Go | Apache 2.0 | 룰(complexity_tier) + 외부 classifier |
조건부 라우팅 룰, failover, 저오버헤드 | 고성능·저비용 셀프호스트 |
| LiteLLM | Python | MIT | 커스텀 전략 / 앞단 classifier | 프로바이더 100개 이상, 다전략 라우팅 | Python 생태계, 빠른 프로토타이핑 |
| vLLM Semantic Router | Python | Apache 2.0 | 임베딩 유사도 | vLLM 전용 경량 분류 라우터 | vLLM 단독 환경 |
| Portkey | TypeScript | Proprietary + OSS | 지원 | SOC2 인증, 시맨틱 캐시, Virtual Keys | 엔터프라이즈·규정 준수 |
| Kong AI Gateway | Lua/C | Apache 2.0 / Enterprise | 플러그인 | MCP 지원, 기존 Kong 자산 재사용 | 이미 Kong을 쓰는 조직 |
| Helicone | Rust | Apache 2.0 | 지원 | 게이트웨이와 관측성을 한 몸에 | 성능·관측성을 동시에 |
| OpenRouter | SaaS | 상용 | 프로바이더 라우팅 | 호스티드 통합 API, 프로바이더 폴백 | 멀티 프로바이더 빠른 통합 |
두 가지 주의가 붙는다. 첫째, LiteLLM과 Kong AI Gateway는 택일이다. 둘 다 L1 게이트웨이이고, 둘을 조합하는 아키텍처(예: Kong 앞단 + LiteLLM 후단)는 검증된 레퍼런스가 없다. 둘째, Bifrost·LiteLLM·Helicone·vLLM Semantic Router는 셀프호스트이고 OpenRouter는 호스티드 SaaS다. SaaS는 모델 접근과 폴백·빌링을 위임할 수 있지만 프롬프트가 외부로 나가므로 데이터 주권·규제 요건이 있는 환경에서는 거버넌스 검토가 먼저다.
3.2 Bifrost vs LiteLLM
둘의 차이는 성능과 생태계, 그리고 공급망 관점으로 갈린다.
- Bifrost: Go 기반이라 Python 대비 메모리 사용이 낮고 처리량이 높다. 공개 벤치 기준 5k RPS에서 오버헤드가 ~11µs(100µs 미만) 수준으로 보고된다. “LiteLLM보다 50배 빠르다”는 태그라인은 벤더 자체 head-to-head 벤치(54x P99, 40x 오버헤드, 9.5x 처리량)를 요약한 것이며 제3자 검증은 없다1. 성능 외에 공급망 관점도 선택 요인이 된다. Python 기반 LLM 라우터는 의존성 트리가 넓어 보안 패치 부담이 상대적으로 크고, 단일 정적 바이너리로 배포되는 Go 기반은 런타임 의존성과 공격 표면이 작다. 단 이런 경향은 어디까지나 일반론이고, 실제 노출 위험은 버전과 설정에 따라 달라진다. 도입할 때 각 프로젝트가 공지한 보안 권고를 직접 확인하는 절차를 남겨 둬야 한다1. 조건부 라우팅 룰은 헤더뿐 아니라 프롬프트에서 파생된
complexity_tier(SIMPLE/MEDIUM/COMPLEX/REASONING),model·params·budget 신호에 접근할 수 있다5. - LiteLLM: 100+ 프로바이더를 지원하고
simple-shuffle·latency-based-routing·usage-based-routing-v2·least-busy·cost-based-routing같은 내장 전략과CustomRoutingStrategyBase기반 커스텀 전략을 제공한다. Langfuse 연동은success_callback: ["langfuse"]한 줄이고 LangChain/LlamaIndex 통합이 네이티브다. 다만 복잡도 기반 라우팅은 내장 전략이 아니다. 앞단 classifier나 커스텀 전략으로 직접 구현해야 한다6.
3.3 시나리오별 추천 조합
| 쓰는 상황 | 추천 조합 | 그 이유 |
|---|---|---|
| 스타트업·PoC 단계 | kgateway + LiteLLM | 시작 비용이 낮고 프로바이더 붙이기가 빠르다 |
| 고성능 셀프호스트 | kgateway + Bifrost + agentgateway | 오버헤드가 낮고 외부·자체 풀을 모두 덮는다 |
| 엔터프라이즈 규정 준수 | kgateway + Portkey + Langfuse | 컴플라이언스 인증과 관측성을 함께 확보 |
| 외부+자체 하이브리드 | kgateway + Bifrost/LiteLLM + agentgateway | 외부는 L1, 자체 추론은 agentgateway |
| 글로벌 엣지 배포 | Cloudflare AI Gateway + kgateway | 엣지 캐시와 DDoS 방어를 앞단에 둔다 |
4. 요청 캐스케이딩(난이도 기반 모델 선택)
4.1 세 가지 캐스케이딩 패턴
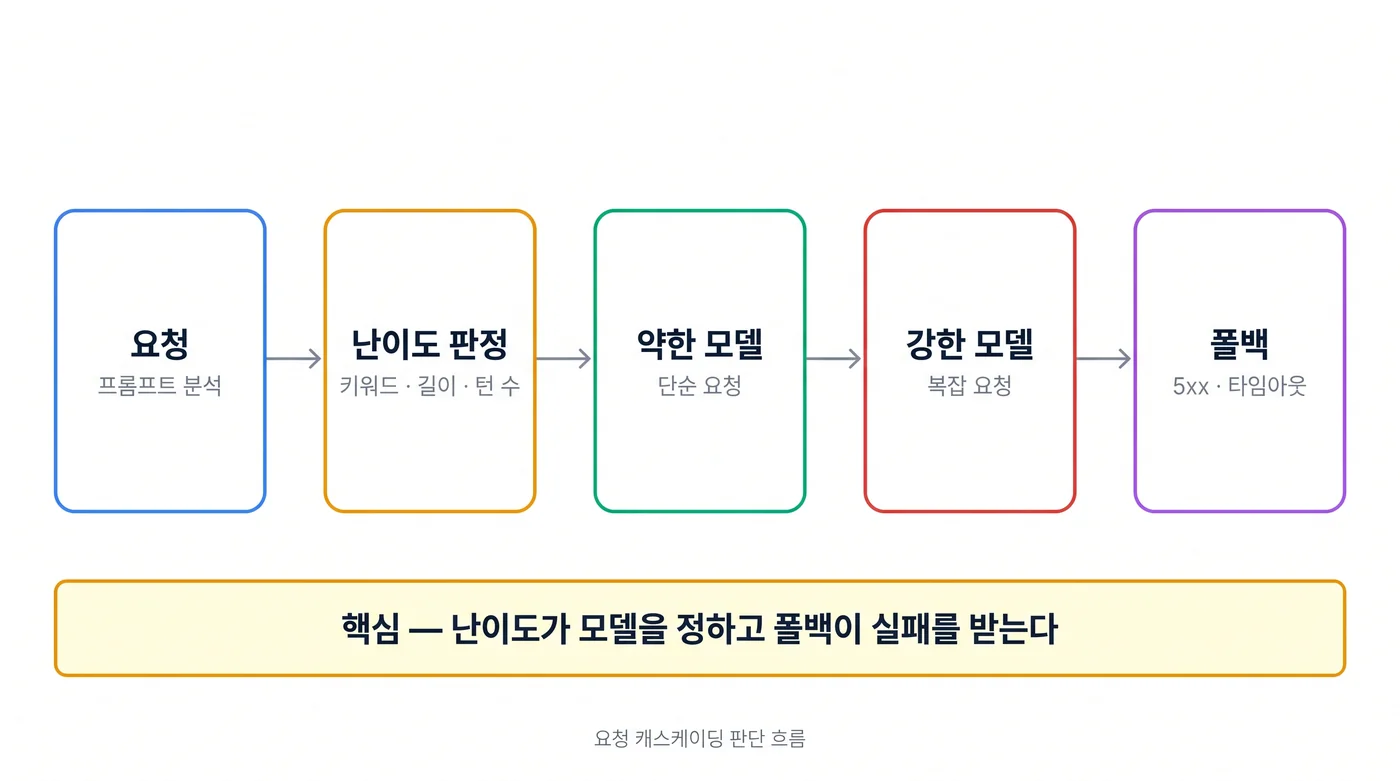
요청 캐스케이딩(request cascading) 은 요청의 복잡도와 정해 둔 품질 기준에 따라 처리할 모델을 고르는 방식이다2. 구현 난이도 순으로 세 패턴이 있다.
| 패턴 | 동작 | 구현 | 쓰이는 곳 |
|---|---|---|---|
| 가중치 기반 | 고정 비율로 트래픽 분배 | kgateway backendRef weight |
A/B 테스트, 점진적 모델 이전 |
| 폴백 기반 | 오류 시 다른 모델로 전환 | kgateway retry + 다중 backendRef |
가용성, rate limit 회피 |
| 지능형 라우팅 | 요청을 분석해 모델 선택 | LLM Classifier / LiteLLM 커스텀 전략 / vLLM Semantic Router | 비용 최적화 + 품질 유지 |
앞의 둘은 “누가 어디로 가는지”가 정해져 있고, 세 번째만 요청마다 결정이 달라진다. 실무에서는 셋을 조합한다. 기본은 지능형 라우팅으로 보내되, 지능형 라우터가 고른 백엔드가 죽으면 폴백이 받아내는 식이다.
4.2 난이도 분류와 모델 매핑
난이도를 나누는 축은 비슷하다. 입력 토큰 수, 코드 포함 여부, 추론 키워드의 존재다. 문서의 기준(2026-04)을 그대로 옮기면 이렇다2.
| 복잡도 | 조건 | 권장 모델 계열 |
|---|---|---|
| Simple | 토큰 < 200, 키워드 없음 | Haiku 4.5 / GPT-4.1 nano |
| Medium | 토큰 200~1,000, 코드 포함 | Sonnet 4.6 / Gemini 2.5 Flash |
| Complex | 토큰 1,000+, reasoning 키워드 | Opus 4.7 / GPT-4.1 |
폴백 조건은 네 가지로 정리된다. HTTP 5xx, rate limit 초과, 타임아웃, 그리고 (옵션으로) 품질 점수 0.7 미만이다.
4.3 구현 접근 A: LLM Classifier
자체 호스팅 vLLM 환경에서 실전 검증된 접근은 경량 분류기다2. Python FastAPI 기반의 작은 라우터가 프롬프트 내용을 직접 보고 SLM과 LLM을 고른다. kgateway 뒤에서 ext-proc 또는 독립 서비스로 동작하고, 클라이언트는 단일 엔드포인트(/v1)만 쓴다.
분류 규칙은 의외로 단순하다. 강한 모델로 보내는 신호는 세 개다.
- 키워드: 리팩터, 아키텍처, 설계, 분석, 디버그, 최적화, 마이그레이션 등(영문 포함)
- 입력 길이: 500자 이상
- 대화 턴 수: 5턴 초과
STRONG = ("리팩터", "아키텍처", "설계", "분석", "최적화", "디버그", "마이그레이션",
          "refactor", "architect", "design", "analyze", "optimize", "debug", "migration")
MIN_CHARS, MAX_TURNS = 500, 5

def classify(messages):
    text = " ".join(m.get("content") or "" for m in messages).lower()
    if any(keyword in text for keyword in STRONG):
        return "strong"
    if len(text) > MIN_CHARS or len(messages) > MAX_TURNS:
        return "strong"
    return "weak"
이 접근이 자체 호스팅에서 채택되는 이유는 명확하다. 표준 OpenAI 호환 클라이언트(Aider, Cline 등)는 base_url 하나만 설정한다. 분류기가 단일 엔드포인트 뒤에서 프롬프트를 분석해 백엔드 vLLM으로 직접 프록시하면, 클라이언트는 모델 선택이 일어나는지조차 모른다. 클라이언트 수정이 0이고 배포는 Pod 하나다. 약점은 분류 정확도가 휴리스틱에 걸려 있다는 것이고, 이건 ML 분류기로 점진적으로 개선하는 경로를 남겨 둔다.
4.4 구현 접근 B/C: LiteLLM과 vLLM Semantic Router
외부 프로바이더가 섞이면 LiteLLM 쪽이 자연스럽다. 다만 복잡도 기반 분기는 내장이 아니므로 앞단 classifier가 model_name 을 골라 주거나 커스텀 전략을 붙인다.
model_list:
  - model_name: premium
    litellm_params:
      model: <provider>/<large-model>
      api_key: os.environ/PROVIDER_API_KEY
  - model_name: economy
    litellm_params:
      model: <provider>/<small-model>
      api_key: os.environ/PROVIDER_API_KEY

router_settings:
  routing_strategy: cost-based-routing   # 가장 저렴한 가용 모델을 고른다
여기서 routing_strategy 를 무엇으로 두느냐가 곧 정책이다. cost-based-routing 은 비용 최소화를, latency-based-routing 은 응답 속도를, least-busy 는 부하 분산을 우선한다. 복잡도 기반 분기는 이 목록에 없으므로 앞단에서 처리한다.
vLLM Semantic Router 는 성격이 다르다. vllm 에서 import 하는 클래스가 아니라 게이트웨이 앞단(Envoy ext-proc)에 배치하는 독립 라우팅 서비스다7. Rust/Candle 기반 경량 BERT 분류기가 프롬프트를 카테고리로 나누고, 매핑은 코드가 아니라 설정 파일로 관리한다. 서비스는 OpenAI 호환 요청을 받아 분류 결과에 따라 백엔드로 프록시한다.
어느 것을 고를지는 환경이 정한다.
| 환경 | 권장 접근 | 이유 |
|---|---|---|
| 자체 호스팅 vLLM(Aider/Cline) | LLM Classifier | 프롬프트 직접 분석, 단일 엔드포인트, 클라이언트 무수정 |
| 외부 프로바이더(OpenAI/Anthropic) | LiteLLM | 100+ 프로바이더, 내장 전략 + 커스텀 전략 |
| vLLM 단독 + 분류 서비스 가용 | vLLM Semantic Router | vLLM 프로젝트 라우터, 경량 |
| 하이브리드(외부+자체) | LLM Classifier + LiteLLM | 자체는 Classifier, 외부는 LiteLLM |
한 가지 반례도 기록해 둔다. Bifrost를 자체 호스팅 vLLM 캐스케이딩에 쓰려던 시도는 네 가지 한계로 접혔다2. 요청 시 openai/glm-5 같은 provider/model 포맷을 강제하는 점, provider당 base_url 이 하나뿐이라 SLM과 LLM이 다른 Service에 있으면 같은 provider로 라우팅할 수 없는 점, 라우팅 룰이 complexity_tier 에는 접근하지만 원시 프롬프트 텍스트를 키워드·정규식으로 직접 매칭하기는 어려운 점, 모델명 정규화(하이픈 제거 등)로 vLLM served-model-name 과 어긋나는 점이다. 결론은 명확하다. Bifrost는 외부 프로바이더 통합과 failover에 강하고, 자체 vLLM 사이의 지능형 캐스케이딩에는 별도 classifier가 더 유연하다.
4.5 RouteLLM이 가르쳐 준 것
RouteLLM 은 LMSYS가 만든 오픈소스 라우팅 프레임워크다. 행렬 분해(Matrix Factorization) 라우터를 Chatbot Arena 선호 데이터로 학습시켰고, MT Bench에서 GPT-4 호출을 26%만 쓰고도 GPT-4 성능의 95%를 유지했다는 결과가 논문(arXiv:2406.18665)으로 검증되었다8.
그런데 쿠버네티스에 그대로 올리는 길은 막혀 있다. torch·transformers·sentence-transformers 의존성 트리가 vLLM 환경과 충돌하고, 분류 모델을 포함하면 이미지가 10GB를 넘고, pip 의존성 해석 실패가 잦고, 연구 프로젝트 성격이라 프로덕션 지원이 없다2. 그래서 가져올 것은 코드가 아니라 개념이다. “선호 데이터로 학습한 분류기가 strong/weak를 가른다”는 아이디어는 유효하고, 실전에서는 규칙 기반 경량 classifier로 근사한다.
| 항목 | RouteLLM(연구) | LLM Classifier(실전) |
|---|---|---|
| 분류 방식 | 행렬 분해 임베딩 | 키워드 + 길이 + 턴 수 |
| 추가 지연 | 10ms 미만 | 1ms 미만(규칙 기반) |
| 의존성 | torch, transformers 등 | FastAPI, httpx |
| K8s 배포 | 불안정(의존성 충돌) | 안정(50MB 이미지) |
4.6 절감 효과
숫자는 시나리오가 붙어야 의미가 있다. 문서 기준(2026-07) 일 10,000 요청 시나리오를 보자2. 단가는 Haiku 4.5 $1.00/$5.00, Sonnet 4.6 $3.00/$15.00, Opus 4.7 $5.00/$25.00 (per 1M 토큰, 입력/출력)이다.
| 구간 | 비중 | 모델 | 입·출력 토큰 | 일 비용 |
|---|---|---|---|---|
| Simple | 50% | Haiku 4.5 | 50 / 100 | $2.75 |
| Medium | 30% | Sonnet 4.6 | 500 / 500 | $27.00 |
| Complex | 15% | Opus 4.7 | 1,500 / 1,000 | $48.75 |
| Very Complex | 5% | Opus 4.7 | 3,000 / 2,000 | $32.50 |
| 합계 | $111.00/일 (월 $3,330) |
같은 요청을 전부 Opus 4.7로 처리하면(평균 1K 토큰 입/출력) 하루 $300, 월 $9,000이다. 즉 약 63% 절감이다. 자체 호스팅 시나리오도 방향은 같다. Qwen3-4B(weak 70%, g6.xlarge L4 Spot ~$0.31/hr) 약 $223/월, GLM-5 744B(strong 30%, p5en.48xlarge 8xH200 Spot ~$16/hr) 약 $3,456/월, Langfuse + AMP/AMG 약 $200/월을 더하면 약 $3,879/월이다. GLM-5를 상시 운영하는 약 $11,520/월과 비교하면 약 66% 절감이다2.
이 표를 그대로 예산 계획으로 옮기면 안 된다. 비중(50/30/15/5)이 곧 라우팅 정확도이고, 분류가 틀리면 절감분이 재시도로 새어 나간다. 그래서 다음 두 절이 필요하다.
5. 시맨틱 캐싱
5.1 캐시 계층 구분
시맨틱 캐싱(semantic caching) 은 의미가 유사한 프롬프트를 감지해 이전 응답을 재사용한다. 비용과 지연을 동시에 줄이는 가장 값싼 수단이고, 라우팅보다 먼저 도입할 만하다. 다만 캐시가 여러 계층에 존재한다는 사실을 구분해야 한다.
| 계층 | 무엇을 재사용하나 | 누가 관리하나 |
|---|---|---|
| 시맨틱 캐시 | 의미가 같은 요청의 전체 응답 | L1 게이트웨이(Bifrost/LiteLLM/Portkey/Kong) |
| KV 캐시(prefix) | 프롬프트 접두사의 중간 계산 | vLLM Pod |
| 프롬프트 캐시 | 프로바이더가 관리하는 접두사 캐시 | 모델 프로바이더 |
시맨틱 캐시는 “중복 LLM 호출 자체를 제거”하고, KV 캐시는 “호출은 하되 연산을 줄인다”는 점이 다르다. 그래서 시맨틱 캐시는 그 아래 계층과 독립적으로 조합된다.
여기서 자주 오해되는 제품이 Kong이다. Kong AI Gateway의 ai-semantic-cache 플러그인이 하는 일은 “의미가 비슷한 요청이면 앞선 응답을 그대로 돌려준다”이고, 이는 호출 자체를 줄이는 응답 캐시 계층에 속한다1. 반면 “어느 Pod에 prefix KV 캐시가 살아 있는지”를 보고 스케줄하는 일은 별개 계층이다. Kong의 부하 분산(consistent-hash, lowest-latency 등)은 프로바이더·모델 단위에서 동작하며, Envoy 기반이 아니라 GIE/ext-proc/InferencePool 계열 구현을 갖지 않는다. 그래서 KV-aware 스케줄링이 필요하면 Kong은 엣지(L1)에 남기고 L2는 EPP·HyperPod·Dynamo 쪽에 맡기는 구성이 자연스럽다. 저장소 위치도 짚어 둘 만하다. Kong은 자체 임베딩을 내장하지 않고 Redis·Valkey·PGVector 같은 외부 저장소에 연결하며, 임베딩 생성도 OpenAI·Bedrock 같은 외부 API 호출로 처리한다1.
5.2 임계값과 캐시 키
유사도 임계값이 캐시의 성격을 결정한다. 문서가 권장하는 기본값은 0.85 다. 의미는 같고 표현만 다른 요청(“이 코드 리팩터링해줘” / “이 코드 좀 정리해줘”)을 같은 것으로 보되, 주제가 다른 요청은 걸러 내는 지점이다1.
임계값을 낮추면 적중률은 오르고 오답 위험도 오른다. 캐시 키 설계에서 실무적으로 중요한 항목은 다음과 같다.
- 모델 식별자를 키에 포함한다. 같은 프롬프트라도 모델이 다르면 응답이 다르다.
- 시스템 프롬프트와 파라미터를 키에 넣는다. temperature·top_p를 바꾼 요청은 다른 요청이다.
- 테넌트 경계를 넘지 않는다. 고객 A의 응답이 고객 B에게 반환되는 순간 캐시는 사고가 된다.
- 권한·시점 의존 응답은 캐시 대상에서 뺀다. “내 잔액은?” 같은 요청은 시맨틱 캐시와 상극이다.
5.3 무효화와 정합성
캐시는 TTL과 무효화 규칙이 함께 있어야 자산이 된다. 프롬프트 템플릿이나 시스템 프롬프트를 바꿨다면 그 변경은 캐시 키에 반영되어야 한다. 그렇지 않으면 배포 직후 구버전 응답이 계속 나온다. 캐시 적중률도 관측 대상이다. 하한선 아래로 떨어지면 시맨틱 캐시가 사실상 꺼진 것이다.
6. 관측성과 품질 회귀 감지
6.1 핵심 메트릭
라우팅을 넣으면 “요청이 어디로 갔는가”가 로그에 남아야 한다. 게이트웨이에서 최소한으로 봐야 할 메트릭은 다섯 갈래다1.
| 카테고리 | 메트릭 | 의미 |
|---|---|---|
| 지연 | TTFT | 첫 토큰까지의 시간. 사용자가 체감하는 응답성 |
| 처리량 | TPS | 초당 토큰 생성 수. 서빙 효율 |
| 오류 | 5xx / 전체 요청 | 백엔드 장애 비율 |
| 캐시 | 캐시 적중 / 전체 요청 | 시맨틱 캐시 효율 |
| 비용 | 모델별 토큰 사용량 × 단가 | 실시간 비용 |
여기에 라우팅 고유의 메트릭을 얹는다. 라우팅 결정 분포(strong/weak 비율), 분류 지연, 라우팅별 품질 점수다. 강한 모델이 정말 강한 모델을 필요로 했는지, 약한 모델이 어려운 요청을 받지 않았는지는 이 세 개가 없으면 판단할 수 없다.
Langfuse OTel 연동 은 표준적인 관측 경로다. Bifrost는 otel 플러그인, LiteLLM은 success_callback: ["langfuse"] 설정으로 프롬프트·완료 내용, 토큰 사용량, 비용 분석, 도구 호출 체인을 추적한다1.
6.2 알림 규칙
문서가 제시하는 알림 규칙을 표로 옮기면 이렇다1.
| 알림 | 조건 | 심각도 |
|---|---|---|
| 높은 오류율 | 5xx > 5% (5분) | Critical |
| 높은 지연 | P99 > 30초 (5분) | Warning |
| 서킷 브레이커 활성화 | circuit_breaker_open == 1 |
Critical |
| 캐시 적중률 급락 | cache hit < 30% |
Warning |
| 예산 초과 임박 | 예산 > 80% | Warning |
6.3 misroute 탐지
라우팅을 넣고 나면 새로운 실패 모드가 생긴다. 작은 모델이 어려운 요청을 받아 엉뚱한 답을 내는 misroute 다. 이건 5xx로 잡히지 않는다. 응답은 정상 200으로 돌아오고 비용은 오히려 줄어든 것처럼 보인다.
탐지 신호를 미리 정해 둔다.
- 재질의율(refollow-up rate): 같은 세션에서 짧은 시간 안에 다시 질문하는 비율. 라우팅 이전보다 오르면 misroute를 의심한다.
- 약한 모델 응답의 재시도율: strong으로 승격되어 재실행된 비율.
- 모델별 품질 점수: 평가셋에 라우터를 통과시켜 모델별 점수를 주기적으로 측정한다.
- 결정 경계 샘플링: strong/weak 판정이 아슬아슬한 요청을 표본 추출해 사람이 검토한다.
임계값·키워드 튜닝과 misroute 탐지 운영은 라우터 설정을 코드로 두고 회귀 테스트를 붙여야 관리 가능해진다.
실무 적용: 단계적 도입과 품질·비용 가드레일
지금까지는 개념이었다. 여기서부터는 Azure/Kubernetes 기반 사내 AI 플랫폼(자체 vLLM과 외부 프로바이더를 함께 쓰고, 요청은 단일 게이트웨이 엔드포인트로 들어오는 구성)을 운영하는 관점의 도입 절차다. Azure에는 대응 개념이 있다. 시맨틱 캐시의 벡터 저장소는 Azure Managed Redis를, 사내 인증·정책 계층은 Azure API Management를 게이트웨이 앞에 붙이는 식이다. 다만 L2(KV-aware Pod 선택)는 vLLM 곁에 있어야 하므로 Azure Kubernetes Service의 추론 Pod 계층에서 EPP 계열로 처리한다.
A. 도입 단계표
한 번에 다 하지 않는다. 캐시 → 라우팅 → 캐스케이딩 순으로 쌓는다.
| 단계 | 목표 | 산출물 | 완료 판정 |
|---|---|---|---|
| 1. 캐시 | 중복 호출 제거 | 게이트웨이 시맨틱 캐시(임계값 0.85), TTL·테넌트 키 규칙 | 캐시 적중률 ≥ 30% 지속, 테넌트 누출 0건 |
| 2. 라우팅 | 단일 엔드포인트 + 폴백 | kgateway 라우팅 룰, 폴백 백엔드, 헤더 검증 | 5xx 발생 시 폴백 동작 로그, 카나리 weight 0 롤백 훈련 1회 |
| 3. 캐스케이딩 | 난이도 기반 모델 선택 | LLM Classifier(L1) 또는 LiteLLM 커스텀 전략, 분류 규칙 버전 관리 | misroute율 측정 가능, 재질의율 회귀 없음 |
| 4. 관측성 강화 | 회귀 감지 | Langfuse OTel, 라우팅 결정 분포 대시보드, misroute 표본 검토 | 알림 5종 활성, 주간 품질 리포트 발행 |
각 단계는 독립적으로 롤백 가능해야 한다. 캐시는 끄면 되고, 라우팅은 weight를 0으로 되돌리면 되고, 캐스케이딩은 분류기를 bypass(모든 요청 strong)하면 된다.
B. 라우팅 판단표
“이 요청을 어디로 보낼까”를 사람이 매번 판단하지 않도록 표를 먼저 정하고 코드에 옮긴다. 다음 표는 앞 절의 분류 규칙을 운영 규칙으로 다시 쓴 것이다.
| 신호 | 약한 모델 | 강한 모델 | 비고 |
|---|---|---|---|
| 강한 키워드 | 없음 | 1개 이상 | 리팩터·설계·분석·디버그·최적화·마이그레이션 |
| 입력 길이 | 500자 미만 | 500자 이상 | 코드 블록 포함 시 한 단계 승격 |
| 대화 턴 수 | 5턴 이하 | 5턴 초과 | 긴 문맥은 약한 모델이 놓치기 쉽다 |
| 도구 호출 포함 | 아니오 | 예 | 도구 스키마 추론은 강한 모델이 안전 |
| 세션 내 재질의 | 아니오 | 예 | 이전 응답이 불만족 → 승격 |
표의 마지막 두 줄이 실전에서 가장 자주 추가되는 항목이다. 문서의 기본 규칙(키워드·길이·턴 수)만으로는 도구 호출과 사용자 불만족을 잡지 못한다.
C. 품질 하한선과 폴백 정책
라우팅의 목적은 비용이 아니라 품질 하한선을 지키면서 비용을 줄이는 것이다. 그래서 폴백 조건을 먼저 정의한다.
| 조건 | 판정 | 조치 |
|---|---|---|
| HTTP 5xx | 백엔드 장애 | 다른 프로바이더/모델로 폴백 |
| rate limit 초과 | 용량 부족 | 상위 티어 또는 다른 리전으로 폴백 |
| 타임아웃(120초) | 생성 실패 | 폴백, 재시도는 최대 3회 |
| 품질 점수 < 0.7 (옵션) | 응답 불충분 | 강한 모델로 승격 재실행 |
| 분류기 장애 | 라우팅 불가 | 안전 기본값 = 강한 모델. 캐시는 그대로 |
마지막 줄을 강조한다. 분류기가 죽었을 때 약한 모델로 몰리면 품질 사고가 나고, 강한 모델로 몰리면 비용이 일시적으로 오른다. 장애 시 기본값은 품질 쪽으로 잡는다. 비용은 되돌릴 수 있지만 신뢰는 되돌리기 어렵다.
D. KPI와 롤백 기준
도입 효과를 주장하려면 숫자가 있어야 한다. 그리고 숫자가 나빠졌을 때 되돌리는 기준도 같이 정한다.
| KPI | 목표 | 측정 위치 | 롤백 트리거 |
|---|---|---|---|
| 캐시 적중률 | ≥ 30% | 게이트웨이 | 2주 연속 < 15% → 캐시 규칙 재검토 |
| 일 비용 | 도입 전 대비 −40% 이상 | 모델별 토큰 × 단가 | 없음(개선 지표) |
| 재질의율 | 도입 전 대비 +10% 이내 | 세션 로그 | +20% 초과 → 캐스케이딩 일시 중단 |
| P99 지연 | ≤ 30초 | 게이트웨이 메트릭 | 5분 연속 초과 → 알림, 폴백 점검 |
| 오류율 | < 5% | 게이트웨이 메트릭 | 초과 → 라우팅 룰 롤백 |
| 약한 모델 응답 재실행율 | 20% 이하 | 분류기 로그 | 30% 초과 → 임계값 상향(0.75→0.85) |
임계값 조정은 방향을 미리 정해 둔다. 재실행율이 높으면 승격 조건을 완화(임계값 상향)하고, 비용이 예상보다 높으면 승격 조건을 조인다. 두 KPI가 반대 방향으로 당기므로 한 번에 하나만 움직인다.
E. 배포 전 체크리스트
- 클라이언트가 단일 엔드포인트(
base_url)만 쓰는가 - 라우팅 룰이 코드(YAML)로 리뷰되고 버전 관리되는가
- 분류 규칙에 버전이 붙어 있고 회귀 테스트가 있는가
- 캐시 키에 모델·파라미터·테넌트가 들어가는가
- 캐시 응답이 테넌트 경계를 넘지 않는 것을 테스트로 증명했는가
- 분류기 장애 시 기본값이 품질 쪽(강한 모델)인가
- 타임아웃이 스트리밍 특성(첫 바이트 vs 전체)에 맞게 분리되어 있는가
- 재시도 상한이 3회이고 도구 호출 요청의 재시도 정책이 정의되어 있는가
- 서킷 브레이커
maxEjectionPercent가 50% 이하인가 - 라우팅 결정이 OTel trace에 남고 Langfuse에서 모델별 비용이 보이는가
- misroute 탐지 지표(재질의율·재실행율)가 대시보드에 있는가
- 각 단계의 롤백 절차(캐시 off / weight 0 / bypass)를 문서화했는가
References
-
Engineering Playbook —
docs/agentic-ai-platform/model-serving/inference-routing/routing-strategy.md(2-Tier Gateway, kgateway, LLM Gateway 비교, Gateway API Inference Extension/EPP, Semantic Caching, agentgateway, 모니터링). https://devfloor9.github.io/engineering-playbook/ ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7 ↩8 ↩9 ↩10 ↩11 ↩12 ↩13 ↩14 ↩15 ↩16 ↩17 ↩18 ↩19 -
Engineering Playbook —
docs/agentic-ai-platform/model-serving/inference-routing/request-cascading.md(Request Cascading 패턴, LLM Classifier, Bifrost 한계, vLLM Semantic Router, RouteLLM, 비용 시나리오). https://devfloor9.github.io/engineering-playbook/ ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7 ↩8 -
Kubernetes Gateway API — https://gateway-api.sigs.k8s.io/ ; Gateway API Inference Extension(InferencePool·EPP) — https://github.com/kubernetes-sigs/gateway-api-inference-extension ↩
-
agentgateway — https://github.com/agentgateway/agentgateway (MCP/A2A 데이터 플레인, 세션 관리·도구 호출 통제) ↩
-
Bifrost routing rules 문서 — https://docs.getbifrost.ai/providers/routing-rules (
complexity_tier기반 라우팅 룰) ↩ -
LiteLLM Routing 문서 — https://docs.litellm.ai/docs/routing (내장 라우팅 전략,
CustomRoutingStrategyBase, Langfuse callback) ↩ -
vLLM Semantic Router — https://github.com/vllm-project/semantic-router (ext-proc 배치 경량 분류 라우터) ↩
-
RouteLLM: Learning to Route LLMs with Preference Data, arXiv:2406.18665 — https://arxiv.org/abs/2406.18665 (Matrix Factorization 라우터, MT Bench에서 GPT-4 호출 26%로 GPT-4 성능 95% 유지) ↩
댓글남기기