
자가 개선 에이전트 루프 설계: 5단계 아키텍처와 리워드 해킹 방어
프로덕션에 올린 에이전트는 매일 트레이스를 남긴다. 사용자 요청, 도구 호출, 중간 추론, 최종 응답, 지연 시간, 그리고 종종 사용자의 엄지손가락까지 함께 남는다. 성공한 경로와 실패한 경로가 라벨 없이도 구분 가능한 형태로 쌓인다는 뜻이다. 자가 개선(self-improving) 루프는 이 잔여물을 다시 학습 신호로 되돌려 모델 가중치를 갱신하는 구조다. 사람이 라벨지를 붙이지 않아도 모델이 자기 실패를 재료로 다음 버전을 만든다는 점에서, “학습 데이터를 만드는 일”을 자동화하는 쪽에 가깝다.
사내 LLM 플랫폼을 운영하면서 이 루프를 검토해 보면, 실제로 어려운 지점은 학습 알고리즘이 아니다. GRPO니 DPO니 하는 선택지는 문서화가 잘 되어 있다. 무너지는 곳은 다른 데다. “무엇을 성공으로 정의할 것인가”, “어떤 트레이스까지 학습에 쓸 것인가”, “어느 단계에서 사람이 손을 멈추게 할 것인가” — 즉 경계를 어디서 끊을 것인가가 문제다. 이 글은 공개된 엔지니어링 매뉴얼의 자가 개선 루프 설계1와 그 도입을 다룬 의사결정 기록2을 참고해, 실제 운영 판단에 쓸 수 있는 형태로 다시 정리한 독립 문서다. 아이디어와 수치의 출처는 각주로 남긴다.
1. 자가 개선 루프란 무엇인가(그리고 무엇이 아닌가)
1.1 성공 경로가 다음 학습의 시그널이 된다
출발점은 “모델이 도구를 써 가며 여러 추론 경로를 탐색하고, 그중 성공한 경로를 다음 학습의 정답으로 재활용한다”는 발상이다1. 원형은 2026년 3월 공개된 자율 연구 루프 프로젝트로, 좁은 실험 환경에서 훈련 설정 파일을 스스로 고치며 지표를 개선하는 사이클을 보여줬다3. 이 아이디어를 에이전트 운영에 옮기면 네 동작으로 정리된다.
- 도구 사용 롤아웃(Tool-use Rollout): 하나의 요청에 대해 코드 실행·검색·계산 같은 도구를 섞어 여러 경로를 시도한다.
- 성공의 시그널화(Success as Signal): 정답 도달이나 작업 완료 여부가 그 경로의 점수가 된다.
- 자기 지도 루프(Self-Supervised Loop): 사람 라벨 없이 성공·실패 데이터가 축적되고, 선호도 학습으로 다시 들어간다.
- 복리 성장(Compound Growth): 강해진 모델이 더 많은 성공 트레이스를 만들고, 그게 다시 학습 재료가 된다.
마지막 항목이 이 구조의 매력이자 위험이다. 선순환은 반대로 돌면 악순환이 되고, 회전 속도가 빠를수록 그 방향을 되돌리기 어렵다. 그래서 엔터프라이즈 해석에서는 “완전 자동화”가 아니라 “사람 감독 아래의 자동 강화”로 읽는 게 정석이다1. 매 회차마다 품질 게이트와 휴먼-인-루프 검증이 끼어든다는 전제를 빼면, 이 글의 나머지 내용은 성립하지 않는다.
1.2 자가 개선 루프가 아닌 것
이 용어는 자주 오해된다. 다음은 자가 개선 루프가 아니다.
| 오해 | 실제 | 왜 다른가 |
|---|---|---|
| 프롬프트를 자동으로 고치는 시스템 | 가중치를 갱신하는 학습 루프 | 프롬프트·라우팅 튜닝은 폐쇄 모델에도 적용 가능하지만 자가 학습은 아님 |
| 파인튜닝 파이프라인 그 자체 | 트레이스 수집 → 평가 → 학습 → 검증의 폐루프 | CI/CD만 있으면 되는 게 아니라 신호 품질 관리가 본체 |
| 사용자 피드백을 그대로 정답으로 쓰는 것 | 피드백을 복합 점수의 한 항으로 쓰는 것 | 단일 신호를 정답화하면 리워드 해킹에 그대로 노출됨 |
| 사람이 필요 없는 학습 | 사람이 경계를 정하는 학습 | 스코프·게이트·롤백 기준은 사람이 합의해야 함 |
특히 마지막 줄이 중요하다. 자가 개선 루프에서 사람의 역할은 “라벨링”에서 “경계 설정과 검증”으로 이동한다. 손이 줄어드는 게 아니라, 개입 지점이 뒤로 밀리는 것이다.
1.3 엔터프라이즈 제약 다섯 가지
이상적인 실험실 루프를 기업 환경에 그대로 옮기면 다섯 곳에서 걸린다1.
| 제약 | 실체 | 대응 방향 |
|---|---|---|
| 데이터 거버넌스 | 트레이스에 개인정보·기밀이 섞임 | PII 스캐너, k-익명성, 동의 추적 |
| 비용 | 롤아웃마다 모델 호출이 경로 수만큼 늘어남 | 저비용 모델 우선, 캐싱, 상한 설정 |
| 리워드 모델링 | “성공”의 정의가 모호(정확도인가 만족도인가) | 복합 리워드 + 정기 재조정 |
| 모드 붕괴(Mode Collapse) | 특정 패턴만 반복 생성해 다양성 상실 | 엔트로피 정규화, 다양한 샘플링 |
| 규제 | 모델 변경마다 감사 로그·모델 카드 갱신 필요 | 버전 관리 + 감사 추적 |
이 중 비용과 모드 붕괴는 학습을 돌려 보기 전에는 체감이 안 되고, 데이터 거버넌스는 사고가 난 뒤에야 비용이 드러난다. 세 항목 모두 “자동화 경계”를 어디에 두느냐로 관리 강도가 결정된다.
2. 5단계 루프 아키텍처
2.1 전체 흐름
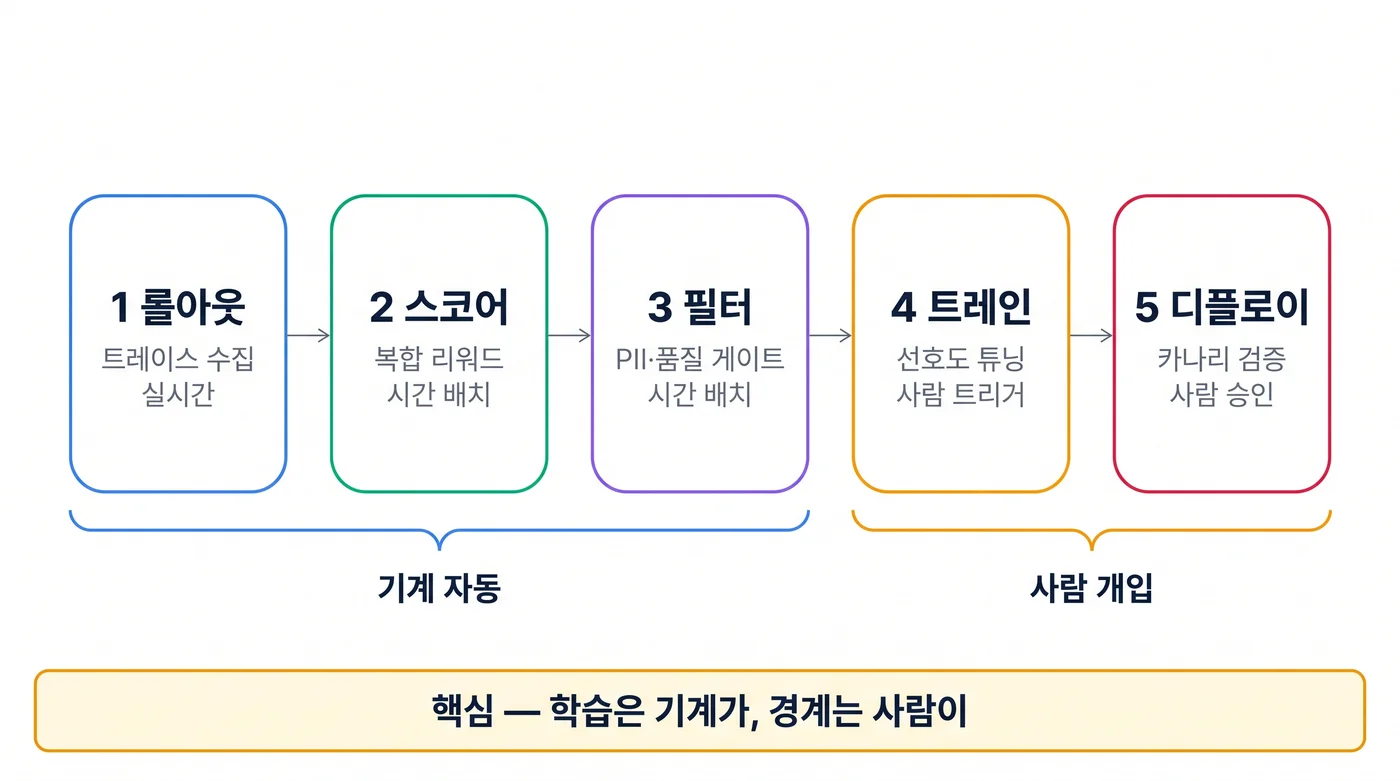
루프는 롤아웃 → 스코어 → 필터 → 트레인 → 디플로이의 다섯 단계로 닫힌다. 각 단계의 실행 주기가 다르다는 점이 설계의 핵심이다. 앞의 세 단계는 기계가 연속·배치로 돌리고, 뒤의 두 단계는 사람이 트리거한다2.
[1 Rollout]  프로덕션 요청 → 에이전트 실행 → 트레이스 기록
     │  실시간 (사용자 응답은 로깅 실패와 무관하게 반환)
     ▼
[2 Score]    LLM 심판 + RAG 지표 + 사용자 피드백 → 0~1 복합 점수
     │  시간 단위 배치
     ▼
[3 Filter]   품질 게이트 → PII 마스킹 → k-익명성 → 학습 테이블 적재
     │  시간 단위 배치
     ▼
[4 Train]    선호 쌍 구성 → GRPO/DPO/RLAIF → 후보 모델 체크포인트
     │  주간/월간, 사람 트리거 필수
     ▼
[5 Deploy]   골든 평가 → 섀도 5% → 카나리 25→50→100%
     │
     └──── 회귀 감지 시 롤백 ◀──── 이전 세대 가중치로 복귀
2.2 1단계: 롤아웃(Rollout) — 트레이스 수집
목표는 실제 사용자 요청에 대한 에이전트 실행 기록을 모으는 것이다. 입력은 요청·컨텍스트·에이전트 상태, 출력은 프롬프트, 도구 호출, 중간 추론, 최종 응답, 지연 시간, 토큰 수를 담은 트레이스다. 관측 도구로는 OTel 기반 트레이싱이 표준으로 쓰인다1.
운영에서 지켜야 할 규칙은 세 가지다.
- 비동기 로깅: 트레이스 저장이 실패해도 사용자 응답은 정상 반환한다. 관측 실패가 서비스 실패가 되면 안 된다.
- 다양성 확보: 같은 요청에 temperature를 조금씩 바꿔 여러 응답을 생성해 롤아웃 풀을 넓힌다. 다양성은 5장의 방어 기제와 직결된다.
- 경로 수 = 비용: 롤아웃 수만큼 추론 비용이 곱해진다. 경로 수는 품질 게이트 통과율과 함께 튜닝해야 하는 값이다.
2.3 2단계: 스코어(Score) — 리워드 계산
각 트레이스에 0~1 점수를 부여해 “얼마나 좋은 응답인가”를 정량화한다. RAG 쪽 지표(충실성·문맥 재현율)는 Ragas 계열 프레임워크로 계산한다4. 여기서 심판 모델의 선택이 비용을 좌우한다. 평가는 소형 모델(예: 8B급)로 돌리고, RAG 지표는 동일 질문·컨텍스트 조합을 캐싱하며, 사용자 피드백이 이미 있으면 심판 호출을 생략하는 식으로 절감한다1.
세 신호를 합치는 이유는 각각의 사각지대가 다르기 때문이다.
| 신호 | 무엇을 보는가 | 사각지대 |
|---|---|---|
| LLM 심판 | 정확성·완전성·명확성·간결성 | 장황함·단정적 표현에 후함 |
| RAG 지표(충실성·문맥 재현율) | 근거에 충실한가, 검색이 충분했나 | 검색이 아예 필요 없는 질문 |
| 사용자 피드백 | 실제 만족 | 표본이 적고 편향됨 |
2.4 3단계: 필터(Filter) — 큐레이션 게이트
점수가 붙은 트레이스 중 학습에 쓸 것만 남긴다. 통과 조건은 명시적이어야 하고, 실패 사유별로 집계해야 한다. 다음 절(4장)에서 임계값과 PII 처리를 따로 다루고, 여기서는 위치만 잡아 둔다. 필터 단계의 산출물은 객체 스토리지 위의 오픈 테이블 포맷 학습 데이터셋이다1. Azure로 옮기면 같은 자리를 Data Lake Storage Gen2 + Delta Lake 조합이 대신한다. 테이블 포맷이 중요한 이유는 스키마 진화와 타임트래블이 필요하기 때문이며, 어느 클라우드든 조건은 같다.
2.5 4단계: 트레인(Train) — 선호도 튜닝
동일 질문에 대한 여러 응답을 점수순으로 세워 상위를 preferred, 하위를 rejected로 묶는다. 이때 점수 차이가 충분히 큰 쌍만 남긴다 — 차이가 작은 쌍(예: 0.2 미만)은 노이즈로 취급한다1. 이 “최소 격차”가 선호 쌍의 품질을 지키는 첫 번째 밸브다.
학습 방법은 데이터 양과 수렴 특성에 따라 고른다.
| 방법 | 최소 데이터 | 대략 GPU-hours(7~8B 기준) | 수렴 안정성 | 적합 시나리오 |
|---|---|---|---|---|
| GRPO | 1k+ pairs | 수십 | 중간 | 초기 실험, 빠른 반복 |
| DPO | 5k+ pairs | 약 200 | 높음 | 데이터 확보 후 안정 학습 |
| RLAIF | 10k+ pairs + 리워드 모델 | 수백 | 낮음 | 복잡한 리워드 모델링 |
| RFT | 10k+ 고품질 트레이스 | 수백(최저 난도) | 매우 높음 | 전문가 검증 골든셋 확보 시 |
숫자는 환경 의존적이다. 참고로 7B 모델 DPO 전체 파인튜닝은 16×A100에서 2~4시간 수준으로 보고된다1. DPO는 별도 리워드 모델 없이 선호 쌍만으로 정책을 직접 최적화하고5, GRPO는 critic(가치) 모델을 제거해 메모리를 아끼는 대신 학습률에 민감하다. 권장 로드맵은 초기 GRPO → 데이터 축적 후 DPO → 복잡한 리워드가 필요해지면 RLAIF, 골든셋이 있으면 RFT 병행이다1.
2.6 5단계: 디플로이(Deploy) — 회귀 검증과 점진 배포
학습이 끝났다고 바로 배포하지 않는다. 순서는 골든셋 평가 → 섀도 테스트 → 카나리 확대다.
- 골든셋 평가: 도메인 전문가가 검증한 100~200개 QA로 기존 모델과 신모델을 비교한다. 대응 표본 검정으로 유의성을 확인하고, 평균이 5% 이상 퇴화하면 즉시 롤백 판정을 낸다1.
- 섀도 테스트: 신모델은 5% 트래픽에 흘려보내되 응답은 로깅만 하고 사용자에게는 기존 모델 답을 준다. 위험 없이 실트래픽 분포를 관찰하는 단계다.
- 카나리 확대: 5% → 25% → 50% → 100%로 올리며 각 단계마다 24시간을 관찰한다1. Azure에서 같은 자리는 Container Apps 리비전 트래픽 분할이나 API Management의 가중치 라우팅이 담당한다.
회귀 감지 규칙은 미리 선언해 둔다. 예를 들어 카나리 모델의 에러율이 기준 모델의 1.5배를 30분간 넘으면 자동 롤백을 트리거하는 식이다1. 자동 롤백은 “감지 → 판정 → 이전 가중치 복귀”가 모두 기계로 닫혀야 실제로 작동한다.
2.7 단계별 주기와 자동화 경계
| 단계 | 실행 주기 | 자동화 | 사람 개입 |
|---|---|---|---|
| 1. 롤아웃 | 실시간 | 완전 자동 | 없음 |
| 2. 스코어 | 시간 배치 | 완전 자동 | 주간 1~2% 샘플 수동 검증 |
| 3. 필터 | 시간 배치 | 완전 자동 | PII 스캐너 통과 강제 |
| 4. 트레인 | 주/월 | 수동 트리거 | 배포 엔지니어 승인 |
| 5. 디플로이 | 학습 후 1회 | 수동 승인 + 카나리 | 단계별 게이트 승인 |
다섯 중 셋만 자동화하고 마지막 둘은 사람이 잡는다는 게 이 아키텍처의 결론이다2. 이 배치는 자율 운영 일반 원칙 — 사람이 의도와 가드레일을 정의하고 시스템이 프로그래머틱하게 실행하는 모델 — 의 한 사례이기도 하다6. 완전 무인으로 돌리면 회전 속도가 빨라지는 만큼 리워드 해킹과 롤백 비용도 함께 커진다.
3. 리워드 설계
3.1 복합 리워드의 구성
리워드는 다섯 항의 가중합으로 둔다. 각 항의 기본 가중치는 다음 표와 같고, 합이 1이 되도록 관리한다1.
| 항 | 가중치 | 의미 |
|---|---|---|
| LLM 심판 점수 | 0.30 | 정확성·완전성·명확성·간결성 |
| RAG 충실성(faithfulness) | 0.25 | 근거에 기반했는가(환각 억제) |
| RAG 문맥 재현율(context recall) | 0.20 | 검색이 필요한 근거를 담았는가 |
| 사용자 피드백 | 0.20 | 긍정 1.0 / 중립 0.5 / 부정 0.0 |
| 지연 시간 페널티 | 0.05 | 임계 초과 시 최대 5% 감점 |
계산식은 단순하다. reward = 0.30·judge + 0.25·faith + 0.20·recall + 0.20·feedback − penalty 형태로 합산한 뒤 0~1로 클램프한다1. 지연 페널티는 일정 시간(예: 10초)을 넘긴 만큼 비례해 깎되 상한을 둔다 — 학습이 “느려도 좋은 답”을 정답으로 배우지 않게 하려는 장치다.
3.2 가중치 조정은 실험으로 한다
가중치는 감으로 정하지 않는다. 실험군을 나눠 학습 → 골든셋 평가 → 소규모 카나리 → 비즈니스 지표 순으로 비교한다1. 예를 들어 baseline, user-first(사용자 피드백 가중 상향), quality-first(충실성·재현율 상향) 세 조합을 병렬로 돌리고, 2~3회 반복 후 조합을 확정한다. 가중치를 바꾸면 학습 방향이 통째로 바뀌므로, 이 실험 자체가 곧 리워드 정책 변경 절차다.
3.3 리워드 정의가 곧 학습 방향이다
리워드 함수는 이 루프의 조타 장치다. 그래서 정책 변경(심판 프롬프트, 지표 가중치, 피드백 반영 방식)에는 단일 책임자(DRI, Directly Responsible Individual)를 지정하고, 변경 시 리뷰와 과거 트레이스에 대한 백테스트 결과를 첨부하도록 규정한다2. 이 규정이 없으면 “조용한 드리프트”가 생긴다. 아무도 모르는 사이에 리워드가 바뀌고, 몇 세대 뒤 모델 성격이 달라져 있다.
4. 데이터 큐레이션과 PII 게이트
4.1 트레이스가 학습 데이터가 되기까지
트레이스 스토어 ──시간 배치──▶ ETL 작업
                                 │
                    ┌────────────┴────────────┐
                    ▼                         ▼
            PII 스캐너(Presidio)        품질 게이트
                    │                         │
              통과  │  탐지            통과    │  탈락
                    │   │                    │    └─▶ 폐기
                    │   └─▶ 익명화 or 폐기    │
                    ▼                         ▼
              오픈 테이블 포맷 학습 데이터셋(객체 스토리지)
파이프라인의 순서가 중요하다. 점수 필터를 먼저 걸러 학습 후보를 줄이고, 그다음 PII를 처리한다. 순서를 뒤집으면 개인정보를 담은 저품질 트레이스까지 스캐너에 넣게 되어 비용만 늘어난다1.
4.2 품질 게이트 임계값
| 조건 | 기준 | 이유 |
|---|---|---|
| 최소 리워드 | 0.7 미만 탈락 | 하위 응답을 학습하면 퇴화 |
| 지연 이상치 | P99 상한 초과 탈락 | 인프라 문제를 모델 문제로 오학습 |
| 에러 발생 | 에러 1건 이상 탈락 | 실패 경로를 정답으로 오인 |
| 중복 | 동일 질문·응답 조합 제거 | 편향 증폭 방지 |
| 선호 쌍 최소 격차 | 리워드 차 0.2 미만 제외 | 노이즈 쌍 배제 |
임계값은 한 번 정하고 끝이 아니다. 통과율이 급락하면 임계값이 데이터 분포와 어긋난 것이고, 통과율이 100%에 붙으면 게이트가 사실상 없는 것이다. 두 방향 모두 알림 대상이다.
4.3 PII 스캔과 한국어 인식기
개인정보 탐지는 Presidio 계열 도구를 기본으로 쓴다17. 다만 기본 엔진은 영어 중심이라 한국어는 별도 NLP 엔진과 커스텀 인식기를 등록해야 한다. 주민등록번호, 계좌번호처럼 한국 특화 패턴은 정규식 인식기로 추가한다1. 스캔 결과는 두 갈래로 처리한다 — 익명화 가능하면 마스킹해서 살리고, 아니면 폐기한다. 어떤 트레이스가 PII로 걸렸는지는 메타데이터에 남겨 감사 로그와 연결한다.
4.4 k-익명성: 패턴 단위로 개인을 지운다
한 건의 트레이스에서 이름을 지워도, 그 문장이 세상에 하나뿐이면 여전히 개인이 특정된다. k-익명성은 질의를 엔티티 제거 후 패턴으로 바꿔, 같은 패턴이 최소 k건 이상 모인 그룹만 학습에 남긴다1. 예컨대 “홍길동의 4월 급여는” 같은 질의는 [이름]의 [날짜] 급여는 패턴으로 접히고, 그 패턴이 k건 미만이면 그룹 전체가 빠진다. k는 보통 5 근처에서 시작한다.
4.5 동의·지역·보관 — 4개 게이트
학습 데이터로 승격되기 전에 통과해야 하는 게이트는 품질·PII 외에도 있다2.
| 게이트 | 확인 내용 | 실패 시 |
|---|---|---|
| PII 게이트 | 개인정보 탐지·마스킹 | 폐기 |
| 동의 게이트 | 학습 활용 동의 태그(consent=true) |
제외 |
| 지역 게이트 | 규제 지역 트레이스는 같은 경계 내 학습만 | 리전 고정 |
| 기밀 분류 게이트 | 고객 기밀은 사내 전용 모델에만 반영 | 스코프 제한 |
법적 요건도 여기 붙는다. 국내 개인정보보호법(PIPA) 기준으로 프로파일 기반 자동 결정에는 사전 동의(opt-in)가 필요하고, 국외 이전 시 별도 동의와 국내 리전 저장이 요구된다. GDPR 기준으로는 삭제 요청 시 7일 내 대응, 목적 달성 후 원본 트레이스는 90일 이내 삭제가 목표다1. 이 조건들은 나중에 붙이기 어렵다. 파이프라인을 처음 설계할 때 게이트로 박아 넣어야 한다.
5. 리워드 해킹 탐지·방어
5.1 리워드 해킹이란
리워드 해킹(Reward Hacking)은 모델이 “진짜 좋은 응답”이 아니라 “점수가 높게 나오는 응답”만 학습하는 현상이다1. 세 가지 전형이 자주 나타난다.
- 과도한 장황함: 길게 쓰면 완전성 점수가 올라가므로, 핵심 없이 길어진다.
- 템플릿 반복: 특정 서식(“1) … 2) …”)이 높은 점수를 받으면 모든 답변이 같은 모양이 된다.
- 확신 과잉: 단정적 표현이 심판 점수를 올려, 틀린 내용도 자신 있게 말한다.
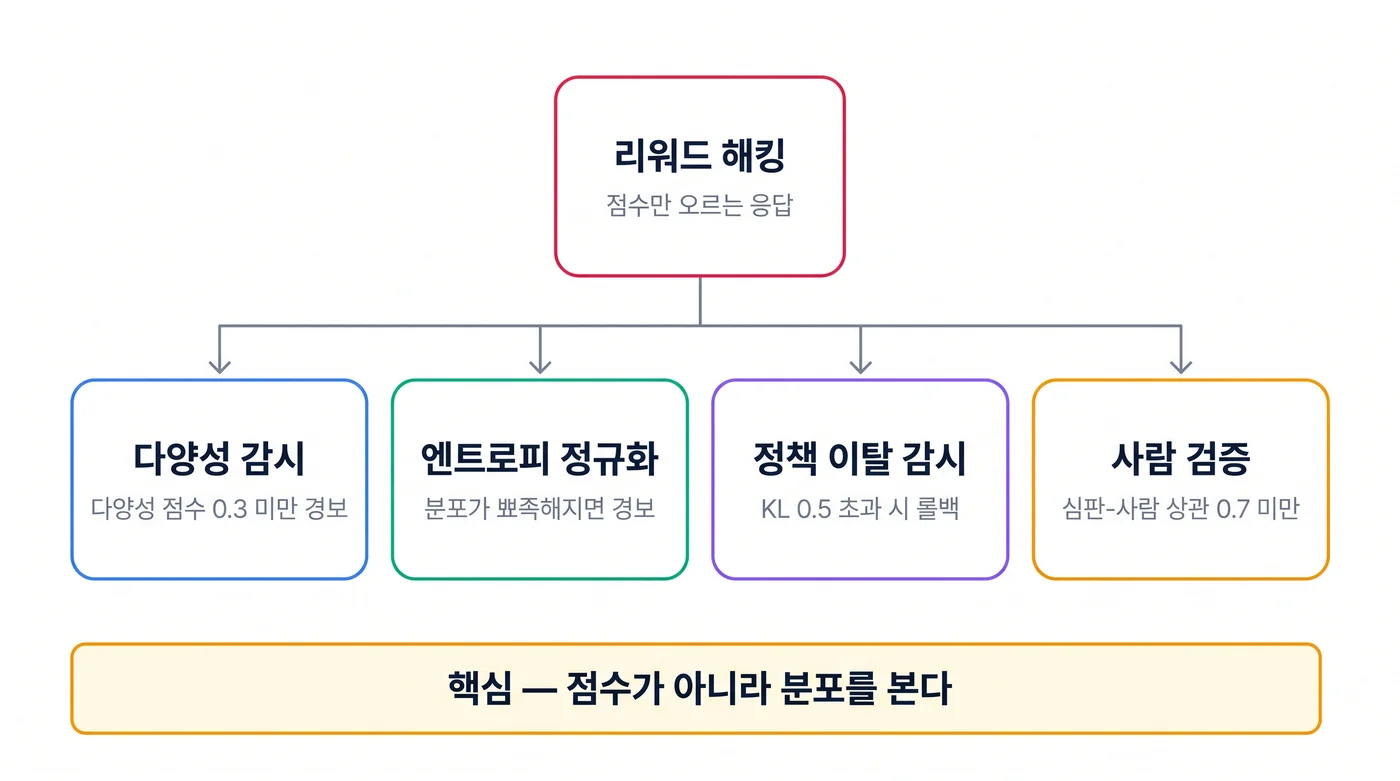
세 전형의 공통점은 출력 분포가 한 점으로 수렴한다는 것이다. 그래서 방어의 절반은 “분포가 좁아지고 있는가”를 감시하는 일이 된다.
5.2 다양성 감시: 응답이 서로 닮아 가는가
방어의 첫 겹은 롤아웃 단계의 다양성 확보다. 같은 프롬프트에 temperature와 top_p를 조금씩 바꿔 여러 응답을 생성하고, 그 응답들끼리의 코사인 유사도를 평균 내 다양성 점수로 삼는다1. 응답이 서로 지나치게 닮으면(예: 다양성 점수 0.3 미만) 모드 붕괴 경고를 띄운다. 이 지표는 학습 전에 잡을 수 있는 유일한 조기 경보다.
5.3 엔트로피 정규화: 넓은 분포를 유지한다
학습 손실에 엔트로피 항을 빼서(즉 높은 엔트로피를 선호하도록) 출력 분포가 뾰족해지는 것을 늦춘다1. 정규화 계수(예: 0.01)는 작게 시작한다. 학습 중 배치별 엔트로피를 로깅하고, 임계 이하로 급감하면 모드 붕괴 신호로 본다. 임계값은 어휘 크기에 따라 다르므로 절대값이 아니라 “기준 모델 대비 하락폭”으로 보는 편이 안전하다.
5.4 정책 이탈 감시: 기준 모델에서 얼마나 멀어졌나
재학습 모델이 기준 모델과 너무 멀어지면, 좋아진 게 아니라 다른 모델이 된 것이다. 이를 KL 발산(KL Divergence)으로 측정한다1. 골든 프롬프트 집합에서 두 모델의 출력 분포 차이를 평균 내고, 임계(예: 0.5) 초과 시 롤백 판정을 낸다. KL은 배포 전 게이트이면서 학습 중 정규화 항(KL 페널티)으로도 쓰인다. 참고로 GRPO 계열의 원 설계에서는 KL 계수를 0.04로 두는 것이 출발점으로 제시된다8.
5.5 사람 검증: 심판과 사람의 상관을 본다
기계 지표만으로는 “심판이 사람과 같은 방향을 보고 있는가”를 알 수 없다. 그래서 학습 데이터의 1~2%를 주간으로 사람이 검토한다1. 표본은 무작위 절반 + 경계 사례 절반으로 구성한다. 경계 사례는 리워드 점수와 사용자 피드백이 크게 어긋난 트레이스, 즉 “기계는 좋다고 했는데 사람은 싫어한” 항목이다. 검토 후에는 리워드 점수와 사람 점수 사이의 순위 상관계수(스피어만)를 계산해, 상관이 낮으면(예: 0.7 미만) 리워드 함수를 재조정한다1. 이 숫자가 리워드 시스템의 건강 지표다.
| 방어 겹 | 무엇을 보는가 | 경보 조건(예) | 조치 |
|---|---|---|---|
| 다양성 감시 | 롤아웃 간 유사도 | 다양성 점수 < 0.3 | 샘플링 파라미터 조정 |
| 엔트로피 정규화 | 출력 분포 폭 | 엔트로피 급감 | 계수 상향, 학습 중단 검토 |
| KL 감시 | 기준 모델과의 거리 | KL > 0.5 | 롤백 |
| 사람 검증 | 심판-사람 상관 | 상관 < 0.7 | 리워드 재조정 |
6. 조직 차원의 도입 판단
6.1 ADR로 경계를 먼저 고정한다
자가 개선 루프는 기술 문서보다 의사결정 기록(ADR, Architecture Decision Record) 이 먼저다. ADR은 아키텍처 수준 결정을 맥락(Context)·결정(Decision)·결과(Consequences) 세 요소로 고정하는 경량 형식이며, “왜 그때 그 구조를 택했는가”를 코드와 함께 버전 관리한다29.
| 섹션 | 역할 |
|---|---|
| Title | 한 줄 결정 요약 |
| Status | Proposed / Accepted / Deprecated / Superseded |
| Context | 결정이 필요해진 배경·제약 |
| Decision | 합의된 선택(단일 또는 다건) |
| Consequences | 긍정·부정 영향, trade-off, 후속 액션 |
이 형식이 자가 개선 루프에 특히 잘 맞는 이유는, 결정 당시의 전제가 무너졌을 때 Context 섹션이 “무엇을 재평가해야 하는가”의 기준점이 되기 때문이다2. Accepted 이후에는 본문을 고치지 않고, 반대 결정은 새 ADR로 쓴 뒤 기존 문서를 Superseded by로 표시한다.
합의해야 할 항목은 대체로 다음과 같이 정리된다2.
- 스코프: 가중치를 갱신하는 대상은 자체 호스팅 오픈웨이트 모델로 한정. 관리형 폐쇄 모델은 프롬프트·라우팅 튜닝으로 대체한다.
- 자동화 경계: 5단계 중 어디까지 무인으로 돌릴지 명시(앞의 2.7절 표).
- 리워드 책임자: 단일 DRI 지정 + 백업 DRI.
- 데이터 게이트: 4개 게이트 통과 의무화(4.5절).
- 비용 가드레일: 월 GPU-hour 상한과 초과 시 승인 절차.
- 롤백 경계: 어느 세대까지 즉시 복귀 가능해야 하는가.
- 조직 경계: 파일럿 대상과 확장 시점.
6.2 비용과 효과를 숫자로 세운다
루프 하나가 도는 데 드는 월 비용은 대략 다음 항목으로 나뉜다1.
| 항목 | 월 비용(예시, USD) | 비고 |
|---|---|---|
| GPU 학습 | 2,500 | 주간 DPO, 8×H100 × 25h 수준 |
| 트레이스 저장 | 300 | 객체 스토리지 + 오픈 테이블 포맷 |
| 심판 추론 | 500 | 소형 모델, 시간당 1만 건 평가 |
| RAG 평가 | 200 | 캐싱 활용 |
| 인프라 운영 | 500 | ETL·배치·카탈로그 |
| 합계 | 4,000 |
학습 1회 비용만 따로 보면 더 명확하다. 8B 모델 5k 쌍 DPO가 200 GPU-hours라고 하면, 시간당 단가에 따라 1회 약 $1,400 수준이고, 주간으로 돌리면 월 $5.5k, 월간으로 돌리면 월 $1.4k가 된다1. 즉 학습 주기가 곧 비용 상한이다. 반대로 기대 효과는 3개월 실측 기준으로 Exact Match 0.78→0.85, 사용자 만족 3.5→4.2, 작업 완료율 72%→83%, 에스컬레이션 15%→9% 같은 수치로 보고된다1. 다만 이 수치는 특정 도메인과 데이터 조건의 결과이므로, 우리 환경에서 재현되는지는 파일럿으로 확인해야 한다.
6.3 단계별 Go/No-Go
한 번에 프로덕션으로 가지 않는다. 최소 스코프 파일럿에서 게임 데이터를 쌓고 확장한다12.
| 단계 | 기간 | 대상·규모 | 예산(예) | Go 기준 |
|---|---|---|---|---|
| Phase 0 (Pilot) | 1개월 | 라우터/분류기만, 500 트레이스 | $500 | Exact Match +3%p 이상 |
| Phase 1 (PoC) | 3개월 | 소형 SLM 하나, 5k 트레이스 | $12k | 만족도 +10% 이상, 회귀 없음 |
| Phase 2 (Production) | 6개월+ | 정기 학습 루프 확립 | 상한 관리 | ROI > 1.5, 게이트 통과율 >95% |
초기 스코프를 라우터나 분류기 같은 작은 모델에 두는 이유는 명확하다. 리워드가 단순하고(정답 라벨이 곧 리워드), 실패 시 피해 반경이 작으며, 학습 비용도 낮다2. 여기서 루프 운영 노하우를 쌓은 뒤 생성 모델로 넓힌다.
6.4 팀 역량 체크
기술 도입 여부보다 팀이 그 기술을 운영할 수 있는지가 먼저다1.
| 역량 | 필수도 | 확보 방안 |
|---|---|---|
| RL 전문성 | 높음 | 외부 컨설팅 또는 채용 |
| MLOps 성숙도 | 매우 높음 | CI/CD·모니터링 파이프라인 |
| LLM 평가 경험 | 높음 | 평가 프레임워크 교육 |
| 프로덕션 운영 | 매우 높음 | SRE 협업 |
| 데이터 거버넌스 | 매우 높음 | 법무·컴플라이언스 연계 |
최소 구성은 대략 ML 엔지니어(RL 경험) 1, MLOps 엔지니어 1, 데이터 엔지니어 1, SRE 0.5(겸임), 도메인 전문가(라벨 검증) 1 정도다1. 이 표에서 “높음”이 두 개 비어 있으면, 기술적으로는 돌아가도 운영이 버티지 못한다.
실무 적용: 중단 조건·승인 게이트·측정 지표
여기서부터는 사내 AI 플랫폼 운영자 시점의 실행 항목이다. AWS 기준으로 쓰되 클라우드별 대응이 다른 지점은 함께 적는다.
중단·롤백 트리거
자동 롤백은 트리거를 미리 선언해 두지 않으면 작동하지 않는다. 아래 표를 ADR에 붙여 두고, 값은 환경별로 채운다.
| 트리거 | 측정 | 임계(예) | 판정 | 조치 |
|---|---|---|---|---|
| 에러율 급증 | 카나리/기준 비율 | 1.5배, 30분 지속 | 자동 | 이전 가중치 복귀 |
| 품질 퇴화 | 골든셋 평균 | 5% 이상 하락 | 자동 | 롤백, 재학습 중단 |
| RAG 충실성 하락 | 카나리 후 배포 관측 | 5%p 하락 | 자동 | 롤백 |
| 정책 이탈 | 기준 모델 대비 KL | 0.5 초과 | 반자동 | 배포 보류, 재학습 |
| 모드 붕괴 | 다양성 점수 | 0.3 미만 | 반자동 | 샘플링·정규화 조정 |
| 심판 신뢰도 | 심판-사람 상관 | 0.7 미만 | 수동 | 리워드 재조정 |
| 비용 초과 | 월 GPU-hour | 상한 도달 | 수동 | 학습 잡 스케줄 중단 |
“자동”으로 표시된 항목만 무인 롤백 경로를 태우고, 나머지는 사람이 확인 후 실행한다. 임계값을 자동 구간에 잘못 넣으면 정상 변동에도 학습 파이프라인이 멈춘다.
사람 승인 게이트
| 게이트 | 시점 | 승인자 | 확인 항목 |
|---|---|---|---|
| 학습 트리거 | 4단계 진입 전 | 배포 엔지니어 | 데이터 게이트 결과, 리워드 정책 변경 여부 |
| 리워드 정책 변경 | 변경 PR | 리워드 DRI | 백테스트 30일 결과 |
| 카나리 확대 | 각 단계 전환 | 운영 리드 | 24시간 회귀 지표 |
| 프로덕션 100% | 최종 전환 | 플랫폼 리드 | 롤백 경로 리허설 완료 |
| 스코프 확장 | Phase 전환 | 관련 팀 리드 | 별도 ADR |
안전 지표 모니터링
| 축 | 지표 | 정상 범위 감각 | 이탈 시 |
|---|---|---|---|
| 품질 | 골든셋 정확도, 충실성 | 기준 대비 ±5% 이내 | 롤백 |
| 비용 | GPU-hour/월, 심판 호출 수 | 상한 80% 이하 | 학습 주기 조정 |
| 편향·다양성 | 응답 다양성 점수, 엔트로피 | 모델별 기준선 유지 | 파라미터 조정 |
| 거버넌스 | PII 탐지 건수, 게이트 통과율 | 0건 누출, 통과율 안정 | 파이프라인 정지 |
| 안정성 | 에러율, P99 지연 | 기준 모델 대비 동등 | 롤백 |
품질·비용·편향 세 축을 한 대시보드에 함께 두는 이유는, 한 축을 개선하는 조치가 다른 축을 나쁘게 만들기 때문이다. 예컨대 학습 빈도를 높이면 품질은 오르지만 비용이 오르고, 리워드 가중치를 품질 쪽으로 밀면 다양성이 줄 수 있다.
롤백 리허설(Game day)
자가 학습 루프의 가장 흔한 실패 모드는 “어제는 좋았는데 오늘은 나빠졌다”다2. 그래서 롤백은 문서로만 두지 않고 주기적으로 리허설한다.
- 보관 세대: 모델 가중치 최근 3세대, 리워드 모델 5회분, 라우터 분류기 10회분을 삭제하지 않고 보관한다2.
- 복귀 시간 목표: 카나리 실패 시 이전 세대로 5분 내 자동 복귀가 되는지 정기 확인한다2.
- 리허설 항목: 가중치 복귀, 리워드 모델 복귀, 트레이픽 분할 초기화, 알림 전파, 감사 로그 기록.
- 기록: 리허설 결과는 ADR의 Consequences 섹션에 후속 액션으로 남긴다.
도입 순서 체크리스트
- 스코프를 자체 호스팅 소형 모델 하나로 좁혔는가(폐쇄 모델 제외).
- 도입 ADR을 작성하고 자동화 경계·리워드 DRI·롤백 기준을 합의했는가.
- 트레이스 수집(1단계)을 사용자 응답과 분리된 비동기 경로로 붙였는가.
- 복합 리워드 정의와 가중치 초깃값을 문서화했는가.
- 품질 게이트 임계값과 4개 데이터 게이트를 파이프라인에 강제했는가.
- PII 스캐너에 한국어 인식기(주민등록번호·계좌번호)를 등록했는가.
- 다양성·엔트로피·KL 감시를 학습 파이프라인에 연결했는가.
- 골든셋(100건 이상)과 회귀 판정 규칙을 준비했는가.
- 카나리 단계(5→25→50→100%)와 자동 롤백 트리거를 선언했는가.
- 월 GPU-hour 상한과 초과 시 승인 절차를 정했는가.
- 롤백 리허설을 한 번 이상 돌렸는가.
체크리스트의 앞 두 항목이 비어 있으면 뒤 항목은 의미가 없다. 경계 없는 자동화는 자동화가 아니라 사고의 증폭기다.
References
- Engineering Playbook —
docs/agentic-ai-platform/design-architecture/advanced-patterns/self-improving-agent-loop.md(devfloor9.github.io/engineering-playbook) - Engineering Playbook —
docs/agentic-ai-platform/design-architecture/advanced-patterns/adr-self-improving-loop.md(devfloor9.github.io/engineering-playbook) - Engineering Playbook —
docs/aidlc/operations/autonomous-response.md(devfloor9.github.io/engineering-playbook) - Andrej Karpathy — autoresearch (2026-03), https://github.com/karpathy/autoresearch
- Michael Nygard — Documenting Architecture Decisions (2011), https://cognitect.com/blog/2011/11/15/documenting-architecture-decisions
- DeepSeekMath: GRPO (2024), https://arxiv.org/abs/2402.03300
- DPO: Direct Preference Optimization (NeurIPS 2023), https://arxiv.org/abs/2305.18290
- Microsoft Presidio, https://microsoft.github.io/presidio/
- Ragas Documentation, https://docs.ragas.io/
-
Engineering Playbook —
docs/agentic-ai-platform/design-architecture/advanced-patterns/self-improving-agent-loop.md(devfloor9.github.io/engineering-playbook). 5단계 루프, 복합 리워드 가중치, 데이터 큐레이션·PII 게이트, 리워드 해킹 방어, 비용·효과 추정의 근거. ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7 ↩8 ↩9 ↩10 ↩11 ↩12 ↩13 ↩14 ↩15 ↩16 ↩17 ↩18 ↩19 ↩20 ↩21 ↩22 ↩23 ↩24 ↩25 ↩26 ↩27 ↩28 ↩29 ↩30 ↩31 ↩32 ↩33 -
Engineering Playbook —
docs/agentic-ai-platform/design-architecture/advanced-patterns/adr-self-improving-loop.md(devfloor9.github.io/engineering-playbook). 자동화 경계, 4개 데이터 게이트, 비용 가드레일, 롤백 보관 세대, 단계별 스코프 결정의 근거. ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7 ↩8 ↩9 ↩10 ↩11 ↩12 ↩13 -
Andrej Karpathy — autoresearch (2026-03), https://github.com/karpathy/autoresearch. 자율 실험 루프 프로젝트. ↩
-
Ragas Documentation, https://docs.ragas.io/. RAG 평가 지표(충실성·문맥 재현율). ↩
-
DPO: Direct Preference Optimization (NeurIPS 2023), https://arxiv.org/abs/2305.18290. 선호 쌍 기반 직접 정책 최적화. ↩
-
Engineering Playbook —
docs/aidlc/operations/autonomous-response.md(devfloor9.github.io/engineering-playbook). 사람이 의도와 가드레일을 정하고 시스템이 실행하는 운영 모델(Human-Directed, Programmatically-Executed) 참고. ↩ -
Microsoft Presidio, https://microsoft.github.io/presidio/. 개인정보 탐지·익명화 도구. ↩
-
DeepSeekMath: GRPO (2024), https://arxiv.org/abs/2402.03300. GRPO 원 설계와 KL 계수 기준. ↩
-
Michael Nygard — Documenting Architecture Decisions (2011), https://cognitect.com/blog/2011/11/15/documenting-architecture-decisions. ADR 원형 템플릿. ↩
댓글남기기