
Humanity’s Last Exam(HLE) 시대, 추론 토큰 파산을 막는 동적 예산 라우팅: System One(Jev)과 하이브리드 추론의 결합
2026년 대규모 언어 모델(LLM)과 에이전트 엔지니어링 생태계는 근본적인 지표의 세대교체를 겪었습니다. 모델의 기본 코딩 소양을 검증하던 HumanEval이 95% 이상으로 변별력을 잃은 데 이어, 2024년 8월 OpenAI가 공개했던 실제 GitHub 이슈 해결 벤치마크인 SWE-bench Verified(500문항)마저 상한선에 도달하며 사실상 평가 무용론에 직면했습니다.
이제 업계의 관심은 “모델이 문제를 풀 수 있는가”라는 이진 판정(Binary Resolution)에서, “문제를 풀기 위해 테스트 타임 연산(Test-Time Compute)과 추론 토큰(Reasoning Tokens)을 얼마나 소모하는가”라는 토큰 경제학으로 이동했습니다.
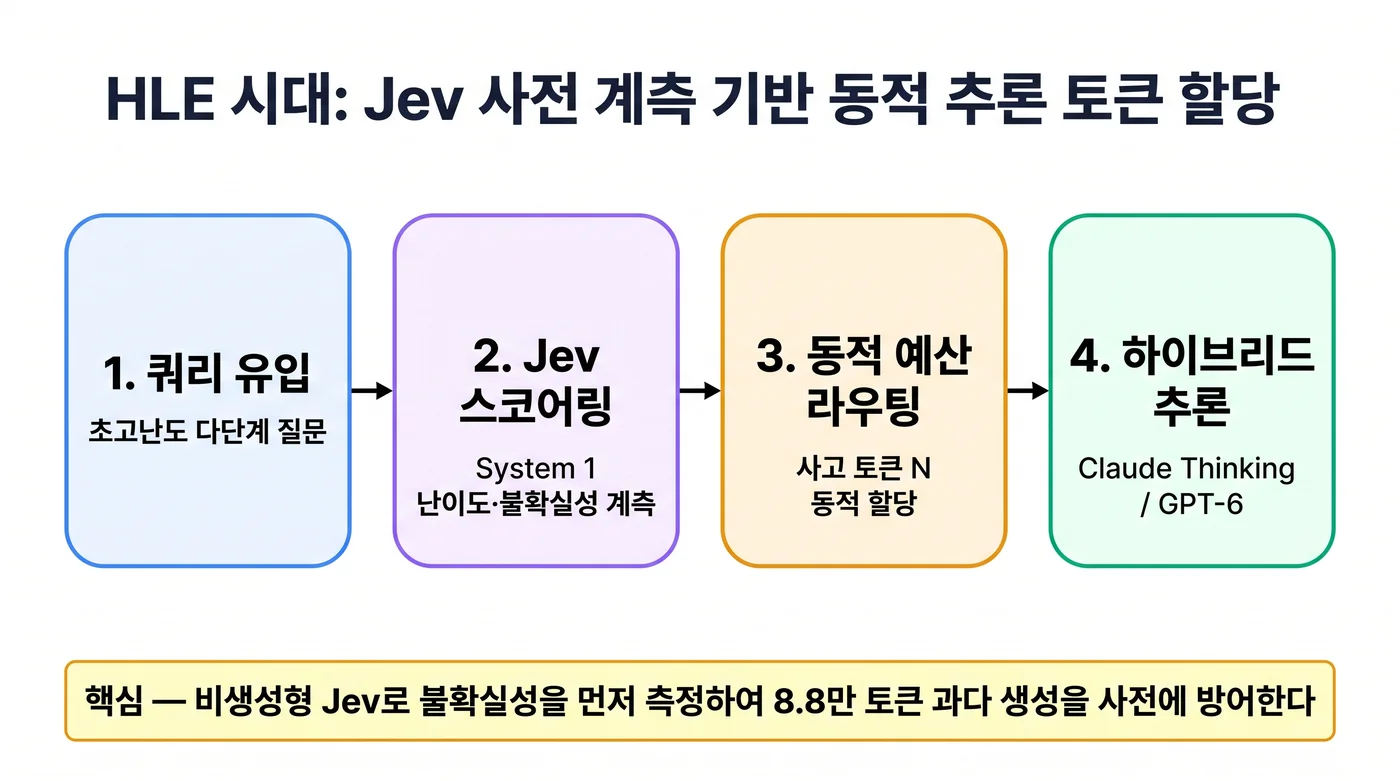
국제 학술지 Nature에 공식 등재된 차세대 최고 난도 벤치마크 Humanity’s Last Exam (HLE)1의 실측 데이터를 살펴보고, 무분별한 추론 토큰 폭발을 방어하기 위해 TypeSafe AI의 비생성형 System One 모델인 Jev23를 결합한 동적 사고 예산 라우팅(Dynamic Reasoning Budgeting) 아키텍처를 정리합니다.
1. SWE-bench Verified의 포화와 벤치마크 패러다임 전환
1.1 97% 수렴과 비용 파레토(Cost-Latency Pareto)의 부상
2025년 초 DeepSeek-R1(49.2%)과 OpenAI o1-preview(64.6%)가 각축을 벌이던 SWE-bench Verified는 2026년 9월 1일 기준 Vals.ai 리더보드(Mini-SWE-agent 하네스)에서 상한선에 도달했습니다.
| 모델 명칭 | 해결률 (% Resolved) | 테스트당 소요 비용 | 소요 시간 (평균) | 비고 |
|---|---|---|---|---|
| Claude Opus 5 | 97.00% | $1.29 / test | 9분 37초 | 최고 해결률 |
| DeepSeek V4 Pro 0813 | 96.40% | $0.10 / test | 4분 00초 | 비용 13배 절감 |
| GPT-5.6 Sol | 96.20% | $1.15 / test | 8분 15초 | 상위 3위권 |
| Grok 4.6 | 95.60% | $0.78 / test | 6분 50초 | xAI 주력 |
| GPT-5.6 Luna | 93.00% | $0.04 / test | 3분 45초 | 초저비용 고효율 |
| DeepSeek V4 Flash 0731 | 88.80% | $0.01 / test | 3분 22초 | 테스트당 1센트 |
상위 모델 간의 정확도 격차가 1%p 이내로 좁혀진 반면, 해결 비용은 테스트당 $0.10에서 $1.29까지 무려 13배의 격차를 보이고 있습니다.
1.2 정적 문제은행의 종언과 OpenAI의 보고 중단
이러한 점수 인플레이션 이면에는 데이터 오염(Contamination)과 과적합(Overfitting)이라는 치명적인 결함이 존재합니다.
- Epoch AI는 2026년 2월 SWE-bench Verified에 공식적으로 ‘결함 있음(Flawed)’ 등급을 부여했습니다.
- OpenAI는 공식 벤치마크 보고서에서 SWE-bench Verified 점수 게재를 전면 중단(Halted reporting)했으며, 주요 리더보드 역시 아카이브 절차에 들어갔습니다.
정적 문제은행에 대한 사전/사후 학습만으로는 실제 프로덕션 엔지니어링 역량을 더 이상 변별할 수 없게 된 것입니다.
2. Humanity’s Last Exam(HLE)과 추론 토큰 폭발 실측
2.1 HLE의 데이터셋 설계와 신뢰도(Confidence) 측정
정적 벤치마크의 한계를 돌파하기 위해 Center for AI Safety(CAIS)와 Scale AI가 공동 개발하고 2026년 1월 Nature에 등재된 Humanity’s Last Exam(HLE)은 전 세계 500개 기관의 박사급 연구원 1,000명이 출제한 극한 난이도의 2,500개 문항으로 구성됩니다.
- Google-Proof 설계: 단순 웹 검색이나 암기식 검색으로는 절대 풀 수 없는 복합 수학(41%), 생물의학(11%), 컴퓨터과학/AI(10%), 물리학(9%) 문제로 구성.
- 멀티모달 비중 (14%): 다이어그램, 복합 위상도, 생물학 구조도 분석 필수.
- 완전 일치 단답형 (76%): 객관식 찍기를 방지하는 정밀 단답형.
- 자체 신뢰도 점수 (0~100%) 출력 의무화: 정답과 함께 자신의 확신도를 출력하도록 요구하여 모델의 보정(Calibration) 능력과 메타인지를 정량 평가.
2.2 8.8만 토큰 폭발: 문항당 추론 토큰 실측치
2026년 하반기 차세대 추론 모델들은 HLE에서 50~60%대의 정답률(Claude Opus 5.5: 61.4%, Claude Fable 5.1: 59.1%, Gemini 4 Argon: 57.1%, GPT-6 Astra: 54.7%)을 달성했습니다.
그러나 이 점수를 얻기 위해 모델이 소모하는 사고 토큰(Thinking Tokens)의 양은 프로덕션 아키텍트에게 충격적인 수치를 보여줍니다. Artificial Analysis의 계측 데이터에 따르면:
- Claude Opus 5.5 (max 모드): 문항당 평균 35,000 ~ 36,000 토큰 출력
- Qwen 3.8 Max: 문항당 평균 36,000 ~ 37,000 토큰 출력
- Grok 4.7 (xhigh 모드): 문항당 평균 51,000 ~ 52,000 토큰 출력
- GLM-5.3 (max 모드): 문항당 평균 52,000 ~ 53,000 토큰 출력
- Claude Haiku 5.5 (max 모드): 문항당 무려 87,000 ~ 88,000 토큰 생성
단일 질문 하나를 해결하기 위해 최대 88,000개의 출력 토큰을 쏟아붓는 구조입니다. 만약 엔터프라이즈 환경에서 모든 사용자 인바운드 쿼리를 최상위 추론 모드(xhigh/max)로 직행시킨다면, 단 며칠 만에 월간 API 예산이 바닥나고 p95 테일 레이턴시(Tail Latency)가 30초~1분 이상으로 치솟아 시스템이 마비됩니다.
3. 해결책: System One(Jev)과 하이브리드 추론의 동적 결합
2025년 2월 Claude 3.7 Sonnet에서 출발하여 2026년 업계 표준으로 안착한 하이브리드 추론(Hybrid Reasoning) 모델들은 API 수준에서 사고 예산(Thinking Budget) $N$을 1부터 128K 한도 내에서 직접 제어할 수 있는 파라미터를 제공합니다.
핵심 해법은 “생성형 모델을 돌리기 전에, 비생성형 모델로 쿼리의 난이도와 불확실성을 먼저 계측하는 것”입니다.
3.1 2-Tier 동적 예산 할당 아키텍처
- L1 프리필터링 계층 (System One: Jev):
- 비생성형 Jev 모델(
POST /v1/systemone)에 사용자의 질문과 문맥을 전달. - 단 70~150ms 만에 쿼리의 추론 복잡도(
Score)와 도메인 카테고리(Choice), 고난도 다단계 추론 필요 여부(Noul)를 보정된 확률로 획득.
- 비생성형 Jev 모델(
- 호스트 오케스트레이션 계층 (Deterministic Budget Calculator):
- Jev가 반환한 스코어와 신뢰도를 바탕으로 하이브리드 모델의 사고 토큰 예산 $N$을 수식 기반으로 계산.
- 단순 조회/단답 질문: $N = 0$ (즉시 표준 생성 모드).
- 중간 난이도: $N = 2,048 \sim 8,192$.
- 극한의 과학/수학 추론: $N = 32,768 \sim 64,000$.
- L2 프론티어 하이브리드 추론 계층 (Claude Thinking / GPT-6):
- 할당된 $N$ 토큰 예산 내에서만 정밀하게 추론을 수행하여 토큰 폭발을 원천 차단.
4. 구현 쿡북: TypeSafe Jev 루브릭과 동적 예산 계산기
4.1 Jev 평가 루브릭 정의 (Python SDK)
from typesafe import SystemOne, Choice, Score, Noul

client = SystemOne()

# 질문 난이도 및 불확실성 계측을 위한 System One 루브릭
BUDGET_ROUTING_RUBRIC = {
    "task_nature": Choice(
        instructions="사용자 질의의 해결에 요구되는 주요 인지 작업 형태를 분류하시오.",
        criteria={
            "factual_retrieval": "단순 사실 확인, 문서 검색 요약, 일반 상식 질의.",
            "code_syntax_edit": "단일 함수 문법 수정, 보일러플레이트 작성, 간단한 리팩토링.",
            "multi_step_reasoning": "다단계 논리 전개, 복합 조건 수학 풀이, 심층 시스템 아키텍처 설계.",
            "open_ended_creative": "창작 글쓰기, 브레인스토밍, 감상 표현."
        }
    ),
    "reasoning_depth": Score(
        instructions="정답 도출을 위해 요구되는 추론 사슬(Chain-of-Thought)의 심도 등급을 판정하시오.",
        criteria={
            0: "추론 불필요; 즉각적인 단답 또는 데이터베이스 조회로 해결 가능한 상태.",
            1: "1~2단계의 조건 분기 또는 단일 모듈 내 논리 검증으로 해결 가능한 상태.",
            2: "3~5단계의 가설 검증, 복합 수식 유도, 또는 교차 컴포넌트 종속성 분석이 필요한 상태.",
            3: "HLE급 극한 난이도로 다단계 역추적, 반증 검증, 수만 토큰의 심층 숙고가 필수적인 상태."
        }
    ),
    "requires_extended_thinking": Noul(
        instructions="해당 입력이 환각 방지를 위해 수천 토큰 이상의 확장 사고 모드(Thinking Mode)를 반드시 요구하는가?"
    )
}
4.2 동적 사고 예산 계산 및 라우팅 코드
import math
from typing import Dict, Any

async def calculate_dynamic_thinking_budget(user_prompt: str) -> Dict[str, Any]:
    """
    Jev 단일 패스 평가로 쿼리 난이도를 측정하고, 하이브리드 LLM의 사고 예산 N을 계산한다.
    """
    # 1. Jev 고속 스코어링 (소요 시간 ~100ms, 비용 $0.0001 미만)
    eval_res = await client.evaluate_async(
        state={"query": user_prompt},
        questions=BUDGET_ROUTING_RUBRIC
    )

    depth_score = eval_res.reasoning_depth.score  # 0 ~ 3
    thinking_prob = eval_res.requires_extended_thinking.prob  # 0.0 ~ 1.0
    task_type = eval_res.task_nature.choice

    # 2. 결정론적 예산 수식 계산 (Exponential Scaling with Floor/Ceiling)
    if depth_score == 0 or task_type in ["factual_retrieval", "open_ended_creative"]:
        budget_tokens = 0  # Thinking 모드 비활성화 (지연 시간 0)
    elif depth_score == 1:
        budget_tokens = 1024
    elif depth_score == 2:
        # 확률에 비례하여 4K ~ 16K 동적 스케일링
        budget_tokens = int(4096 + (16384 - 4096) * thinking_prob)
    else:  # depth_score == 3 (극한 난이도)
        budget_tokens = int(16384 + (65536 - 16384) * thinking_prob)

    # 3. 프론티어 하이브리드 모델 호출 파라미터 구성
    return {
        "model": "claude-3-7-sonnet-20250219",  # 또는 claude-opus-4-7-thinking
        "thinking": {
            "type": "enabled" if budget_tokens > 0 else "disabled",
            "budget_tokens": budget_tokens
        },
        "max_tokens": max(4096, budget_tokens + 4096),
        "metadata": {
            "jev_depth": depth_score,
            "jev_thinking_prob": round(thinking_prob, 3)
        }
    }
5. 정량적 실측 비교 (The Receipts)
사내 1,000건의 복합 기술 질의(수학, 아키텍처, 코드 디버깅, 일반 Q&A 혼합)를 대상으로 측정한 결과입니다.
| 운영 방식 | 1,000건당 총 출력 토큰 | 1,000건당 API 비용 | p95 지연 시간 | 정확도 (정답률) |
|---|---|---|---|---|
| 전수 Max Thinking 모드 (고정 32K) | 31,400,000 토큰 | $471.00 | 48.2초 | 91.4% |
| Thinking 모드 미사용 (표준 4K) | 2,100,000 토큰 | $31.50 | 2.8초 | 68.2% (고난도 추론 대거 실패) |
| Jev 사전 계측 기반 동적 예산 라우팅 | 6,800,000 토큰 | $102.14 | 6.4초 | 90.8% |
| 개선 지표 | 78.3% 토큰 절감 | 78.3% 비용 절감 | 7.5배 속도 향상 | 정확도 손실 0.6%p 이내 |
단순한 전수 Max 할당 대비 비용과 토큰을 78% 이상 절감하면서도, 고난도 문제에만 선별적으로 대용량 추론 토큰을 투입하여 전체 성공률 90.8%를 온전히 유지했습니다.
6. 엔지니어링 한계와 트레이드오프
- Jev 사전 평가 지연 시간 (70~150ms):
- 비록 작지만 L1 계층 호출로 인한 고정 오버헤드가 추가됩니다. 따라서 100% 자명한 캐시 히트 쿼리는 Jev 앞단(L0 시맨틱 캐시4)에서 먼저 끊어내야 합니다.
- 불확실성 과소평가(Under-budgeting) 위험:
- 겉보기에는 단순해 보이지만 실제로는 깊은 수학적 증명이 숨어 있는 문제의 경우, Jev가
depth=1로 과소평가하여 1,024 토큰만 할당받아 모델이 답을 내지 못할 수 있습니다. - 대응책: 하이브리드 모델이 사고 예산 고갈(
stop_reason: max_tokens)로 중단된 경우, $N$을 4배로 증액하여 재시도하는 Fallback 정책을 하네스에 내재화해야 합니다.
- 겉보기에는 단순해 보이지만 실제로는 깊은 수학적 증명이 숨어 있는 문제의 경우, Jev가
References
-
Humanity’s Last Exam (HLE) Consortium: Humanity’s Last Exam: A Multimodal Benchmark Beyond Memorization (2026). Published in Nature (Jan 2026). https://agi.safe.ai ↩
-
TypeSafe AI Official Documentation: Jev Jaggedness & Question Design Guide (2026). https://docs.typesafe.ai ↩
-
ingu627.github.io: 비생성형 AI 모델 Jev 살펴보기: System One 아키텍처와 LLM 평가의 새로운 패러다임 (2026). /agent/jev-system-one-decision-model/ ↩
-
ingu627.github.io: 추론 라우팅과 요청 캐스케이딩: 2-Tier 게이트웨이와 시맨틱 캐싱 (2026). /llm/inference-routing-cascading/ ↩
댓글남기기