DeepSeek-V3/V4의 MLA(Multi-Head Latent Attention) 수리적 해부와 SGLang RadixAttention 서빙 최적화
이 글을 30초에 파악하기
한 줄로 — 대화 기록이 길어질수록 GPU 메모리가 먼저 차고 응답이 느려지는 문제를, 기억을 작게 압축해 저장하는 방법과 이미 읽은 앞부분을 다시 계산하지 않는 방법으로 나눠 설명한 글이다.
읽고 나면 알게 되는 것
- 긴 대화를 처리할 때 GPU 메모리에서 실제로 무엇이 차오르고, 왜 비싼 연산 장치가 놀게 되는지
- 같은 정보를 32분의 1로 줄이면서도 답변 품질을 잃지 않는다는 주장이 어떤 수식으로 뒷받침되는지
- 대화 앞부분이 겹치는 요청이 많은 서비스에서 어떤 서빙 엔진을 골라야 하는지, 그 판단 기준선이 어디인지
용어 먼저 보기
| 용어 | 한 줄 설명 | 이 글에서의 역할 |
|---|---|---|
| KV 캐시(Key-Value Cache) | 앞서 처리한 토큰들의 계산 결과를 다시 쓰지 않도록 GPU 메모리에 쌓아 두는 중간값 | 메모리를 가장 먼저 차지하는 원인 |
| MHA(멀티헤드 어텐션) | 문맥을 여러 관점에서 동시에 보는 표준 어텐션 구조 | 비교의 출발점, 메모리 사용량 상한 |
| GQA(그룹 쿼리 어텐션) | 키·값 헤드를 몇 개 그룹으로 묶어 공유해 메모리를 줄이는 절충안 | MHA 다음에 등장하는 대안, 표현력 손실의 근거 |
| MLA(Multi-Head Latent Attention) | 키·값을 작은 압축 벡터로 저장했다가 필요할 때 복원하는 방식 | 이 글의 중심 개념 |
| 저랭크 압축(Low-Rank Projection) | 큰 행렬을 더 작은 차원으로 눌러 저장하는 선형대수 기법 | KV 캐시를 576차원으로 줄이는 계산 |
| 가중치 흡수(Weight Absorption) | 고정된 두 가중치 행렬을 미리 곱해 하나로 합치는 기법 | 압축 벡터끼리 바로 어텐션 점수를 계산하는 근거 |
| RoPE(회전 위치 임베딩) | 토큰 순서 정보를 회전으로 넣는 위치 인코딩 | 흡수를 방해하는 요소, 분리 저장이 필요한 이유 |
| RadixAttention | 대화 앞부분(접두사)을 트리로 재사용하는 SGLang의 캐시 관리 방식 | 60% 이상 겹치는 워크로드에서 우위가 나는 이유 |
이런 분께 — LLM 서빙을 운영하면서 비용과 지연 시간이 왜 그렇게 나오는지 원리까지 확인하고 싶은 엔지니어. 처음 읽을 때는 1절에서 문제를 잡고, 2.4절의 압축률 숫자와 3.1절의 비교표만 먼저 봐도 엔진 선택 기준이 잡힌다.
2026년 대규모 추론 모델과 장기 실행 에이전트 워크플로우가 프로덕션의 표준으로 자리 잡았다. 서빙 인프라의 가장 치명적인 하드웨어 병목도 바뀌었다. GPU 연산 능력(FLOPs)에서 KV 캐시(Key-Value Cache) 메모리 대역폭(Memory Bandwidth)으로 완전히 전환된 것이다.
수만 토큰에 달하는 시스템 프롬프트, 도구 스키마, 다중 턴 대화 히스토리를 VRAM에 상주시키면 정작 배치 크기(Batch Size)를 늘리지 못한다. 그 결과 GPU 연산 코어가 유휴 상태(Idle)에 빠지는 메모리 바운드(Memory-bound) 현상이 발생한다.
Multi-Head Latent Attention(MLA)1은 DeepSeek-V2/V3/R1 및 최신 V4에서 도입되었다. Kimi K3, GLM-5 등 2026년 주요 오픈 가중치 프론티어 모델로 확산된 이 아키텍처는 이 병목을 수리적으로 돌파한 대표적인 어텐션 아키텍처이다. MLA의 저랭크 잠재 공간 압축과 가중치 흡수(Weight Absorption) 원리를 수식으로 증명한다. 이어서 Kubernetes 환경에서 SGLang RadixAttention과 결합해 서빙 처리량을 극대화하는 엔지니어링 전략을 정리한다.
1. KV 캐시 메모리 장벽: MHA와 GQA의 한계
1.1 표준 멀티헤드 어텐션(MHA)의 메모리 폭증
표준 멀티헤드 어텐션(MHA, Multi-Head Attention)에서 배치 크기 $B$, 시퀀스 길이 $N$, 어텐션 헤드 수 $H$, 헤드당 차원 $d_h$에 대해 레이어 하나당 저장해야 하는 KV 캐시 요소 수는 다음과 같다.
\[\text{Memory}_{\text{MHA}} = 2 \times B \times N \times H \times d_h \times \text{BytesPerElement}\]예를 들어 128개의 헤드($H=128$), 헤드 차원 128($d_h=128$), 61개 레이어를 가진 671B MoE 모델을 보자. 이 모델에서 단일 요청이 128K 컨텍스트를 소모할 경우, 요청 1건당 순수 KV 캐시 메모리만 수십 GB에 달한다.
1.2 그룹 쿼리 어텐션(GQA)의 트레이드오프
이를 완화하기 위해 Llama 3 등은 그룹 쿼리 어텐션(GQA, Grouped-Query Attention)을 채택했다. GQA는 키-값 헤드 수를 그룹 수 $G$ ($G \ll H$)로 축소하여 공유하는 방식을 취했다.
그러나 GQA는 본질적으로 정보 표현력을 희생하여 메모리를 줄이는 다운샘플링 기법이다. 따라서 에이전트 루프와 같은 고난도 문맥 추론에서 어텐션 해상도(Resolution) 저하를 피할 수 없다.
2. Multi-Head Latent Attention (MLA)의 수리적 메커니즘
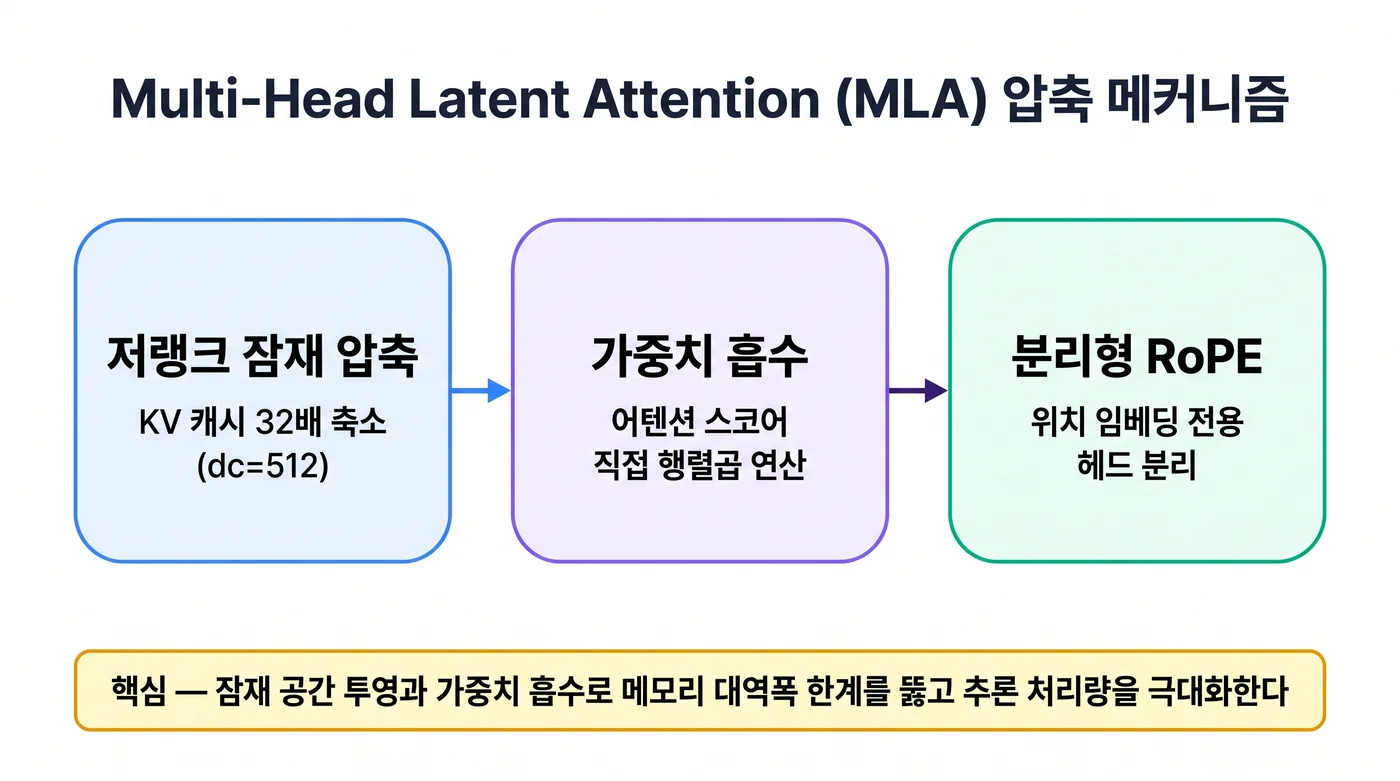
DeepSeek 팀이 고안한 MLA는 헤드 수를 억지로 줄이지 않는다. 대신 선형대수학적 저랭크 투영(Low-Rank Projection)과 가중치 흡수(Weight Absorption)를 통해 KV 캐시 상태 자체를 압축하여 저장한다.
2.1 저랭크 잠재 공간 압축 ($C_{KV}$)
입력 토큰 벡터 $X \in \mathbb{R}^{d \times n}$에 대해, MLA는 곧바로 거대한 $K, V$ 행렬을 생성하지 않는다. 대신 저랭크 다운 프로젝션 가중치 행렬 $W_{DKV} \in \mathbb{R}^{d_c \times d}$를 거쳐 압축된 잠재 벡터(Compressed Latent Vector) $C_{KV}$만을 KV 캐시에 저장한다:
\[C_{KV} = W_{DKV} X \in \mathbb{R}^{d_c \times n} \quad (\text{단, } d_c \ll 2 d_h H)\]- $d$: 모델 은닉 차원 (예: 7,168)
- $d_c$: 압축 잠재 차원 (예: $d_c = 4 d_h = 512$)
이후 복원 시점에는 두 개의 업 프로젝션 행렬 $W_{UK} \in \mathbb{R}^{d_h H \times d_c}$, $W_{UV} \in \mathbb{R}^{d_h H \times d_c}$를 통해 각각 키와 값을 복원한다:
\[K = W_{UK} C_{KV}, \quad V = W_{UV} C_{KV}\]학습 시 역전파 활성화 메모리를 줄이기 위해 쿼리(Query) 역시 동일하게 저랭크 압축을 거친다:
\[C_Q = W_{DQ} X \in \mathbb{R}^{d_q \times n}, \quad Q = W_{UQ} C_Q \in \mathbb{R}^{d_h H \times n}\]2.2 가중치 흡수 (Weight Absorption): 어텐션 스코어 직접 연산
추론 단계에서 생성 토큰마다 매번 $C_{KV}$를 거대한 $K$와 $V$로 명시적 복원한다면 상당한 행렬곱 오버헤드가 발생한다. MLA는 행렬 곱의 결합법칙(Associativity)을 활용하여 이 오버헤드를 완전히 소거한다.
어텐션 스코어 $S$의 행렬곱을 전개하면:
\[S = K^T Q = (W_{UK} C_{KV})^T (W_{UQ} C_Q) = C_{KV}^T (W_{UK}^T W_{UQ}) C_Q\]여기서 $W_{UK}^T \in \mathbb{R}^{d_c \times d_h H}$는 고정된 모델 가중치이다. $W_{UQ} \in \mathbb{R}^{d_h H \times d_q}$ 역시 사전에 고정된 모델 가중치(Static Weights)이다. 따라서 두 행렬을 사전에 곱해 흡수한 단일 가중치 행렬 $W_{KQ}$를 정의할 수 있다:
\[W_{KQ} = W_{UK}^T W_{UQ} \in \mathbb{R}^{d_c \times d_q}\]결과적으로 최종 어텐션 스코어는 거대한 $K$를 전혀 복원하지 않고, 압축 잠재 벡터 $C_{KV}$와 $C_Q$ 사이의 직접 연산으로 계산된다:
\[S = C_{KV}^T W_{KQ} C_Q\]값(Value) 연산 역시 동일하게 결합법칙을 적용한다. 어텐션 출력은 $O = V \cdot \text{Softmax}(S)$에서 $O = W_{UV} (C_{KV} \cdot \text{Softmax}(S))$로 바뀐다. 가중치 행렬이 출력단으로 흡수되기 때문이다.
2.3 분리형 RoPE (Decoupled RoPE)의 결합
그러나 여기에 치명적인 수학적 난관이 있다. 회전 위치 임베딩(RoPE, Rotary Position Embedding) 행렬 $R_m$이 키와 쿼리에 적용되면:
\[K_{\text{RoPE}} = R_m (W_{UK} C_{KV})\]위치 인덱스 $m$에 의존하는 $R_m$이 중간에 끼어들면서 $W_{UK}^T$와 $W_{UQ}$를 사전에 단일 행렬 $W_{KQ}$로 병합(가중치 흡수)할 수 없게 된다.
MLA는 이를 분리형 RoPE(Decoupled RoPE) 구조로 해결한다:
- 키와 쿼리 벡터를 콘텐츠 표현 벡터(Content Vector)와 위치 전용 벡터(Position Vector)의 두 부분으로 분리.
- 콘텐츠 벡터는 순수 저랭크 가중치 흡수를 적용하여 압축 연산 수행.
- 위치 전용 벡터는 소규모 차원($d_{h}^R = 64$)만을 별도로 할당하여 RoPE 연산을 적용한 뒤 Concat.
2.4 실측 압축률: 32배 KV 캐시 절감
DeepSeek-V3/V4는 $d_h = 128$, $H = 128$ 환경에서 $d_c = 512$를 설정했다:
\[\text{MHA 차원}: 2 \times 128 \times 128 = 32,768 \quad \longrightarrow \quad \text{MLA 차원}: 512 + 64(\text{RoPE}) = 576\]이 수리적 최적화를 통해 레이어당 저장되는 KV 캐시 크기는 표준 MHA 대비 약 32분의 1로 압축(32x Compression Ratio)되었다. 그 결과 동일 하드웨어에서 32배 큰 배치 크기와 최대 20배 빠른 추론 가속이 가능해졌다.
3. Kubernetes 서빙 최적화: vLLM vs SGLang 실측 벤치마크
이러한 MLA 아키텍처 모델(DeepSeek-V3/V4, Kimi K3, GLM-5)을 Kubernetes 환경에 배포할 때가 있다. 이때 서빙 엔진(vLLM vs SGLang)의 선택은 워크로드의 접두사 중복률(Prefix Overlap)에 따라 극명하게 갈린다.
3.1 접두사 중복률에 따른 처리량 변곡점
독립 벤치마크2(DeepSeek-R1-Distill-Llama-70B 및 DeepSeek-V3 기준) 실측 데이터는 다음과 같다.
| 워크로드 특성 | 접두사 중복률 (Overlap) | vLLM 처리량 (tok/s) | SGLang 처리량 (tok/s) | 승자 및 핵심 원인 |
|---|---|---|---|---|
| 단일 턴 고유 쿼리 (독립 프롬프트) | 0% | 60.0 tok/s | 52.7 tok/s | vLLM 우세 (단순 커널 실행 오버헤드 최소화) |
| 일반 챗봇 대화 | 30% ~ 40% | 45.2 tok/s | 46.8 tok/s | 대등 (유의미한 차이 없음) |
| 에이전트 루프 / 복합 RAG | 60% 이상 | 22.4 tok/s | 31.2 tok/s | SGLang 압승 (RadixAttention 캐시 재사용) |
| 대규모 멀티턴 에이전트 ($c=50$) | 80% | 16.0 tok/s | 30.5 tok/s | SGLang 91% 높은 처리량 유지 |
3.2 SGLang RadixAttention의 구조적 우위 원리
접두사 중복률이 60%를 넘어서는 순간 SGLang의 처리량과 TTFT가 뚜렷하게 개선된다. 그 이유는 기수 트리(Radix Tree)3 기반의 KV 캐시 관리와 캐시 인지 스케줄링(Cache-aware Scheduling) 덕분이다.
- vLLM의 한계: 고정 크기 블록(16/32 토큰) 단위 해시 체인 방식은 블록 경계가 정확히 일치하지 않으면 캐시가 누락(Fragmented)되며, 트리 분기형 대화 컨텍스트에서 탐색 오버헤드가 증가한다.
- SGLang의 Radix Trie: 문자열 단위가 아닌 토큰 시퀀스 전체를 가변 길이 기수 트리(Radix Tree)로 관리하여 LRU(Least Recently Used) 기반으로 노드를 정밀하게 보존한다.
- 실측치: 80% 접두사 공유 환경에서 SGLang은 캐시 적중률 92%를 달성하여, vLLM 대비 p50 TTFT를 37%, p95 TTFT를 41% 단축(에이전트 다중 턴에서는 최대 82% 단축)했다. 고동시성 부하에서 vLLM이 16 tok/s로 급락할 때도 SGLang은 30 tok/s 이상을 일정하게 방어했다.
4. 프로덕션 배포 아키텍처: L7 프리픽스 라우터와 K8s 배포
MLA 모델을 프로덕션 Kubernetes에 서빙할 때는 별도 라우팅이 필요하다. 인그레스(Ingress) 계층의 프리픽스 인지 라우팅(Prefix-Aware Routing)4이 결합되어야 한다.
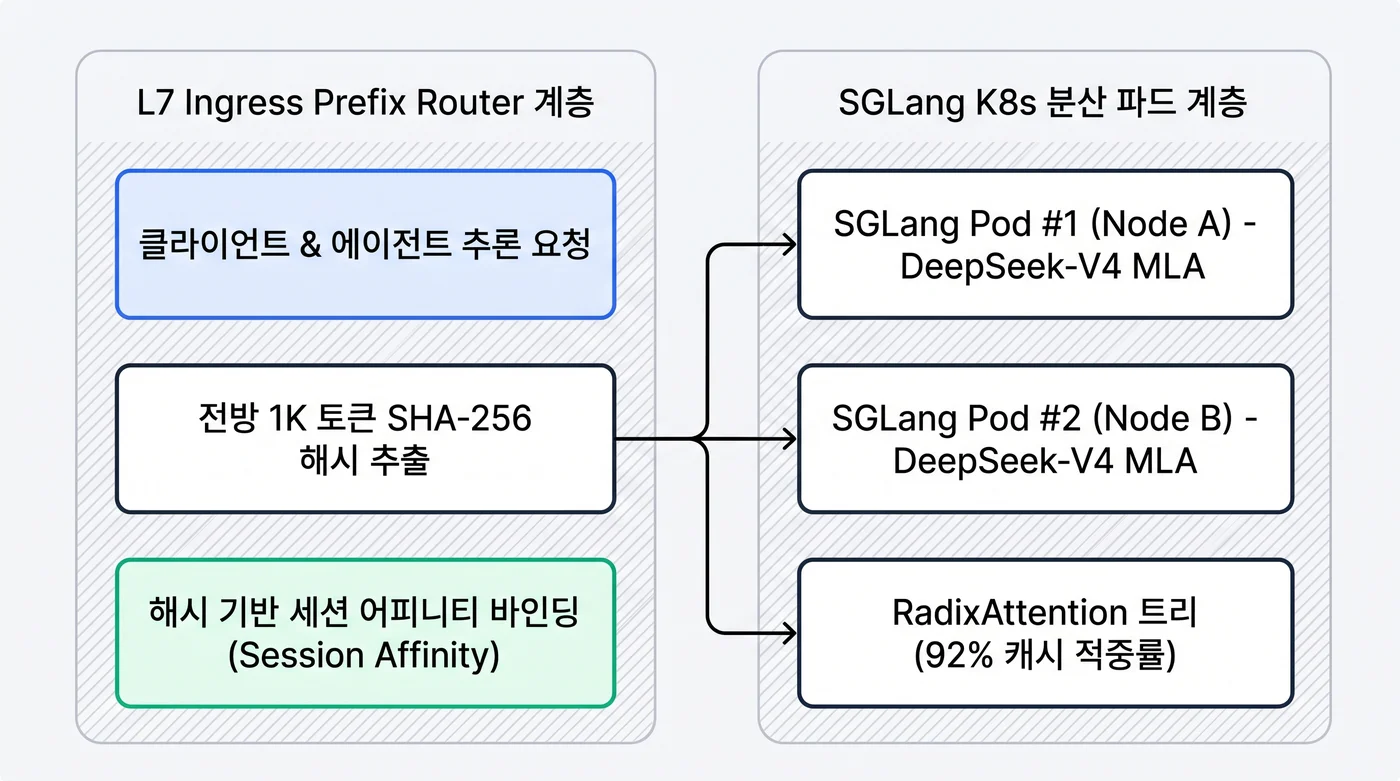
동일한 에이전트 세션이나 공통 시스템 프롬프트를 공유하는 요청이 서로 다른 파드(Pod)로 분산되면 Radix 캐시가 파편화된다. 그렇기 때문에 인그레스에서 요청의 상위 1,000 토큰 해시값을 기준으로 동일 파드에 트래픽을 바인딩하는 것이 필수적이다.
4.1 SGLang 프로덕션 K8s 배포 명세 예시
아래 매니페스트는 GPU 8장을 한 파드에 묶어 DeepSeek-V3를 올리고, Radix 캐시와 최장 접두사 우선 스케줄링을 켠 최소 예시다.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: sglang-deepseek-mla
  namespace: llm-serving
spec:
  replicas: 4
  template:
    spec:
      containers:
      - name: sglang-server
        image: lmsysorg/sglang:v0.4.3-cu124
        command:
        - python3
        - -m
        - sglang.launch_server
        - --model-path
        - deepseek-ai/DeepSeek-V3
        - --host
        - "0.0.0.0"
        - --port
        - "30000"
        - --tp
        - "8"
        - --enable-radix-cache
        - --mem-fraction-static
        - "0.88"
        - --schedule-policy
        - "lpm"  # Longest Prefix Match 우선 스케줄링
        resources:
          limits:
            nvidia.com/gpu: 8
5. 엔지니어링 결론 및 엔진 선택 기준
- 에이전트 루프 및 다중 턴 서빙에는 SGLang이 기본 표준:
- 접두사 공유율이 높은 대화형 코딩 에이전트, 복합 툴 호출, RAG 워크플로우에서는 SGLang RadixAttention이 p95 레이턴시와 VRAM 효율에서 실측 기준 뚜렷한 우위를 기록한다 (p95 TTFT 최대 41% 단축, 고동시성 처리량 30 tok/s 이상 유지).
- 단일 턴 배치 및 특수 하드웨어에는 vLLM:
- 접두사 중복이 없는 독립형 대량 배치 작업, NVIDIA Blackwell(B200) 아키텍처 조기 적용, 혹은 AWS Trainium이나 Google TPU와 같은 비-NVIDIA 가속기 환경에서는 생태계 호환성이 검증된 vLLM을 선택해야 한다.
References
-
DeepSeek-AI: DeepSeek-V3 Technical Report: Multi-Head Latent Attention and DualPipe Architecture (2025). arXiv:2412.19437 ↩
-
ingu627.github.io: Kubernetes 환경에서 초저지연 LLM 서빙: vLLM vs SGLang 접두사 캐싱 아키텍처와 처리량 심층 비교 (2026). /llm/k8s/k8s-low-latency-llm-serving-vllm-sglang/ ↩
-
LMSYS Organization: SGLang: Efficient Execution of Structured Language Model Programs with RadixAttention (2024). arXiv:2312.07104 ↩
-
ingu627.github.io: 추론 라우팅과 요청 캐스케이딩: 2-Tier 게이트웨이와 시맨틱 캐싱 (2026). /llm/inference-routing-cascading/ ↩
댓글남기기