
비생성형 AI 모델 Jev 살펴보기: System One 아키텍처와 LLM 평가의 새로운 패러다임
프로덕션 환경에서 AI 에이전트와 LLM 파이프라인을 운영하다 보면 구조적인 비효율을 마주하게 됩니다. 사용자의 프롬프트가 가드레일 정책을 준수했는지 확인하는 참/거짓 판정, 사전에 정의된 도구(Tool) 중 어떤 것을 실행할지 결정하는 인텐트 분류, 혹은 RAG 파이프라인이 생성한 응답의 충실도를 검증하는 평가 작업까지—우리는 고작 단답형 결정을 얻기 위해 수십~수천억 개 파라미터를 가진 거대 언어 모델이 토큰을 한 글자씩 순차적으로 찍어내길 기다리곤 합니다.
심리학자 대니얼 카너먼(Daniel Kahneman)은 인간의 사고 체계를 즉각적이고 직관적인 ‘시스템 1(System 1)’과 신중하고 논리적인 ‘시스템 2(System 2)’로 구분했다. 현재의 LLM 애플리케이션 아키텍처는 가벼운 직관적 판정 영역에도 가장 무거운 시스템 2(자기회귀 토큰 생성)를 그대로 투입하고 있는 셈이다.
전 OpenAI 연구원 디오고 알메이다(Diogo Almeida)가 설립한 TypeSafe AI에서 공개한 Jev는 이 지점을 겨냥한 특수 목적 모델이다. Jev는 텍스트를 생성하지 않는 비생성형(Non-generative) System One AI 모델로, 자연어 상태(State)와 타입화된 질문을 입력받아 보정된 확률 분포(Calibrated Probabilities)와 타입 지정 결과를 단일 패스(Single-pass)로 반환한다. 사내 에이전트 워크플로우와 평가 파이프라인을 점검하면서 관련 논문12과 기술 아티클34을 분석하고, 실무 적용 관점에서 얻은 시사점을 정리해보았다.
1. 생성형의 피로와 ‘System One’의 필요성
1.1 자기회귀 텍스트 생성의 구조적 한계
기존 생성형 LLM(Autoregressive Model)을 라우터, 가드레일, 심판(LLM-as-a-Judge)으로 활용할 때 겪는 엔지니어링 병목은 명확하다.
- 토큰 길이에 비례하는 지연 시간(Latency): 단답형 판정을 원하더라도 프롬프트 템플릿, CoT(Chain-of-Thought), 장황한 서술 텍스트를 디코딩하는 과정에서 네트워크와 연산 지연이 누적된다.
- 스키마 무결성 후처리 오버헤드:
{"verdict": true}형태의 JSON 출력을 요청하더라도 마크다운 백틱 감싸기나 전후 부가 설명이 섞일 위험이 있어, 안정적인 파싱을 위해 정규식 후처리나 재시도(Retry) 로직이 요구된다. - 과금 구조의 비효율: 출력 토큰 단가는 입력 토큰보다 비싸다. 대규모 단위 테스트나 배치 트레이스를 전수 평가할 때 비용 누적의 주원인이 된다.
- 생성 텍스트 기반의 사후 해석: 결정 신뢰도를 모델 내부의 로짓(Logit)이나 보정 확률로 직접 얻기 어렵고, 생성된 텍스트의 뉘앙스를 사후 해석해야 한다.
1.2 자연어를 입력받는 비생성형 판정 모델
Jev는 생성형 토큰 디코더 대신, 자연어 상태(State)와 타입화된 질문(Typed Question)을 단일 패스로 처리하여 결과를 산출하는 방식을 취한다. TypeSafe 공식 문서5에서는 이를 ‘전통적 소프트웨어(규칙 기반)’와 ‘자율 LLM 에이전트(생성 루프)’를 잇는 제3의 아키텍처인 AI 지원 소프트웨어(AI-Powered Software)로 정의한다.
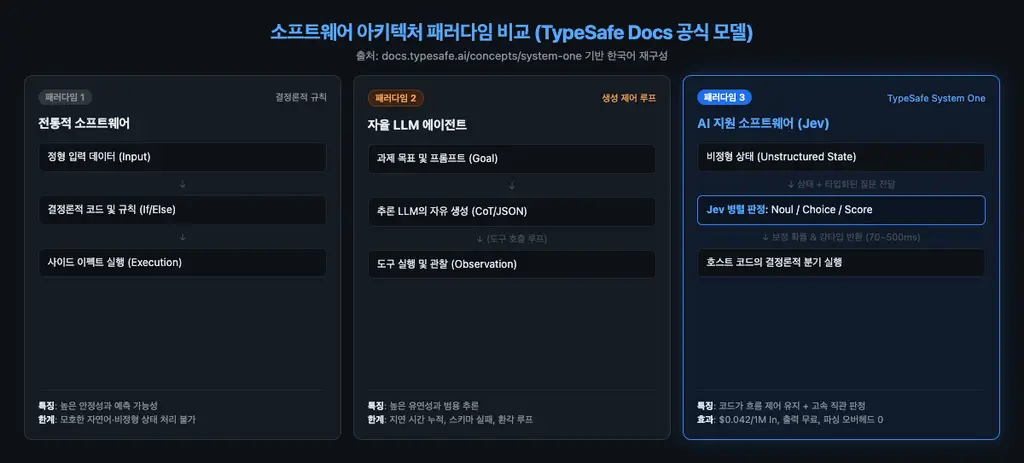
모든 제어권을 비결정론적 생성 모델에 넘기는 대신, 호스트 애플리케이션 코드가 상태와 실행 흐름을 통제하고 직관적 판정만 Jev에 병렬 위임하는 접근이다. 최근 엔지니어링 현장에서 복잡한 생성형 루프 속 정형 의사결정 구간을 Jev 같은 모델로 치환하는 패턴을 일명 ‘Jev화(jevify)’로 부르기도 한다. 이는 공식 제품명이 아니라, 생성 모델의 과도한 사용을 걷어내고 결정론적 라우팅 계층으로 전환하려는 실무적 설계 관용구에 가깝다.
2. Jev의 내부 메커니즘과 3대 결정 프리미티브
2.1 RLCD: 집계 차원의 보정 확률 학습
Jev의 핵심 기술적 축은 보정 강화학습(RLCD, Reinforcement Learning for Calibrated Decisions)이다1. 일반적인 거대 언어 모델은 오답을 낼 때도 높은 확신을 표명하는 ‘과신(Overconfidence)’ 경향을 자주 보인다.
RLCD는 모델이 산출하는 확률값($0.0 \sim 1.0$)이 대규모 집계(Aggregate) 차원에서 실제 통계적 참(Empirical likelihood)의 빈도와 일치하도록 최적화한다. 단일 케이스 하나에 대해 절대적인 진위를 보장하는 것은 아니지만, 전체 예측 집합에서 “0.80의 확률로 참”이라고 판정한 데이터군을 모았을 때 실제로 약 80%가 참이 되도록 통계적 정밀도를 맞추는 원리다. 이 보정된 확률 분포를 활용하면 임계값(Threshold) 기반의 조건부 라우팅을 구성할 수 있다.
여기서 주의할 점은 낮은 분산(Low Variance)이나 타입 안정성이 판정의 무오류성(Correctness)을 뜻하지는 않는다는 사실이다. Jev의 응답 스키마가 깨지지 않고 반복 실행 시 일관된 확률을 낸다고 해서, 모델의 판정 자체가 항상 참인 것은 아니다. 타입 안정성은 파싱 실패를 없애줄 뿐이며, 분류 정확도는 여전히 도메인 데이터셋 검증을 거쳐야 한다.
2.2 3가지 타입화된 질문 (Question Primitives)
Jev API는 세 가지 질문 프리미티브를 제공한다3. 모든 응답은 별도의 텍스트 파싱 과정 없이 API 수준에서 구조화된 형태로 전달된다.
1. Noul (Boolean)
   - 질문: "해당 입력에 시스템 명령어 주입 시도가 포함되어 있는가?"
   - 반환: boolean 값 및 조건 충족에 대한 보정 확률 (0.0 ~ 1.0)

2. Choice
   - 질문: "사용자 요청의 목적은 [문서_검색, 요약, 번역, 오류_문의] 중 무엇인가?"
   - 반환: 선택된 카테고리 라벨 + 각 후보별 확률 분포 + 결정 신뢰도(Confidence)

3. Score
   - 질문: "제공된 레퍼런스 대비 생성된 답변의 충실도를 정해진 루브릭 척도로 평가하시오."
   - 반환: 척도 등급 및 구간별 확률 분포
2.3 벤더 공시 스펙과 엔지니어링 프로필
TypeSafe AI가 공시한 Jev의 성능 및 비용 프로필은 다음과 같다1.
| 항목 | TypeSafe AI 공시 스펙 | 엔지니어링 의미 |
|---|---|---|
| 응답 지연 시간 | 70 ~ 500 ms (단일 패스) | 토큰 생성 루프 없이 빠른 상태 전이 지원 |
| 입력 토큰 비용 | $0.042 / 1M 토큰 | 프론티어 생성 모델 대비 현저히 낮은 단가 |
| 출력 토큰 비용 | $0 (출력 과금 없음) | 비생성형 모델 특성상 출력 토큰 과금 미발생 |
| 인터페이스 무결성 | API 수준 강타입 구조체 반환 | 정규식 기반 JSON 파싱 오류 원천 배제 |
실제 평가 비용은 입력 토큰 수 × 단가 공식에 수렴한다. 예를 들어 LangChain의 벤치마크 실험4에서는 평가 1건당 평균 0.44초 소요, 약 $0.00035의 비용이 측정되었다. 이는 약 8,000 토큰 수준의 평가 문맥을 전제로 한 수치이며, 문맥 길이에 따라 전체 비용이 결정된다.
3. 실무 아키텍처: REFLEX 선택적 제어와 배치 평가
3.1 REFLEX 프레임워크와 선택적 제어 실측치
Jev를 에이전트 시스템에 실질적으로 적용한 대표적인 연구는 REFLEX (Selective Control in LLM Agents)이다2. 이 연구에서는 복잡한 과제를 수행하는 에이전트가 매 단계마다 무거운 프론티어 LLM을 직접 호출하는 대신, Jev를 전진 배치하여 가벼운 제어를 우선 시도하는 구조를 설계했다.
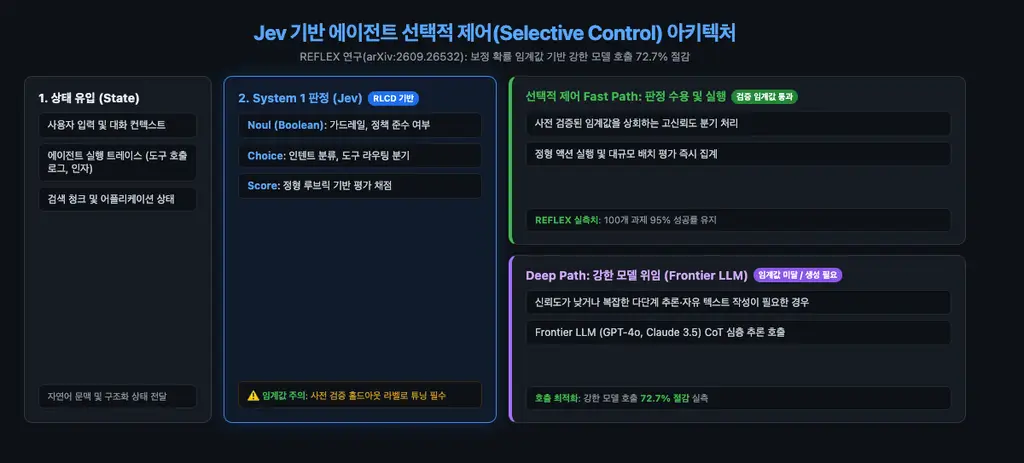
논문에서 100개 에이전트 과제를 대상으로 측정한 결과는 주목할 만하다.
- 성공률 유지: 기준선인 95% 성공률을 그대로 유지했다.
- 강한 모델 호출 절감: 복잡하고 값비싼 프론티어 모델 호출 횟수를 72.7% 감소시켰다.
즉, 에이전트가 수행하는 다단계 액션 중 상당수는 굳이 수백B 파라미터의 추론 능력을 필요로 하지 않으며, 보정 확률 임계값을 넘는 정형 판정은 경량 System One 모델로 안전하게 흡수할 수 있음을 보여준다.
3.2 LLM-as-a-Judge 대규모 배치 평가
CI/CD 파이프라인에서 에이전트 프롬프트나 RAG 청킹 전략을 변경할 때 수천 건의 골든 테스트셋을 검증해야 한다. 기존 생성형 LLM을 평가자(Judge)로 쓰면 막대한 비용과 긴 파이프라인 대기 시간이 소요되지만, 비생성형 판정 모델을 도입하면 출력 토큰 비용 없이 대량의 트레이스를 고속으로 채점할 수 있다.
4. 트레이드오프와 도입 시 주의사항
4.1 CoT 부재와 시뮬레이션 과제의 한계
Jev는 빠른 직관 모델인 만큼, 생성형 모델이 가진 강점을 대체하지 못하는 뚜렷한 한계가 존재한다.
- 추론 설명력(Explainability)의 부재: Jev는 토큰을 생성하지 않으므로 결론에 도달한 사고 과정(Chain-of-Thought)이나 자연어 해설을 내놓지 않는다. 오판이 발생했을 때 엔지니어는 입력 상태(State)와 확률 분포 로그를 기반으로 원인을 분석해야 한다.
- 평가(Evaluation) vs 시뮬레이션(Simulation): 텍스트에 드러난 근거를 직접 대조해 사실 여부를 판정하는 ‘평가’ 과제에는 강하지만, 다단계 수읽기나 미래 상태를 마음속으로 시뮬레이션해야 하는 과제에서는 생성형 모델의 심층 추론을 따라가지 못한다.
4.2 운영자가 반드시 알아야 할 위험 요소
실무 적용 시 간과하기 쉬운 두 가지 위험 요소를 주의해야 한다3.
- 임계값(Threshold) 튜닝의 필수성: Jev가 제공하는 신뢰도 수치를 임의의 상수로 고정(예: 무조건 0.8 이상이면 실행)해서는 안 된다. 도메인별 데이터 특성에 맞춰, 사전에 레이블링된 독립된 홀드아웃(Held-out) 데이터셋에서 정밀도(Precision)와 재현율(Recall) 곡선을 확인한 뒤 임계값을 보정해야 한다.
- 미검증 보안 게이트의 유도 가능성(Steerability): 안전 가드레일로 Jev를 단독 배치할 경우, 정교하게 우회된 프롬프트 주입(Prompt Injection)에 대해 확률 판정이 왜곡될 위험이 있다. 보안이 핵심인 관문에서는 정적 룰 필터나 심층 검증 레이어를 함께 병용하는 다층 방어가 필수적이다.
4.3 도입 판단 기준
| 시나리오 | 권장 접근 | 판단 근거 |
|---|---|---|
| 에이전트 상태 머신의 정형 라우팅 | Jev 우선 (Fast Path) | 홀드아웃 검증 임계값 통과 시 빠른 전이 지원 |
| CI/CD 대량 트레이스 루브릭 채점 | Jev 우선 | 출력 토큰 비용 배제 및 스키마 안정성 확보 |
| 프롬프트 주입 및 심층 보안 차단 | 하이브리드 다층 방어 | Jev 단독 게이트의 우회(Steerable) 위험 대비 |
| 비정형 문서 작성 및 최종 대화 생성 | Frontier LLM (System 2) | 자연스러운 문맥 생성 및 창작 필요 |
| 복잡한 다단계 논리 시뮬레이션 | Frontier LLM (System 2) | Chain-of-Thought 심층 추론 필수 |
5. 마치며: 분업화되는 에이전트 인프라
모든 문제를 하나의 거대한 단일 모델(Monolithic LLM)로 해결하려던 초기 에이전트 아키텍처는 점차 세분화된 분업 체계로 성숙하고 있다.
Jev와 같은 비생성형 System One 모델의 의의는 “모든 생성 모델을 대체하는 것”이 아니라, “생성 모델이 하지 않아도 될 일을 정확히 걷어내는 것”에 있다. 신뢰도 보정에 기반한 선택적 제어(Selective Control)를 통해 빠른 판단과 깊은 추론의 역할을 분리할 때, 비로소 프로덕션 수준의 비용 효율성과 반응 속도를 함께 달성할 수 있다.
References
-
TypeSafe AI. (2026). Introducing System One Models and Jev. typesafe.ai/blog/introducing-system-one-models-and-jev ↩ ↩2 ↩3
-
arXiv. (2026). REFLEX with Jev for Efficient Selective Control in LLM Agents. arXiv preprint arXiv:2609.26532. ↩ ↩2
-
HoneyHive. (2026). How to Use TypeSafe AI’s Jev as an LLM Judge. honeyhive.ai/blog/how-to-use-typesafe-ais-jev-as-an-llm-judge ↩ ↩2 ↩3
-
LangChain Blog. (2026). Jev Agent Evals in LangSmith. langchain.com/blog/jev-agent-evals-langsmith ↩ ↩2
-
TypeSafe AI Docs. (2026). Concepts: System One Architecture and Software Paradigms. docs.typesafe.ai/concepts/system-one ↩
댓글남기기