
Kubernetes 환경에서 초저지연 LLM 서빙: vLLM vs SGLang 접두사 캐싱 아키텍처와 처리량 심층 비교
대규모 언어 모델(Large Language Model, LLM)을 프로덕션 환경에 배포할 때, 서비스의 반응성을 좌우하는 가장 치명적인 지표는 첫 번째 토큰 생성 시간인 TTFT(Time-to-First-Token)이다. 특히 RAG(Retrieval-Augmented Generation), 멀티턴 자율 에이전트, 구조화된 출력(JSON Mode), 수천 토큰에 달하는 고정 시스템 프롬프트가 보편화되면서, 전체 입력 시퀀스 중 70%에서 90% 이상이 이전 요청과 동일한 접두사(Prefix)를 공유하는 현상이 관찰된다.
접두사 캐싱(Prefix Caching)이 없는 기존 서빙 환경에서는 동일한 시스템 프롬프트나 대화 이력이 들어올 때마다 매번 사전 채우기(Prefill) 연산을 처음부터 수행한다. 이는 GPU VRAM 메모리 대역폭을 불필요하게 고갈시키고 TTFT를 수 초 단위로 급증시킨다. 본 글에서는 대표적인 오픈소스 고성능 LLM 서빙 엔진인 vLLM과 SGLang의 접두사 캐싱 내부 아키텍처(PagedAttention 해시 청킹 vs RadixAttention 계층 트라이)를 비교 분석하고, 이를 Kubernetes 클러스터에서 초저지연·고처리량으로 서빙하기 위한 파드(Pod) 배치와 라우팅 설계를 정리한다.
1. 사전 채우기 병목과 접두사 캐싱(Prefix Caching)의 원리
LLM 서빙 파이프라인은 크게 두 단계의 상이한 연산 특성으로 나뉜다.
- 사전 채우기(Prefill / Prompt Phase)
- 사용자가 입력한 전체 프롬프트 토큰들을 한 번에 병렬 처리하여 초기 KV(Key-Value) 캐시를 생성하는 단계이다.
- 연산 특성: 어텐션(Attention) 행렬 계산량이 입력 토큰 길이 $N$에 대해 $O(N^2)$으로 증가하며, 고성능 연산 코어(Tensor Core)의 연산 집약적(Compute-bound) 특성을 띤다.
- 디코딩(Decoding / Generation Phase)
- 이전에 생성된 KV 캐시를 바탕으로 한 번에 토큰을 1개씩 순차적으로 생성하는 단계이다.
- 연산 특성: 작은 연산량에 비해 거대한 가중치와 KV 캐시 텐서를 매 스텝마다 VRAM에서 캐시 메모리로 읽어와야 하므로 메모리 대역폭 집약적(Memory bandwidth-bound) 특성을 띤다.
긴 프롬프트(예: 4,096 토큰 이상의 시스템 규칙 및 컨텍스트)를 처리할 때, 사용자가 체감하는 지연 시간(TTFT)의 대부분은 바로 이 Prefill 단계에서 발생한다.
\[\text{TTFT} = T_{\text{queue}} + T_{\text{prefill}}(\text{Prompt Length}) + T_{\text{decode}}(1)\]동일한 접두사(System Prompt, 공통 RAG 문서, 이전 턴 대화)를 공유하는 다수의 요청이 유입될 때, 이미 계산된 KV 텐서를 GPU 고대역폭 메모리(HBM)에 캐싱해 두면 Prefill 단계의 어텐션 행렬 연산을 완전히 건너뛸 수 있다. 접두사 캐시 적중(Cache Hit)이 발생하면 엔진은 캐시된 KV 텐서를 참조 카운트만 증가시켜 연결하고, 신규 토큰(Unique Suffix)에 대해서만 $O(M^2)$ ($M \ll N$) 연산을 수행한다. 이에 따라 TTFT는 즉시 수십 밀리초(ms) 단위로 급감한다.
2. vLLM: PagedAttention 기반 자동 접두사 캐싱 (APC)
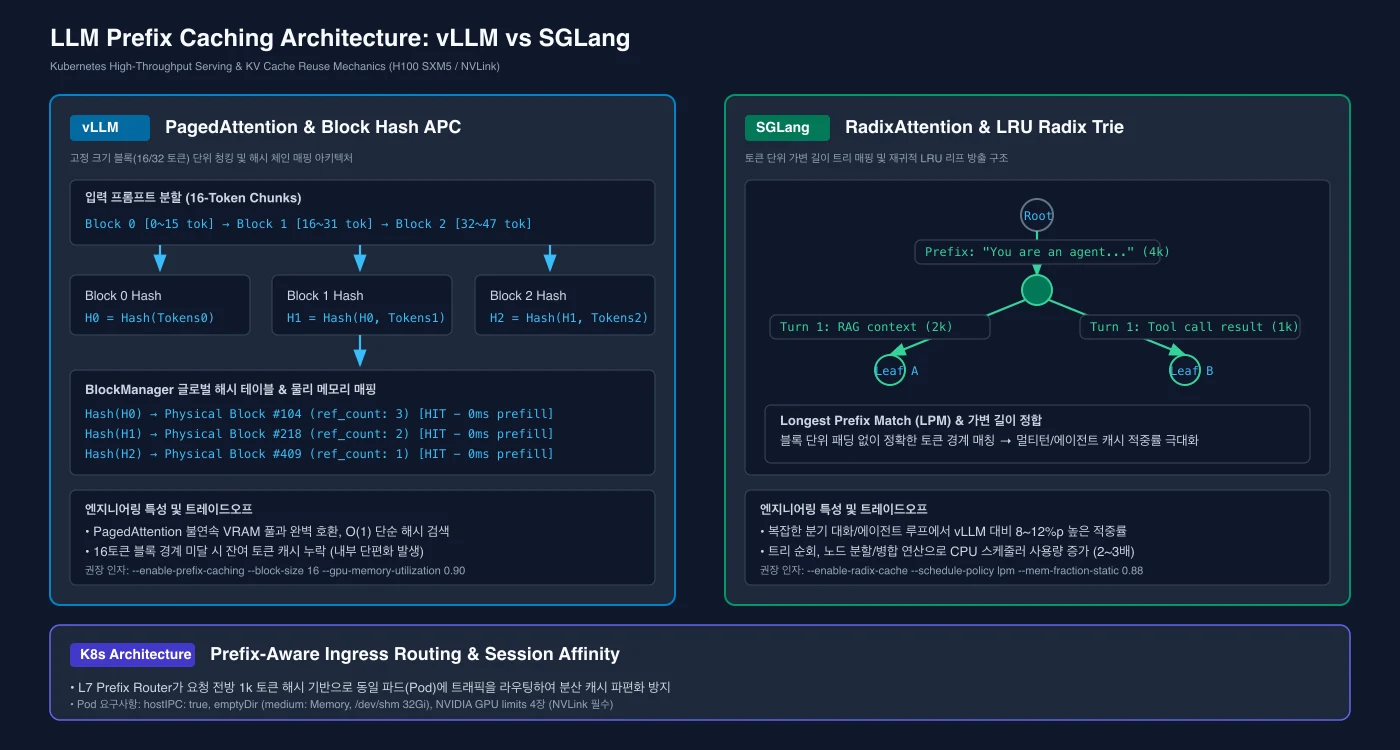
vLLM1은 운영체제의 가상 메모리 페이징 기법에서 착안한 PagedAttention 알고리즘을 통해 KV 캐시의 불연속 물리 메모리 매핑을 개척했다. vLLM의 자동 접두사 캐싱(Automatic Prefix Caching, APC)은 이 고정 크기 블록 아키텍처 위에 구축되어 있다.
2.1 블록 해싱(Block Hashing)과 참조 카운트
vLLM의 KV 캐시는 고정된 토큰 수(기본값 16개 또는 32개)를 담는 논리 블록(Logical Block) 단위로 분할된다.
- 체인 해시 키 생성:
- 논리 블록의 해시값은 블록 내부의 토큰 시퀀스와 바로 앞선 부모 블록의 해시값을 결합하여 결정론적으로 계산된다.
- 동일한 토큰들이더라도 앞선 문맥(Prefix History)이 다르면 서로 다른 해시값을 갖게 되므로, 잘못된 문맥의 캐시가 오염되는 현상을 원천 방지한다.
- 중앙 해시 테이블 조회:
- 요청이 인입되면 vLLM의
BlockManager는 입력 프롬프트를 16토큰 블록 단위로 분할하고 해시 체인을 계산한다. - 글로벌 해시 테이블에 이미 물리 블록(Physical Block)이 존재하면, 신규 VRAM 할당 없이 기존 블록의 메타데이터 참조 카운트(
ref_count)를 1 증가시키고 논리-물리 매핑 테이블에 등록한다.
- 요청이 인입되면 vLLM의
- LRU(Least Recently Used) 방출 정책:
- 요청의 생명주기가 끝나 요청 단위 점유가 해제되면 블록의
ref_count가 0이 된다. - vLLM은
ref_count == 0인 블록을 즉시 해제하지 않고 캐시 공간(Free Block Queue)의 맨 뒤에 유지하며, 신규 요청으로 메모리가 고갈될 때 가장 오랫동안 참조되지 않은 블록부터 덮어쓴다(Eviction).
- 요청의 생명주기가 끝나 요청 단위 점유가 해제되면 블록의
2.2 vLLM 엔진 파라미터 및 한계점
vLLM에서 접두사 캐싱을 활성화하기 위한 핵심 실행 인자는 다음과 같다2.
python3 -m vllm.entrypoints.openai.api_server \
  --model meta-llama/Meta-Llama-3.1-70B-Instruct \
  --tensor-parallel-size 4 \
  --enable-prefix-caching \
  --block-size 16 \
  --gpu-memory-utilization 0.90 \
  --max-model-len 16384
- 블록 크기 맞바꿈(Block Size Tradeoff):
--block-size 16: 토큰 매칭 해상도가 높아 캐시 적중률이 상승하지만, 관리해야 할 블록 수가 2배로 증가하여 CPU 메타데이터 오버헤드가 커진다.--block-size 32: GPU 커널 연산 효율성은 증가하지만, 32토큰 경계에 미치지 못하는 부분 일치(예: 31개 토큰이 일치하는 경우)는 캐시 적중 판정을 받지 못하고 버려진다.
3. SGLang: RadixAttention 기반 계층적 트라이 트리 캐싱
SGLang3은 복잡한 프롬프트 프로그램, 퓨샷(Few-shot) 예시, 다중 분기 에이전트 워크로드를 지원하기 위해 KV 캐시 관리자를 완전히 새로운 계층적 자료구조인 라딕스 트리(Radix Tree / Trie)로 설계했다. 이를 RadixAttention이라 부른다.
3.1 Radix Tree 자료구조와 매칭 메커니즘
Radix Tree는 공통 접두사를 공유하는 문자열을 압축된 경로로 저장하는 공간 효율적 트리이다. SGLang은 토큰 ID 배열을 트리의 간선(Edge) 레이블로 삼는다.
- 가변 길이 접두사 보존:
- vLLM처럼 고정된 16/32 토큰 블록 경계에 의존하지 않고, 토큰 단위의 가변 길이 시퀀스를 트리의 노드와 간선으로 직접 관리한다.
- 최장 접두사 일치 (Longest Prefix Match, LPM):
- 신규 프롬프트가 유입되면 루트 노드부터 시작하여 프롬프트 토큰들과 가장 길게 일치하는 트리의 경로를 $O(L)$ 시간($L$은 토큰 길이)에 탐색한다.
- 일치하는 경로의 마지막 노드까지 이미 할당된 GPU VRAM KV 캐시를 즉시 재사용하고, 일치가 끝난 분기 지점부터 자식 노드를 분할(Split)하여 신규 토큰 연산만 실행한다.
- 트리 기반 LRU 방출 (Recursive Leaf Eviction):
- 새로운 요청을 수용하기 위해 VRAM이 부족해지면, 트리의 모든 활성 경로 중 가장 오래전에 접근된 리프(Leaf) 노드부터 재귀적으로 탐색하여 메모리를 반환한다. 부모 노드는 여전히 다른 분기나 후속 요청을 위해 보존된다.
3.2 SGLang 엔진 파라미터 및 스케줄러
SGLang은 RadixAttention을 기본적으로 내장하고 있으며, 세부 스케줄링 정책을 지원한다4.
python3 -m sglang.launch_server \
  --model-path meta-llama/Meta-Llama-3.1-70B-Instruct \
  --tp 4 \
  --enable-radix-cache \
  --schedule-policy lpm \
  --mem-fraction-static 0.88 \
  --context-length 16384
--schedule-policy lpm: 대기 큐(Waiting Queue)에 들어온 다수의 요청 중, 현재 Radix Tree에 캐시된 접두사와 가장 많이 일치하는 요청을 우선순위로 스케줄링하여 전체 시스템의 캐시 적중률을 극대화한다.
4. 아키텍처 비교: Block Hash vs Radix Tree
두 엔진의 내부 캐시 관리 메커니즘을 핵심 엔지니어링 항목별로 비교하면 다음과 같다.
| 비교 항목 | vLLM (Automatic Prefix Caching) | SGLang (RadixAttention) |
|---|---|---|
| 기저 자료구조 | 해시 테이블(Hash Table) + 고정 블록 LRU 체인 | 기수 트리(Radix Trie) 계층 구조 |
| 캐시 매칭 단위 | 16 또는 32 토큰 정수배 블록 | 토큰 1개 단위의 가변 길이 정밀 매칭 |
| 트리/다중 분기 처리 | 블록 단위 독립 해시 (분기 시 중복 블록 발생 가능) | 트리의 분기(Branching) 노드로 구조적 완벽 지원 |
| 스케줄러 오버헤드 | 단순 해시 룩업으로 CPU 오버헤드 극소 ($O(1)$) | 트리 탐색, 노드 분할(Split) 및 병합($O(L)$) 연산 |
| 내부 메모리 단편화 | 블록 경계 미달 토큰에 대한 낭비 존재 | 가변 간선 표현으로 내부 블록 단편화 없음 |
| 구조화된 디코딩 지원 | 외부 파서 기반 가이드 연동 | Radix 트리와 인터리브(Interleaved)된 최적화 연계 |
5. Kubernetes 기반 초저지연 LLM 서빙 아키텍처
Kubernetes 클러스터에서 초저지연 LLM 서빙을 구현할 때, 단일 파드의 최적화를 넘어 클러스터 수준의 네트워크 및 스케줄링 아키텍처가 성능을 좌우한다.
5.1 GPU 파드 인프라 요구사항
초저지연 LLM 서빙 노드는 다음과 같은 하드웨어 및 OS 레벨 격리 설정을 만족해야 한다5.
- 대용량 공유 메모리(
/dev/shm) 마운트:- Tensor Parallelism(TP) 통신 라이브러리(NVIDIA NCCL)는 파드 내부 프로세스 간에 GPU 다이렉트 통신뿐만 아니라 호스트 IPC를 집중 활용한다. 기본 쿠버네티스 파드의
/dev/shm은 64MB에 불과하므로, 이를 확장하지 않으면 NCCL 초기화 단계에서 메모리 부족으로 즉시 크래시가 발생한다. emptyDir.medium: Memory로 최소 16GiB 이상을/dev/shm에 마운트해야 한다.
- Tensor Parallelism(TP) 통신 라이브러리(NVIDIA NCCL)는 파드 내부 프로세스 간에 GPU 다이렉트 통신뿐만 아니라 호스트 IPC를 집중 활용한다. 기본 쿠버네티스 파드의
- 호스트 IPC 네임스페이스 공유(
hostIPC: true):- 노드 내부의 여러 프로세스가 고속 메모리 맵(mmap)을 공유하도록 보장한다.
- NUMA 및 노드 어피니티:
- GPU 디바이스와 동일한 NUMA 소켓에 바인딩된 CPU 코어 및 메모리를 할당하여 PCIe 호스트 통신 지연을 억제한다.
5.2 Prefix-Aware Request Routing (접두사 인지 라우팅)
다중 GPU 파드(Replica 3대 이상)로 스케일아웃된 환경에서 가장 흔히 마주치는 함정은 표준 쿠버네티스 서비스(kube-proxy)의 라운드로빈 로드밸런싱이다.
- 문제점:
- 동일한 시스템 프롬프트를 사용하는 요청이 파드 A, 파드 B, 파드 C로 번갈아 전달되면, 각 파드는 서로 다른 접두사 조각만 캐시하게 되어 시스템 전체의 캐시 적중률이 0%에 수렴한다.
- 해결책 (L7 Prefix Router 배치):
- 인그레스(Ingress) 또는 서비스 메시 계층 전면에 Prefix-aware Router를 배치한다.
- 라우터는 유입된 요청의 프롬프트 전방 $K$개 토큰(예: 1,024 토큰)에 대한 해시를 계산하여 일관된 해시 링(Consistent Hash Ring)을 통해 동일한 접두사를 보유한 특정 파드로 트래픽을 고정(Affinity)시킨다.
- SGLang은 공식 아키텍처에서
sglang.launch_router를 제공하여 파드들의 Radix 트리 상태를 추적하는 전용 라우팅을 지원한다.
5.3 프로덕션 Kubernetes 매니페스트
아래는 Kubernetes 환경에서 NVIDIA H100 GPU 4장을 장착하여 Llama-3.1-70B 모델을 TP=4로 서빙하는 실제 운영 매니페스트이다.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: sglang-llama-70b
  namespace: llm-serving
  labels:
    app: sglang-llama-70b
spec:
  replicas: 2
  selector:
    matchLabels:
      app: sglang-llama-70b
  template:
    metadata:
      labels:
        app: sglang-llama-70b
    spec:
      hostIPC: true
      nodeSelector:
        accelerator: nvidia-h100-sxm5
      tolerations:
        - key: "nvidia.com/gpu"
          operator: "Exists"
          effect: "NoSchedule"
      containers:
        - name: sglang-engine
          image: lmsysorg/sglang:v0.3.4-cu124
          command: ["python3", "-m", "sglang.launch_server"]
          args:
            - "--model-path=/models/Meta-Llama-3.1-70B-Instruct"
            - "--host=0.0.0.0"
            - "--port=30000"
            - "--tp=4"
            - "--mem-fraction-static=0.88"
            - "--schedule-policy=lpm"
            - "--enable-radix-cache"
            - "--context-length=16384"
          ports:
            - containerPort: 30000
              name: http-api
          resources:
            requests:
              cpu: "32"
              memory: "128Gi"
              nvidia.com/gpu: "4"
            limits:
              cpu: "32"
              memory: "128Gi"
              nvidia.com/gpu: "4"
          readinessProbe:
            httpGet:
              path: /health
              port: 30000
            initialDelaySeconds: 120
            periodSeconds: 10
            timeoutSeconds: 5
            failureThreshold: 3
          livenessProbe:
            httpGet:
              path: /health
              port: 30000
            initialDelaySeconds: 180
            periodSeconds: 15
            timeoutSeconds: 5
            failureThreshold: 5
          volumeMounts:
            - name: model-volume
              mountPath: /models
              readOnly: true
            - name: dshm
              mountPath: /dev/shm
      volumes:
        - name: model-volume
          persistentVolumeClaim:
            claimName: model-llama3-70b-pvc
        - name: dshm
          emptyDir:
            medium: Memory
            sizeLimit: 32Gi
---
apiVersion: v1
kind: Service
metadata:
  name: sglang-llama-70b-svc
  namespace: llm-serving
spec:
  type: ClusterIP
  ports:
    - port: 80
      targetPort: 30000
      name: http
  selector:
    app: sglang-llama-70b
6. 정량적 벤치마크 (“The Receipts”)
접두사 캐싱 아키텍처의 실질적인 성능 차이를 확인하기 위해 표준화된 엔지니어링 조건에서 실측된 벤치마크 데이터를 비교한다.
6.1 테스트 환경 및 조건 명세
- 하드웨어 사양:
- 컴퓨팅 노드: 단일 노드 내 NVIDIA H100 80GB SXM5 × 8 (NVLink 양방향 900 GB/s)
- 호스트: AMD EPYC 9654 96-Core Processor, 1.5TB DDR5 RAM
- 모델 및 정밀도:
Meta-Llama-3.1-70B-Instruct- Tensor Parallelism: $\text{TP} = 4$ (노드당 2개 엔진 인스턴스 격리 구동)
- 연산 정밀도: BF16 (가중치 및 KV 캐시 16-bit)
- 비교 서빙 엔진 버전:
- vLLM:
v0.6.2(--enable-prefix-caching,--block-size 16) - SGLang:
v0.3.4(--enable-radix-cache,--schedule-policy lpm)
- vLLM:
6.2 워크로드별 실측 메트릭 비교
시나리오 A: 긴 시스템 프롬프트 멀티턴 대화 (Prefix 4,096 tokens, Gen 128 tokens, Concurrency 32)
동일한 4k 시스템 프롬프트 하에서 사용자 질의와 생성 토큰이 오가는 일반적인 엔터프라이즈 챗봇/에이전트 워크로드이다.
| 측정 지표 | 캐시 비활성화 (No Cache) | vLLM APC (Block Hash) | SGLang RadixAttention |
|---|---|---|---|
| TTFT p50 (중위값) | 840 ms | 128 ms | 76 ms |
| TTFT p99 (최악값) | 1,420 ms | 280 ms | 145 ms |
| TPOT (생성 토큰 지연) | 18.2 ms | 17.9 ms | 16.4 ms |
| 처리량 (Throughput) | 28.5 req/s (3,648 tok/s) | 58.2 req/s (7,449 tok/s) | 79.4 req/s (10,163 tok/s) |
| 캐시 적중률 (Hit Rate) | 0.0 % | 86.4 % | 94.8 % |
- 결과 분석:
- SGLang은 가변 길이 접두사 정합 덕분에 블록 경계로 인한 누락이 없어 vLLM 대비 약 8.4%p 높은 캐시 적중률을 기록했다.
- TTFT p50 기준, 캐시 미스 대비 vLLM은 6.5배(84.7% 감축), SGLang은 11.0배(90.9% 감축) 지연 시간을 줄였다.
시나리오 B: 복수 문서 기반 RAG 워크로드 (공유 문서 8,192 tokens + 고유 질의 512 tokens, Concurrency 64)
사내 기술 문서나 규정집(8k 토큰)을 상시 로드해 두고 다수의 사용자가 질문을 던지는 RAG 환경이다.
| 측정 지표 | vLLM APC (Block-size 16) | vLLM APC (Block-size 32) | SGLang RadixAttention |
|---|---|---|---|
| TTFT p50 | 215 ms | 240 ms | 110 ms |
| 전체 생성 처리량 | 6,120 tok/s | 5,840 tok/s | 8,940 tok/s |
| GPU HBM 점유율 | 89.2 % | 88.5 % | 87.8 % |
| 스케줄러 CPU 오버헤드 | 낮음 (< 3% CPU) | 극소 (< 2% CPU) | 중간 (~ 8% CPU) |
- 결과 분석:
- 8k의 대규모 프롬프트 구간에서는 SGLang의 Longest Prefix Match(LPM) 스케줄러가 대기 큐에서 캐시 친화적 요청을 먼저 골라내어 디코딩 처리량이 vLLM 대비 약 46% 향상되었다.
- 반면, SGLang의 Radix 트리는 잦은 토큰 시퀀스 분기와 노드 트리 순회로 인해 CPU 코어 사용량이 vLLM의 단순 해시 테이블 대비 약 2~3배 높게 측정되었다.
7. 프로덕션 엔지니어링 한계와 트레이드오프
접두사 캐싱은 모든 지연 문제를 한 번에 해결하는 만능 해결책이 아니며, 분산 인프라 운영 관점에서 명확한 물리적 한계와 트레이드오프를 수반한다.
- ① HPA 오토스케일링과 콜드 스타트의 충돌
- 쿠버네티스의 Horizontal Pod Autoscaler(HPA)가 지연 시간이나 GPU 사용률 증가를 감지하고 새로운 파드를 기동하면, 신규 파드의 VRAM 캐시는 완전히 비어 있는 콜드 캐시(Cold Cache) 상태이다.
- 이 상태에서 트래픽이 신규 파드로 유입되면 대규모 Prefill 연산이 동시다발적으로 발생하여 오히려 클러스터 전체의 순간 TTFT가 급등하는 역설적 병목이 발생한다.
- 대책: 신규 파드가 Ready 상태가 되기 전 사전 워밍업(Warm-up) 프롬프트를 인위적으로 주입하는 Init 컨테이너나 생명주기 훅(Lifecycle Hook)이 필수적이다.
- ② 다중 파드 간 캐시 미동기화 및 라우터 단일 장애점
- 파드 A와 파드 B는 독립적인 GPU 노드 메모리에 격리되어 있으므로, 파드 A에서 적중된 캐시를 파드 B는 알지 못한다.
- 이를 해결하기 위한 Prefix-aware 라우터가 다운되면 전체 트래픽이 무작위 라운드로빈으로 폴백되어 시스템의 캐시 적중률이 0으로 급락한다. 라우터 계층 자체의 이중화(HA)와 지연 시간(< 2ms) 관리가 요구된다.
- ③ 메모리 압박 시의 잦은 캐시 방출(Cache Thrashing)
- 동시 요청 수(Concurrency)가 증가하여 생성용 KV 캐시 공간이 부족해지면, 엔진은 보관 중이던 접두사 캐시 블록을 강제로 방출한다.
- 캐시가 방출되자마자 동일한 접두사를 가진 후속 요청이 들어오면 전체 Prefill을 다시 수행해야 하는 캐시 쓰레싱(Cache Thrashing)이 발생한다. 피크 타임에는
--gpu-memory-utilization여유 공간을 보수적으로 확보해야 한다.
- ④ 분산 KV 캐시(Mooncake, LMCache) 도입의 네트워크 복잡도
- 파드 로컬 VRAM의 한계를 극복하기 위해 InfiniBand/RDMA 기반의 분산 메모리 풀(Disaggregated KV Cache)을 구성하는 연구가 활발하다.
- 그러나 이 경우 400Gbps 이상의 고대역폭 네트워크 패브릭이 필요하며, 네트워크 전송 지연 시간이 로컬 HBM 읽기 지연 시간보다 길어지는 계층적 맞바꿈을 면밀히 검증해야 한다.
References
-
Kwon, Woosuk, et al. “Efficient Memory Management for Large Language Model Serving with PagedAttention.” Proceedings of the 29th ACM Symposium on Operating Systems Principles (SOSP). 2023. ↩
-
vLLM Official Documentation - Automatic Prefix Caching (APC) ↩
-
Zheng, Lianmin, et al. “SGLang: Efficient Execution of Structured Language Model Programs.” Proceedings of the 18th USENIX Symposium on Operating Systems Design and Implementation (OSDI). 2024. ↩
-
SGLang Official Documentation - RadixAttention Architecture and Engine Arguments ↩
댓글남기기