
Jev API 계약 딥다이브: Choice·Score·Noul 프리미티브와 질문 엔지니어링
앞선 글에서 비생성형 System One 모델 Jev의 거시적인 아키텍처와 에이전트 선택적 제어(Selective Control) 흐름을 살펴보았습니다. 이번 글에서는 엔지니어가 실제로 코드를 작성하고 시스템을 연동할 때 마주하는 구체적인 인터페이스 계약(API Contract)을 다루어보려 합니다.
TypeSafe AI의 Jev는 텍스트를 자유 생성하지 않는 대신, 사전에 정의된 엄격한 스키마 규격을 통해 상태(State)를 평가합니다. 공식 API 엔드포인트인 POST /v1/systemone과 공식 SDK(typesafe-sdk)는 세 가지 핵심 프리미티브인 Choice, Score, Noul을 제공합니다. 공식 문서123에 명시된 관찰 가능한 API 스펙, 신뢰도(Confidence) 계산식, 그리고 질문 엔지니어링 규칙을 바탕으로 실무 설계 원칙을 정리해보았습니다.
1. System One API 엔드포인트와 요청 계약
1.1 입력 계약: 상태(State)와 질문(Questions)의 분리
Jev API의 가장 중요한 설계 원칙은 “평가 대상인 상태 데이터”와 “판단 규칙인 질문 정의”를 물리적으로 분리하는 것이다.
{
  "model": "jev-latest",
  "state": "고객 주문 번호: #8921\n문의 내용: 배송된 신발 사이즈가 잘못 왔습니다. 금요일 마라톤 대회 전까지 교환해주세요.",
  "questions": {
    "department": { "type": "choice", ... },
    "urgency": { "type": "score", ... },
    "is_exchange": { "type": "noul", ... }
  }
}
state(string 또는 JSON object): 판단 대상이 되는 비정형 텍스트, 대화 이력, RAG 검색 문서, 에이전트 트레이스 등 원본 사실 데이터다.questions(Record<string, QuestionSpec>): 각각 고유 식별자(ID)를 가진 질문 객체들의 맵이다.
단일 HTTP 요청에 여러 질문을 묶어 전달하면, 개별 질문에 대한 판정 결과가 단일 응답 객체(answers)에 담겨 함께 반환된다. 각 질문은 상호 독립적으로 평가되며 대화 컨텍스트가 오염되지 않는다.
1.2 과금 및 사용량 지표
TypeSafe AI의 공시 과금 정책은 입력 토큰 기준($0.042 / 1M input tokens)이다1. 실제 API 응답의 usage 필드를 살펴보면 출력 토큰 카운트(output_tokens)가 집계되어 반환되지만, 생성형 모델과 달리 출력 토큰은 과금되지 않는다(Unbilled).
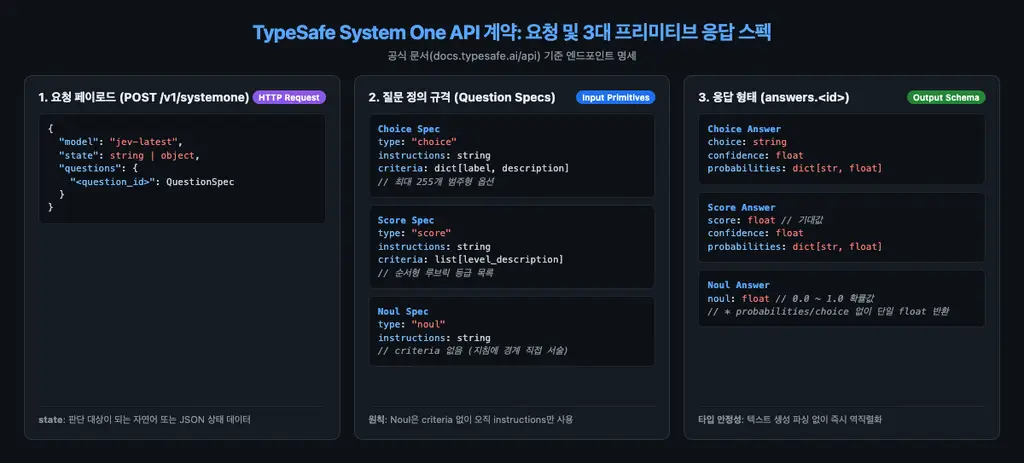
2. 3대 프리미티브 스키마와 응답 형태
공식 문서에 명시된 세 프리미티브는 용도와 반환 형태가 명확히 구분된다.
2.1 Choice: 범주형 라벨 분류
사전에 정의된 고정 선택지 중 가장 적합한 라벨 하나를 선택한다 (최대 255개 옵션 지원)4.
- 요청 스펙:
instructions: 분류 작업 지침 문자열criteria: 각 선택지 라벨과 그 설명을 담은 딕셔너리 (dict[str, str])
- 응답 스키마 (
answers.<id>):choice: 선택된 라벨 문자열 (예:"returns")confidence: 결정 신뢰도 부동소수점 (0.0 ~ 1.0)probabilities: 전체 후보 라벨별 확률 분포 (dict[str, float])
각 선택지의 criteria 설명이 명확할수록 경계 케이스(Boundary case)의 분류 정밀도가 높아진다. 라벨 명칭 자체로 의미가 자명한 경우(예: tone: {"calm": null, "angry": null})는 criteria 값을 null로 둘 수 있다.
2.2 Score: 순서형 루브릭 등급 평가
불연속적인 정수 등급이 아니라, 정해진 루브릭 척도 상에서의 위치를 실수 형태로 측정한다5.
- 요청 스펙:
instructions: 채점 지침 문자열criteria: 등급 인덱스(0, 1, 2, …) 순서대로 나열된 설명 리스트 (list[str])
- 응답 스키마 (
answers.<id>):score: 기대값(Expected Value) 실수 (예:1.88)confidence: 신뢰도 부동소수점 (0.0 ~ 1.0)probabilities: 등급 인덱스별 확률 맵 ({"0": 0.00, "1": 0.12, "2": 0.88})
반환되는 score가 단순한 최고 확률 인덱스(정수)가 아니라 확률 가중 기대값(float)으로 산출되므로, 모니터링 시스템이나 게이트 로직에서 완만한 연속형 수치로 추세를 추적할 수 있다.
2.3 Noul: 이진(Boolean) 조건 검증
특정 조건의 충족 여부를 참/거짓 확률로 평가한다6.
- 요청 스펙:
instructions: 참/거짓 판단을 요구하는 질의 문자열 (예:"고객이 교환이나 환불을 명시적으로 요구하는가?")- (Noul은 criteria, options, levels 필드가 전혀 없으며, 참/거짓 판정 경계는 모두 instructions 지침 문자열 내에 서술한다)
- 응답 스키마 (
answers.<id>):noul: 조건이 참일 확률을 나타내는 단일 부동소수점 값 (0.0 ~ 1.0)
Choice나 Score와 달리 Noul은 criteria 필드나 probabilities 딕셔너리, choice 문자열이 존재하지 않는다. 오직 단일 instructions만 받아 noul 부동소수점 확률값 하나만 직접 반환한다는 점이 인터페이스 상의 핵심 차이다.
3. 기술 원리: 확률(Probability)과 신뢰도(Confidence)의 공식 계산식
공식 문서(Confidence and Probabilities)3는 probabilities와 confidence의 시맨틱 차이를 엄격히 규정한다.
- 확률(
probabilities): “어떤 결과가 얼마나 일어날 법한가(Which outcome and how likely)”를 나타낸다. - 신뢰도(
confidence): “선택된 결정에 얼마나 확신을 가질 수 있는가(How decisive/trustworthy is the decision)”를 나타낸다.
최상위 확률($p_{\max}$)이 존재하더라도 후보군 간 확률 차이가 적으면 신뢰도는 낮게 측정된다. 이때 자동화 시스템은 결정을 단독 집행하지 않고 기권(Abstain)하거나 검토 단계로 넘겨야 한다.
3.1 Choice 프리미티브의 신뢰도 공식
Choice 프리미티브의 신뢰도는 균등 분포 대비 최상위 확률의 초과량을 정규화하여 산출한다3.
\[\text{confidence} = \frac{p_{\max} - \frac{1}{n}}{1 - \frac{1}{n}}\]여기서 $n$은 선택지 개수이며, $p_{\max}$는 가장 높은 확률값이다.
- 모든 선택지의 확률이 $1/n$으로 동일한 완전 불확실 상태에서는 분자가 0이 되어 0.0이 된다.
- 단일 선택지에 확률 1.0이 몰리면 1.0이 된다.
- 선택지가 2개일 때 $p_{\max} = 0.60$이라면 $\frac{0.60 - 0.50}{1 - 0.50} = 0.20$으로 낮은 신뢰도가 반환된다.
3.2 Score와 Noul의 신뢰도 특성
- Score: 최빈 등급(modal level)으로부터의 확률 가중 거리를 균등 분포의 평균 절대 편차(Uniform MAD)로 정규화하여 산출한다. 기대값이 특정 등급에 날카롭게 수렴할수록 높은 신뢰도를 보인다.
-
Noul: 별도의 confidence 필드를 반환하지 않는다. Noul은 오직 조건이 참일 확률 $p$ 하나만 반환한다. 만약 로컬 코드에서 대칭적 확신 거리가 필요하다면 애플리케이션 수준에서 $ 2p - 1 $ 형태로 변환해 활용할 수 있다.
중요한 제약: 이 신뢰도 수치는 모델 내부 확률 분포의 ‘결정적 분극성(Decisiveness)’을 요약한 통계량일 뿐이며, 현실에서의 ‘절대적 정답(Correctness)’을 보장하지 않는다. 따라서 도메인 검증셋을 통한 평가가 병행되어야 한다.
4. Jev 1.13 Jaggedness에서 추린 질문 설계 4원칙
공식 문서(Jev 1.13 Jaggedness)2는 모델의 9가지 버전별 실패 모드를 분석하고 있다. 이 중 실무 질문 작성에 가장 유용한 4가지 핵심 원칙을 추리면 다음과 같다.
4.1 Snap Judgments (원자적 직관 판정으로 분해)
System One 모델은 빠른 상식적 평가에 최적화되어 있다. 다단계 추론이나 문제 해결 전략 수립을 하나의 질문에 요구하면 실패한다.
- 적합:
"이 메시지에 마감 기한이 명시되어 있는가?" - 부적합:
"이 메시지를 분석하여 최적의 비즈니스 대응 계획을 세우시오."
4.2 Missing Context Rule (누락된 맥락의 법칙)
모델은 작성자의 암묵적 의도가 아니라 문자 그대로(Literal Reading) 질문을 해석한다. 오판이 발생했을 때 엔지니어가 “내가 실제로 의도했던 건 이런 조건이었다”라고 변명하는 그 해설이 바로 질문 지침에 빠져 있던 누락된 지침이다.
4.3 Situational Rubrics for Score (상황 기술형 척도)
Score 프리미티브의 등급 기준은 각 레벨이 독립적으로 평가된다. 따라서 상대적인 정도를 나타내는 표현은 작동하지 않는다.
- 적합:
Level 2: "기능 장애가 발생했으나 우회 경로(Workaround)가 존재하는 상태" - 부적합:
Level 2: "다소 심각함",Level 3: "Level 2보다 더 심각함"
4.4 State와 Question의 분리 유지
배경 맥락이나 가변적인 데이터는 모두 state에만 넣고, questions의 지침과 기준에는 오직 고정된 판정 규칙만 작성해야 캐싱 및 재사용성이 유지된다.
5. Python SDK 실전 구현과 CJK·버전 고정 주의점
공식 Python SDK(typesafe-sdk)를 사용하면 타입화된 응답 객체를 다룰 수 있다.
from typesafe_sdk import TypeSafeClient, Choice, Score, Noul

# 프로덕션에서는 임계값 무효화를 방지하기 위해 특정 버전(예: jev-1.13.0)을 명시 권장
with TypeSafeClient() as client:
    response = client.system_one(
        state=(
            "주문 ID: #4092\n"
            "고객: 신발 밑창이 뜯어져서 왔습니다. 내일 모레 출국인데 당장 교환해주세요!"
        ),
        questions={
            "department": Choice(
                instructions="어느 부서에서 처리해야 하는가?",
                criteria={
                    "exchange": "물품 하자, 교환, 환불 관련 접수",
                    "delivery": "배송 지연, 택배사 문의",
                    "general": "일반 상품 문의",
                },
            ),
            "urgency": Score(
                instructions="문의의 긴급도를 평가하시오.",
                criteria=[
                    "긴급하지 않음 - 일반 일정",
                    "보통 - 통상적 처리 기한 내 대응",
                    "매우 긴급 - 48시간 이내 특정 마감일 존재",
                ],
            ),
            "defect_confirmed": Noul(
                instructions="고객이 제품의 파손 또는 불량을 언급했는가?",
            ),
        },
    )

    # 1. Choice 접근 (response.choices)
    dept = response.choices["department"]
    print(f"부서: {dept.choice} (신뢰도: {dept.confidence})")
    print(f"라벨별 확률: {dept.probabilities}")

    # 2. Score 접근 (response.scores)
    urgency = response.scores["urgency"]
    print(f"긴급도 기대값 점수: {urgency.score} (신뢰도: {urgency.confidence})")

    # 3. Noul 접근 (response.nouls)
    defect = response.nouls["defect_confirmed"]
    print(f"불량 언급 확률: {defect.noul}")

    # 4. 검증된 신뢰도(Confidence) 임계값 기반 제어 분기
    # ※ 0.80은 예시값이며, 실무에서는 독립 홀드아웃 검증셋에서 보정한 임계값을 적용해야 한다.
    CONFIDENCE_THRESHOLD = 0.80
    if dept.confidence >= CONFIDENCE_THRESHOLD and defect.noul >= 0.80:
        print(f"고신뢰도 자동 라우팅 실행: {dept.choice}")
    else:
        print("신뢰도 미달: 담당자 검토 또는 Frontier LLM으로 에스컬레이션")
프로덕션 도입 시 2대 운영 주의사항
- 한국어(CJK) 성능 벤치마크 필수: 공식 모델 문서에 따르면 Jev의 주 학습 언어는 영어(English)다. 한국어 텍스트 입력도 지원하지만 언어별 확률 보정 품질이 다를 수 있으므로, 반드시 사내 한국어 데이터셋에서 신뢰도와 정확도를 측정해야 한다.
- 모델 버전 고정(Version Pinning):
jev-latest별칭은 상위 체크포인트 갱신 시 확률 분포가 미세하게 변할 수 있다. 보정된 임계값이 틀어지는 것을 방지하려면jev-1.13.0처럼 구체적인 버전 태그를 고정해 운영하는 것이 안전하다.
6. 마치며
Jev의 세 가지 프리미티브는 단순한 기능 확장이 아니라, 비생성형 의사결정 모델을 소프트웨어 엔지니어링 표준에 맞게 규격화한 결과물이다.
- Choice는 모호한 의도를 고정된 상태 머신 분기로 매핑하고,
- Score는 주관적 품질을 모니터링 가능한 연속형 기대값으로 정량화하며,
- Noul은 조건부 실행을 위한 참/거짓 확률 신호를 제공한다.
불필요한 텍스트 생성과 JSON 정규식 파싱을 걷어내고, 명확한 API 계약에 기반한 직관 판정 레이어를 구축하는 것이 안정적인 에이전트 아키텍처의 핵심 출발점이다.
References
-
TypeSafe AI. (2026). API Reference: POST /v1/systemone. docs.typesafe.ai/api ↩ ↩2
-
TypeSafe AI. (2026). Model Jaggedness & Question Design. docs.typesafe.ai/model-jaggedness/jev-1.13 ↩ ↩2
-
TypeSafe AI Docs. (2026). Confidence and Probabilities. docs.typesafe.ai/confidence ↩ ↩2 ↩3
-
TypeSafe AI Docs. (2026). Primitives: Choice. docs.typesafe.ai/primitives/choice ↩
-
TypeSafe AI Docs. (2026). Primitives: Score. docs.typesafe.ai/primitives/score ↩
-
TypeSafe AI Docs. (2026). Primitives: Noul. docs.typesafe.ai/primitives/noul ↩
댓글남기기