
클라우드 비용 최적화(FinOps): 단위 경제학과 예약 전략
이 시리즈는 쿠버네티스와 클라우드(AWS·GCP·Azure 공통 개념)를 실무 관점에서 정리한 기록이다. 핵심 개념·코드 예제·실전 함정(gotcha) 중심으로, 학습과 설계 리뷰·장애 대응에 바로 쓸 수 있게 구성했다. 각 편은 독립적으로 읽을 수 있고, 순서대로 보면 클러스터 내부 구조에서 클라우드 운영까지 하나의 흐름으로 이어진다.
이번 편에서는 클라우드 보안과 거버넌스에서 세운 계정·정책 경계 위에서 비용을 다루는 방법을 정리한다. FinOps 재단(FinOps Foundation)이 정의한 Inform·Optimize·Operate 순환을 축으로, 태깅과 쇼백으로 비용을 보이게 만드는 단계, RI·Compute SP·CUD·스팟을 섞어 단가를 낮추는 단계, 그리고 단위 경제성(unit economics)을 리뷰 루틴에 넣어 지속 가능하게 만드는 단계를 코드와 함께 살펴본다. 비용은 대개 아키텍처 결정의 그림자이므로, 단위 경제성을 측정 루프에 넣는 순간 최적화 대상은 자동으로 드러난다. 다음 편인 클라우드 아키텍처 패턴과 재해 복구(DR)에서 RTO/RPO 기준의 이중화 설계와 그 비용 트레이드오프를 이어서 다룬다.
- FinOps 3단계(Inform / Optimize / Operate)의 순환 구조와 핵심 원칙을 세운다
- 태깅·비용 탐색·예산 알람·쇼백으로 비용 가시성을 확보하는 방법을 확인한다
- RI·Compute SP·CUD·스팟의 할인율과 커버리지 규칙을 비교한다
- VPA·bin packing·Karpenter로 쿠버네티스 비용을 줄이는 실전 설정을 정리한다
- egress·NAT·스토리지 함정과 단위 경제성 리뷰 루틴, 실무 체크리스트를 챙긴다
1. FinOps 3단계: Inform / Optimize / Operate
클라우드 비용 최적화는 “쓴 뒤에 줄이는” 사후 작업이 아니라 수요·용량·단가를 지속적으로 정렬하는 운영 체계다. FinOps는 재무(Finance)·엔지니어링(Engineering)·비즈니스가 하나의 언어로 비용을 다루게 하는 프레임워크이며, 성능 최적화와 상충하지 않는다. 비용은 대개 아키텍처 결정의 그림자이므로, 단위 경제성(unit economics)을 측정 루프에 넣는 순간 최적화 대상은 자동으로 드러난다.
1.1 세 단계는 순환이다
FinOps 재단(FinOps Foundation)이 정의한 세 단계는 순환이며, 한 단계라도 빠지면 최적화가 일회성 캠페인으로 끝난다.
| 단계 | 목적 | 대표 활동 | 산출물 |
|---|---|---|---|
| Inform | 누가 무엇에 얼마를 쓰는지 보이게 함 | 태깅, 비용 탐색기(Cost Explorer), 예산/알람, 쇼백 | 팀별·서비스별 비용 리포트 |
| Optimize | 낭비 제거와 단가 인하 | RI/SP/CUD, 스팟(Spot), right-sizing, 유휴 자원 정리 | 절감액, 커버리지 지표 |
| Operate | 지속 가능하게 만듦 | 단위 경제성, 리뷰 루틴, 가드레일/정책 | SLO와 함께 관리되는 비용 KPI |
1.2 핵심 원칙
핵심 원칙은 다음과 같다.
- 엔지니어링이 비용을 소유한다. 재무팀이 인스턴스를 끄지 않는다.
- 모두가 협업한다. 태깅 표준, 예산, 할인 구매는 공동 결정이다.
- 중앙집중식 FinOps 팀이 유일한 의사결정자여야 한다. 분산된 임시 최적화는 할인 커버리지를 깨뜨린다.
- 비즈니스 가치에 비례해 의사결정한다. 저비용 워크로드에 최적화 노력을 낭비하지 않는다.
- 사용량과 요금을 분리해 본다. 사용량은 엔지니어링 문제, 단가는 구매 문제다.
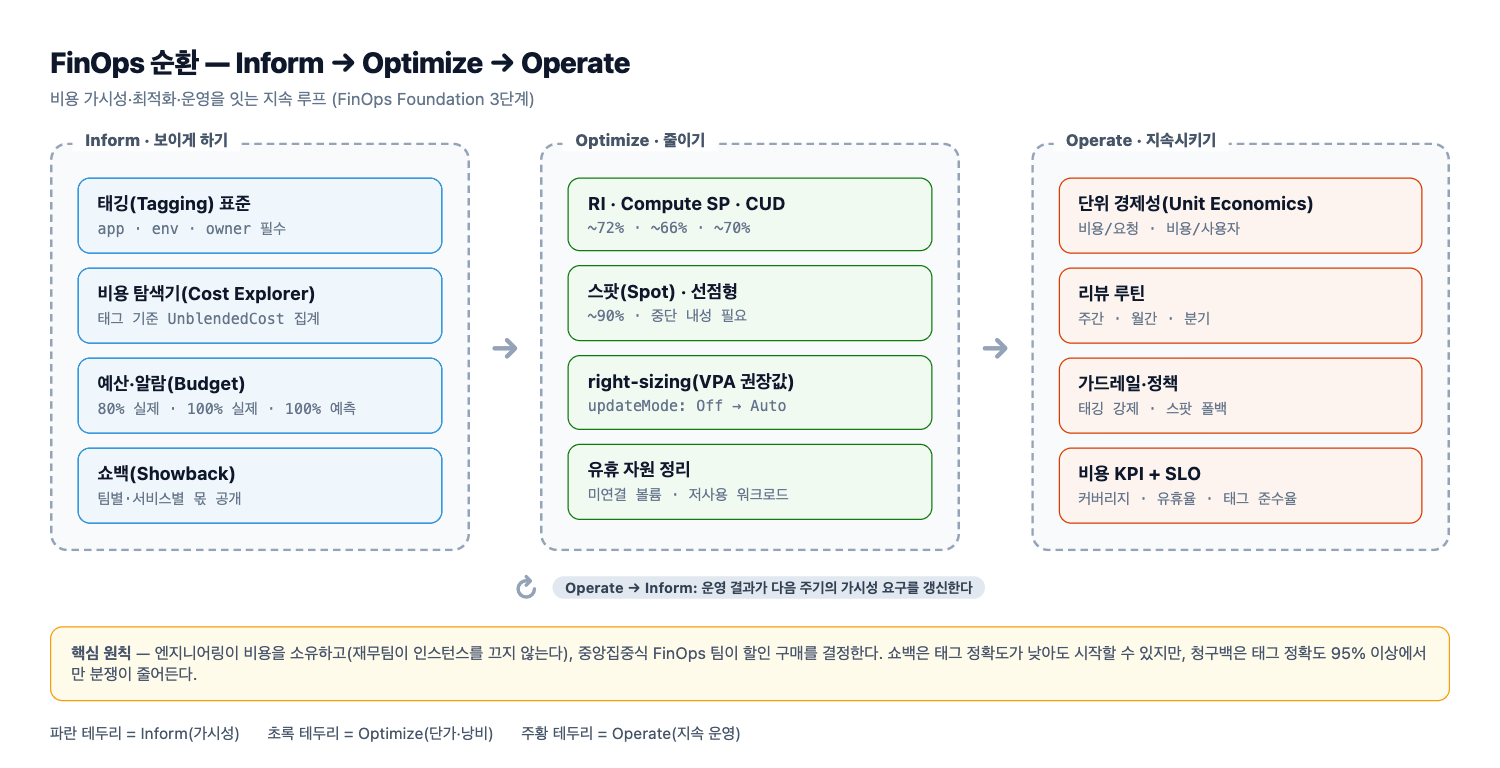
위 그림은 Inform(태깅·비용 탐색·예산 알람·쇼백) → Optimize(RI/SP/CUD·스팟·right-sizing·유휴 자원 정리) → Operate(단위 경제성·리뷰 루틴·가드레일)로 이어지는 순환을 보여준다. 한 바퀴를 돌고 끝나는 캠페인이 아니라, Operate에서 얻은 단위 경제성 지표가 다시 Inform의 가시성 요구로 되돌아가는 루프라는 점이 핵심이다.
2. 비용 가시성
비용을 줄이려면 먼저 “누가 무엇에 얼마를 쓰는지”가 보여야 한다. 그 출발점이 태깅(Tagging)과 비용 탐색이다.
2.1 태깅(Tagging) 전략
태깅이 무너지면 이후 모든 논의가 “누구 것인지 모르는 30%”로 막힌다. 최소 스키마를 강제하고 정책(Policy)으로 예외를 차단한다.
| 태그 키 | 예시 값 | 필수 여부 | 용도 |
|---|---|---|---|
app |
checkout-api | 필수 | 서비스 단위 집계 |
env |
prod / staging / dev | 필수 | 환경별 격리 |
owner |
team-payments | 필수 | 쇼백 책임자 |
cost-center |
CC-1042 | 선택 | 재무 전표 매핑 |
ttl |
2026-03-01 | 선택 | 임시 자원 자동 회수 |
주의: AWS는 비용 할당 태그(Cost Allocation Tag) 를 콘솔/API에서 별도로 활성화해야 하며, 활성화 후 과거 데이터 반영에 최대 24시간이 걸린다. GCP는 라벨(Label), Azure는 태그(Tag)라는 이름을 쓰지만 소문자/대소문자 규칙이 달라 공통 태깅 명세를 크로스 클라우드로 맞춰야 한다.
2.2 비용 탐색: 태그 기준 집계
# 최근 7일간 team 태그 기준 UnblendedCost 집계 (macOS/BSD date 기준)
aws ce get-cost-and-usage \
  --time-period Start=$(date -v-7d +%Y-%m-%d),End=$(date +%Y-%m-%d) \
  --granularity DAILY \
  --metrics UnblendedCost \
  --group-by Type=TAG,Key=team \
  --query 'ResultsByTime[].Groups[].{team:Keys[0],cost:Metrics.UnblendedCost.Amount}' \
  --output table
# Linux(GNU coreutils)라면 Start=$(date -d '7 days ago' +%Y-%m-%d) 로 교체
2.3 예산과 알람(Budget & Alert)
예산은 “초과 시 알림”이 아니라 이상 탐지 + 자동 대응 지점으로 설계한다. 임계값은 80% 실제, 100% 실제, 100% 예측 세 갈래를 모두 건다.
resource "aws_budgets_budget" "monthly" {
  name         = "prod-monthly"
  budget_type  = "COST"
  limit_amount = "5000"
  limit_unit   = "USD"
  time_unit    = "MONTHLY"

  cost_filter {
    name   = "TagKeyValue"
    values = ["user:env$prod"]
  }

  notification {
    comparison_operator       = "GREATER_THAN"
    threshold                 = 80
    threshold_type            = "PERCENTAGE"
    notification_type         = "ACTUAL"
    subscriber_sns_topic_arns = [aws_sns_topic.finops.arn]
  }

  notification {
    comparison_operator       = "GREATER_THAN"
    threshold                 = 100
    threshold_type            = "PERCENTAGE"
    notification_type         = "FORECASTED"
    subscriber_sns_topic_arns = [aws_sns_topic.finops.arn]
  }
}
2.4 쇼백(Showback) vs 청구백(Chargeback)
- 쇼백: 실제로는 중앙 계정이 지불하고, 팀에게 “네 몫은 얼마”를 보여만 준다. 도입이 빠르고 저항이 적다.
- 청구백: 원가를 실제 예산에서 차감한다. 강력하지만 태그 정확도가 95% 미만이면 분쟁만 늘어난다.
- 쿠버네티스에서는 OpenCost/Kubecost를 사용해 워크로드별 비용을 추정한다. 노드 비용을 CPU/메모리 requests 비율로 안분하되, 유휴 용량은 플랫폼 팀 계정에 남긴다는 규칙을 명문화하지 않으면 매달 같은 논쟁이 반복된다.
3. 컴퓨팅 할인 전략
3.1 할인 수단 비교
| 구분 | 대상 | 최대 할인 | 유연성 | 적합 워크로드 |
|---|---|---|---|---|
| RI (Reserved Instance) | 특정 인스턴스 패밀리/AZ | ~72% | 낮음 | 24/7 안정 트래픽 |
| Compute SP (Savings Plans) | vCPU·메모리 시간당 지출 | ~66% | 높음 | 패밀리/리전 변경 잦음 |
| CUD (Committed Use Discount) | vCPU·메모리 | ~70% | 중간 | GCP 워크로드 |
| Spot / 선점형(Preemptible) | 여유 용량, 회수 가능 | ~90% | 중단 위험 | 배치, CI, 학습 |
3.2 실무 규칙
- 커버리지(coverage) 먼저, 할인율 나중. Compute SP 커버리지 70%를 목표로 하고, 그 이상은 중단 위험과 아키텍처 변경 여지를 고려한다.
- 기준선은 약정, 스파이크는 스팟/온디맨드. 최소 12개월 부하만 약정한다.
- 스팟은 중단 내성을 코드로 보장해야 한다. 체크포인트, 배치 분할,
terminationGracePeriod대응이 없으면 데이터 손상으로 비용이 더 커진다. - 할인 구매는 리전·계정 단위로 분산한다. 한 계정에 몰아넣으면 조직 분할 시 회수 불가능한 미사용 약정이 된다.
4. 쿠버네티스 비용 최적화
쿠버네티스 비용의 80%는 스케줄러가 결정한다. requests가 실제 사용량보다 크면 노드를 낭비하고, 작으면 OOM으로 성능이 깨진다.
4.1 right-sizing과 VPA 권장값
VPA(Vertical Pod Autoscaler)를 먼저 updateMode: "Off" 로 두고 권장값만 수집하면, 서비스 중단 없이 실제 분포를 얻을 수 있다.
apiVersion: autoscaling.k8s.io/v1
kind: VerticalPodAutoscaler
metadata:
  name: api-vpa
  namespace: prod
spec:
  targetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: api
  updatePolicy:
    updateMode: "Off"        # 권장값만 계산. 리뷰 후 "InPlaceOrRecreate" 또는 "Auto"로 승격
  resourcePolicy:
    containerPolicies:
      - containerName: api
        minAllowed: { cpu: 100m, memory: 128Mi }
        maxAllowed: { cpu: "2", memory: 2Gi }
        controlledResources: ["cpu", "memory"]
# 수집된 권장값 확인. VPA는 상위 95퍼센타일 기반으로 target/upper/lower를 계산한다
kubectl -n prod get vpa api-vpa -o jsonpath='{range .status.recommendation.containerRecommendations[*]}{.containerName}{"\t"}{.target.cpu}{"\t"}{.target.memory}{"\n"}{end}'
# 실제 사용 대비 requests 비율 확인 (낭비 탐지)
kubectl -n prod top pod -l app=api --containers
4.2 bin packing
스케줄러는 requests 합이 노드 용량에 맞을 때만 파드를 배치한다. requests가 과대하면 노드 수가 늘고, 과소하면 노드에 과밀 배치되어 CPU 스로틀링이 발생한다.
requests는 P95 사용량,limits는 메모리에만 설정하는 패턴이 일반적이다.- 메모리 limits 미설정은 노드 OOM을 유발하므로 게으르게 넘기지 않는다.
topologySpreadConstraints로 AZ 분산을 강제하면 가용성은 올라가지만 AZ 간 트래픽 비용이 늘어나는 트레이드오프가 있다.
4.3 Karpenter로 인스턴스 선택 자동화
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
  name: general
spec:
  template:
    spec:
      requirements:
        - key: karpenter.sh/capacity-type
          operator: In
          values: ["spot", "on-demand"]        # 스팟 우선, 실패 시 온디맨드 대체
        - key: kubernetes.io/arch
          operator: In
          values: ["arm64", "amd64"]        # Graviton 우선 배치
        - key: karpenter.k8s.aws/instance-generation
          operator: Gt
          values: ["5"]
      nodeClassRef:
        group: karpenter.k8s.aws
        kind: EC2NodeClass
        name: default
  disruption:
    consolidationPolicy: WhenEmptyOrUnderutilized   # 저활용 노드 통합
    consolidateAfter: 1m
  limits:
    cpu: "1000"
    memory: 2000Gi                                  # 폭주 방지 상한
consolidationPolicy: WhenEmptyOrUnderutilized 는 비용 효율이 가장 큰 스위치지만, 짧은 수명의 큰 인스턴스를 자주 만들면 시작 지연이 생긴다. consolidateAfter 를 1분 이하로 낮추면 파드 재스케줄 churn이 급증한다.
4.4 유휴 자원 정리
#!/usr/bin/env bash
# 1) requests가 0이거나 극히 낮은 워크로드 후보 추출
kubectl get deploy -A -o json | jq -r '
  .items[] | select(.spec.replicas > 0) |
  [.metadata.namespace, .metadata.name,
   ([.spec.template.spec.containers[].resources.requests.cpu // "0"] | join(","))] | @tsv'

# 2) 30일 이상 미연결(available) 상태인 EBS 볼륨
aws ec2 describe-volumes \
  --filters Name=status,Values=available \
  --query 'Volumes[].{id:VolumeId,size:Size,created:CreateTime}' \
  --output table
5. 스토리지·데이터 전송 비용 함정
컴퓨팅을 최적화해도 네트워크·스토리지에서 새는 비용이 더 클 수 있다.
5.1 비용이 새는 지점
| 함정 | 발생 지점 | 완화 |
|---|---|---|
| 인터넷 egress | 외부로 나가는 트래픽 | CDN(CloudFront) 앞단 배치, 압축, 캐시 헤더 |
| AZ 간 트래픽 | 서비스 간 chatty 호출, 복제 | 같은 AZ 우선 라우팅, 배치 크기 확대 |
| NAT Gateway | 프라이빗 서브넷 → S3/ECR | VPC Gateway Endpoint(S3/DynamoDB), Interface Endpoint |
| 스토리지 클래스 오배치 | 자주 안 읽는 로그를 표준 스토리지에 보관 | S3 Lifecycle로 IA/Glacier 전환, 만료 규칙 |
| 스냅샷/버전 누적 | 버전 관리(Versioning) 켠 버킷 | NoncurrentVersionExpiration, 오래된 스냅샷 삭제 |
5.2 NAT Gateway 판단 규칙
핵심 판단 규칙: NAT Gateway는 시간당 요금 + GB당 처리 요금을 동시에 낸다. 컨테이너 이미지를 매 배포마다 인터넷 경유로 받는 클러스터는 ECR Interface Endpoint 하나로 월 수백 달러를 절약하는 경우가 흔하다.
6. 성능 최적화
비용과 성능은 같은 축이다. 같은 일을 더 적은 자원으로 빠르게 하면 양쪽이 동시에 좋아진다.
6.1 이미지 경량화
이미지 크기는 콜드 스타트, 노드 디스크, ECR 전송 비용에 모두 영향을 준다.
FROM golang:1.23 AS build
WORKDIR /src
COPY go.mod go.sum ./
RUN go mod download
COPY . .
RUN CGO_ENABLED=0 GOOS=linux go build -trimpath -ldflags="-s -w" -o /out/app ./cmd/app

FROM gcr.io/distroless/static-debian12:nonroot
COPY --from=build /out/app /app
USER nonroot:nonroot
ENTRYPOINT ["/app"]
-s -w 는 심볼/디버그 정보를 제거하고, distroless 베이스는 셸·패키지 매니저를 없애 공격면과 크기를 함께 줄인다. 빌드 캐시를 살리려면 COPY go.mod 를 소스 복사보다 앞에 둔다.
6.2 콜드 스타트
- 서버리스/Lambda: 프로비저닝된 동시성(Provisioned Concurrency)·스냅샷 시작 활용. 다만 프로비저닝 동시성은 유휴 시간에도 과금되므로 트래픽 시간대에만 스케줄한다.
- 컨테이너:
startupProbe로 초기화를 분리하고, 이미지 풀은 노드 캐시(pre-pull)로 흡수한다. - JVM: AppCDS/네이티브 이미지를 검토한다. 힙을 노드 메모리에 맞춰 지나치게 크게 잡으면 노드 단위 packing이 깨진다.
6.3 캐싱
캐시는 가장 저렴한 컴퓨팅이다. 계층을 나눠 설계한다: 엣지(CDN) → 애플리케이션(Redis) → 데이터베이스(쿼리 결과/플랜). 캐시 키 설계와 무효화(invalidation) 정책이 없으면 stale 데이터 문제가 비용 절감을 상쇄한다. Redis는 maxmemory-policy allkeys-lru 와 TTL을 반드시 함께 설정해 무한 증가를 막는다.
6.4 데이터베이스 튜닝 기초
- 느린 쿼리 로그를 켜고 상위 10개 쿼리만 최적화한다(대개 전체 비용의 대부분을 차지한다).
- 누락 인덱스 추가,
SELECT *제거, N+1 제거. - 읽기 복제본(Read Replica)으로 읽기를 분산하되, 복제 지연을 SLO에 반영한다.
- 오토스케일링이 없는 RDS는 인스턴스 클래스가 곧 상한이다. 스토리지 IOPS 과금형(gp3 프로비저닝 IOPS)은 사용량 실측 후 조정한다.
6.5 CDN
정적 자산과 공개 API 응답은 CDN으로 오프로드한다. S3 → CloudFront 방향 트래픽은 무료이고, 캐시 히트율 1%p 개선이 오리진 컴퓨팅 감소로 직결된다. Cache-Control: max-age 와 stale-while-revalidate 를 함께 쓰면 오리진 부하 스파이크를 흡수한다.
7. 단위 경제성과 비용 리뷰 루틴
총액은 트래픽이 늘면 당연히 는다. 의미 있는 지표는 단위당 비용이다.
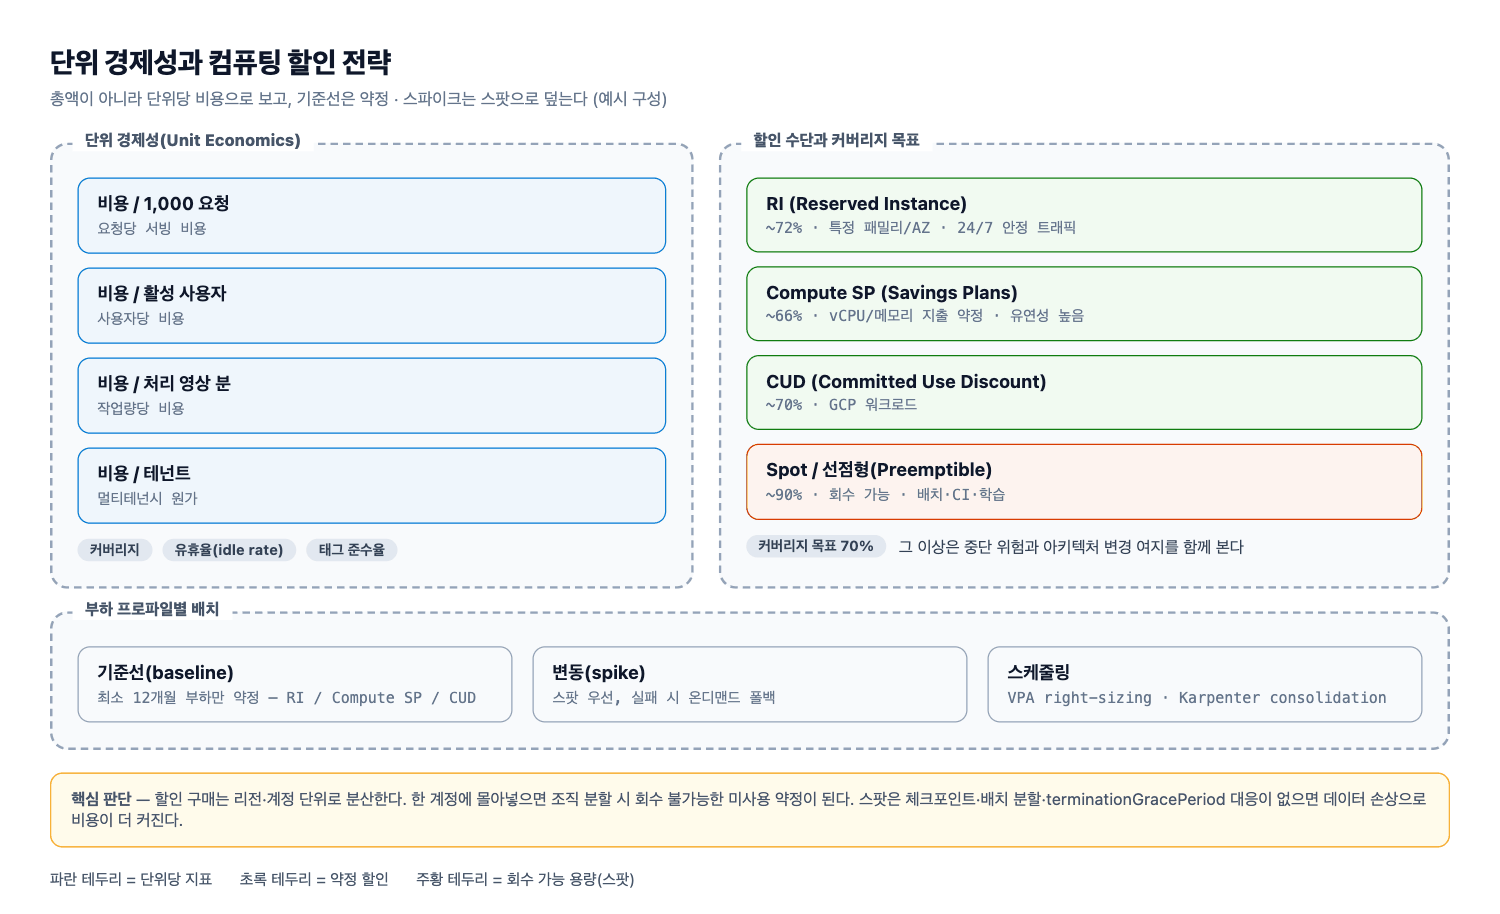
위 그림은 비용/1,000 요청·비용/활성 사용자·비용/테넌트 같은 단위당 지표와, RI(~72%)·Compute SP(~66%)·CUD(~70%)·스팟(~90%)의 할인 수단을 한 화면에 놓고, 기준선은 약정으로·스파이크는 스팟/온디맨드로 덮는 배치를 보여준다. 단위당 비용이 평평하게 유지되는지가 최적화의 성패를 가르는 지표가 된다.
7.1 단위당 비용 지표
- 비용 / 1,000 요청, 비용 / 활성 사용자, 비용 / 처리 영상 분, 비용 / 테넌트
- 커버리지(약정 대비 사용 비율), 유휴율(idle rate), 태그 준수율(tag compliance)
7.2 리뷰 루틴
- 주간: 태그 누락 리포트, 예산 편차, 스팟 중단 횟수, 즉시 회수 가능한 유휴 자원.
- 월간: RI/SP 커버리지와 미사용 약정, 인스턴스 패밀리 분포, 스토리지 클래스 분포.
- 분기: 아키텍처 변경(ARM 전환, 서버리스 전환), 할인 재구매, 단위 경제성 추세.
8. 흔한 에러 → 원인 → 해결
| 증상 | 원인 | 해결 |
|---|---|---|
Pod 가 OOMKilled |
memory limits가 실제 워크로드 대비 과소 | VPA 권장값 확인 후 limits 상향, 또는 힙/GC 튜닝 |
0/3 nodes are available: Insufficient cpu |
requests 과다 또는 bin packing 실패 | requests를 P95 기준으로 하향, Karpenter에 다양한 인스턴스 타입 허용 |
| 예산 알람이 오지 않음 | 비용 할당 태그 미활성화, SNS 구독 미확인 | 태그 활성화(반영 24시간), 알람 채널 테스트 발송 |
| 예상보다 높은 네트워크 비용 | NAT Gateway 경유 S3/ECR 접근, AZ 간 chatty 호출 | VPC Endpoint 도입, 동일 AZ 라우팅·배치 확대 |
| 스팟 노드에서 배치 작업 실패 | 중단(interruption) 미처리 | 체크포인트, 재시도, on-demand 폴백 설정 |
| VPA 적용 후 파드가 반복 재시작 | updateMode: Auto 를 검증 없이 적용 |
먼저 Off 로 권장값 수집, minAllowed 로 하한 고정 |
| 배포마다 노드 급증 | 이미지 크기 과대 + 캐시 미적중 | 멀티스테이지 빌드, 이미지 풀 캐시, 노드 pre-pull |
9. 실무 체크리스트
- 필수 태그 스키마(app/env/owner)가 정책으로 강제되고, 비용 할당 태그가 활성화되어 있는가
- 팀/서비스 단위 쇼백 리포트가 자동 생성되고, 유휴 용량 귀속 규칙이 문서화되어 있는가
- 예산 알람이 80% 실제·100% 실제·100% 예측 세 갈래로 설정되고 채널 테스트가 통과했는가
- Compute SP/RI/CUD 커버리지와 미사용 약정이 월간 리뷰되고 있는가
- 모든 워크로드의 requests가 실측 P95를 반영하며, VPA 권장값 리뷰 주기가 정해져 있는가
- 클러스터에 consolidation(Karpenter/Cluster Autoscaler)이 켜져 있고, 저활용 노드가 자동 통합되는가
- NAT Gateway 경유 트래픽이 VPC Endpoint로 대체되었고, S3/ECR 트래픽이 인터넷을 통과하지 않는가
- 스토리지에 Lifecycle(IA/Glacier 전환, 만료)과 스냅샷 보존 정책이 적용되어 있는가
- 배포 이미지가 멀티스테이지 경량 이미지이며, 콜드 스타트 지연이 SLO에 포함되어 측정되는가
- 단위 경제성 지표(비용/요청, 비용/사용자)가 대시보드에 있고, 주간·월간·분기 리뷰 루틴이 캘린더에 등록되어 있는가
10. 정리
- 비용은 순환으로 관리한다. Inform에서 보이게 만들고, Optimize에서 줄이고, Operate에서 리뷰 루틴에 넣는다. 한 단계가 빠지면 일회성 캠페인으로 끝난다.
- 태그가 없으면 논의가 멈춘다. app/env/owner 최소 스키마를 정책으로 강제하고, 비용 할당 태그를 활성화한 뒤 쇼백을 시작한다. 청구백은 태그 정확도가 95%를 넘긴 뒤에 꺼낸다.
- 커버리지 먼저, 할인율 나중. 기준선은 약정(RI/SP/CUD)으로, 스파이크는 스팟/온디맨드로 덮고, 스팟은 중단 내성을 코드로 보장한다.
- 쿠버네티스는 requests가 곧 비용이다. VPA 권장값으로 right-sizing하고, Karpenter consolidation으로 저활용 노드를 통합하며, 메모리 limits는 반드시 설정한다.
- 새는 곳은 컴퓨팅 밖에도 있다. NAT Gateway·egress·스토리지 클래스·스냅샷을 점검하고, 단위 경제성 지표를 주간·월간·분기 리뷰 루틴에 묶는다.
References
- FinOps Foundation — FinOps Framework (Inform / Optimize / Operate)
- AWS — AWS Cost Explorer로 비용 분석
- AWS — 비용 할당 태그 활성화(Cost Allocation Tags)
- AWS — Compute Savings Plans
- Google Cloud — Committed use discounts (CUD)
- Kubernetes Documentation — Vertical Pod Autoscaling
- Karpenter — NodePool disruption (consolidation)
댓글남기기