
커스텀 모델 서빙 파이프라인: LoRA 학습부터 평가·롤아웃까지
사내 AI 플랫폼에서 모델을 “빌려 쓰는” 단계를 지나면 곧 같은 벽에 부딪힌다. 도메인 용어를 모르는 범용 모델, 밖으로 나갈 수 없는 코드, 고객사마다 달라지는 출력 형식이다. 그래서 오픈 웨이트(open weight) 모델을 직접 올리고, 도메인 데이터로 LoRA(Low-Rank Adaptation)를 학습시키고, 평가를 통과한 어댑터만 서빙에 반영하는 루프를 만들게 된다. 문제는 이 루프가 “학습 스크립트 하나”로 끝나지 않는다는 점이다. 학습 데이터 수집, GPU 인스턴스 선택, 모델 캐시 전략, 배포 모드, 평가 임계값, 카나리 승격, 롤백까지 각 단계마다 되돌릴 수 없는 결정이 있다. 이 글은 AWS EKS 기반으로 공개된 엔지니어링 매뉴얼을 읽고, 내가 운영하는 플랫폼 관점으로 다시 정리한 독립 문서다1234. 원문 저장소와 사이트는 References에 남겼다5.
특정 벤더 하나에 종속된 절차가 아니라, “무엇을 측정하고 어디서 멈추는가”에 초점을 맞췄다. Azure 관리형 파운데이션 모델 엔드포인트를 쓰는 팀도, AKS(Azure Kubernetes Service)에 vLLM을 직접 올린 팀도 같은 질문을 던진다. 그 질문은 “모델이 좋아졌는가”가 아니라 “좋아졌다는 것을 어떻게 증명하고, 아니면 어떻게 8분 안에 되돌리는가”다.
1. 커스텀 모델이 필요한 순간
1.1 SaaS 도구의 다섯 가지 벽
호스팅형 AI 코딩 도구는 도입이 빠르다. 하지만 데이터 주권과 도메인 최적화가 요구사항이 되는 순간 다섯 지점에서 막힌다1.
| 제약 | SaaS 기반 도구 | 자체 호스팅 파이프라인 |
|---|---|---|
| 파인튜닝 | 사실상 불가 | 도메인별 LoRA 어댑터 학습 |
| 데이터 주권 | 코드·프롬프트가 외부로 전송 | VPC(Virtual Private Cloud) 내부에서 완결 |
| 모델 선택 | 제공 목록 안에서만 | 오픈 웨이트 모델 자유 선택 |
| 비용 구조 | 토큰 단가 고정 | SLM 캐스케이드로 단가 하향 |
| 고객별 특화 | 범용 가중치 공유 | Multi-LoRA로 고객별 어댑터 분리 |
표의 마지막 줄이 실무에서 가장 크게 작용한다. “고객사 A의 사내 규약을 학습한 모델”과 “고객사 B용 모델”을 각각 따로 서빙하면 GPU가 두 배로 필요하지만, 기본 모델을 공유하고 어댑터만 갈아 끼우면 한 대로 감당할 수 있다.
1.2 규제와 라이선스라는 두 개의 문
자체 호스팅의 첫 번째 동인은 규제다. 금융·의료·공공 영역은 민감 데이터의 국외 전송을 제한하고, 내부 코드베이스를 외부 API로 보내는 것 자체를 금지하는 경우가 많다4.
두 번째는 라이선스다. “오픈 웨이트”가 곧 “아무 제약 없음”은 아니다4.
| 라이선스 | 상업적 사용 | 파생 모델 배포 | 확인할 점 |
|---|---|---|---|
| Apache 2.0 | 허용 | 허용 | 특허 사용 허여 조항이 붙는다 |
| MIT | 허용 | 허용 | 저작권·면책 고지가 필요하다 |
| Llama 4 License | 허용(월 활성 사용자 상한) | 제한적 | 초대규모 서비스는 별도 협의 |
| Mistral License | 허용 | 제한적 | 어댑터 배포 시 출처 고지 |
여기서 실무 규칙 하나가 나온다. 법무 검토를 모델 선택 이후가 아니라 이전에 붙인다. 모델을 정하고 나서 라이선스를 확인하면, 이미 학습 파이프라인을 그 모델에 맞춰 만든 뒤다.
1.3 Base + LoRA 패턴이 기본값인 이유
하나의 기본 모델(base model) 위에 여러 도메인 어댑터를 동시에 얹는 구조가 출발점이다1. 기본 가중치를 한 번만 GPU 메모리에 올리고, 어댑터는 그 위에 붙기 때문이다. LoRA rank 16 기준으로 어댑터 하나는 100~200MB 수준이라, 10개를 동시에 로드해도 추가 메모리가 2GB를 넘지 않는다. 70B급 모델을 10번 올리는 것과 1번 올리는 것의 차이가 곧 비용 차이다.
2. 학습에서 배포까지 파이프라인 개요
2.1 전체 흐름
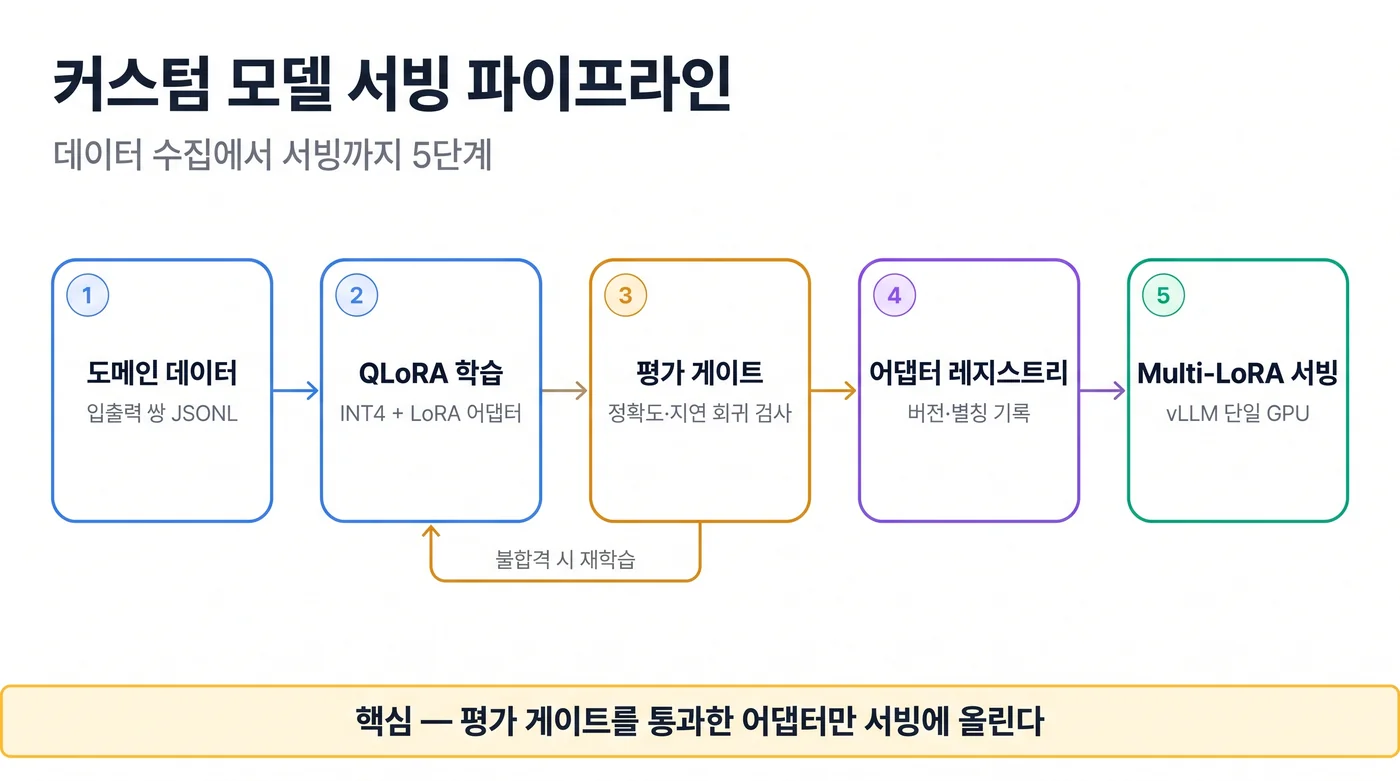
학습 파이프라인과 서빙 파이프라인이 만나는 지점이 평가 게이트다. 데이터가 아무리 좋아도, 평가를 통과하지 못한 어댑터는 서빙에 올라가지 않는다1.
도메인 데이터 ─▶ 전처리 ─▶ QLoRA 학습 ─▶ 평가 게이트 ─▶ 어댑터 레지스트리
                                  ▲           │ 불합격          (S3 + MLflow)
                                  └───────────┘                    │
                                                                   ▼
  클라이언트 ◀─ kgateway ◀─ Bifrost 캐스케이드 ◀─ vLLM Multi-LoRA 서빙
                            (SLM·LLM 라우팅)      (기본 모델 + 어댑터)
2.2 QLoRA로 GPU 요구 낮추기
QLoRA(Quantized LoRA)는 기본 모델 가중치를 INT4로 양자화한 상태에서 LoRA 어댑터만 학습한다. Full Fine-tuning 대비 GPU 요구량이 극적으로 줄어든다1.
| 모델 (Llama-3.3-70B) | Full Fine-tuning | LoRA (FP16) | QLoRA (INT4) |
|---|---|---|---|
| GPU | H100×16 이상 | H100×2~4 | H100×1 |
| VRAM | 약 840GB | 약 142~180GB | 약 40GB |
| 학습 기간 | - | 약 5일 | 약 2~3일 |
| 비용 | - | 약 $8,000 | 약 $2,000 |
대가도 있다. INT4로 유지되는 기본 가중치는 정밀한 수치 연산 태스크(금융 계산 등)에서 FP16 LoRA보다 미세하게 어긋날 수 있다. 그래서 평가 단계에서 도메인 특화 케이스를 반드시 따로 검증한다.
2.3 데이터와 학습 프레임워크
학습 데이터는 JSONL 형식의 입력-출력 쌍으로 만든다1. 예를 들어 레거시 코드 변환 도메인이라면 입력에 COBOL 문장, 출력에 대응하는 Java 구현을 넣는다. 데이터 수집 경로는 대개 다섯 갈래다.
| 소스 | 변환 방식 | 규모 예시 |
|---|---|---|
| 레거시 코드 | 언어 A → 언어 B 변환 쌍 생성 | 10,000+ 모듈 |
| 사내 프레임워크 | 패턴 → 코드 쌍 | 5,000+ 패턴 |
| 코드 리뷰 이력 | 리뷰 지적 → 반영 코드 쌍 | 20,000+ 커밋 |
| 기술 문서 | 문서 서술 → 동작 코드 쌍 | 3,000+ 페이지 |
숫자보다 중요한 것은 품질이다. 시니어가 검수한 1,000쌍이 자동 생성 10,000쌍보다 나은 경우가 많고, 최소 500쌍 검수분에서 시작하는 편이 안전하다. 프레임워크 선택은 노드 규모로 갈린다1.
| 프레임워크 | 강점 | 적합한 경우 |
|---|---|---|
| NeMo Framework | 멀티노드 분산 학습, 벤더 공식 지원 | H100 클러스터 보유, 대규모 학습 |
| Unsloth | 메모리 절감·학습 속도 개선, 단순 API | 단일 노드, 빠른 프로토타이핑 |
어댑터 하이퍼파라미터는 대개 rank 16, dropout 0.05, attention 계열 모듈(q_proj, k_proj, v_proj, o_proj)을 대상으로 시작한다. rank는 도메인 복잡도에 따라 32~64까지 올릴 수 있지만, 올릴수록 어댑터 메모리와 스왑 지연이 함께 커진다.
2.4 SLM 캐스케이드: 모든 요청을 큰 모델로 보내지 않는다
요청의 상당 부분은 소형 모델(SLM)로 충분하다. 게이트웨이에서 복잡도를 분류해 단순 요청은 SLM으로, 복잡한 요청만 LLM으로 보내면 비용 곡선이 꺾인다1.
| 항목 | SLM 단독 | LLM 단독 | 캐스케이드 (70:30) |
|---|---|---|---|
| 월 비용 | 약 $500 | 약 $8,900 | 약 $3,020 |
| 정확도 | 70% | 95% | 92% |
| 절감 | - | - | 약 66% |
주의할 점은 캐스케이드가 품질을 조금 내주고 비용을 크게 줄이는 거래라는 것이다. 정확도 92%가 요구 하한(예: 90%) 아래로 내려가는 순간 캐스케이드는 이득이 아니라 사고가 된다. 그래서 라우팅 규칙을 바꿀 때도 평가 게이트를 다시 통과시킨다.
3. 모델·GPU·배포 모드 선택
3.1 모델 선택 기준
모델을 고를 때 확인하는 축은 여섯 개다2.
| 기준 | 확인 사항 |
|---|---|
| 라이선스 | 상업적 활용 가능 여부 |
| VRAM 요구량 | FP8/FP16 기준 필요 메모리 |
| 서빙 프레임워크 호환 | vLLM 등 공식 지원 여부 |
| 벤치마크 | 타깃 태스크(코딩·추론·대화) 점수 |
| 컨텍스트 길이 | 지원 최대 토큰 수 (에이전틱 워크로드는 길수록 유리) |
| MoE 구조 | 전체 파라미터 대비 활성 파라미터 |
MoE(Mixture of Experts) 구조는 “전체 파라미터는 크지만 토큰당 활성화되는 전문가가 일부”라는 특성이 있어, VRAM 대비 성능 효율이 좋다. 다만 로딩 시에는 전체 가중치를 올려야 하므로 VRAM 계산은 전체 파라미터 기준으로 한다. 예를 들어 744B MoE(활성 40B) FP8 모델은 가중치가 약 704GB, 단일 노드 로딩 시 약 744GB의 VRAM을 요구한다. 이런 모델은 H200×8(1,128GB) 또는 B200×8(1,440GB)에서 단일 노드로 올라간다2.
3.2 GPU 인스턴스와 VRAM 매트릭스
| 인스턴스 | GPU | VRAM | 단일 노드 로딩 | PP=2 멀티노드 | Spot 가격 예시 | 권장도 |
|---|---|---|---|---|---|---|
| p5.48xlarge | H100×8 | 640GB | 불가(744GB > 640GB) | 교착 발생 | 약 $12/hr | 주의 |
| p5en.48xlarge | H200×8 | 1,128GB | 가능 | 불필요 | 약 $12/hr | 최적 |
| p6-b200.48xlarge | B200×8 | 약 1,432GB | 가능 | 불필요 | 약 $35/hr | 여유 |
선택 원칙은 네 줄로 요약된다2.
- VRAM이 충분한 최저가 Spot을 고른다: 가격이 같으면 VRAM이 큰 쪽을 선택한다.
- 모델 크기 대비 1.5배 이상 VRAM을 확보한다: KV 캐시 공간이 남아야 한다.
- 단순성을 우선한다: 멀티노드 복잡도를 애초에 만들지 않는다.
- 안정성을 우선한다: 아래 4.2에서 다룰 파이프라인 병렬 교착을 피한다.
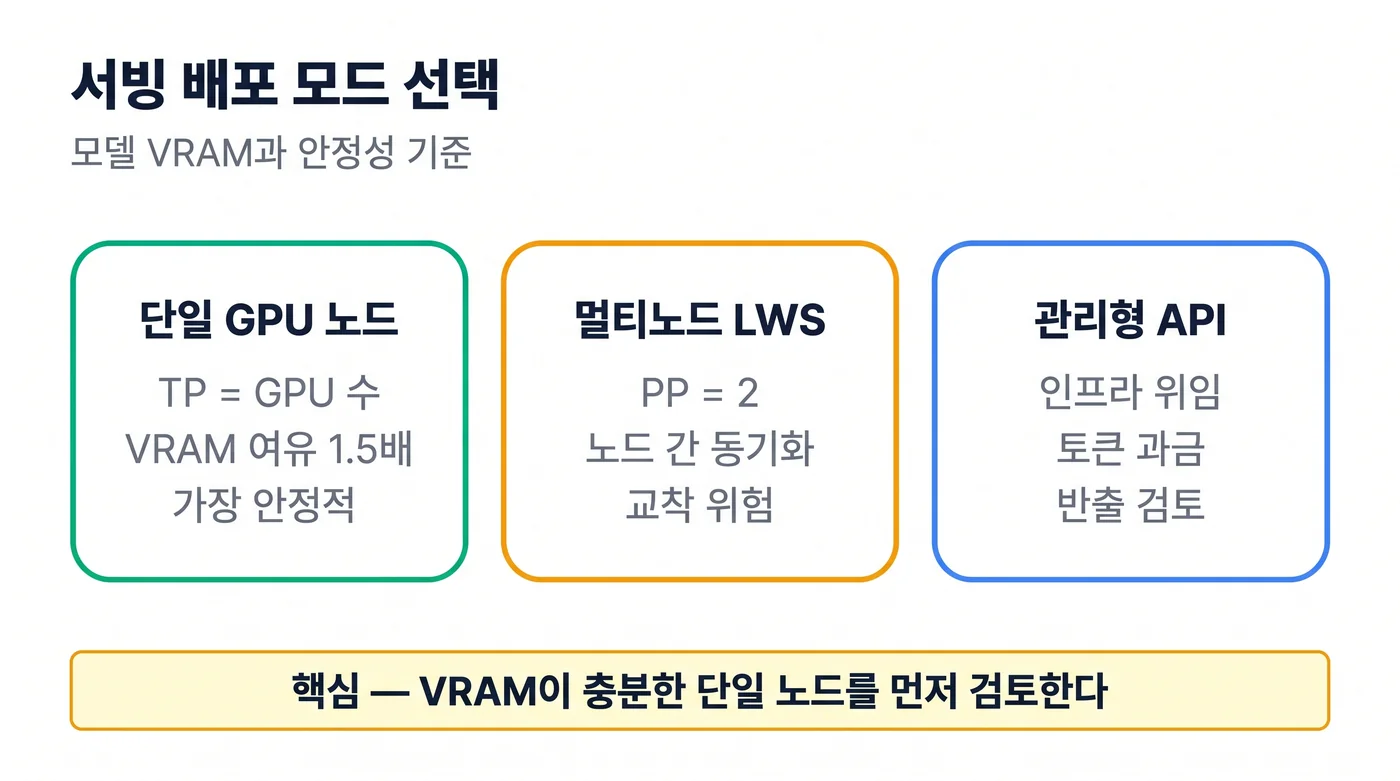
3.3 배포 모드: 관리형 노드 그룹이 기본값
EKS의 Auto Mode와 Standard Mode + 관리형 노드 그룹(MNG) 중에서는 후자를 권장한다2. Auto Mode는 최신 가속 인스턴스 지원이 추가되어 선택지가 넓어졌지만, 인스턴스 타입 자유도·Spot 대체 전략·노드 그룹 생성 안정성에서 관리형 노드 그룹이 예측 가능하다.
| 모드 | 특징 | 주의 |
|---|---|---|
| 단일 GPU 노드 | TP=GPU 수, 가장 단순 | 인스턴스 VRAM이 모델보다 커야 함 |
| 멀티노드 LWS | PP=2, 노드 간 동기화 필요 | 교착 위험, 아래 4.2 |
| 관리형 API | 인프라 위임 | 토큰 과금, 데이터 반출 검토 |
Azure로 옮겨 보면 대응 관계가 단순하다. 관리형 API는 관리형 파운데이션 모델 엔드포인트, 단일 GPU 노드는 AKS + GPU 노드 풀 + vLLM, 멀티노드 LWS는 노드 풀 간 분산 추론에 대응한다. 반출 검토 대상이 되는 것은 모델 자체가 아니라 프롬프트에 실려 나가는 데이터라는 점은 어느 쪽이나 같다.
4. 서빙 배포 실전(캐시·LWS·흔한 교착)
4.1 모델 캐시: S3 → s5cmd → NVMe
수백 GB 모델은 다운로드 시간 자체가 장애 원인이 된다. 특히 멀티노드에서는 노드별 다운로드 완료 시점이 어긋나면서 엔진 초기화 타임아웃이 난다2.
| 전략 | 노드당 다운로드 | 멀티노드 동기화 | 복잡도 | 권장 |
|---|---|---|---|---|
| HuggingFace Hub 직접 | 약 45분 | 노드별 독립 | 낮음 | 주의 |
S3 + aws s3 sync |
약 30분 | 타이밍 어긋남 가능 | 중간 | 사용 가능 |
S3 + s5cmd |
약 15분 | 타이밍 어긋남 가능 | 중간 | 최적 |
| EFS 공유 | 약 60분 | 공유 파일시스템 | 높음 | 주의 |
| NVMe emptyDir | 즉시(사전 다운로드) | S3 sync 선행 | 높음 | 권장 |
권장 워크플로우는 세 단계다. 모델을 S3에 한 번 올리고, initContainer에서 고속 S3 클라이언트로 병렬 다운로드한 뒤, 노드 로컬 NVMe 기반 emptyDir에 캐시한다2.
initContainers:
- name: download-model
  image: public.ecr.aws/aws-cli/aws-cli:latest
  command: ["/bin/bash", "-c"]
  args:
    - |
      wget -q https://github.com/peak/s5cmd/releases/download/v2.2.2/s5cmd_2.2.2_Linux-64bit.tar.gz
      tar xzf s5cmd_2.2.2_Linux-64bit.tar.gz
      ./s5cmd --numworkers 16 sync "s3://<MODEL_CACHE_BUCKET>/model/*" /mnt/models/model/
  volumeMounts:
  - name: model-cache
    mountPath: /mnt/models
emptyDir은 노드의 임시 스토리지를 쓰므로, 노드 디스크 크기를 모델 크기의 2~3배로 잡는다. 부족하면 ephemeral-storage 축출(eviction)이 나면서 Pod이 조용히 죽는다.
4.2 파이프라인 병렬 멀티노드 교착 (실패 사례)
VRAM이 부족한 인스턴스에서 PP(Pipeline Parallelism)=2 멀티노드 배포를 시도하면 다음 증상이 나온다2.
- Leader Pod은 정상: 엔진 초기화 성공, 가중치 로딩 완료.
- Worker Pod은
Waiting for engine process to be ready...를 반복하다 600초 후 실패. - 이어서 GPU 메모리 해제 →
TCPStore::recv: Connection closed by peer→ 크래시.
원인은 네 갈래로 겹친다2. 엔진 준비 타임아웃 기본값 600초가 대형 모델 로딩에는 짧고, V1 엔진의 non-Ray 멀티노드 PP가 실험적 단계이며, --enforce-eager가 제대로 전달되지 않으면 활성화되는 torch.compile이 노드 간 컴파일 타이밍을 어긋나게 하고, 노드별 독립 다운로드가 로딩 완료 시점을 갈라놓는다.
시도와 결과를 표로 남겨 둔다. 같은 함정을 반복하지 않기 위해서다.
| 시도 | 결과 |
|---|---|
| 엔진 타임아웃 1800초 연장 | 크래시 빈도 감소, 교착 유지 |
--enforce-eager 강제 |
인자 전달 실패 |
| S3 사전 다운로드 + s5cmd | 다운로드 개선, 동기화 문제 잔존 |
| NCCL 타임아웃 연장 | 효과 없음 (엔진 타임아웃 문제) |
| 분산 타임아웃 환경변수 | 해당 변수 미인식 |
| Ray 실행 백엔드 | Kubernetes 통합 복잡도 증가 |
결론은 명확하다. 2026년 4월 기준, non-Ray 멀티노드 PP는 프로덕션에 적합하지 않다. 선택지는 셋이다2. (1) VRAM이 충분한 인스턴스로 단일 노드 배포(최우선), (2) 모델 전용 최적화 이미지를 제공하는 다른 서빙 엔진(SGLang 등)의 멀티노드 PP, (3) Ray 클러스터 기반 분산. 우선순위는 언제나 (1)이다. 인스턴스를 한 등급 올리는 비용이 멀티노드 교착을 디버깅하는 비용보다 싸다.
4.3 LWS를 쓸 때 성공하는 부분
멀티노드가 불가피하면 LeaderWorkerSet(LWS)으로 배치한다. 교착은 별개 문제로 남지만, LWS의 멀티노드 네트워킹 자체는 동작한다2.
- NCCL이 두 노드 16개 rank(노드당 GPU 8개 × 2)를 연결한다.
- 744GB 모델이 두 노드에 나뉘어 로딩된다(노드당 약 43GB/80GB 사용).
- Leader Pod IP가
LWS_LEADER_ADDRESS로 Worker에 자동 주입된다. - Worker는 Leader와 다른 포트(예: 8000/8001)를 써서 충돌을 피한다.
restartPolicy: Default로 Worker만 재시작해 전체 그룹 재기동을 피한다.
apiVersion: leaderworkerset.x-k8s.io/v1
kind: LeaderWorkerSet
metadata:
  name: vllm-large
spec:
  replicas: 1
  leaderWorkerTemplate:
    size: 2                 # Leader(rank 0) + Worker(rank 1)
    restartPolicy: Default  # Worker만 재시작
핵심은 포트 분리와 재시작 정책이다. 두 노드가 같은 포트를 열면 두 번째 노드가 뜨지 못하고, 재시작 정책이 그룹 전체로 걸리면 Worker의 일시적 실패가 Leader까지 내린다.
4.4 Kubernetes Service 이름이 만드는 vLLM 경고
Kubernetes는 Service 이름을 기반으로 환경변수를 자동 생성한다. 이때 Service 이름이 vllm-로 시작하면 VLLM_* 환경변수가 만들어지고, vLLM이 이를 자기 설정으로 오인해 경고를 뿜는다2.
| Service 이름 | 생성되는 환경변수 | 결과 |
|---|---|---|
vllm-glm5 |
VLLM_GLM5_SERVICE_HOST, VLLM_GLM5_PORT … |
vLLM이 미지의 설정으로 경고 |
glm5-serving |
GLM5_SERVING_SERVICE_HOST … |
충돌 없음 |
해결은 단순하다. Service 이름에서 vllm-, llm-, model- 같은 prefix를 쓰지 않는다. Pod 라벨(app: vllm-glm5)은 그대로 둬도 되고, 바꿔야 하는 것은 Service 이름뿐이다.
4.5 GPU Operator와 Auto Mode 충돌
Auto Mode는 NVIDIA 디바이스 플러그인을 내장한다. 그 위에 GPU Operator를 기본 설정으로 설치하면 디바이스 플러그인이 중복 설치되어 충돌한다. 증상은 GPU 노드의 할당 가능 자원이 0으로 보이는 것이다2.
kubectl get nodes -l node.kubernetes.io/instance-type=p5en.48xlarge -o json
  → "nvidia.com/gpu": "0"        # 충돌 상태
nvidia-device-plugin-daemonset  CrashLoopBackOff  # 중복 플러그인
해결은 GPU Operator 설치 시 디바이스 플러그인을 끄고, 관측 계열 컴포넌트만 켜는 것이다(devicePlugin.enabled=false, dcgm, dcgmExporter, gfd, nodeStatusExporter는 활성). 단, 충돌이 한 번 발생한 뒤에는 Operator를 재설치해도 GPU 노드를 재생성해야 한다. 워크로드 삭제 → NodeClaim 삭제 또는 노드 drain·종료 → 새 GPU 노드 프로비저닝 순서다.
5. 평가 게이트와 롤아웃
5.1 무엇을 어떤 임계값으로 재는가
학습된 어댑터는 배포 전에 여러 평가를 통과해야 한다13.
| 평가 | 목적 | 자동화 |
|---|---|---|
| RAGAS | RAG 정확도(충실성·관련성) | CI/CD 연동 |
| SWE-bench | 실제 이슈 해결력 | CI/CD 연동 |
| 도메인 전문가 리뷰 | 비즈니스 정합성 | 수동 |
| 레드팀(Garak 등) | 프롬프트 주입·안전성 | CI/CD 연동 |
배포 하한선은 숫자로 못 박아 둔다1. RAGAS 충실성 0.85 이상, SWE-bench 해결률 30% 이상, 도메인 전문가 3명 중 2명 이상 승인, 보안 테스트 치명적 발견 0건이다.
여기서 실무적으로 더 중요한 것은 평가 자체를 계약으로 만드는 일이다3.
- 후보 모델과 기준 모델에 동일한 고정 평가 입력을 보내고, 응답·완료 상태·지연을 먼저 저장한다.
- 점수 계산에는 judge 모델·임베딩·모델 리비전과 평가 도구 버전을 고정하고, 데이터셋과 프로토콜의 해시를 함께 기록한다.
- 표본은 최소 500건, 양쪽이 같은 sample ID 집합을 써야 한다.
- 평균만 보지 않는다. 결측·중복 ID·비유한(non-finite) 점수를 실패로 처리하고, P99 지연은 nearest-rank로 계산한다.
- 판정은 절대 하한과 상대 회귀 두 축으로 한다. 충실성이 3pp(퍼센트포인트) 초과 하락하거나 P99 지연이 10% 초과 늘면 실패다.
- 게이트 결과는 문자열이 아니라 종료 코드로 다음 단계에 넘긴다. 사람이 로그를 읽고 판단하는 순간 자동화가 끊긴다.
5.2 카나리 승격: 5% → 25% → 100%
승격은 게이트웨이의 HTTPRoute 가중치를 바꿔 가며 진행한다3.
  5% (24시간 관측) ──▶ 25% (7일 관측) ──▶ 100%
   │                    │                  │
   └ 매 단계 승인 게이트(자동 해제 아님, 사람이 재개)
apiVersion: gateway.networking.k8s.io/v1
kind: HTTPRoute
metadata:
  name: model-serving-canary
  namespace: model-serving
spec:
  rules:
  - matches:
    - path: {type: PathPrefix, value: /v1/chat/completions}
    backendRefs:
    - {name: vllm-stable, port: 8000, weight: 95}
    - {name: vllm-canary, port: 8000, weight: 5}
5% 단계에서 100%까지 최소 8일이 걸리고, 승인 대기 시간은 별도다. 승격 조건은 “알림이 없다”가 아니라 관측이 건강하다는 증명이다3.
| 조건 | 값 |
|---|---|
| 필수 시계열 | stable·canary 각각 동일 개수, 중복 없음 |
| 최소 표본 | track당 요청 100건, 평가 20건 |
| 관측 신선도 | 마지막 요청·평가 관측이 90초 이내 |
| 수집 완결성 | collection_complete = 1 (producer 누락 없음) |
| 품질 회귀 | stable 대비 −3pp 초과 시 중단 |
| 지연 회귀 | stable 대비 +10% 초과 시 중단 |
| 오류율 | min(1%, max(0.1%, 2 × stable 오류율)) 초과 시 중단 |
수집 완결성 지표를 따로 두는 이유가 있다. producer 하나가 죽으면 남은 producer의 최솟값만 계산되어 지표가 멀쩡해 보인다. 그래서 “예상 목록 대비 누락”을 확인하는 별도 게이지가 필요하다. 같은 이유로 조회 시각과 메트릭이 담고 있는 관측 시각을 따로 검사한다. 방금 조회한 값이라도 오래된 관측에서 계산됐을 수 있다.
5.3 레지스트리와 롤백
레지스트리(예: MLflow Model Registry)는 아티팩트 위치와 버전을 기록할 뿐, 그 자체로 배포를 실행하지 않는다3.
- 평가를 통과한 버전을 등록하고
candidate별칭을 붙인다. 이 단계에서 트래픽은 바뀌지 않는다. - 카나리 관측과 승인 증거가 확인된 뒤에만
production별칭을 옮기고, 직전 버전을previous로 보존한다. - 별칭 변경은 릴리스 결정의 기록이지 배포 명령이 아니다. 두 가지를 분리해야 “누가 언제 무엇을 승인했는가”가 추적된다.
롤백은 새 라우트를 만드는 일이 아니다. 트래픽이 연결된 기존 HTTPRoute의 가중치를 stable 100%로 되돌리는 것이다3.
| 신호 | 임계 | 조치 |
|---|---|---|
| 품질 하락 | stable 대비 −3pp 초과 | 가중치 0%로 회수, 후보 학습 중단 |
| 지연 악화 | stable 대비 +10% 초과 | 가중치 0%로 회수, 프로파일링 |
| 오류율 상승 | 허용 상한 초과 | 즉시 회수 후 로그·트레이스 확인 |
| 메트릭 수집 중단 | collection_complete = 0 |
승격 동결, exporter·reconciler 점검 |
| 롤백 후에도 이상 | 지속 | stable 버전 자체 회귀 여부 확인 |
롤백에서 사람이 자주 틀리는 지점은 순서다. 리소스 적용 성공과 데이터 경로 반영은 다르므로, 라우트의 Accepted=True·ResolvedRefs=True와 실제 요청 결과를 확인한다. 진행 중인 스트림이 빠져나가기(drain) 전에 canary 레플리카를 0으로 줄이면 요청이 끊긴다. 체크포인트는 실험용과 운영용을 겹치지 않는 prefix로 나눠 보존한다. 실험용만 만료시키는 수명주기 규칙을 써야 운영 체크포인트가 실수로 지워지지 않는다3.
6. TCO와 오픈 웨이트 판단
6.1 세 가지 배포 패턴
오픈 웨이트 모델의 배포는 세 갈래다4.
| 패턴 | 구성 | 강점 | 부담 |
|---|---|---|---|
| 클라우드 관리형 K8s | EKS + vLLM | Spot·오토스케일, 관리형 모니터링 | GPU 시간당 비용, 클라우드 의존 |
| 온프레미스 베어메탈 | H100×8 서버 + vLLM | 완전한 데이터 통제, 낮은 네트워크 지연 | 초기 CapEx, 운영 인력, 유휴 전력 |
| 하이브리드 | 민감 작업 온프레미스 + 일반 작업 클라우드 API | 민감도별 분리 | 라우팅·정책 복잡도 |
하이브리드에서 자주 쓰는 형태는 경로나 작업 민감도로 모델을 나누는 라우팅이다. 여기서 폴백(fallback) 설정 하나가 특히 중요하다. 민감 작업에는 외부 전송으로 이어지는 폴백을 두지 않는다. 가용성이 떨어지더라도 규제 위반보다 낫다.
6.2 TCO 비교
| 항목 | 클라우드 API | 자체 호스팅 (EKS) | 온프레미스 베어메탈 |
|---|---|---|---|
| 과금 | 입력 $3 / 출력 $15 (1M 토큰 기준) | 고정 인프라 + 운영 인력 | 3년 상각 + 전력 + 인력 |
| 월 비용 예시 | 약 $300 (5천만 입력·1천만 출력) | 4B급 약 $2,742 / 405B급 약 $76,940 | 약 $20,226 (3년 후 약 $11,893) |
| 초기 투자 | 없음 | 낮음 | 높음(하드웨어) |
자체 호스팅 월 비용에는 운영 인력이 들어간다는 점을 빼먹기 쉽다. 소형 모델은 0.2 FTE, 대형 모델은 0.5 FTE 수준으로 잡으면 4B급은 월 $2,742, 405B급은 월 $76,940이 된다. 온프레미스는 3년 상각으로 월 약 $20,226이며, 하드웨어 상각이 끝나는 3년 후에는 약 $11,893으로 내려간다4.
의사결정 기준은 네 줄이다4.
- 월 1천만 토큰 미만: 관리형 API가 합리적이다. 관리 오버헤드가 없다.
- 월 1천만~1억 토큰: 작업 유형과 민감도에 따라 하이브리드를 검토한다.
- 월 1억 토큰 이상: 자체 호스팅을 검토한다.
- CapEx 투자 가능 + 3년 이상 운영: 온프레미스가 장기 TCO에서 가장 낮다.
6.3 KPI: 개선당 비용
모델 수명주기에서 놓치기 쉬운 지표는 “품질 1단위를 사는 데 얼마를 썼는가”다. 충실성 0.01 상승당 GPU 시간과 비용으로 환산한다3.
| 지표 | 반복 1 | 반복 2 | 반복 3 |
|---|---|---|---|
| GPU 시간 | 96 | 120 | 144 |
| 학습 비용 | $1,200 | $1,500 | $1,800 |
| 충실성 상승폭 | 0.020 | 0.015 | 0.010 |
| 0.01 상승당 GPU 시간 | 48 | 80 | 144 |
| 0.01 상승당 비용 | $600 | $1,000 | $1,800 |
표의 패턴이 곧 중단 신호다. 반복을 거듭할수록 개선당 비용이 오르면, 같은 데이터로 더 학습시키는 대신 데이터 수집·라벨링으로 되돌아가야 한다. 학습 루프의 주기도 이 지표에 맞춘다3.
| 주기 | 액션 | 목표 |
|---|---|---|
| 주간 | 트레이스 수집·라벨링 | 승인·중복 제거를 통과한 샘플 확보 |
| 격주 | 재학습 여부 검토 | 데이터가 충분할 때만 학습 |
| 월간 | 전체 평가 + 카나리 검토 | 기준 통과 후보만 승격 |
| 분기 | 비용 대비 효과 분석 | 학습 지속·중단 결정 |
실무 적용: 파일럿→양산 로드맵과 롤백 기준
도입 Phase와 판정 기준
파일럿은 “모델을 올렸다”가 아니라 “루프가 돈다”를 증명하는 단계다. 각 Phase의 판정 기준을 통과하지 못하면 다음으로 넘어가지 않는다1.
| Phase | 기간 | 구성 | 비용(예시) | 판정 기준 |
|---|---|---|---|---|
| 1 | 즉시 | 기본 모델 + 스티어링 | 약 $8,900/월(GPU) | OpenAI 호환 API 응답, 트레이싱 연동 확인 |
| 2 | 1~2주 | + 벡터 RAG | 인프라 추가 | 사내 문서 질의 정확도 기준 통과 |
| 3 | 2~4주 | + SLM 캐스케이드 | +약 $500/월 | 캐스케이드 정확도가 설정 하한 이상 유지 |
| 4 | 1~2개월 | + LoRA 학습·Multi-LoRA 배포 | +약 $2,000(1회) | 평가 게이트 4종 통과, 카나리 승격 완료 |
Phase 1~3은 “학습 없이 얻을 수 있는 것”을 먼저 확보하는 구간이다. 스티어링·RAG·캐스케이드만으로도 상당 부분이 해결되므로, LoRA는 그 뒤에 붙인다. 순서를 뒤집으면 학습 데이터 품질 문제를 서빙 문제로 착각하게 된다.
평가 게이트 임계값을 정의하는 법
임계값은 감이 아니라 네 단계로 정한다.
- 기준선을 고정한다. 운영 중인 모델을 baseline으로 지정하고, 후보와 완전히 같은 표본·같은 프로토콜을 쓴다.
- 절대 하한을 정한다. 비즈니스가 견딜 수 있는 최저선(예: 충실성 0.85)을 먼저 못 박는다.
- 상대 한도를 정한다. 회귀 허용폭(예: 품질 −3pp, 지연 +10%)을 정한다. 절대 하한만 있으면 “원래 좋던 모델이 조금 나빠진 것”을 놓친다.
- 표본·신선도 조건을 붙인다. 표본 수·관측 지연·수집 완결성 조건을 만족하지 않으면 “판정 불가”로 처리한다. 판정 불가를 통과로 처리하는 순간 게이트는 무의미해진다.
임계값은 한쪽만 조인다는 원칙도 기억한다. 품질을 올리려고 지연 한도를 없애면 사용자 경험이 무너지고, 지연을 조이려고 품질 하한을 풀면 카나리가 조용히 나빠진다.
롤백·레지스트리 운영 체크리스트
승격 전에 확인한다.
- 평가 게이트가 종료 코드로 판정되고, 보고서에 데이터셋·프로토콜 해시가 있다
- 레지스트리에 후보 버전이 등록되고
candidate별칭이 붙었다 - 직전 운영 버전이
previous별칭으로 보존되어 있다 - stable 서비스가 정상이고, stable Pod이 준비 상태다
- 라우트 가중치 변경이 코드 리뷰를 거친다(수동 kubectl 금지)
- 관측 exporter·reconciler가 살아 있고
collection_complete가 1이다
롤백 시에 확인한다.
- 가중치를 stable 100%로 되돌렸다(새 라우트를 만들지 않았다)
- 라우트의
Accepted=True,ResolvedRefs=True를 최신 generation에서 확인했다 - 실제 요청으로 stable 모델 응답을 확인했다
- 진행 중 스트림이 drain된 뒤에 canary 레플리카를 줄였다
- 롤백 후에도 이상이면 stable 버전 자체를 의심하고 이전 버전으로 내린다
- MLflow 별칭(
production/previous)과 실제 서빙 버전이 일치한다
마지막 줄이 자주 어긋난다. 별칭은 릴리스 결정의 기록이고 트래픽은 라우트가 결정하므로, 둘을 같은 스크립트에서 함께 바꾸지 않으면 “레지스트리에는 새 버전이 production인데 서빙은 옛 버전”인 상태가 만들어진다.
자체 호스팅인가 관리형인가: 판단표
| 상황 | 권장 |
|---|---|
| 민감 데이터 반출 금지 | 자체 호스팅(또는 하이브리드, 폴백 없음) |
| 월 1천만 토큰 미만 | 관리형 API |
| 월 1억 토큰 이상 + 안정적 워크로드 | 자체 호스팅 검토 |
| 고객별 출력 형식·용어 차이 큼 | Multi-LoRA (자체 호스팅 전제) |
| GPU 운영 인력 없음 | 관리형 API 또는 완전관리형 엔드포인트 |
| 3년 이상 운영 + CapEx 가능 | 온프레미스 베어메탈 |
References
외부 자료
- LoRA: Hu et al., 2021 — https://arxiv.org/abs/2106.09685
- QLoRA: Dettmers et al., 2023 — https://arxiv.org/abs/2305.14314
- vLLM Multi-LoRA 문서 — https://docs.vllm.ai/en/latest/features/lora/
- LeaderWorkerSet — https://github.com/kubernetes-sigs/lws
- s5cmd — https://github.com/peak/s5cmd
- Gateway API — https://gateway-api.sigs.k8s.io/
- MLflow — https://mlflow.org/
- Argo Workflows — https://argoproj.github.io/workflows/
- RAGAS — https://docs.ragas.io/
- NVIDIA GPU Operator — https://docs.nvidia.com/datacenter/cloud-native/gpu-operator/
-
Engineering Playbook —
docs/agentic-ai-platform/reference-architecture/model-lifecycle/custom-model-pipeline.md(devfloor9.github.io/engineering-playbook) ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7 ↩8 ↩9 ↩10 ↩11 -
Engineering Playbook —
docs/agentic-ai-platform/reference-architecture/model-lifecycle/custom-model-deployment.md(devfloor9.github.io/engineering-playbook) ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7 ↩8 ↩9 ↩10 ↩11 ↩12 ↩13 -
Engineering Playbook —
docs/agentic-ai-platform/reference-architecture/model-lifecycle/continuous-training/evaluation-rollout.md(devfloor9.github.io/engineering-playbook) ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7 ↩8 ↩9 ↩10 -
Engineering Playbook —
docs/aidlc/toolchain/open-weight-models.md(devfloor9.github.io/engineering-playbook) ↩ ↩2 ↩3 ↩4 ↩5 ↩6 -
Engineering Playbook 저장소 사이트 — https://devfloor9.github.io/engineering-playbook/ (2026-10-10 확인) ↩
댓글남기기