
SRE와 신뢰성: SLO·에러 버짓·인시던트·카오스 엔지니어링
이 시리즈는 쿠버네티스와 클라우드(AWS·GCP·Azure 공통 개념)를 실무 관점에서 정리한 기록이다. 핵심 개념·코드 예제·실전 함정(gotcha) 중심으로, 학습과 설계 리뷰·장애 대응에 바로 쓸 수 있게 구성했다. 각 편은 독립적으로 읽을 수 있고, 순서대로 보면 클러스터 내부 구조에서 클라우드 운영까지 하나의 흐름으로 이어진다.
이번 편에서는 SRE(Site Reliability Engineering)를 “운영을 소프트웨어 문제로 다룬다”는 원칙 위에서 다시 정리한다. 신뢰성을 사람의 헌신이 아니라 측정 가능한 목표(SLO)와 에러 버짓(error budget)으로 관리하고, 반복 작업(토일, toil)을 자동화로 제거하며, 인시던트를 학습 기회로 바꾸는 방식을 SLO 설계부터 온콜·인시던트 대응, 카오스 엔지니어링, 부하 테스트, 점진적 배포까지 실무에서 바로 쓸 수 있는 형태로 살펴본다. 신뢰성 목표를 세우기 전에 클라우드 아키텍처 패턴과 재해 복구(DR)에서 RTO/RPO와 다중 리전 전략을 먼저 잡아 두면 좋고, 장애 신호를 어떻게 수집하고 좁혀 갈지는 쿠버네티스 관찰성과 디버깅에서 다룬 메트릭·로그·트레이싱과 kubectl 디버깅 흐름이 그대로 쓰인다.
- SRE의 네 가지 원칙과 “100% 신뢰성은 잘못된 목표”라는 전제를 정리한다
- SLI·SLO·SLA의 층위를 구분하고, 좋은 SLI의 조건과 에러 버짓 계산법을 세운다
- 멀티윈도우 소진률 경보와 에러 버짓 정책으로 릴리스 게이트를 만든다
- 토일 제거, 온콜 로테이션, 인시던트 선언·역할·소통, 비난 없는 포스트모템을 하나의 운영 체계로 엮는다
- 런북·카오스 엔지니어링·부하 테스트·점진적 배포로 변경을 안전하게 만드는 흐름을 정리한다
1. SRE 원칙: 신뢰성은 비용이다
SRE의 출발점은 “100% 신뢰성은 잘못된 목표”라는 인식이다. 사용자는 완벽을 체감하지 못하지만, 그 완벽을 위한 비용은 청구된다. 그래서 신뢰성을 서비스 수준 목표(Service Level Objective, SLO) 라는 명시적 계약으로 표현하고, 목표를 초과 달성하면 오히려 릴리스 속도를 높이는 방향으로 자원을 재배분한다.
핵심 원칙은 네 가지로 요약된다.
- 측정 우선: 감(感)이 아니라 SLI(Service Level Indicator)로 판단한다.
- 에러 버짓은 예산: 남으면 기능을 내보내고, 다 쓰면 안정성 작업에 집중한다.
- 토일은 부채: 반복적·수동적·자동화 가능한 작업은 정량화해서 갚는다.
- 학습은 비난 없이: 사람은 실패한다. 시스템이 실패를 허용하도록 설계한다.
2. SLI / SLO / SLA와 에러 버짓 운영
세 용어는 자주 혼용되지만 층위가 다르다.
| 용어 | 정의 | 주체 | 예시 |
|---|---|---|---|
| SLI | 실제 측정값 | 엔지니어링 | 5xx / 전체 요청 비율, p99 지연 |
| SLO | SLI의 내부 목표 | 엔지니어링 + 제품 | 30일 롤링 99.9% 가용성 |
| SLA | 위반 시 보상이 따르는 대외 계약 | 법무 + 사업 | 월 가용성 99.5% 미달 시 크레딧 |
SLA는 SLO보다 항상 느슨해야 한다. 둘을 같게 잡으면 에러 버짓이 0이 되어 아무 변경도 못 하는 서비스가 된다.
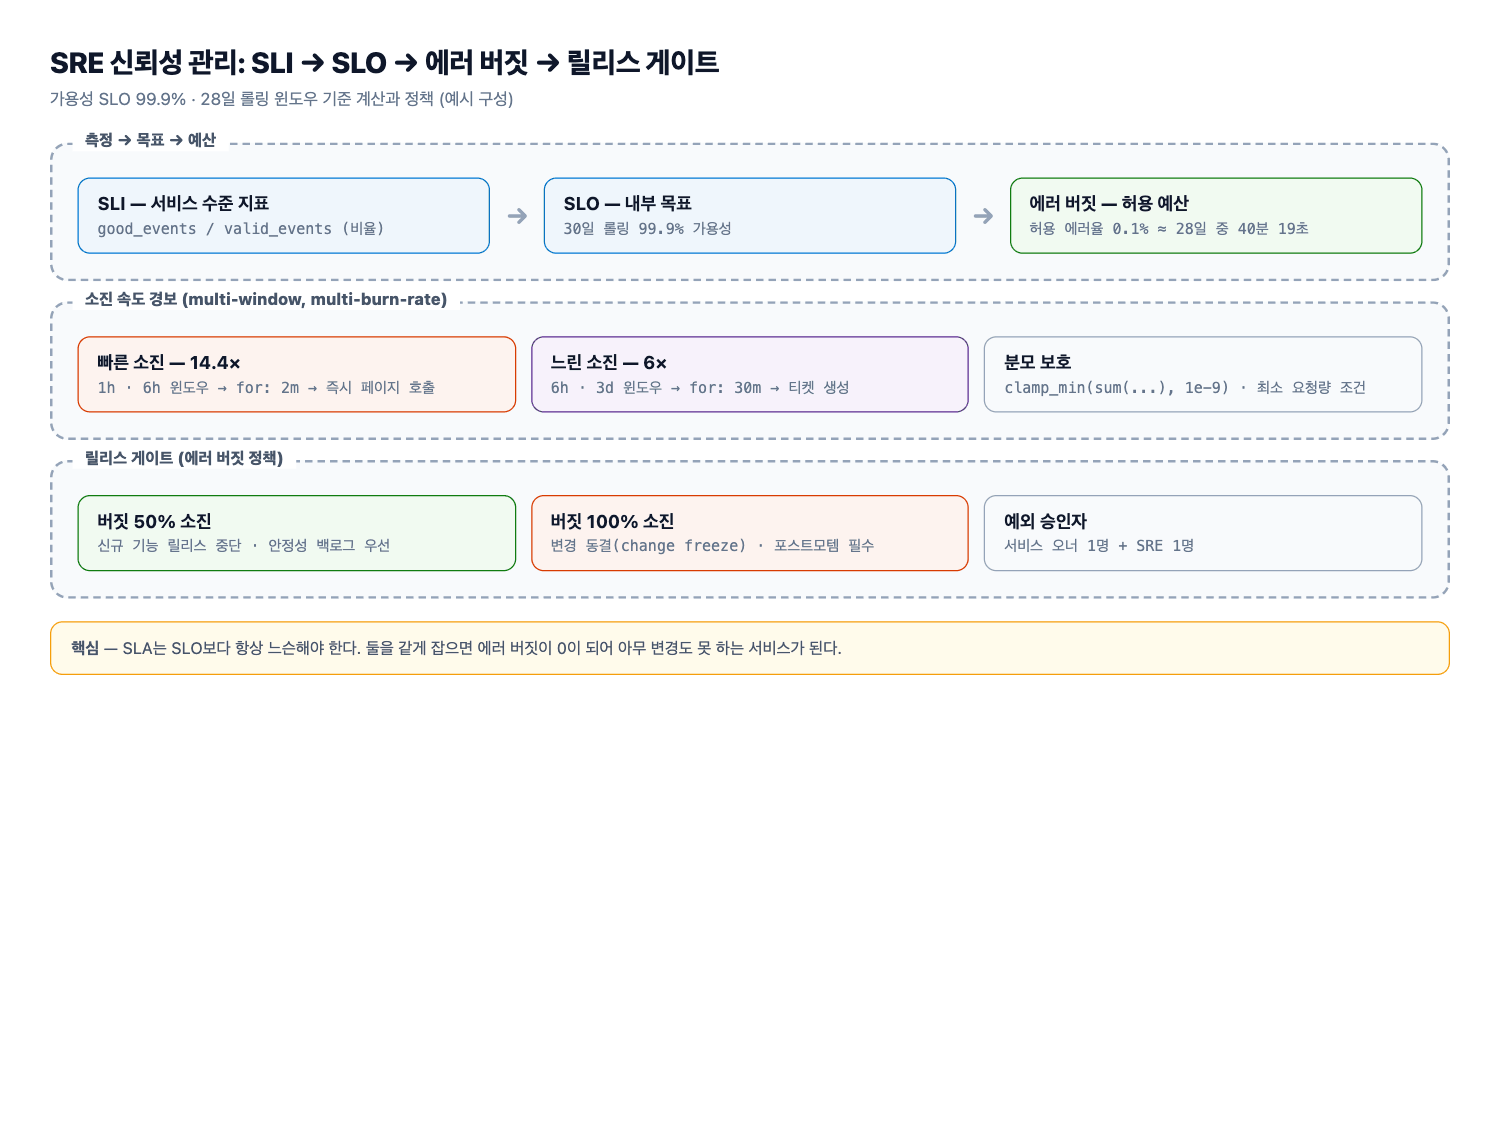
위 다이어그램은 SLI(측정값) → SLO(내부 목표) → 에러 버짓(허용 예산)으로 이어지는 계산 흐름과, 소진 속도를 경보로 나눈 뒤 버짓 소진율에 따라 릴리스 여부를 결정하는 게이트를 한 장에 담았다. 이 구조가 이 편 전체의 뼈대가 된다.
2.1 좋은 SLI의 조건
- 사용자 행동에 기반한다(CPU 사용률이 아니라 성공한 결제 수).
- 비율(ratio)로 표현한다:
good_events / valid_events. - 윈도우를 명시한다(롤링 28일 또는 캘린더 월).
- 집계 지점을 정한다(로드밸런서, 서비스 메시, 애플리케이션 계측 중 하나만 — 섞으면 이중 계상된다).
2.2 에러 버짓 계산
SLO 99.9%면 허용 에러율은 0.1%다. 28일 기준으로는 0.001 × 28일 ≈ 40분 19초의 완전 장애와 등가다. 이 “예산”을 소진 속도로 경보를 만든다.
# prometheus-slo-rules.yaml
# 목표: 99.9% 가용성 → 허용 에러율 0.001
apiVersion: v1
kind: ConfigMap
metadata:
  name: slo-rules
  namespace: monitoring
data:
  slo-http.yaml: |
    groups:
      - name: slo-http-availability
        interval: 30s
        rules:
          - record: slo:http_error_ratio:ratio1h
            expr: |
              sum(rate(http_requests_total{status=~"5.."}[1h]))
              /
              clamp_min(sum(rate(http_requests_total[1h])), 1e-9)
          - record: slo:http_error_ratio:ratio6h
            expr: |
              sum(rate(http_requests_total{status=~"5.."}[6h]))
              /
              clamp_min(sum(rate(http_requests_total[6h])), 1e-9)
      - name: slo-http-alerts
        rules:
          # 빠른 소진(1h·6h 모두 14.4배) → 즉시 호출
          - alert: SLOErrorBudgetFastBurn
            expr: |
              slo:http_error_ratio:ratio1h > (14.4 * 0.001)
              and
              slo:http_error_ratio:ratio6h > (14.4 * 0.001)
            for: 2m
            labels:
              severity: page
              slo: checkout-availability
            annotations:
              summary: "에러 버짓 2%를 1시간 내 소진 (SLO 99.9%)"
          # 느린 소진(6h·3d) → 티켓
          - alert: SLOErrorBudgetSlowBurn
            expr: |
              slo:http_error_ratio:ratio6h > (6 * 0.001)
              and
              slo:http_error_ratio:ratio3d > (6 * 0.001)
            for: 30m
            labels:
              severity: ticket
멀티윈도우 멀티버스트(multi-window, multi-burn-rate) 방식의 장점은 단순하다. 짧은 스파이크에 새벽 호출을 당하지 않고, 느린 누수는 티켓으로 잡는다.
2.3 에러 버짓 정책 문서
기술 규칙보다 정책이 먼저다. 문서에 최소한 다음을 명시한다.
- 버짓 50% 소진 시: 신규 기능 릴리스 일시 중단, 안정성 백로그 우선.
- 버짓 100% 소진 시: 변경 동결(change freeze), 포스트모템 필수.
- 예외 승인자: 서비스 오너 1명 + SRE 1명.
3. 토일(Toil) 측정과 제거
토일은 수동적·반복적·자동화 가능·전술적·가치가 선형 증가하지 않는 작업이다. 대시보드 눈으로 보며 재시작하는 일, 매주 손으로 돌리는 리포트, 티켓 큐 처리 등이다.
측정은 Google SRE 방식의 설문이 가장 저렴하다. 주 1회, 온콜/운영 담당자에게 물어라.
- 이번 주 토일에 쓴 시간은 몇 시간인가?
- 그중 반복된 작업 Top 3는 무엇인가?
- 이 작업이 자동화되면 주 몇 시간이 회수되는가?
목표는 토일 비율 50% 이하다. 초과하면 다음 분기의 로드맵에서 자동화 항목을 최우선으로 올린다. 제거 순서는 “시간 소모 × 발생 빈도 ÷ 자동화 난이도”로 정렬한다(예: kubectl rollout restart 수동 반복 → 헬스체크 기반 자동 재시작, 수동 스케일 → HPA/KEDA).
4. 온콜 운영: 로테이션, 에스컬레이션, 피로 관리
온콜(on-call)은 “인터넷이 죽으면 깨어나는 사람”이 아니라 설계된 시스템이다.
- 로테이션: 최소 6~8명 규모에서 1주 단위. 1인 온콜은 반드시 피한다.
- 에스컬레이션: 1차 응답(5분) → 2차(10분) → 서비스 오너(15분). 무응답은 자동으로 다음 단계로 넘어가야 한다.
- 업무량 상한: 교대당 호출 2건 초과, 주간 6건 초과면 온콜 품질 저하로 간주하고 신뢰성 작업을 멈춘다.
- 피로 관리: 호출은 실제 사용자 영향 + 조치 필요 조건을 모두 만족할 때만. 조치가 없는 경보는 즉시 삭제하거나 티켓으로 강등한다.
- 보상과 낮 시간 회복: 야간 호출 다음 날 오전 일정은 비워둔다.
#!/usr/bin/env bash
# declare-incident.sh - 인시던트 선언과 타임라인 기록
set -euo pipefail

TITLE="${1:?usage: declare-incident.sh <title> <sev1|sev2|sev3>}"
SEV="${2:-sev3}"
: "${SLACK_WEBHOOK:?export SLACK_WEBHOOK=https://hooks.slack.com/...}"

if [[ ! "$SEV" =~ ^sev[1-3]$ ]]; then
  echo "invalid severity: $SEV" >&2; exit 2
fi

INC_ID="INC-$(date -u +%Y%m%d)-$(openssl rand -hex 3)"
LOG="incident-${INC_ID}.timeline.log"

# sev1/sev2는 페이지 호출, sev3는 채널 알림만
if [[ "$SEV" == "sev1" || "$SEV" == "sev2" ]]; then
  MENTION='<!subteam^S0ONCALL> *에스컬레이션: 즉시 참여 필요*'
else
  MENTION='업무 시간 내 대응'
fi

curl -fsS -X POST "$SLACK_WEBHOOK" -H 'Content-Type: application/json' \
  -d "{\"text\":\"[${INC_ID}][${SEV}] ${TITLE}\\n${MENTION}\\n역할: IC(Incident Commander) / Ops Lead / Comms Lead 지정 필요\"}"

printf '%s | %s | declared | %s | %s\n' \
  "$(date -u +%FT%TZ)" "$INC_ID" "$SEV" "$TITLE" | tee -a "$LOG"
5. 인시던트 관리: 선언 기준, 역할, 소통, 심각도
인시던트 관리의 최대 실패 모드는 늦은 선언이다. “내가 좀 더 보면 원인을 알 것 같다”는 착각이 30분을 태운다. 기준을 미리 정해 기계적으로 선언하라.
선언 기준(하나라도 해당하면 선언): Sev1·Sev2 조건 충족, 도메인 지식 없이는 복구 불가, 두 팀 이상이 관련, 15분 내 원인 미상, 또는 대시보드가 빨간색인데 원인을 모를 때.
| 심각도 | 기준 | 대응 | 소통 주기 |
|---|---|---|---|
| Sev1 | 전 고객 서비스 중단, 데이터 손실 위험 | 전원 호출, IC 즉시 지정 | 15분 |
| Sev2 | 핵심 기능 저하, SLO 빠른 소진 | 온콜 + 서비스 오너 | 30분 |
| Sev3 | 부분 저하, 우회 가능 | 업무 시간 대응 | 일 1회 |
| Sev4 | 경미, 영향 미미 | 백로그 | — |
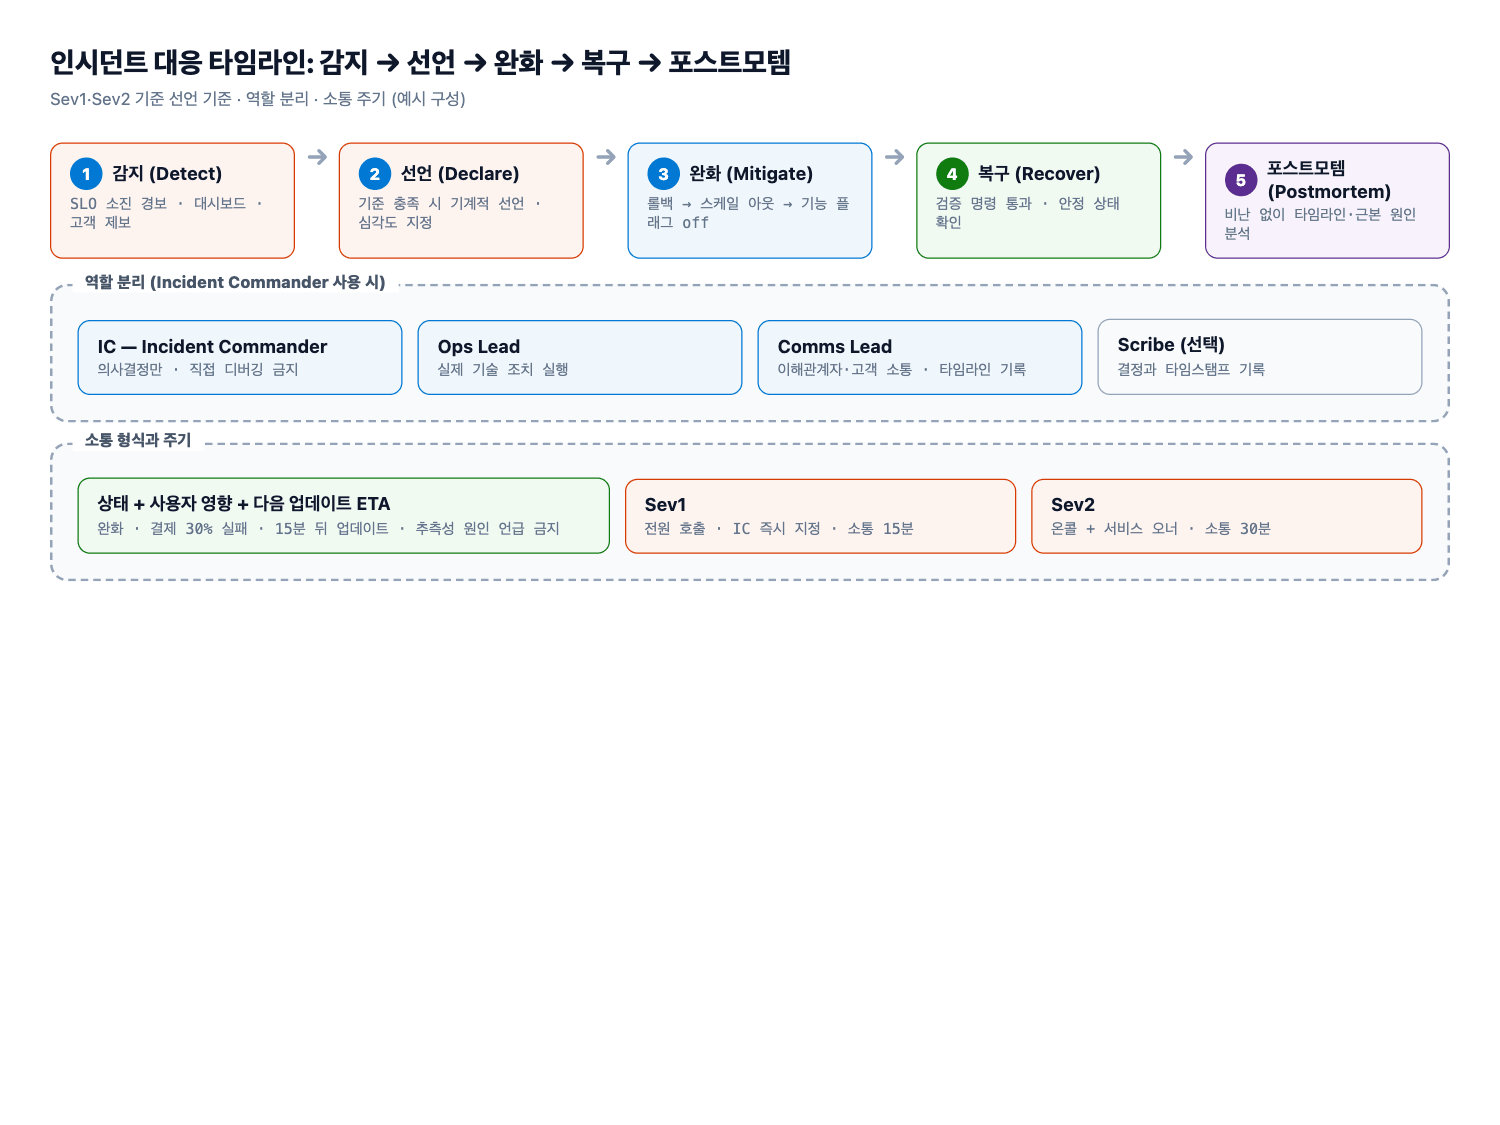
위 그림은 감지 → 선언 → 완화 → 복구 → 포스트모템으로 이어지는 인시던트 대응 타임라인과, 각 단계에서 나뉘는 역할(IC/Ops Lead/Comms Lead), 소통 형식과 주기를 함께 나타낸다. 완화 단계에서는 롤백이 항상 첫 번째 선택지다.
역할 분리(IC 사용 시):
- IC(Incident Commander): 의사결정만. 직접 디버깅 금지.
- Ops Lead: 실제 기술 조치 실행.
- Comms Lead: 이해관계자·고객 커뮤니케이션, 타임라인 기록.
- Scribe: 결정과 타임스탬프 기록(선택).
소통은 “원인”이 아니라 영향과 다음 업데이트 시각을 말한다. 형식: 상태(조사중/완화/복구) + 사용자 영향 + 다음 업데이트 ETA. 추측성 원인 언급은 Sev1에서 특히 위험하다.
# 커맨더용 즉석 진단 스니펫 (변경 없이 관찰만)
kubectl -n prod get pods -l app.kubernetes.io/name=checkout-api -o wide
kubectl -n prod rollout status deploy/checkout-api --timeout=60s
kubectl -n prod logs -l app.kubernetes.io/name=checkout-api --since=15m --tail=300 | grep -iE 'error|panic'
kubectl -n prod get events --sort-by=.lastTimestamp | tail -30
6. 비난 없는 포스트모템과 액션 아이템 추적
포스트모템(blameless postmortem)의 전제는 “사람은 자신이 가진 정보와 자원 안에서 최선의 판단을 했다”이다. 목적은 시스템 재설계지 개인 평가가 아니다.
문서 구성: 영향(고객·SLO 버짓 소모율) → 타임라인(타임스탬프 + 결정) → 근본 원인(트리거/조건/실패한 방어선) → 탐지·대응 품질 → 잘된 점 → 액션 아이템.
액션 아이템은 반드시 OWNER + 기한 + 검증 방법을 갖는다. 추적하지 않는 액션 아이템은 존재하지 않는 것과 같다.
# 액션 아이템을 이슈로 강제 등록 (기한 없는 항목은 실패 처리)
while IFS='|' read -r title owner due; do
  [[ -z "$owner" || -z "$due" ]] && { echo "MISSING OWNER/DUE: $title"; continue; }
  gh issue create --title "[postmortem] $title" \
    --assignee "$owner" --label "reliability" --milestone "$due"
done < action-items.txt
7. 런북(Runbook)과 플레이북(Playbook)
런북은 “지금 새벽 3시의 피곤한 내가 읽어도 동작하는” 문서다. 경보에는 반드시 런북 링크가 붙어 있어야 하고, 런북에는 복사해서 바로 실행 가능한 명령이 있어야 한다.
좋은 런북의 골격:
- 증상과 확인할 대시보드 링크(경보 이름과 일치)
- 영향 범위 판단(단일 AZ? 전 리전?)
- 완화 단계(롤백 → 스케일 아웃 → 기능 플래그 off 순서)
- 롤백 후 검증 명령
- 에스컬레이션 조건과 연락 대상
롤백이 1단계에 없으면 그것은 런북이 아니라 논문이다.
8. 카오스 엔지니어링: 가설을 실험으로 검증
카오스 엔지니어링은 무작위 파괴가 아니라 정상 상태(steady state) 가설을 세우고, 현실적 장애를 주입해 반증하는 실험이다. 순서: 정상 상태 정의 → 가설 → 최소 폭발 반경 → 주입 → 관찰 → 중단 조건.
에러 버짓이 있는 서비스에서만 한다. 버짓이 0이면 카오스도 멈춘다.
# chaos-network-delay.yaml
# 가설: 결제 게이트웨이 지연이 300ms여도 체크아웃 p99는 900ms 이내이고 에러율은 0.1% 미만이다.
apiVersion: chaos-mesh.org/v1alpha1
kind: NetworkChaos
metadata:
  name: checkout-api-payment-latency
  namespace: chaos-testing
spec:
  action: delay
  mode: fixed-percent
  value: "10"                 # 대상 파드의 10%만 (폭발 반경 축소)
  selector:
    namespaces: [prod]
    labelSelectors:
      app.kubernetes.io/name: checkout-api
  delay:
    latency: "300ms"
    correlation: "65"
    jitter: "40ms"
  direction: to
  target:
    mode: all
    selector:
      namespaces: [prod]
      labelSelectors:
        app.kubernetes.io/name: payment-gateway
  duration: "5m"
  scheduler:
    cron: "@every 30m"
주입 직후 반드시 확인할 것: SLI 그래프, 알림 발화 여부, 자동 완화(서킷 브레이커·재시도·HPA) 동작, 그리고 관찰자가 붙어 있는지.
kubectl -n chaos-testing apply -f chaos-network-delay.yaml
kubectl -n chaos-testing get networkchaos checkout-api-payment-latency -w
kubectl -n chaos-testing delete networkchaos checkout-api-payment-latency   # 중단 = 즉시 정리
9. 용량 계획과 부하 테스트
용량 계획은 “피크 예상치 × 안전 계수”로 노드/파드 한도를 정하고, 정기 부하 테스트로 가정을 검증하는 순환이다.
- 부하 모델: 피크 RPS, 동시 사용자, 요청당 비용(CPU/메모리), 데이터 증가율.
- 헤드룸: 목표 부하에서 노드 자원 60~70% 이하 유지(장애 시 재스케줄 여유).
- 부하 테스트는 운영과 같은 경로로: 스테이징이 축소 복제면 결과는 신뢰할 수 없다.
// load-test/k6-checkout.js  (k6 v0.50+)
import http from 'k6/http';
import { check, sleep } from 'k6';
import { Rate } from 'k6/metrics';

const checkoutErrors = new Rate('checkout_errors');

export const options = {
  scenarios: {
    ramp: {
      executor: 'ramping-arrival-rate',   // VU 수가 아니라 초당 도착률을 제어
      startRate: 10,
      timeUnit: '1s',
      preAllocatedVUs: 50,
      maxVUs: 600,
      stages: [
        { target: 100, duration: '2m' },  // 평시 2배
        { target: 300, duration: '5m' },  // 목표 피크
        { target: 400, duration: '3m' },  // 한계 탐색
        { target: 0,   duration: '1m' },
      ],
    },
  },
  thresholds: {
    http_req_duration: ['p(95)<400', 'p(99)<900'],
    http_req_failed: ['rate<0.01'],
    checkout_errors: ['rate<0.001'],
  },
};

export default function () {
  const res = http.post(
    `${__ENV.BASE_URL}/api/checkout`,
    JSON.stringify({ sku: 'SKU-1001', qty: 1 }),
    { headers: { 'Content-Type': 'application/json' }, tags: { flow: 'checkout' } },
  );
  check(res, { 'status 202': (r) => r.status === 202 });
  checkoutErrors.add(res.status >= 500);
  sleep(1);
}
# k6는 CI 임계값 실패 시 비-0 종료코드를 낸다 → 파이프라인 게이트로 사용
k6 run --env BASE_URL=https://staging.example.com \
  --out experimental-prometheus-rw \
  --tag testid="$(date -u +%Y%m%d-%H%M)" \
  load-test/k6-checkout.js
Locust도 동일한 목적이며, Python 기반 시나리오 작성이 편할 때 쓴다(예: 복잡한 로그인 플로우, 데이터 의존 시퀀스). 핵심은 도구가 아니라 임계값을 SLO와 일치시키는 것이다. p99 임계값이 SLO보다 느슨하면 테스트는 통과하지만 사용자는 불행하다.
10. 점진적 배포와 피처 플래그
배포 안전의 핵심은 “한 번에 바꾸지 않는다”이다. 카나리(canary) → 점진적 확대 → 자동 분석 실패 시 롤백.
# argo-rollouts-canary.yaml
apiVersion: argoproj.io/v1alpha1
kind: Rollout
metadata:
  name: checkout-api
  namespace: prod
spec:
  replicas: 20
  selector:
    matchLabels: { app: checkout-api }
  template:
    metadata:
      labels: { app: checkout-api }
    spec:
      containers:
        - name: app
          image: registry.example.com/checkout-api:1.42.0
          readinessProbe:
            httpGet: { path: /healthz, port: 8080 }
            initialDelaySeconds: 5
  strategy:
    canary:
      canaryService: checkout-api-canary
      stableService: checkout-api-stable
      trafficRouting:
        istio:
          virtualService:
            name: checkout-api-vs
      analysis:
        templates:
          - templateName: slo-error-ratio
        startingStep: 1
        args:
          - name: service
            value: checkout-api
      steps:
        - setWeight: 5
        - pause: { duration: 5m }
        - setWeight: 25
        - pause: { duration: 10m }
        - setWeight: 50
        - pause: { duration: 10m }
피처 플래그(feature flag)는 배포(deploy)와 릴리스(release)를 분리한다. 카나리로 트래픽을 제어하고, 플래그로 기능 노출을 제어한다. 플래그는 반드시 수명을 가져야 한다 — 영구 플래그는 설정 지옥을 만든다.
# 킬 스위치: 인시던트 중 즉시 기능 차단 (30초 내 완화)
curl -fsS -X PATCH "${FLAG_API}/flags/new-checkout-flow" \
  -H "Authorization: Bearer ${FLAG_TOKEN}" -H 'Content-Type: application/json' \
  -d '{"enabled": false, "rolloutPercentage": 0}'
플래그 위생 규칙: 생성 시 만료일 필수, 100% 롤아웃 후 30일 내 코드에서 제거, 플래그별 오너 지정, 플래그 상태를 배포 파이프라인에서 로그로 남김.
11. 변경 관리와 배포 안전장치
인시던트의 다수는 변경에서 발생한다. 따라서 변경 자체를 통제 대상으로 다룬다.
- 모든 변경은 코드/구성으로: 콘솔 클릭 변경은 재현·감사·롤백이 불가능하다(GitOps 권장).
- PR 게이트: SLO 영향 평가, 마이그레이션 여부, 롤백 계획 3항목 체크.
- 마이그레이션 분리: 스키마 변경은 “확장 → 이중 쓰기 → 전환 → 정리” 4단계로 나누고 각 단계를 독립 배포한다.
- 자동 롤백 조건: 카나리 분석 실패, 에러율 임계 초과, 지연 p99 초과.
- 동결(freeze) 창: 대형 이벤트, 연말, 주요 마케팅 기간에는 변경 동결 + 예외 승인 절차.
- 배포 관측: 배포 이벤트를 대시보드에 마커로 남긴다(
kubectl annotate+ 배포 툴 통합). 마커 없는 그래프는 해석이 불가능하다.
12. 실전 함정과 흔한 에러
함정 1 — SLI가 사용자가 아닌 서버를 본다. kubectl get pods의 Ready 개수는 SLI가 아니다. 로드밸런서/서비스 메시에서 성공 응답 비율을 뽑아라. 내부 헬스체크를 SLI에 섞으면 장애 중에도 초록색이 뜬다.
함정 2 — for:가 길어 탐지가 늦다. 급성 장애 경보에 for: 30m을 걸면 버짓이 다 탄 뒤에 온다. 빠른 소진은 for: 2m, 느린 소진은 for: 30m으로 분리한다.
함정 3 — 카나리 분석의 통계적 착시. 트래픽이 적은 새벽에 5% 카나리를 돌리면 표본이 부족해 분석이 무의미하거나 오탐이 난다. 최소 표본 수 조건을 넣고, 부족하면 pause로 전환한다.
함정 4 — 카오스 실험이 복구되지 않음. NetworkChaos를 지웠는데도 지연이 남는 경우가 있다. 실험에 duration을 반드시 넣고, NetworkChaos/PodChaos CR이 실제로 삭제됐는지, 대상 파드에 남은 tc 규칙이 없는지 확인한다.
| 흔한 에러 | 원인 | 해결 |
|---|---|---|
SLOErrorBudgetFastBurn이 트래픽 없는 시간에 발화 |
분모가 0에 가까워 비율이 NaN/왜곡 | clamp_min(sum(...), 1e-9) • 최소 요청량 조건 추가 |
k6 insufficient VUs / 부하가 목표 도착률에 못 미침 |
ramping-arrival-rate에 maxVUs 부족 |
preAllocatedVUs/maxVUs 상향, 테스트 전 부하 생성기 노드 확인 |
카나리가 ProgressDeadlineExceeded로 정체 |
새 버전 readiness probe 실패 | kubectl describe rollout로 조건 확인, probe 경로/타임아웃 수정 |
| 온콜 호출이 하루 20건 | 경보 임계값 미조정, 조치 불필요 알림 혼입 | 조치 불필요 알림 삭제/강등, for 및 임계값 재조정 |
| 포스트모템 액션 아이템이 사라짐 | 오너·기한 없는 항목 | 이슈 트래커 강제 등록 + 기한 없는 항목 자동 실패 처리 |
| 플래그가 100% 롤아웃 후에도 남음 | 만료 정책 부재 | 만료일 필수화, 코드 제거 티켓 자동 생성 |
13. 실무 체크리스트
- 모든 사용자 대면 서비스에 SLI/SLO가 정의되어 있고, SLI는 사용자 행동 기반 비율로 측정된다.
- 에러 버짓 정책 문서에 소진율별 행동(중단·동결)과 예외 승인자가 명시되어 있다.
- 멀티윈도우 소진률 경보가 구성되어 있고, 각 경보에 런북 링크가 붙어 있다.
- 토일 시간을 주 1회 정량 측정하고, 50% 초과 시 자동화 항목을 로드맵 최우선으로 올린다.
- 온콜 로테이션은 최소 2인 이상이며, 자동 에스컬레이션 경로와 호출량 상한이 설정되어 있다.
- 인시던트 선언 기준·심각도 매트릭스·역할(IC/Ops/Comms)이 문서화되어 있다.
- Sev1/Sev2마다 비난 없는 포스트모템을 작성하고, 액션 아이템은 오너·기한·검증 방법을 갖고 추적된다.
- 주요 경보마다 실행 가능한 명령이 포함된 런북이 있고, 최근 6개월 내 검증되었다.
- 에러 버짓이 남아 있는 동안 정기적으로 카오스 실험을 수행하고, 폭발 반경과 중단 조건을 사전에 정의한다.
- 부하 테스트 임계값이 SLO와 일치하며, 결과가 CI 게이트로 파이프라인을 차단한다.
- 배포는 카나리 + 자동 분석 + 자동 롤백으로 수행되고, 피처 플래그는 만료일과 오너를 갖는다.
14. 정리
- 완벽은 목표가 아니다. 100% 신뢰성은 비용만 키우므로, SLI로 측정하고 SLO로 목표를 정해 남는 에러 버짓을 릴리스 속도로 바꾼다.
- 경보는 정책과 함께 설계한다. 멀티윈도우 소진률 경보로 빠른 소진은 호출, 느린 누수는 티켓으로 나누고, 버짓 소진율별 행동(중단·동결)을 문서로 못박는다.
- 토일과 온콜은 시스템이다. 토일 시간을 주 1회 정량 측정해 자동화하고, 로테이션·에스컬레이션·호출량 상한으로 온콜 품질을 지킨다.
- 인시던트는 늦은 선언이 최대 실패 모드다. 기준을 미리 정해 기계적으로 선언하고, IC/Ops/Comms 역할을 나눠 영향과 다음 업데이트 시각만 소통한다.
- 학습은 비난 없이, 변경은 점진적으로. 비난 없는 포스트모템으로 오너·기한·검증이 있는 액션 아이템을 추적하고, 카나리·자동 롤백·피처 플래그로 배포를 안전하게 만든다.
References
- Google SRE Book — Embracing Risk (에러 버짓과 100% 신뢰성의 비용)
- Google SRE Book — Service Level Objectives (SLI·SLO·SLA)
- Google SRE Workbook — Alerting on SLOs (멀티윈도우 소진률 경보)
- Chaos Mesh Documentation — Simulate Network Chaos (NetworkChaos)
- Grafana k6 Documentation — Thresholds
- Argo Rollouts — Canary Deployment Strategy
댓글남기기