
쿠버네티스 스토리지와 데이터: Volume·PV/PVC·CSI와 StatefulSet DB 운영
이 시리즈는 쿠버네티스와 클라우드(AWS·GCP·Azure 공통 개념)를 실무 관점에서 정리한 기록이다. 핵심 개념·코드 예제·실전 함정(gotcha) 중심으로, 학습과 설계 리뷰·장애 대응에 바로 쓸 수 있게 구성했다. 각 편은 독립적으로 읽을 수 있고, 순서대로 보면 클러스터 내부 구조에서 클라우드 운영까지 하나의 흐름으로 이어진다.
컨테이너의 파일시스템은 이미지 레이어 위에 얹힌 임시 레이어(writable layer)라 컨테이너가 재시작되면 그 안의 쓰기는 모두 사라진다. 그래서 쿠버네티스(Kubernetes) 스토리지 설계의 본질은 “데이터의 수명(lifetime)을 파드(Pod)·노드(Node)·클러스터 중 어디에 묶을 것인가”를 명시적으로 결정하는 일이다. 이번 편에서는 쿠버네티스 네트워킹에서 외부 트래픽이 파드까지 도달하는 경로를 정리한 흐름을 이어, 파드가 사라져도 남아야 하는 데이터를 다루는 계층 — Volume 종류부터 PV/PVC 추상화, CSI 드라이버와 스냅샷, StatefulSet 기반 데이터베이스 운영, 백업/DR, 성능 튜닝, 그리고 데이터 유실 함정 — 을 운영 관점에서 정리한다.
- Volume 종류별 수명(lifetime)과 용도·제약을 비교하고, 상태 데이터에 무엇을 쓸지 판단 기준을 세운다
- PV/PVC/StorageClass의 역할과 동적 프로비저닝 흐름, RWO/RWX 접근 모드의 실제 의미를 구분한다
- CSI 드라이버 구성과 스냅샷 CRD, 복원 시의 일관성·토폴로지 제약을 이해한다
- StatefulSet과 Operator 패턴으로 데이터베이스를 운영할 때의 안티어피니티·PDB·업그레이드 순서를 정리한다
- 백업·DR 두 축과 성능 특성, 데이터 유실 함정·흔한 에러·실무 체크리스트를 점검한다
1. Volume 기초: 수명이 곧 설계다
Volume은 파드 스펙에 정의되고 파드와 함께 생성·소멸하는 스토리지 단위다. 파드 내 컨테이너들이 같은 Volume을 공유해 데이터를 주고받을 수 있고, 컨테이너 재시작에도 데이터가 유지된다. 문제는 파드가 삭제되거나 노드가 축출(eviction)될 때 어떤 Volume이 살아남는가이다.
1.1 Volume 종류 비교
| 종류 | 수명 | 용도 | 핵심 제약 |
|---|---|---|---|
emptyDir |
파드와 동일 | 스크래치, 캐시, 컨테이너 간 파일 공유 | 파드 삭제·노드 이동 시 삭제. medium: Memory면 tmpfs(메모리 과금) |
hostPath |
노드와 동일 | DaemonSet 로그/소켓 접근, 노드 로컬 캐시 | 노드에 데이터 고정, 보안 취약, 재스케줄링 시 데이터 없음 |
configMap / secret |
오브젝트 수명 | 설정·자격증명 주입 | 기본 read-only. subPath로 마운트하면 갱신이 반영되지 않음 |
ephemeral |
파드와 동일 (PVC는 파드가 소유) | CSI 기능을 쓰는 임시 볼륨 | 파드 삭제 시 PVC도 함께 삭제. 스냅샷/암호화/쿼터를 그대로 활용 가능 |
persistentVolumeClaim |
클러스터 수명 | DB, 큐, 업로드 파일 등 영속 데이터 | 접근 모드·AZ·성능 프로파일을 StorageClass로 결정 |
projected |
오브젝트 수명 | 여러 소스를 한 디렉터리로 병합 (SA 토큰 + CM + Secret) | — |
1.2 예제 1: emptyDir + configMap + secret 조합
apiVersion: v1
kind: Pod
metadata:
  name: app-with-volumes
spec:
  containers:
    - name: app
      image: nginx:1.27
      volumeMounts:
        - name: cache
          mountPath: /var/cache/app
        - name: config
          mountPath: /etc/app/config
          readOnly: true
        - name: creds
          mountPath: /etc/app/secrets
          readOnly: true
  volumes:
    - name: cache
      emptyDir:
        sizeLimit: 1Gi            # 노드 디스크 고갈 방지용 쿼터
    - name: config
      configMap:
        name: app-config
        items:
          - key: app.yaml
            path: app.yaml       # 파일명을 직접 지정
    - name: creds
      secret:
        secretName: app-secret
        defaultMode: 0400
1.3 ephemeral Volume
ephemeral Volume은 PV/PVC를 별도로 만들지 않고 파드 스펙 안에서 CSI 볼륨을 요청한다. 테스트용으로 쿼터·암호화가 적용된 빠른 볼륨이 필요할 때 유용하다.
volumes:
  - name: scratch
    ephemeral:
      volumeClaimTemplate:
        spec:
          accessModes: ["ReadWriteOnce"]
          storageClassName: gp3
          resources:
            requests:
              storage: 20Gi
2. PV / PVC / StorageClass — 선언적 스토리지
- PersistentVolume(PV): 클러스터 스코프의 실제 스토리지 자원. EBS 볼륨, NFS 익스포트, Ceph RBD 이미지 하나가 PV 하나에 대응한다. 네임스페이스에 속하지 않는다.
- PersistentVolumeClaim(PVC): 네임스페이스에 속하는 요청서. “100Gi, RWO, gp3”라고 선언하면 스토리지 컨트롤러(스토리지 조정 루프, reconciliation loop)가 조건에 맞는 PV를 바인딩하거나 새로 프로비저닝한다.
- StorageClass(SC): 프로비저너(provisioner), 파라미터, 리클레임 정책(reclaimPolicy), 바인딩 모드(volumeBindingMode)를 담은 템플릿.
storageClassName: ""는 정적 바인딩 전용, 미지정은 기본 SC 사용을 의미한다.
2.1 동적 프로비저닝 흐름
- PVC 생성 → 2.
volumeBindingMode: WaitForFirstConsumer면 파드 스케줄까지 보류 → 3. 스케줄러가 노드를 결정하면 토폴로지(AZ)에 맞춰 CSICreateVolume호출 → 4. PV 생성 및 PVC 바인딩 → 5. kubelet이 노드에서 attach/mount → 6. 파드 기동.
Immediate 모드는 PVC 생성 즉시 볼륨을 만들기 때문에 AZ가 임의로 정해지고, 이후 파드가 다른 AZ 노드에 스케줄되면 FailedScheduling이 발생한다. 멀티 AZ 클러스터에서는 항상 WaitForFirstConsumer를 기본으로 삼는다.
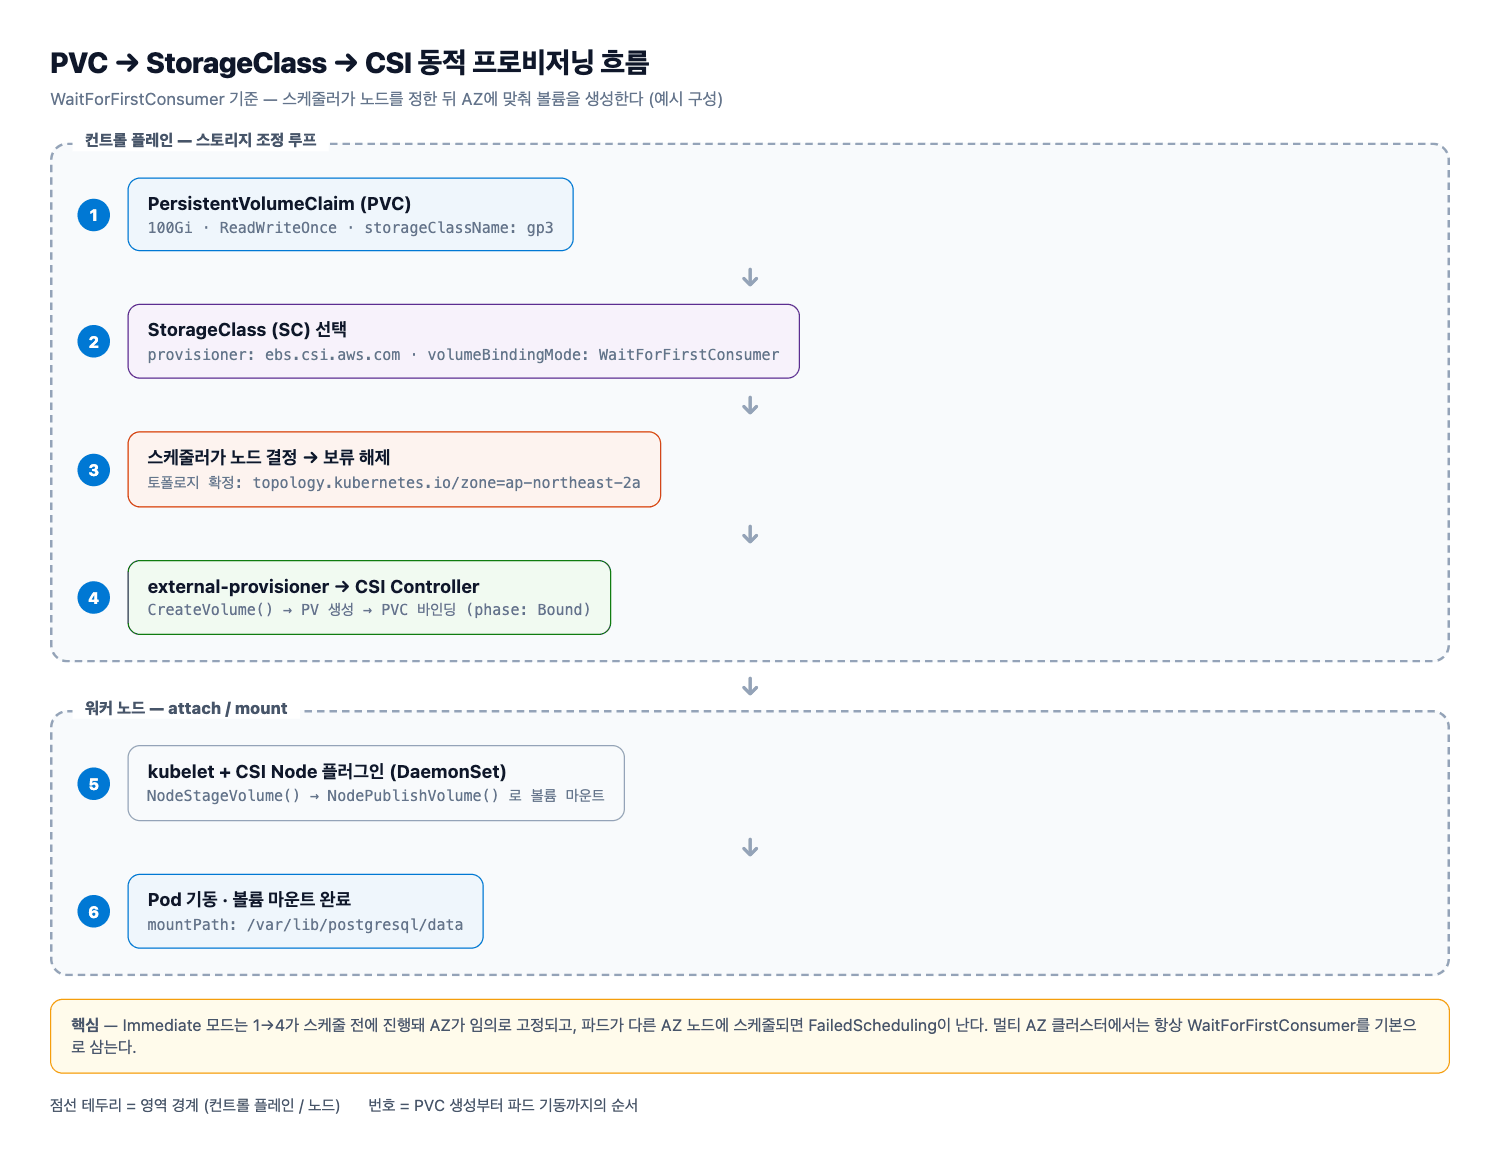
위 다이어그램은 PVC가 StorageClass의 프로비저너를 거쳐 CSI 드라이버의 CreateVolume을 호출하고, 생성된 PV가 다시 PVC에 바인딩된 뒤 kubelet이 노드에서 attach/mount하는 동적 프로비저닝 경로를 보여준다. WaitForFirstConsumer에서는 이 경로가 스케줄러의 노드 결정 이후에 시작되므로, 볼륨의 AZ가 파드가 놓일 노드와 어긋나지 않는다.
| 항목 | 정적 프로비저닝 | 동적 프로비저닝 |
|---|---|---|
| 볼륨 생성 주체 | 관리자가 PV 사전 생성 | CSI 프로비저너 |
| 확장성 | 수십 개 수준 | 수천 개(PVC당 1볼륨) |
| 토폴로지 제어 | PV에 nodeAffinity 수동 지정 |
allowedTopologies / 자동 |
| 용도 | 온프레미스 NFS, 레거시 SAN | 클라우드 기본값 |
2.2 예제 2: StorageClass + StatefulSet volumeClaimTemplates
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: gp3
provisioner: ebs.csi.aws.com
volumeBindingMode: WaitForFirstConsumer
allowVolumeExpansion: true
reclaimPolicy: Retain          # PVC 삭제 시 볼륨 보존(수동 정리)
parameters:
  type: gp3
  fsType: ext4
  encrypted: "true"
  iops: "6000"
  throughput: "250"
allowedTopologies:
  - matchLabelExpressions:
      - key: topology.kubernetes.io/zone
        values: ["ap-northeast-2a", "ap-northeast-2c"]
---
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: pg
spec:
  serviceName: pg-headless
  replicas: 3
  selector:
    matchLabels: { app: pg }
  template:
    metadata:
      labels: { app: pg }
    spec:
      containers:
        - name: postgres
          image: postgres:16
          ports:
            - name: pg
              containerPort: 5432
          volumeMounts:
            - name: data
              mountPath: /var/lib/postgresql/data
  volumeClaimTemplates:
    - metadata:
        name: data
      spec:
        accessModes: ["ReadWriteOnce"]
        storageClassName: gp3
        resources:
          requests:
            storage: 100Gi
volumeClaimTemplates로 만든 PVC는 data-pg-0, data-pg-1처럼 파드 순번 기반 이름을 갖는다. 스케일 다운 시 쿠버네티스는 PVC를 삭제하지 않는다(의도적 안전장치). 반대로 Helm uninstall이나 네임스페이스 삭제는 PVC를 지우므로 helm.sh/resource-policy: keep 애노테이션을 쓰거나 reclaimPolicy를 Retain으로 두는 편이 안전하다. 또한 volumeClaimTemplates는 생성 후 필드 수정이 금지되므로, 용량 증설은 PVC를 개별 패치한다.
# StatefulSet PVC 용량 확장 (SC에 allowVolumeExpansion: true 필요)
kubectl patch pvc data-pg-0 -p '{"spec":{"resources":{"requests":{"storage":"200Gi"}}}}'
kubectl get pvc data-pg-0 -w   # FileSystemResizePending → 용량 반영 확인
3. 접근 모드(Access Mode)의 실제 의미
접근 모드는 실제로 스토리지 백엔드가 무엇을 지원하는지를 나타내며, 특히 RWO의 의미가 자주 오해된다.
| 모드 | 축약 | 실제 의미 | 대표 백엔드 |
|---|---|---|---|
ReadWriteOnce |
RWO | 단일 노드에서 read-write 마운트. 같은 노드의 여러 파드는 동시에 쓸 수 있다 | EBS, GCE PD, 로컬 NVMe |
ReadOnlyMany |
ROX | 여러 노드에서 read-only | NFS, EFS, CephFS |
ReadWriteMany |
RWX | 여러 노드에서 read-write (동시 쓰기 정합성은 파일시스템이 보장) | EFS, Azure Files, CephFS |
ReadWriteOncePod |
RWOP | 단일 파드만 read-write (K8s 1.29 GA). CSI 드라이버 지원 필요 | EBS CSI 최신 버전 등 |
핵심 함정은 이렇다. “RWO는 파드 하나만 붙일 수 있다”는 설명은 틀렸다. RWO 볼륨을 서로 다른 노드의 두 파드가 쓰면 두 번째 파드는 Multi-Attach error for volume로 실패한다. 반대로 같은 노드에 공존하면 성공한다. 반면 ReadWriteMany를 선언하는 순간 EBS 같은 블록 스토리지는 프로비저닝을 거부한다. 롤링 업데이트 시 strategy: Recreate 또는 ReadWriteOncePod를 쓰면 두 파드가 동시에 같은 볼륨을 잡는 사고를 구조적으로 막을 수 있다.
4. CSI와 스냅샷
CSI(Container Storage Interface)는 kubelet·컨트롤러가 벤더 드라이버와 통신하는 표준 gRPC API다. 인트리(in-tree) 플러그인은 CSI 마이그레이션을 거쳐 제거 추세이므로, 신규 클러스터는 항상 CSI 드라이버를 설치한다.
구성 요소는 다음과 같다.
- Controller 플러그인(Deployment):
CreateVolume,DeleteVolume,CreateSnapshot, attach/detach 담당. 노드와 무관하게 동작. - Node 플러그인(DaemonSet):
NodeStageVolume,NodePublishVolume담당. 노드별 DaemonSet이 없으면 마운트가 실패한다. - external-provisioner / attacher / resizer / snapshotter: 사이드카로 붙어 CSI 호출을 쿠버네티스 오브젝트와 연결한다.
- 토폴로지:
NodeGetInfo가 AZ·리전을 보고하면 스케줄러가 반영한다. EBS는 AZ 스코프, EFS는 리전 스코프다.
4.1 예제 3: CSI 스냅샷 생성과 복원
스냅샷은 snapshot.storage.k8s.io/v1 CRD(VolumeSnapshotClass/VolumeSnapshot/VolumeSnapshotContent)와 스냅샷 컨트롤러 설치가 선행돼야 한다.
apiVersion: snapshot.storage.k8s.io/v1
kind: VolumeSnapshotClass
metadata:
  name: csi-snapclass
driver: ebs.csi.aws.com
deletionPolicy: Retain     # 스냅샷 오브젝트 삭제 시 실제 스냅샷 보존
parameters:
  tagSpecification_1: "Name=pg-nightly"
---
apiVersion: snapshot.storage.k8s.io/v1
kind: VolumeSnapshot
metadata:
  name: pg-data-snap
  namespace: db
spec:
  volumeSnapshotClassName: csi-snapclass
  source:
    persistentVolumeClaimName: data-pg-0
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: pg-data-restored
  namespace: db
spec:
  accessModes: ["ReadWriteOnce"]
  storageClassName: gp3
  resources:
    requests:
      storage: 100Gi
  dataSource:
    name: pg-data-snap
    kind: VolumeSnapshot
    apiGroup: snapshot.storage.k8s.io
kubectl get volumesnapshot -n db
kubectl describe volumesnapshot pg-data-snap -n db   # ReadyToUse: true 확인
주의할 점이 있다. 스냅샷은 크래시 일관성(crash-consistent)만 보장한다. PostgreSQL은 pg_backup_start/pg_stop_backup 또는 WAL 아카이빙과 조합해야 일관 복원이 가능하다. 복원된 볼륨은 스냅샷이 존재하는 AZ에 생성되며, 원본과 다른 AZ를 요구하면 실패한다.
5. StatefulSet + 데이터베이스 운영
StatefulSet은 ① 안정적이고 예측 가능한 파드 이름(pg-0, pg-1), ② 순번 기반 PVC, ③ 순차적 롤아웃/롤백, ④ 헤드리스 서비스(clusterIP: None)를 통한 개별 DNS(pg-0.pg-headless.db.svc)를 제공한다. 데이터베이스가 자기 복제본을 찾아 클러스터를 구성하려면 이 정체성(identity)이 필수다.
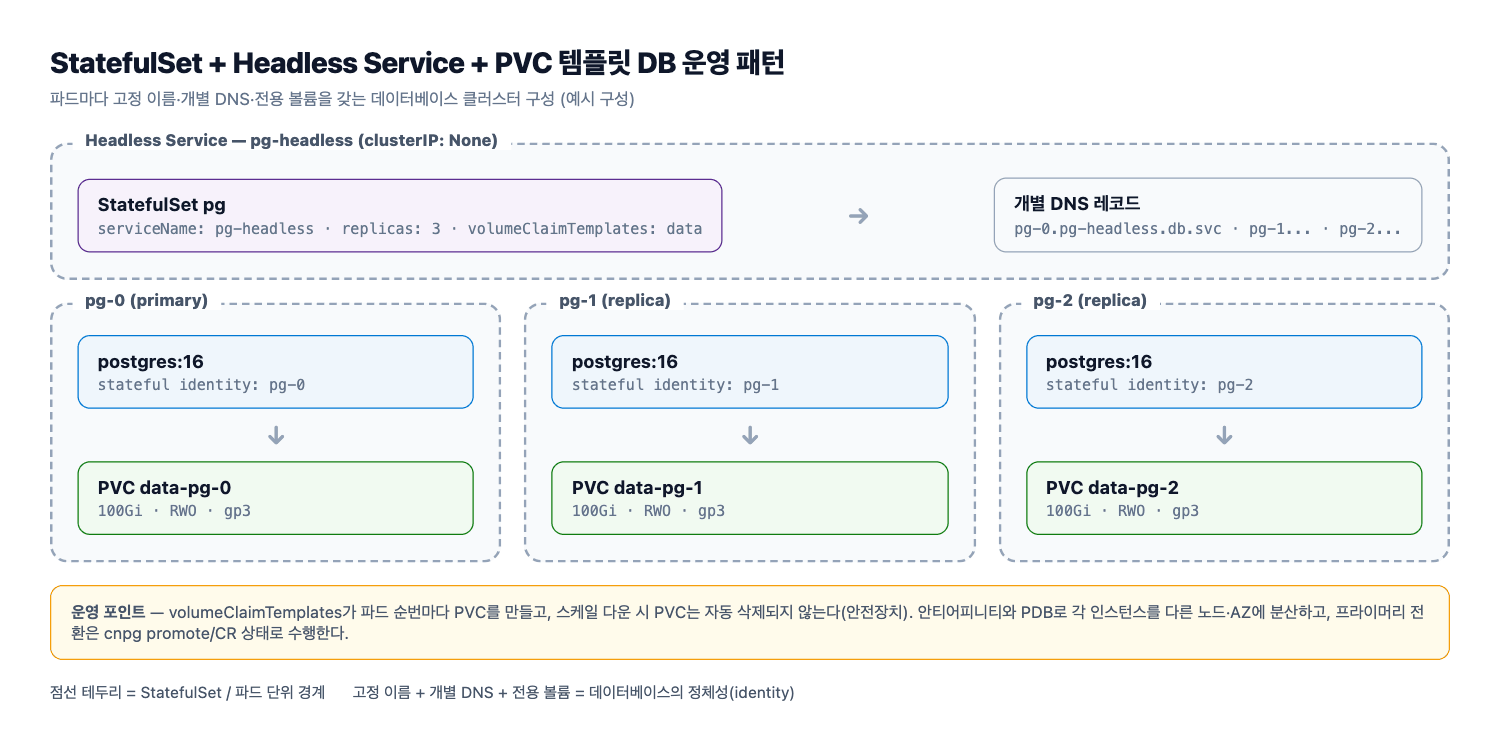
위 그림은 헤드리스 서비스가 각 파드에 개별 DNS를 부여하고, volumeClaimTemplates가 파드 순번마다 PVC를 따로 만들어 각 인스턴스가 자기 데이터 볼륨을 갖는 구조를 나타낸다. 스케일 다운이나 롤아웃에서도 파드 이름과 볼륨이 짝을 유지하기 때문에, 복제본끼리 서로를 식별하는 데이터베이스 클러스터 운영이 가능해진다.
5.1 Operator 패턴
원시 StatefulSet + ConfigMap으로 PostgreSQL을 운영하면 페일오버, 복제 슬롯, 백업 검증, 업그레이드 순서를 모두 수동 스크립트로 관리해야 한다. Operator는 데이터베이스 도메인 지식을 조정 루프로 코드화한 컨트롤러다.
| Operator | 대상 | 특징 |
|---|---|---|
| CloudNativePG | PostgreSQL | 파드 1개 = 인스턴스 1개, 선언적 선언, WAL 아카이빙 내장 |
| Zalando postgres-operator | PostgreSQL | Patroni 기반 HA, postgresql CR |
| Crunchy PGO | PostgreSQL | PgBouncer·모니터링·백업 통합 |
| Percona / Oracle MySQL Operator | MySQL | Group Replication, 백업 스케줄 |
| Vitess | MySQL 샤딩 | 대규모 샤딩·프록시 |
| Redis / Strimzi(Kafka) | 캐시·스트리밍 | 클러스터 토폴로지 관리 |
5.2 예제 4: CloudNativePG 클러스터
apiVersion: postgresql.cnpg.io/v1
kind: Cluster
metadata:
  name: pg-cluster
  namespace: db
spec:
  instances: 3
  imageName: ghcr.io/cloudnative-pg/postgresql:16.4
  storage:
    size: 100Gi
    storageClass: gp3
  walStorage:                 # WAL 전용 볼륨 분리 → 스냅샷/복구 단순화
    size: 50Gi
    storageClass: gp3
  postgresql:
    parameters:
      max_connections: "300"
      shared_buffers: "4GB"
      synchronous_commit: "on"   # 명시적 동기 복제 제어
  resources:
    requests: { cpu: "2", memory: 8Gi }
    limits:   { memory: 8Gi }
  backup:
    barmanObjectStore:
      destinationPath: s3://my-pg-backup/cluster
      s3Credentials:
        inheritFromIAMRole: true   # IRSA 사용
      wal:
        compression: gzip
    retentionPolicy: "30d"
  monitoring:
    enablePodMonitor: true
---
apiVersion: postgresql.cnpg.io/v1
kind: ScheduledBackup
metadata:
  name: pg-nightly
  namespace: db
spec:
  schedule: "0 0 3 * * *"      # 초 단위 6필드 cron
  backupOwnerReference: self
  cluster:
    name: pg-cluster
운영 포인트:
- 안티어피니티(anti-affinity) 로 각 인스턴스를 다른 노드/AZ에 분산한다. CloudNativePG는 기본적으로 soft anti-affinity를 걸지만, 노드가 부족하면 두 인스턴스가 같은 노드에 몰려 SPOF가 된다.
- PDB(PodDisruptionBudget) 를 설정해 노드 드레인 시 쿼럼이 동시에 깨지지 않게 한다.
- 프라이머리 강제 전환은
kubectl delete pod대신cnpg promote/CR 상태를 통해 수행한다. - 업그레이드는 minor 버전 → 이미지 태그 변경 → 롤링 순서로, 메이저 버전은
pg_upgrade경로를 문서화한다.
6. 백업·복원과 DR
두 축을 구분해야 한다.
- 애플리케이션 인지 백업:
pg_basebackup+ WAL 아카이빙,mysqldump/XtraBackup. PITR(Point-In-Time Recovery) 가능. 반드시 별도 스토리지(S3 등)에 저장한다. - 볼륨 스냅샷/파일 백업: CSI 스냅샷 또는 Velero. 상태 전체를 일괄 보호하고 재해 복구(DR)에 강하다.
6.1 예제 5: Velero 설치와 백업/복원
# 설치: S3 백엔드 + 노드 에이전트(Kopia) 로 파일 수준 백업
velero install \
  --provider aws \
  --plugins velero/velero-plugin-for-aws:v1.10.0 \
  --bucket my-velero-backup \
  --backup-location-config region=ap-northeast-2 \
  --snapshot-location-config region=ap-northeast-2 \
  --use-node-agent \
  --default-volumes-to-fs-backup

# 네임스페이스 단위 백업 (스냅샷 + 파일 백업 병행)
velero backup create app-daily \
  --include-namespaces app,db \
  --snapshot-volumes \
  --ttl 720h \
  --wait

# 정기 스케줄
velero schedule create nightly --schedule="0 2 * * *" --include-namespaces app,db --ttl 720h

# 다른 네임스페이스로 복원 (검증 리허설)
velero restore create app-restore-test \
  --from-backup app-daily \
  --namespace-mappings app:app-restore \
  --include-namespaces app

velero backup describe app-daily --details
velero restore logs app-restore-test
DR 전략은 RPO/RTO로 결정한다. 콜드 DR(백업에서 몇 시간 내 복원, 클러스터 교체 포함)은 Velero + 앱 인지 백업으로 충분하고, 웜/핫 DR(수 분 내)은 다른 리전에 스트리밍 복제본(PostgreSQL 스트리밍 복제, Aurora Global Database, EFS Replication)을 상시 유지해야 한다. 리전 간 백업 버킷은 반드시 크로스 리전 복제를 켠다.
복원 리허설 없는 백업은 백업이 아니다. 분기마다 실제 네임스페이스 복원 → 애플리케이션 기동 → 데이터 정합성 검증 순서를 자동화한다.
7. 성능: 로컬 SSD vs 네트워크 스토리지
데이터베이스 성능은 대부분 fsync 지연(latency) 과 IOPS 에서 결정된다.
| 유형 | 지연 | IOPS 특성 | 용도 |
|---|---|---|---|
| 로컬 NVMe(instance store) | 수십~수백 µs | 수십만 IOPS | 캐시, 임시 처리, 복제 가능한 상태 |
| 프로비저닝된 블록(EBS gp3) | 수백 µs~수 ms | 기본 3,000 IOPS / 125 MiB/s, 최대 16,000 / 1,000 MiB/s | 일반 DB, 대부분의 영속 볼륨 |
| 고성능 블록(io2 Block Express) | 수백 µs~1 ms | 최대 256,000 IOPS / 4,000 MiB/s | 대규모 OLTP |
| 네트워크 파일(EFS/NFS) | 수 ms | 처리량 기반, 메타데이터 연산 느림 | 공유 파일, RWX가 필요한 앱 |
| 오브젝트(S3) | 수십 ms | 무제한 처리량 | 백업, 미디어, 데이터 레이크 |
실전 규칙:
- WAL과 데이터 파일을 같은 볼륨에 두면 fsync 경합이 커진다. 가능하면
walStorage를 분리한다. - gp3는 IOPS와 처리량을 독립적으로 올릴 수 있다. 초당 3,000 IOPS 미달이면
iops파라미터를 조정한다. - EFS는
Elastic처리량 모드가 무난하지만stat/fsync가 느리므로 DB 데이터 디렉터리로는 부적합하다. - 노드 로컬 디스크를 쓰더라도 데이터 복제는 애플리케이션 계층에서 보장해야 한다(예: 3복제 인스턴스 + anti-affinity).
- 노드에 동시 붙는 볼륨 수와 인스턴스 제한(EBS는 인스턴스 타입별 볼륨 수·대역폭 한계) 을 사전에 확인한다.
7.1 예제 6: Terraform(HCL)로 EBS CSI와 StorageClass 프로비저닝
terraform {
  required_providers {
    aws        = { source = "hashicorp/aws", version = "~> 5.60" }
    kubernetes = { source = "hashicorp/kubernetes", version = "~> 2.31" }
  }
}

resource "aws_eks_addon" "ebs_csi" {
  cluster_name                = aws_eks_cluster.main.name
  addon_name                  = "aws-ebs-csi-driver"
  service_account_role_arn    = aws_iam_role.ebs_csi.arn
  resolve_conflicts_on_update = "OVERWRITE"
}

resource "kubernetes_storage_class_v1" "gp3" {
  metadata {
    name = "gp3"
    annotations = {
      "storageclass.kubernetes.io/is-default-class" = "true"
    }
  }
  storage_provisioner    = "ebs.csi.aws.com"
  volume_binding_mode    = "WaitForFirstConsumer"
  allow_volume_expansion = true
  reclaim_policy         = "Retain"
  parameters = {
    type      = "gp3"
    fsType    = "ext4"
    encrypted = "true"
  }
}
8. 파일 · 블록 · 오브젝트 스토리지 비교
| 항목 | 파일(File) | 블록(Block) | 오브젝트(Object) |
|---|---|---|---|
| 접근 방식 | NFS/SMB 마운트 | 디바이스로 attach 후 파일시스템 | HTTP API (S3/GCS) |
| 접근 모드 | RWX/ROX 가능 | 보통 RWO | 앱이 SDK로 직접 |
| 지연 | 수 ms | 수백 µs~ms | 수십 ms |
| 확장성 | 중간~높음 | 볼륨당 수 TB | 무제한 |
| 동시 쓰기 | 파일 락으로 조정 | 파일시스템 의존 | 객체 단위 원자적 교체 |
| K8s 연동 | PV + RWX | PV + RWO | CSI(예: Mountpoint S3) 또는 앱 직접 |
| 비용 | 중간 | 높음 | 저렴 |
| 대표 예 | EFS, Azure Files | EBS, GCE PD | S3, GCS, MinIO |
선택 기준은 단순하다. 여러 노드가 동시에 같은 파일 트리를 읽고 써야 하면 파일, 단일 인스턴스가 낮은 지연으로 DB를 돌려야 하면 블록, 대용량 비정형 데이터와 백업이면 오브젝트다. 오브젝트 스토어를 파일시스템처럼 마운트하는 것은 편의 기능이며, 무작위 쓰기·작은 파일 연산에는 성능이 급격히 나빠진다.
9. 데이터 유실 함정 모음
- emptyDir에 상태 저장: 파드 재시작은 버티지만 파드 삭제·노드 축출·
kubectl rollout restart에서 삭제된다. 로그·캐시 전용으로만 쓴다. - hostPath로 노드 고정: Deployment가 다른 노드로 스케줄되면 데이터가 없고, 같은 노드에 묶어두면 노드 장애가 곧 서비스 장애다. 반드시 DaemonSet + 재생성 가능한 데이터만.
- reclaimPolicy
Delete+ PVC 삭제: PVC를 지우면 클라우드 볼륨이 삭제된다. 상태 저장 워크로드는Retain을 기본으로 검토한다. - RWO 볼륨의 재스케줄링: 파드가 강제 삭제되고 새 노드에 뜨면 기존 노드의 attach가 해제될 때까지
Multi-Attach error가 난다.terminationGracePeriodSeconds와 볼륨 detach 시간을 고려한다. - StatefulSet 스케일 다운 후 PVC 잔존: 반대로 의도치 않은 네임스페이스 삭제는 PVC까지 지운다.
resource-policy: keep을 붙인다. - AZ 고정: EBS PV는 AZ 종속이다. 노드풀이 여러 AZ면
WaitForFirstConsumer가 필수이며, 복원된 볼륨도 같은 AZ 규칙을 따른다. - subPath로 configMap 마운트: 파일이 갱신돼도 컨테이너 내부가 갱신되지 않는다. 전체 디렉터리 마운트 또는 해시 기반 롤아웃을 쓴다.
- 스냅샷을 백업으로 착각: 스냅샷은 같은 리전·같은 저장소에 종속된다. 리전 장애 대비는 크로스 리전 복제 + 애플리케이션 백업으로 보완한다.
10. 흔한 에러 → 원인 → 해결
| 증상 | 원인 | 해결 |
|---|---|---|
pod has unbound immediate PersistentVolumeClaims |
WaitForFirstConsumer인데 스케줄 가능 노드가 없거나 용량 부족 |
노드 가용성·리소스 쿼터·SC allowedTopologies 확인 |
Multi-Attach error for volume ... already used by pod(s) |
RWO 볼륨이 다른 노드에 attach된 상태에서 새 파드 기동 | 기존 파드 종료 후 detach 대기, 같은 노드로 스케줄, 또는 RWX/ReadWriteOncePod로 전환 |
FailedMount: timeout expired waiting for volumes to attach or mount |
CSI node DaemonSet 미기동, AZ 불일치, IRSA 권한 없음 | kubectl -n kube-system get pod -l app=ebs-csi-node, 볼륨 AZ, 서비스 어카운트 롤 확인 |
the server doesn't have a resource type "volumesnapshots" |
external-snapshotter CRD/컨트롤러 미설치 | snapshot.storage.k8s.io CRD와 컨트롤러 설치 후 재시도 |
ReadWriteOncePod volume is already exclusively attached |
같은 볼륨을 쓰는 파드가 이미 Running | 기존 파드를 종료하거나 --cascade=orphan 없이 순차 재기동 |
Permission denied (마운트 후 파일 접근) |
fsGroup/UID 불일치, defaultMode 과도하게 제한 |
securityContext.fsGroup 지정, Secret defaultMode: 0444 조정 |
11. 실무 체크리스트
- 모든 상태 저장 워크로드에 StorageClass를 명시하고, 기본 SC 암묵 사용을 금지했는가?
- 멀티 AZ 클러스터에서
volumeBindingMode: WaitForFirstConsumer가 모든 SC에 적용됐는가? reclaimPolicy(Delete/Retain)와 StatefulSet PVC 보존 정책, Helmresource-policy: keep을 문서화했는가?allowVolumeExpansion: true를 켜고 PVC 확장 절차와 파일시스템 리사이즈를 실제로 검증했는가?- RWO/RWX 요구사항을 워크로드별로 정리하고, RWX가 필요한 지점만 파일 스토리지로 분리했는가?
- 데이터베이스에 안티어피니티 + PDB + 리소스 requests/limits 를 설정했는가?
- 백업을 (a) 애플리케이션 인지 백업과 (b) Velero/스냅샷 두 축으로 운영하고, 복원 리허설을 정기적으로 수행하는가?
- 로컬 NVMe를 쓰는 워크로드는 데이터를 애플리케이션 계층에서 복제하며, 노드 장애 시 복구 절차가 있는가?
- emptyDir/hostPath 사용 위치를 인벤토리화하고, 상태 데이터가 들어가지 않도록 리뷰 프로세스에 포함했는가?
- 볼륨 IOPS/지연, CSI 컨트롤러·노드 플러그인 상태, 스냅샷 성공률을 모니터링 알림으로 연결했는가?
12. 정리
- 수명을 먼저 정한다. Volume은 파드·노드·클러스터 수명 중 어디에 데이터를 묶을지의 선언이다. emptyDir·hostPath는 재생성 가능한 데이터에만 쓰고, 영속 데이터는 PVC로 뺀다.
- 요청과 구현을 분리한다. PVC가 요구사항을 선언하고 StorageClass가 프로비저너·토폴로지·리클레임을 결정한다. 멀티 AZ에서는
WaitForFirstConsumer가 기본이다. - 접근 모드는 백엔드의 능력이다. RWO는 노드 단위 제약이라 다른 노드의 두 파드는
Multi-Attach error로 실패한다. RWX가 필요하면 파일 스토리지로 분리한다. - CSI와 StatefulSet이 데이터를 떠받친다. 표준 gRPC 드라이버가 프로비저닝·스냅샷·토폴로지를 담당하고, StatefulSet의 정체성과 순번 PVC가 데이터베이스 클러스터를 가능하게 한다.
- 백업은 두 축, 복구는 리허설까지. 애플리케이션 인지 백업과 스냅샷/Velero를 함께 운영하고, RPO/RTO에 맞춰 콜드·웜/핫 DR을 고른 뒤 복원 리허설로 검증한다.
References
- Kubernetes Documentation — Volumes
- Kubernetes Documentation — Persistent Volumes (PV/PVC, 접근 모드, 리클레임 정책)
- Kubernetes Documentation — Storage Classes (동적 프로비저닝, volumeBindingMode, 확장)
- Kubernetes Documentation — Volume Snapshots (CSI 스냅샷 CRD)
- Kubernetes Documentation — StatefulSets (정체성, volumeClaimTemplates)
- Velero Documentation — File System Backup (노드 에이전트 기반 백업/복원)
댓글남기기