
쿠버네티스 네트워킹: Service·Ingress·CNI·NetworkPolicy
이 시리즈는 쿠버네티스와 클라우드(AWS·GCP·Azure 공통 개념)를 실무 관점에서 정리한 기록이다. 핵심 개념·코드 예제·실전 함정(gotcha) 중심으로, 학습과 설계 리뷰·장애 대응에 바로 쓸 수 있게 구성했다. 각 편은 독립적으로 읽을 수 있고, 순서대로 보면 클러스터 내부 구조에서 클라우드 운영까지 하나의 흐름으로 이어진다.
쿠버네티스 네트워킹의 핵심은 “모든 파드(Pod)는 고유 IP를 갖고, NAT 없이 서로 통신한다”는 평탄한(flat) 모델이다. 이번 편에서는 Kubernetes 기본 개념 정리에서 잡은 오브젝트 감각을 전제로, 이 모델 위에 Service가 안정적인 가상 IP를 얹고 Ingress/Gateway API가 L7 진입점을 만들며, CNI 플러그인이 실제 패킷 전달과 NetworkPolicy(네트워크 정책) 집행을 담당하는 구조를 다룬다. 실무 장애의 대부분은 이 계층 경계(어디서 NAT가 걸리고, 어디서 DNS가 풀리고, 어디서 정책이 드롭하는지)를 구분하지 못해 발생하므로, 각 컴포넌트의 책임 범위를 명확히 하는 데 초점을 둔다. 다음 편인 쿠버네티스 스토리지와 데이터에서는 PV/PVC·CSI와 StatefulSet 기반 DB 운영을 이어서 살펴본다.
- 파드마다 고유 IP를 주는 IP-per-Pod 모델과 네트워크 3원칙, IPAM 구조를 확인한다
- Cilium·Calico를 데이터플레인·정책·라우팅 기준으로 비교하고 선택 기준을 세운다
- Service 4종과 kube-proxy(iptables/IPVS/eBPF), EndpointSlice 동작을 정리한다
- Ingress와 Gateway API의 책임 분리, CoreDNS 디스커버리와 NetworkPolicy 화이트리스트 설계를 짚는다
- MTU·conntrack 함정과 계층별 트러블슈팅 절차, 실무 체크리스트를 정리한다
1. IP-per-Pod 모델
1.1 파드마다 고유 IP
쿠버네티스는 파드마다 클러스터 전역에서 라우팅 가능한 고유 IP를 부여한다. 한 파드 안의 컨테이너들은 같은 네트워크 네임스페이스(network namespace)를 공유하므로 localhost로 통신하고, 포트 충돌 없이 사이드카를 붙일 수 있다. 이 설계의 이점은 명확하다.
- 컨테이너 간 포트 매핑/NAT가 필요 없다 → 서비스 메시 사이드카, 로그 수집기가 자연스럽게 동작
- 노드 간 파드 통신은 라우팅 또는 오버레이로 해결하고, 애플리케이션은 IP를 그대로 본다
- 노드의 host 네트워크와 파드 네트워크가 분리되어
net.ipv4.ip_forward·iptables 규칙이 호스트 서비스를 오염시키지 않는다
전제 조건(쿠버네티스 네트워크 모델 3원칙)은 다음과 같다. ① 모든 파드는 NAT 없이 다른 모든 파드와 통신 가능 ② 모든 노드는 NAT 없이 모든 파드와 통신 가능 ③ 파드가 보는 자기 IP는 다른 파드가 보는 그 IP와 동일. ③이 깨지면(예: 잘못된 마스커레이드) 서비스 디스커버리, TLS SAN 검증, 세션 유지가 연쇄적으로 무너진다.
1.2 주소 할당과 IPAM
주소 할당은 IPAM(IP Address Management)이 담당한다. 클러스터 --cluster-cidr(예: 10.244.0.0/16)를 노드별 podCIDR(예: /24)로 쪼개 배분하고, 노드 내부에서는 CNI 플러그인의 IPAM이 개별 파드 IP를 할당한다. 노드당 파드 수가 110개(기본)라면 /24(254개)로 충분하지만, 노드 스펙을 키웠다면 --max-pods와 podCIDR 크기를 함께 재검토해야 한다.
2. CNI 플러그인: Cilium vs Calico
CNI(Container Network Interface)는 kubelet이 파드 생성 시 호출하는 규격이다. kubelet은 CRI를 통해 샌드박스를 만들고, CNI 플러그인에게 netns 경로와 파드 정보를 넘겨 veth 페어 생성·IP 할당·라우팅 규칙 주입을 위임한다. 즉 “파드에 IP를 주고 트래픽이 실제로 흐르게 만드는 일”은 전적으로 CNI의 책임이다.
| 항목 | Cilium | Calico |
|---|---|---|
| 데이터플레인 | eBPF (커널 5.10+ 권장) | iptables / eBPF 선택 가능 |
| kube-proxy 대체 | 완전 대체(kubeProxyReplacement) |
eBPF 모드에서 대체 |
| L7 정책 | 내장 Envoy로 HTTP/gRPC 정책 | 기본 L3/L4, L7은 별도 |
| 관측성 | Hubble(플로우/서비스맵) | Flow log, Prometheus |
| 라우팅 | VXLAN/Geneve 터널, native | BGP(native), IPIP/VXLAN |
| 강점 | 대규모, 성능, 보안·관측 통합 | 성숙도, BGP 연동, Windows 지원 |
| 주의 | 구형 커널/커스텀 커널 제약 | iptables 모드는 대규모에서 규칙 폭증 |
선택 기준은 대체로 이렇게 정리된다.
- 온프레미스에서 L3 스위치와 BGP 피어링해 캡슐화 없이 라우팅하고 싶다 → Calico native routing
- 노드 수천 대·파드 수만 개 규모, iptables 규칙 폭증을 피하고 싶다 → Cilium eBPF
- NetworkPolicy를 HTTP 경로/메서드 단위로 세분화하고 감사(audit)하고 싶다 → Cilium
- Windows 노드 혼재 → Calico (Windows 데이터플레인 지원 성숙)
- 툴체인 최소화, 기존 운영 지식 재활용 → Calico(전통 모드)
Cilium을 kube-proxy 대체 모드로 설치하는 Terraform(HCL) 예시는 다음과 같다.
resource "helm_release" "cilium" {
  name       = "cilium"
  repository = "https://helm.cilium.io"
  chart      = "cilium"
  namespace  = "kube-system"
  version    = "1.16.3"

  set { name = "kubeProxyReplacement" value = "true" }
  set { name = "ipam.mode"           value = "kubernetes" }
  set { name = "routingMode"         value = "tunnel" }
  set { name = "tunnelProtocol"      value = "vxlan" }
  set { name = "MTU"                 value = "1450" }   # 오버레이 헤더만큼 감소
  set { name = "hubble.enabled"      value = "true" }
  set { name = "hubble.relay.enabled" value = "true" }
  set { name = "hubble.ui.enabled"    value = "true" }
  set { name = "operator.replicas"    value = "2" }
}
설치 후에는 반드시 cilium status --wait, cilium connectivity test로 데이터플레인을 검증한다. helm upgrade로 MTU나 라우팅 모드를 바꾸면 기존 파드의 연결이 끊기므로 롤링 재시작 계획을 세워야 한다.
3. Service 4종과 kube-proxy
Service는 셀렉터로 선택된 파드 집합에 대해 안정적인 가상 IP(ClusterIP)와 DNS 이름을 제공한다. 파드가 재생성되어 IP가 바뀌어도 클라이언트는 서비스 이름만 알면 된다.
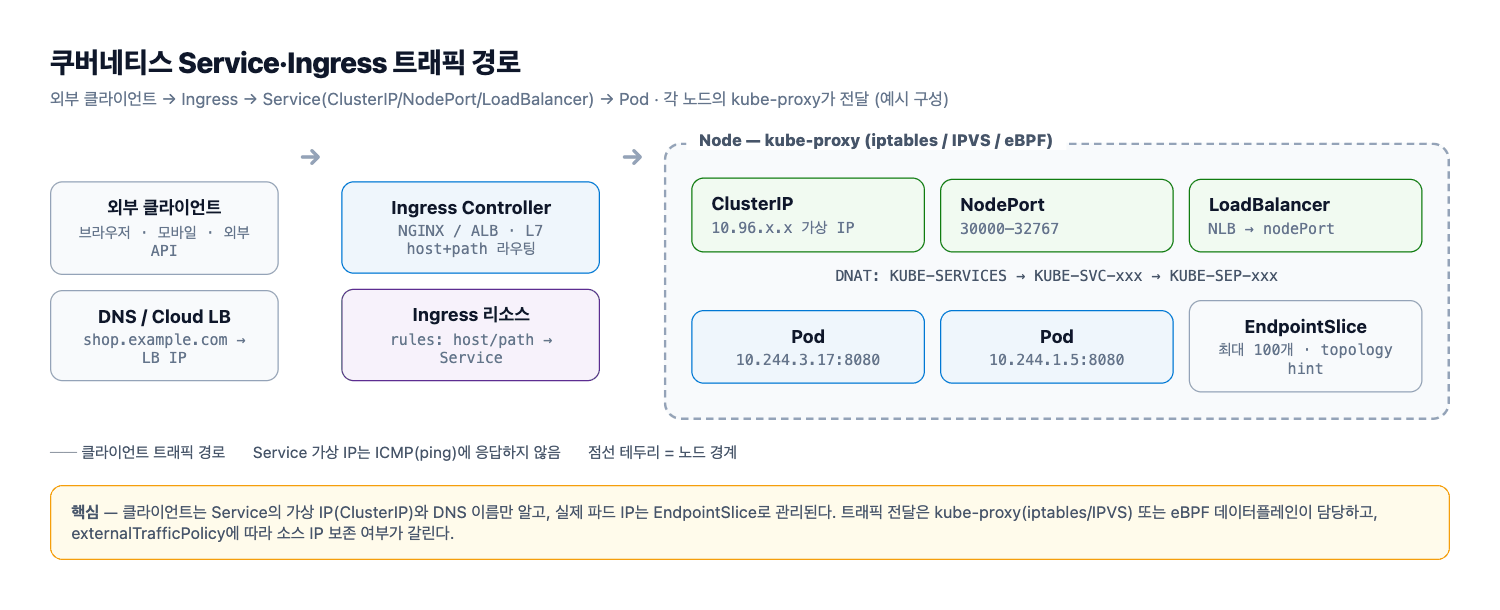
위 다이어그램은 외부 트래픽이 Ingress를 거쳐 ClusterIP·NodePort·LoadBalancer 타입의 Service로 들어오고, 각 노드의 kube-proxy가 iptables/IPVS 규칙으로 백엔드 파드에 전달하는 경로를 보여준다. 클라이언트가 보는 주소는 Service의 가상 IP와 DNS 이름뿐이고, 실제 파드 IP는 EndpointSlice로 관리된다.
| 타입 | 동작 | 사용 시점 |
|---|---|---|
| ClusterIP | 클러스터 내부 전용 가상 IP | 기본값, 내부 서비스 간 통신 |
| NodePort | 모든 노드의 30000–32767 포트 개방 | 임시 노출, 온프레미스 L4 앞단 |
| LoadBalancer | 클라우드 LB 프로비저닝(MetalLB는 온프레미스 대안) | 외부 트래픽 진입 |
| ExternalName | DNS CNAME만 반환, 프록시 없음 | 외부 관리형 DB/SaaS 참조 |
apiVersion: v1
kind: Service
metadata:
  name: web-clusterip
  namespace: prod
spec:
  type: ClusterIP
  selector: { app: web }
  ports:
    - name: http
      port: 80
      targetPort: 8080
---
apiVersion: v1
kind: Service
metadata:
  name: web-nodeport
  namespace: prod
spec:
  type: NodePort
  selector: { app: web }
  externalTrafficPolicy: Local   # 클라이언트 IP 보존, 로컬 엔드포인트 없으면 드롭
  ports:
    - port: 80
      targetPort: 8080
      nodePort: 30080
---
apiVersion: v1
kind: Service
metadata:
  name: web-lb
  namespace: prod
  annotations:
    service.beta.kubernetes.io/aws-load-balancer-type: external
    service.beta.kubernetes.io/aws-load-balancer-nlb-target-type: ip
    service.beta.kubernetes.io/aws-load-balancer-scheme: internet-facing
spec:
  type: LoadBalancer
  selector: { app: web }
  ports:
    - port: 443
      targetPort: 8080
---
apiVersion: v1
kind: Service
metadata:
  name: legacy-db
  namespace: prod
spec:
  type: ExternalName
  externalName: db.prod.internal.example.com
실제 트래픽 전달은 각 노드의 kube-proxy가 담당하며, 모드에 따라 특성이 다르다.
- iptables 모드(기본):
KUBE-SERVICES체인에 DNAT 규칙을 생성. 랜덤 확률 기반 분산이라 세션 단위 로드밸런싱이고, 서비스·엔드포인트가 늘면 규칙 수가 O(n)로 늘어 갱신 지연이 발생한다. - IPVS 모드: 해시 테이블 기반으로
rr,lc,sh,wrr등 알고리즘 선택 가능. 대규모에서 iptables보다 동기화가 빠르지만, 여전히 노드별 프록시이며 iptables 체인도 일부 병행 사용된다. - eBPF 모드(Cilium 등): kube-proxy를 아예 제거하고 커널 프로그램으로 처리. DNAT/SNAT가 커널에서 일어나 규칙 폭증 문제가 없고, 소켓 레벨 로드밸런싱으로 지연이 낮다. 대신 커널 버전 요구사항이 엄격하다.
externalTrafficPolicy: Cluster(기본)는 트래픽이 들어온 노드에서 다른 노드의 파드로 한 번 더 포워딩되며 소스 IP가 SNAT로 가려진다. Local은 소스 IP를 보존하지만 로컬 파드가 없으면 블랙홀이 되므로, 반드시 해당 서비스의 파드가 모든 노드에 분산되도록(예: DaemonSet 또는 topologySpreadConstraints) 설계해야 한다.
4. Endpoints / EndpointSlice
Endpoints(구 API)는 서비스 셀렉터에 매칭된 파드 IP:Port 목록이다. 쿠버네티스 v1.21부터는 EndpointSlice가 기본으로, 하나의 슬라이스에 최대 100개 엔드포인트를 담고 라벨 kubernetes.io/service-name으로 서비스와 연결된다. 슬라이스는 노드/존 단위 topology hint를 담을 수 있어 토폴로지 인지 라우팅(topology aware routing)의 근거가 된다.
운영에서 확인할 지점은 세 가지다.
kubectl get endpointslice -n prod -l kubernetes.io/service-name=<svc>→ 엔드포인트가 0개면 셀렉터 불일치 또는 readiness 실패- Readiness Probe가 통과하지 못한 파드는 엔드포인트에서 제외된다(
publishNotReadyAddresses: true로 예외 처리 가능) - 셀렉터 없는 Service(외부 DB 프록시 등)는 EndpointSlice를 수동으로 만들어야 한다
kubectl get endpointslices -n prod -o custom-columns=\
NAME:.metadata.name,PORTS:.ports[*].port,ENDPOINTS:.endpoints[*].addresses,READY:.endpoints[*].conditions.ready
5. Ingress, Ingress Controller, Gateway API
Ingress는 L7 라우팅 규칙(호스트/경로)만 기술하는 오브젝트이고, 실제 프록시는 Ingress Controller가 담당한다. NGINX Ingress는 범용·풍부한 애노테이션, AWS Load Balancer Controller(ALB 모드)는 ACM 인증서·WAF·보안그룹 연동에 강하다.
apiVersion: networking.k8s.io/v1
kind: Ingress
metadata:
  name: web
  namespace: prod
  annotations:
    nginx.ingress.kubernetes.io/proxy-body-size: "16m"
    nginx.ingress.kubernetes.io/proxy-connect-timeout: "5"
spec:
  ingressClassName: nginx
  tls:
    - hosts: ["shop.example.com"]
      secretName: wildcard-tls
  rules:
    - host: shop.example.com
      http:
        paths:
          - path: /api
            pathType: Prefix
            backend:
              service:
                name: api-svc
                port: { number: 8080 }
          - path: /
            pathType: Prefix
            backend:
              service:
                name: web-clusterip
                port: { number: 80 }
Ingress의 한계(헤더 기반 매칭·트래픽 분할·역할 분리 불가)를 해결한 것이 Gateway API이며, GatewayClass(인프라 제공자) / Gateway(운영자) / HTTPRoute(개발자)로 책임을 분리한다.
apiVersion: gateway.networking.k8s.io/v1
kind: Gateway
metadata: { name: prod-gw, namespace: prod }
spec:
  gatewayClassName: cilium
  listeners:
    - name: https
      protocol: HTTPS
      port: 443
      tls:
        mode: Terminate
        certificateRefs: [{ kind: Secret, name: wildcard-tls }]
      allowedRoutes: { namespaces: { from: Same } }
---
apiVersion: gateway.networking.k8s.io/v1
kind: HTTPRoute
metadata: { name: api-route, namespace: prod }
spec:
  parentRefs: [{ name: prod-gw }]
  hostnames: ["shop.example.com"]
  rules:
    - matches:
        - path: { type: PathPrefix, value: /api }
          headers: [{ name: x-canary, value: "true" }]
      backendRefs:
        - { name: api-canary, port: 8080, weight: 100 }
    - matches: [{ path: { type: PathPrefix, value: /api } }]
      backendRefs:
        - { name: api-svc, port: 8080, weight: 90 }
        - { name: api-canary, port: 8080, weight: 10 }
6. CoreDNS와 서비스 디스커버리
클러스터 DNS는 kube-system의 CoreDNS가 제공하며, kube-dns라는 ClusterIP 서비스로 노출된다. 파드는 dnsPolicy: ClusterFirst 기본값으로 /etc/resolv.conf에 search 도메인과 ndots:5를 받는다. 조회 대상이 상대 이름(예: api-svc)이면 ndots 때문에 최대 5개의 search 도메인을 순차 시도해 지연이 누적된다.
| 레코드 | 예시 | 용도 |
|---|---|---|
| A | api-svc.prod.svc.cluster.local |
ClusterIP 조회 |
| SRV | _http._tcp.api-svc.prod.svc.cluster.local |
포트 포함 디스커버리 |
| Headless A | db-0.db-headless.prod.svc... |
StatefulSet 개별 파드 IP |
| PTR | 10.244.3.17.in-addr.arpa |
역방향 조회 |
운영 팁: 클러스터 도메인 내부 통신은 FQDN에 마침표를 붙여(api-svc.prod.svc.cluster.local.) ndots 우회를 강제하고, 파드 스펙에서 dnsConfig.options로 ndots:2를 지정하는 편이 낫다. CoreDNS 지연이 의심되면 NodeLocal DNSCache를 DaemonSet으로 배포해 노드 로컬 UDP 캐시로 흡수한다.
# CoreDNS Corefile 발췌 (ConfigMap)
# .:53 {
#   errors
#   health { lameduck 10s }
#   ready
#   kubernetes cluster.local in-addr.arpa ip6.arpa {
#     pods insecure
#     ttl 30
#   }
#   prometheus :9153
#   forward . /etc/resolv.conf { max_concurrent 1000 }
#   cache 30
#   loop
#   reload
# }
7. NetworkPolicy 설계
NetworkPolicy는 파드 셀렉터로 대상을 고르고, 허용(allow) 규칙만 기술하는 화이트리스트 모델이다. 즉 정책이 하나도 없으면 전부 허용이고, 어떤 파드에 정책이 하나라도 걸리면 그 파드는 나열된 트래픽 외 전부 차단된다. Ingress/Egress 방향을 각각 선언할 수 있고, 정책은 누적(additive)된다. flannel처럼 정책을 지원하지 않는 CNI를 쓰면 오브젝트는 생성되지만 아무 효과가 없다.
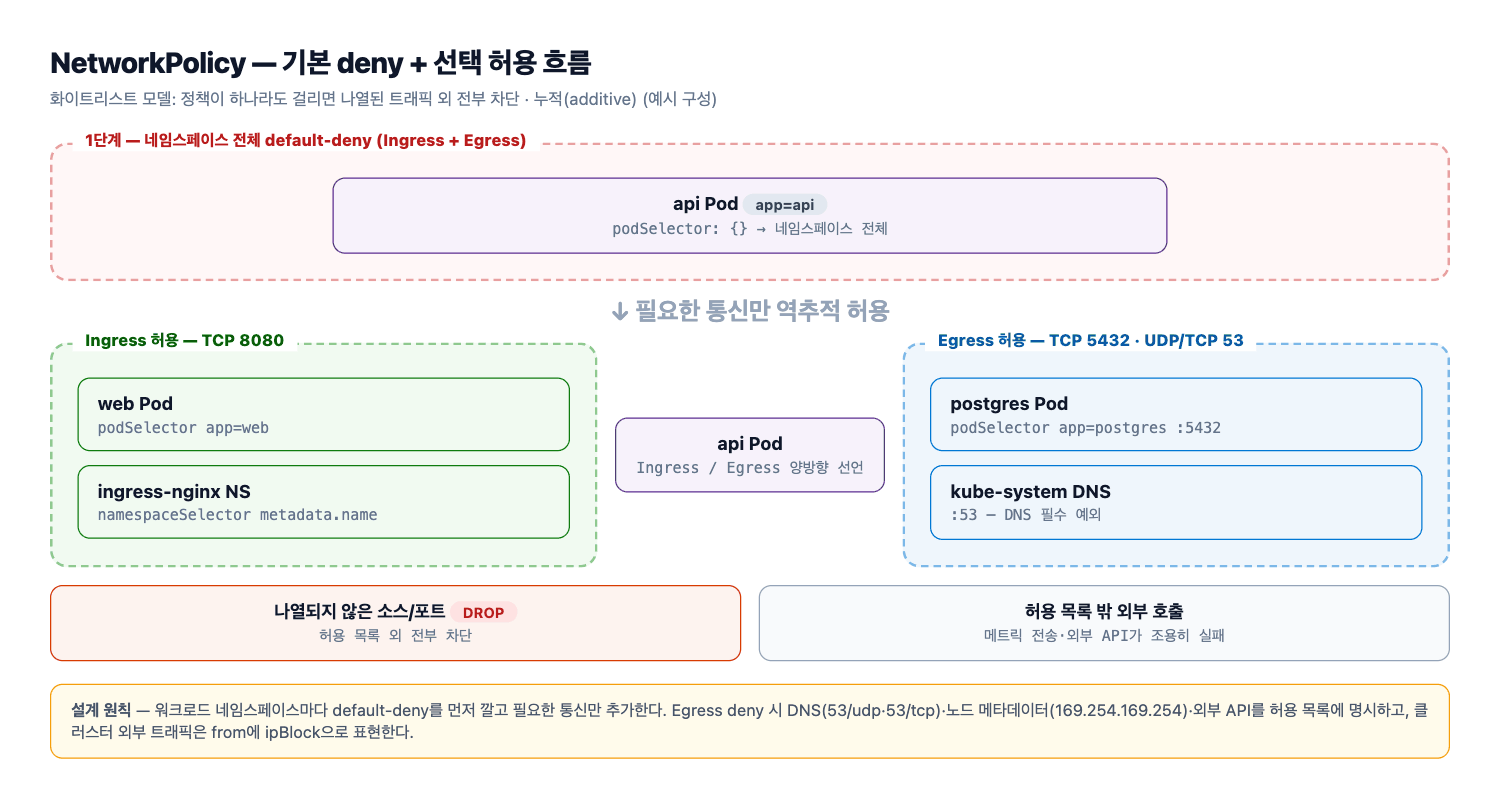
위 다이어그램은 네임스페이스 전체에 default-deny 정책을 먼저 깔고, 필요한 통신만 podSelector·namespaceSelector·ipBlock으로 역추적해 허용하는 흐름을 나타낸다. Egress를 기본 차단하면 DNS(53/udp, 53/tcp)와 노드 메타데이터, 외부 API 엔드포인트를 허용 목록에 반드시 넣어야 한다.
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata: { name: default-deny-all, namespace: prod }
spec:
  podSelector: {}          # 네임스페이스 전체
  policyTypes: [Ingress, Egress]
---
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata: { name: api-ingress-egress, namespace: prod }
spec:
  podSelector: { matchLabels: { app: api } }
  policyTypes: [Ingress, Egress]
  ingress:
    - from:
        - podSelector: { matchLabels: { app: web } }
        - namespaceSelector: { matchLabels: { kubernetes.io/metadata.name: ingress-nginx } }
      ports: [{ protocol: TCP, port: 8080 }]
  egress:
    - to:
        - podSelector: { matchLabels: { app: postgres } }
      ports: [{ protocol: TCP, port: 5432 }]
    - to:               # DNS는 반드시 별도 허용
        - namespaceSelector: { matchLabels: { kubernetes.io/metadata.name: kube-system } }
      ports: [{ protocol: UDP, port: 53 }, { protocol: TCP, port: 53 }]
설계 원칙: 워크로드 네임스페이스마다 default-deny를 먼저 깔고, 필요한 통신만 역추적해 추가한다. Egress deny를 켰다면 DNS(53/udp, 53/tcp), 노드 메타데이터(169.254.169.254), 외부 API 엔드포인트를 반드시 허용 목록에 넣는다. ipBlock은 CIDR에 except로 예외를 두고, 클러스터 외부 트래픽은 from에 ipBlock으로 명시해야 한다(파드 셀렉터로는 외부 IP를 표현할 수 없다).
8. 서비스 메시(Istio / Linkerd)와 mTLS
서비스 메시는 통신 계층을 애플리케이션 밖으로 끌어내 재시도·타임아웃·서킷 브레이커·트래픽 분할·상호 TLS(mTLS)를 인프라 차원에서 제공한다.
- Istio: Envoy 사이드카(또는 ambient 모드의 ztunnel/waypoint), VirtualService/DestinationRule로 세밀한 라우팅. 기능은 가장 풍부하지만 운영 복잡도와 리소스 오버헤드가 크다.
- Linkerd: Rust로 작성된 초경량 마이크로 프록시, 설치·운영이 단순하고 지연 오버헤드가 낮다. 세밀한 L7 정책은 Istio보다 제한적이다.
mTLS는 사이드카/노드 프록시가 SPIFFE(Secure Production Identity Framework for Everyone) 기반 워크로드 신원으로 자동 인증서를 발급·회전하며 처리한다. 애플리케이션 코드는 평문 HTTP를 그대로 쓰고, 인증서는 제어 평면(istiod / linkerd identity)이 갱신한다. 도입 판단 기준은 명확하다. mTLS·세밀 트래픽 제어·강한 관측이 필요하고 그 복잡도를 감당할 SRE 여력이 있으면 메시를, 단순 mTLS만 필요하면 CNI 레벨 암호화(Cilium WireGuard/IPsec)나 SPIFFE CSI로 대체하는 편이 비용 효율적이다.
9. 네트워크 트러블슈팅 실전
계층을 위에서 아래로 좁혀간다: DNS → Service/EndpointSlice → 파드 netns → 노드 라우팅/정책.
# 1) 파드에 netshoot 임시 컨테이너를 붙여 타깃 netns에서 진단
kubectl debug -it web-7d9f8b6c-abcde -n prod \
  --image=nicolaka/netshoot --target=web -- bash

# 컨테이너 안에서
nslookup api-svc.prod.svc.cluster.local 10.96.0.10   # DNS 자체 검증
curl -sv --max-time 3 http://api-svc.prod.svc.cluster.local:8080/healthz
ss -tnp state established
ip route get 10.244.3.17

# 2) 양단에서 동시 캡처: 요청이 나갔는지/응답이 돌아왔는지 판정
tcpdump -ni any -c 20 'host 10.244.3.17 and port 8080'

# 3) 서비스-엔드포인트 정합성
kubectl get svc api-svc -n prod -o wide
kubectl get endpointslice -n prod -l kubernetes.io/service-name=api-svc
# 4) 노드 레벨: 파드의 veth/네트워크 네임스페이스로 직접 진입
PID=$(crictl inspect $(crictl pods --name web-7d9f8b6c-abcde -q) | jq -r .info.pid)
nsenter -t "$PID" -n ip addr show eth0
nsenter -t "$PID" -n tcpdump -ni eth0 -w /tmp/pod.pcap -c 200

# 5) CNI/라우팅 상태 (Cilium)
cilium status
cilium endpoint list
hubble observe --namespace prod --to-pod api-svc --verdict DROPPED

# 6) MTU 경로 탐색: 1472+28=1500, 오버레이 1450이면 1422 성공/1423 실패
kubectl exec -it netshoot -- ping -M do -s 1422 10.244.1.5
자주 만나는 오류와 해결책:
| 증상 | 원인 | 해결 |
|---|---|---|
Connection refused (즉시) |
엔드포인트 0개 또는 targetPort 불일치 | endpointslice 확인, 컨테이너 실제 listen 포트 확인 |
Connection timed out |
NetworkPolicy 드롭 또는 CNI 라우팅 실패 | hubble observe --verdict DROPPED, 정책 감사 |
no such host / DNS 5초 지연 |
CoreDNS 장애 또는 ndots:5로 인한 순차 조회 |
kubectl -n kube-system logs deploy/coredns, FQDN 사용·ndots 조정 |
| TLS 핸드셰이크에서 멈춤 | 경로 MTU 불일치, 큰 패킷 드롭 | CNI MTU 정렬, MSS clamp |
| 간헐적 502/timeout | conntrack 테이블 포화, iptables 갱신 지연 | nf_conntrack_max 상향, IPVS/eBPF 전환 |
| NodePort 접속 불가(일부 노드) | externalTrafficPolicy: Local인데 로컬 파드 없음 |
파드 분산 또는 정책을 Cluster로 |
10. MTU / conntrack 실전 함정
MTU 불일치는 가장 찾기 어려운 장애다. 작은 요청은 정상이고 큰 응답(인증서 체인, JSON 대용량, gRPC 프레임)에서 멈춘다. VXLAN 터널은 50바이트, IPIP는 20바이트 헤더를 더하므로 물리 MTU 1500에서 각각 1450/1480이 한계다. AWS EKS의 VPC CNI는 ENI 기반으로 9001(점보)이지만, 오버레이를 끼워 넣으면 다시 깎인다. Cilium/Calico Helm 값의 MTU와 노드 인터페이스 MTU를 일치시키고, 필요하면 iptables -t mangle -A FORWARD -p tcp --tcp-flags SYN,RST SYN -j TCPMSS --clamp-mss-to-pmtu로 MSS를 경로 MTU에 맞춘다.
conntrack 포화는 NodePort/LoadBalancer에서 SNAT 엔트리가 급증할 때 발생한다. 증상은 nf_conntrack: table full, dropping packet 커널 로그와 간헐적 타임아웃이다.
# 현재 사용량과 한계
sysctl net.netfilter.nf_conntrack_count net.netfilter.nf_conntrack_max
conntrack -S | head -20          # drop 이유별 통계
conntrack -L -p tcp --dport 30080 | wc -l

# 상향 및 타임아웃 단축 (노드 sysctl: 99-k8s-networking.conf 등으로 영속화)
sysctl -w net.netfilter.nf_conntrack_max=1048576
sysctl -w net.netfilter.nf_conntrack_tcp_timeout_established=86400
추가 함정: ① ClusterIP는 가상 IP라 ICMP(ping)에 응답하지 않는다 — ping 성공 여부로 서비스를 판정하지 말 것 ② 파드 IP를 재사용할 때 이전 5-튜플 conntrack 엔트리가 남아 새 연결이 드롭될 수 있으므로, 파드 재시작 후 문제가 지속되면 해당 엔트리를 확인/삭제한다 ③ externalTrafficPolicy: Local과 internalTrafficPolicy: Local을 혼동하면 클러스터 내부 호출까지 드롭된다 ④ NetworkPolicy가 Egress를 기본 차단하면 메트릭 전송·외부 API 호출이 조용히 실패한다(Ingress만 보던 습관의 전형적 사고) ⑤ 카오스 엔지니어링 도구로 노드 간 파드 트래픽을 끊었을 때 서비스 추상화 덕분에 장애가 보이지 않을 수 있으니, 노드 단위 장애를 정기적으로 리허설한다.
11. 실무 체크리스트
- CNI/MTU를 노드 인터페이스·오버레이 헤더와 일치시켰고,
ping -M do로 최대 페이로드를 검증했다 nf_conntrack_max·count모니터링과 알림이 있으며, NodePort/LB 노드에서 포화 이력이 없다- 서비스별 EndpointSlice 엔드포인트 수와 Readiness 상태를 대시보드로 감시한다
externalTrafficPolicy·internalTrafficPolicy선택 근거와 소스 IP 보존 요구사항이 문서화되어 있다- 모든 워크로드 네임스페이스에 default-deny(Ingress/Egress) 정책이 있고 DNS·메타데이터 예외가 명시되어 있다
- CoreDNS 지연 p99와 SERVFAIL/NXDOMAIN 비율을 추적하고, 필요 시 NodeLocal DNSCache를 적용했다
- Ingress 컨트롤러·Gateway API의 TLS 인증서 만료 자동 갱신과 롤백 절차가 있다
- kube-proxy 모드(iptables/IPVS/eBPF)와 서비스 수 증가에 따른 규칙 폭증 한계를 인지하고 있다
- 서비스 메시 도입 시 mTLS 검증(
istioctl authn tls-check,linkerd viz edges)을 배포 파이프라인에 넣었다 - netshoot·tcpdump·hubble를 이용한 3계층(DNS/Service/Pod) 진단 런북이 온콜 문서에 있고, 장애 후 개선 항목을 역추적한다
12. 정리
- 모델은 평탄하다. 파드마다 전역 라우팅 가능한 고유 IP를 주고, 노드·파드 사이에 NAT가 없다는 3원칙이 모든 상위 추상화의 토대다. 이 원칙이 깨지면 디스커버리·TLS·세션이 함께 무너진다.
- CNI가 데이터플레인의 주인이다. veth 생성·IP 할당·라우팅·정책 집행은 CNI의 책임이며, Cilium(eBPF·Hubble)과 Calico(BGP·성숙도) 중 규모·라우팅·정책 요구로 고른다.
- Service는 안정된 계약, 전달은 kube-proxy가 한다. ClusterIP/NodePort/LoadBalancer/ExternalName의 용도를 구분하고, iptables/IPVS/eBPF 모드의 규칙 증가·소스 IP 보존 특성을 함께 본다.
- 진입점은 L7, 정책은 화이트리스트다. Ingress/Gateway API가 호스트·경로 라우팅을 맡고, NetworkPolicy는 default-deny 후 역추적 허용이 원칙이며 DNS·메타데이터 예외를 반드시 명시한다.
- 함정은 계층 경계에서 나온다. MTU 불일치와 conntrack 포화,
Local정책 블랙홀은 계층을 DNS→Service→Pod→노드 순으로 좁히는 진단 런북으로만 빠르게 잡힌다.
References
- Kubernetes Documentation — Services, Load Balancing, and Networking
- Kubernetes Documentation — Network Policies
- Kubernetes Documentation — Ingress
- Kubernetes Documentation — DNS for Services and Pods
- Kubernetes Gateway API — Introduction
- CNI — Specification
댓글남기기