
EKS VPC CNI 딥다이브와 IP 용량 계획: ipamd의 풀 관리부터 Karpenter 서브넷 선택까지
EKS 클러스터에서 “파드가 안 뜬다”는 문의는 대개 스케줄링 문제로 접수되지만, 실제로 열어 보면 절반은 IP 문제다. 노드에는 CPU와 메모리가 남아 있고 스케줄러도 파드를 배정했는데, 파드는 ContainerCreating에서 멈춰 있다. 원인은 노드 한 대가 미리 잡아 둔 주소 풀이 바닥났거나, 그 노드가 속한 서브넷에 가용 주소가 남아 있지 않은 경우다. VPC CNI를 “설치되는 애드온” 정도로만 이해하고 있으면 이 지점에서 판단할 근거가 없다. 이 글은 공개된 EKS 운영 매뉴얼(Engineering Playbook)의 네트워킹 문서 세 편을 읽고, 사내 AI 플랫폼 클러스터의 IP 압박을 기준으로 다시 정리한 기록이다123. 데이터패스가 어떻게 생겼는지 → ipamd가 풀을 어떻게 유지하는지 → 그래서 노드당 몇 개를 계산해야 하는지 → 어디서 함정이 생기는지 순서로 훑는다.
1. VPC CNI는 두 개의 프로세스다
VPC CNI를 하나의 바이너리로 생각하면 동작을 설명할 수 없다. 실제로는 호출 시점과 수명이 완전히 다른 두 컴포넌트가 같은 플러그인으로 묶여 있다1.
| 컴포넌트 | 실행 형태 | 맡은 일 |
|---|---|---|
CNI 플러그인 바이너리 (aws-cni) |
kubelet이 파드 생성·삭제 때마다 호출 | veth pair 생성, 라우팅 규칙 설정 등 실제 배선 |
ipamd (aws-node DaemonSet) |
노드마다 상주하는 데몬 | ENI를 붙이고 떼는 작업, 보조 주소 풀 유지, EC2 API 호출 |
파드가 생성될 때 CNI 바이너리는 로컬 ipamd에 gRPC로 주소를 요청하고, ipamd는 이미 확보해 둔 여유분(warm pool)에서 즉시 하나를 돌려준다. EC2 API를 부르는 작업(ENI 생성, 보조 IP 할당)은 파드 생성 경로에서 분리되어 백그라운드에서 진행된다. 파드 기동 시간이 EC2 API 응답 속도에 묶이지 않는 이유가 이 분리 구조다1.
기본 secondary-IP 모드에서 노드가 담을 수 있는 파드 주소는 인스턴스 타입의 ENI 개수와 ENI당 보조 IP 개수로 결정된다. ENI 4개에 ENI당 IP 15개인 타입이라면 ENI마다 primary IP 하나는 노드 자신이 쓰므로, 파드에 돌아갈 주소는 4 × (15 - 1) = 56개다. 여기서 흔히 오해하는 지점이 있다. 공개된 max-pods 권장 계산식의 + 2는 파드 IP를 따로 소비하지 않는 hostNetwork 파드를 위한 몫이다. 따라서 계산 결과 58은 “파드 수 설정값”이고 파드 IP 58개가 아니다. 실제로 담기는 파드 수는 kubelet 설정과 워크로드의 리소스 요구량에 따라서도 달라진다1.
1.1 L3 라우티드 모드: 브리지가 없는 데이터패스
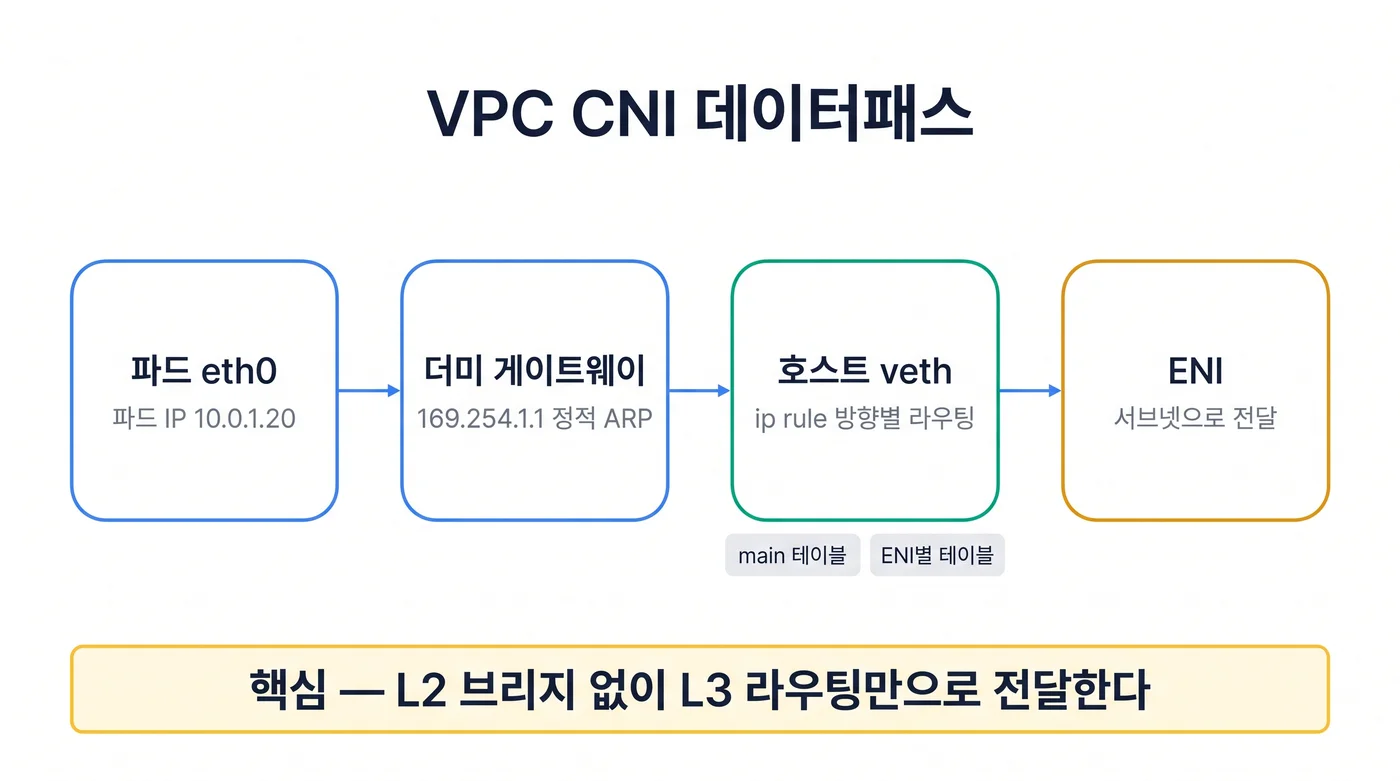
VPC CNI는 노드 안에 L2 브리지를 만들지 않는다. 파드마다 veth pair를 만들고, 정적 라우팅과 정책 라우팅(ip rule)만으로 패킷을 넘기는 L3 라우티드 모드(routed mode)를 쓴다1.
[파드 네임스페이스]
  eth0 (10.0.1.20/32)
    └─ default via 169.254.1.1   ← 실체 없는 더미 게이트웨이
       ARP: 169.254.1.1 → host veth MAC (PERM, 정적 엔트리)
                    ‖ veth pair
[호스트 네임스페이스]
  eni3a52ce78d95 (host veth)
    ├─ ip rule  : 파드 IP를 소스로 매칭
    ├─ main 테이블      : 10.0.1.20/32 → host veth   (VPC → 파드)
    └─ ENI별 테이블      : default → 서브넷 게이트웨이  (파드 → VPC)
                    ‖
              ENI 0(primary) / ENI 1(secondary) → VPC
파드 안의 라우팅 테이블에는 링크로컬 주소 169.254.1.1을 기본 게이트웨이로 삼는 경로가 들어가고, 그 주소에 대한 정적 ARP 엔트리가 PERM 플래그로 심긴다. 169.254.1.1은 실재하는 장비가 아니라 호스트 쪽 veth의 MAC을 가리키는 자리표시자다. 그래서 파드는 ARP 질의를 하지 않고 모든 아웃바운드 패킷을 그대로 veth pair 너머 호스트로 밀어 넣는다1.
이 설계가 만드는 결과는 세 가지다.
- 파드 간 통신에서 ARP 브로드캐스트가 발생하지 않는다. 모든 전달 결정은 호스트의 L3 라우팅에서 내려진다.
- 같은 노드에 있는 파드끼리 통신해도 항상 호스트 라우팅 테이블을 거친다.
- L2 도메인 자체가 없으므로 브리지 기반 CNI가 안고 있는 MAC 학습·플러딩 문제가 생기지 않는다.
호스트 쪽 veth 이름은 eni 접두사(기본값, AWS_VPC_K8S_CNI_VETHPREFIX로 바꿀 수 있다)에 해시값 앞 11자를 이어 붙여 만든다. 해시 입력은 네트워크 이름·파드 식별자·인터페이스 이름 세 가지이므로 같은 파드에는 항상 같은 이름이 나온다. 반대로 eni3a52ce78d95 같은 이름에서 파드를 역추적하려면 해시 입력을 다시 계산하거나 ip addr의 라우팅 엔트리와 맞춰 봐야 한다1.
1.2 방향별 이중 라우팅과 ENI별 테이블
트래픽 방향에 따라 서로 다른 테이블이 쓰인다1.
| 방향 | 사용하는 테이블 | 동작 |
|---|---|---|
| VPC → 파드 (ingress) | main | 파드 IP/32 → host veth 호스트 라우트로 전달 |
| 파드 → VPC (egress) | ENI별 테이블 | ip rule이 파드 IP를 소스로 매칭해, 그 IP가 속한 ENI의 테이블로 보낸다. 테이블의 기본 경로는 서브넷 게이트웨이를 가리킨다 |
egress에 ENI별 테이블이 따로 필요한 이유는 보조 ENI에 붙은 주소의 응답 패킷이 반드시 그 ENI로 나가야 하기 때문이다. VPC는 소스 IP와 ENI의 대응 관계를 검증하므로, primary ENI의 기본 경로로 밀어 내보내면 스푸핑으로 판단해 패킷을 버린다1.
1.3 NetworkPolicy는 컨트롤러와 eBPF 에이전트의 분업이다
VPC CNI v1.14.0부터 Kubernetes NetworkPolicy를 네이티브로 지원하며, 적용 구조는 두 계층으로 나뉜다1.
- Network Policy Controller — EKS 컨트롤 플레인에서 AWS가 관리한다. NetworkPolicy의 셀렉터를 실제 파드 IP 집합으로 해석(resolve)하고 그 결과를
PolicyEndpointsCRD로 발행한다. - aws-network-policy-agent — 노드마다 도는 DaemonSet이다.
PolicyEndpoints를 감시(watch)하다가, 파드의 host veth에 eBPF 프로브를 attach해 정책을 적용한다. iptables 체인을 만들지 않기 때문에, 정책이 아무리 많아져도 규칙을 훑는 비용이 선형으로 커지지 않는다.
운영에서 챙길 함의는 이렇다. 정책이 적용됐는지 확인할 1차 대상은 NetworkPolicy 오브젝트가 아니라 PolicyEndpoints CRD다. 컨트롤러의 해석 결과가 여기까지 도달했는지가 분기점이기 때문이다. 커널 레벨에서 실제로 어떤 트래픽이 거부됐는지는 노드 에이전트가 제공하는 CLI(aws-eks-na-cli)와 정책 이벤트 로그로 본다. 적용 범위에도 제약이 있다. 대상은 파드의 eth0뿐이고, host networking 파드·Windows 노드·Fargate에는 적용되지 않는다1.
2. ipamd의 IP 풀 관리(워밍 풀·재사용)
파드 생성 요청에 즉시 답하려면 여유 주소가 미리 있어야 한다. ipamd가 그 여유분을 얼마나 잡을지 결정하는 방식이 IP 용량 계획의 출발점이다12.
2.1 워밍 풀을 정하는 세 변수
| 변수 | 기본값 | 의미 |
|---|---|---|
WARM_ENI_TARGET |
1 |
ENI 한 개 분량의 주소를 통째로 여유로 유지한다. WARM_IP_TARGET이 설정되면 무시된다 |
WARM_IP_TARGET |
없음 | 여유 주소 개수를 직접 지정한다. WARM_ENI_TARGET을 덮어쓴다 |
MINIMUM_IP_TARGET |
없음 | 노드가 항상 보유할 주소의 하한(floor). 기동 직후 파드가 몰려 뜨는 상황을 대비한 pre-scaling 용도다 |
WARM_ENI_TARGET=1은 숫자만 보면 과해 보이지만 의도된 기본값이다. ENI 하나를 붙이는 데 최대 10초가 걸리므로, 파드가 갑자기 늘어나는 시점에 ENI attach 경로로 들어가면 그 노드의 파드 기동이 한꺼번에 밀린다1. 반대로 WARM_IP_TARGET을 너무 작게 잡으면 파드 생성·삭제(churn)마다 개별 주소를 EC2 API로 붙였다 떼게 되고, 이 호출이 스로틀링에 걸리면 해당 노드가 아니라 클러스터 전체의 ENI·IP 할당이 막힌다. 공개 문서가 대규모·high churn 환경에서 WARM_IP_TARGET 단독 사용을 자제하라고 적어 둔 이유가 여기 있다2.
MINIMUM_IP_TARGET은 반드시 WARM_IP_TARGET과 함께 쓴다. 하한만 설정하면 WARM_IP_TARGET이 0으로 간주되어, 최소치를 채운 뒤에는 여유 주소가 하나도 남지 않는 상태가 될 수 있다12.
2.2 Prefix Delegation: /28 단위 할당
ENABLE_PREFIX_DELEGATION=true(v1.9.0+)를 켜면 ipamd는 개별 보조 IP 대신 /28 프리픽스(연속 주소 16개) 단위로 ENI에 주소를 붙인다. IPv6에서는 /80이 같은 역할을 한다. 도입 효과는 두 갈래다12.
- 파드 밀도 상승 — ENI 슬롯 하나가 주소 1개가 아니라 16개를 담는다. 실제로 담기는 파드 수는 별도로 설정한 kubelet
max-pods, 서브넷 가용 주소, CPU·메모리 여유를 함께 확인해야 한다. - EC2 API 호출 감소 — 주소 16개를 API 호출 한 번으로 확보하므로 스케일링 시 호출량이 크게 줄어든다.
전제 조건이 있다. /28은 연속된 16개 주소여야 하므로 서브넷 단편화(fragmentation)가 심하면 프리픽스를 받지 못하고, 이때 개별 IP 모드로 폴백하지 않고 에러가 된다. 전용 서브넷이나 Subnet CIDR reservation과 함께 쓰는 편이 안전하다. 프리픽스 모드에서는 warm 타깃 계산도 프리픽스 단위로 바뀌고 WARM_PREFIX_TARGET(기본 1)이 추가로 관여한다1.
2.3 IP 쿨다운과 비강제 축소
파드가 사라지면 그 주소는 곧바로 재사용 가능 상태가 되지 않고 쿨다운을 거친다. 기본값은 30초이고 IP_COOLDOWN_PERIOD(v1.15.0+)로 조정한다. 쿨다운이 필요한 이유는 Kubernetes의 비동기성이다. 파드가 삭제돼도 각 노드의 kube-proxy 규칙에서 그 주소가 빠지기까지 시간이 걸리는데, 쿨다운 없이 새 파드에 즉시 재할당하면 아직 갱신되지 않은 규칙을 타고 이전 Service의 트래픽이 새 파드로 흘러들 수 있다. 0으로 설정하는 것이 지원되긴 하지만 공식 문서가 강하게 비권장한다. 반대로 너무 크게 잡으면 가용 주소가 쿨다운에 묶여 EC2 API 호출이 늘어난다. 파드 churn이 큰 워크로드에서는 초당 파드 삭제율 × 쿨다운 기간만큼의 주소가 상시 쿨다운 상태에 있다는 점을 워밍 풀 산정에 넣어야 한다12.
풀을 줄이는 경로에도 안전장치가 있다. ipamd는 30초 주기로 초과분 주소와 ENI를 반납하려 시도하지만, 이 축소는 비강제(non-force) 삭제만 한다. 데이터스토어에서 주소를 지울 때 그 주소가 파드에 물려 있으면 삭제가 거부된다. 강제로 지우는 경우는 EC2 API로 그 보조 주소가 이미 인스턴스에서 떨어져 나간 것을 재확인한 reconcile 단계뿐이다1. 그래서 warm 타깃을 줄이거나 노드를 축소해도 실행 중인 파드의 연결이 IPAM 때문에 끊기는 일은 없다. 반납 대상은 언제나 아직 배정되지 않은 여유분이다.
2.4 관측 지점
| 지점 | 보는 것 |
|---|---|
/var/log/aws-routed-eni/ipamd.log |
ENI·IP 할당과 반납 결정 로그 |
curl http://localhost:61679/v1/enis, /v1/pods |
ipamd introspection — 데이터스토어의 ENI·IP·파드 매핑 스냅샷 |
curl http://localhost:61678/metrics |
Prometheus 메트릭 (introspection과 포트가 다르다) |
warm 풀 관련 이상, 예를 들어 파드가 ContainerCreating에서 주소를 기다리거나 ipamd 로그에 EC2 스로틀링 에러가 찍히는 상황은 이 세 지점을 먼저 본다12.
3. IP 소비 계산: 노드당 몇 개가 필요한가
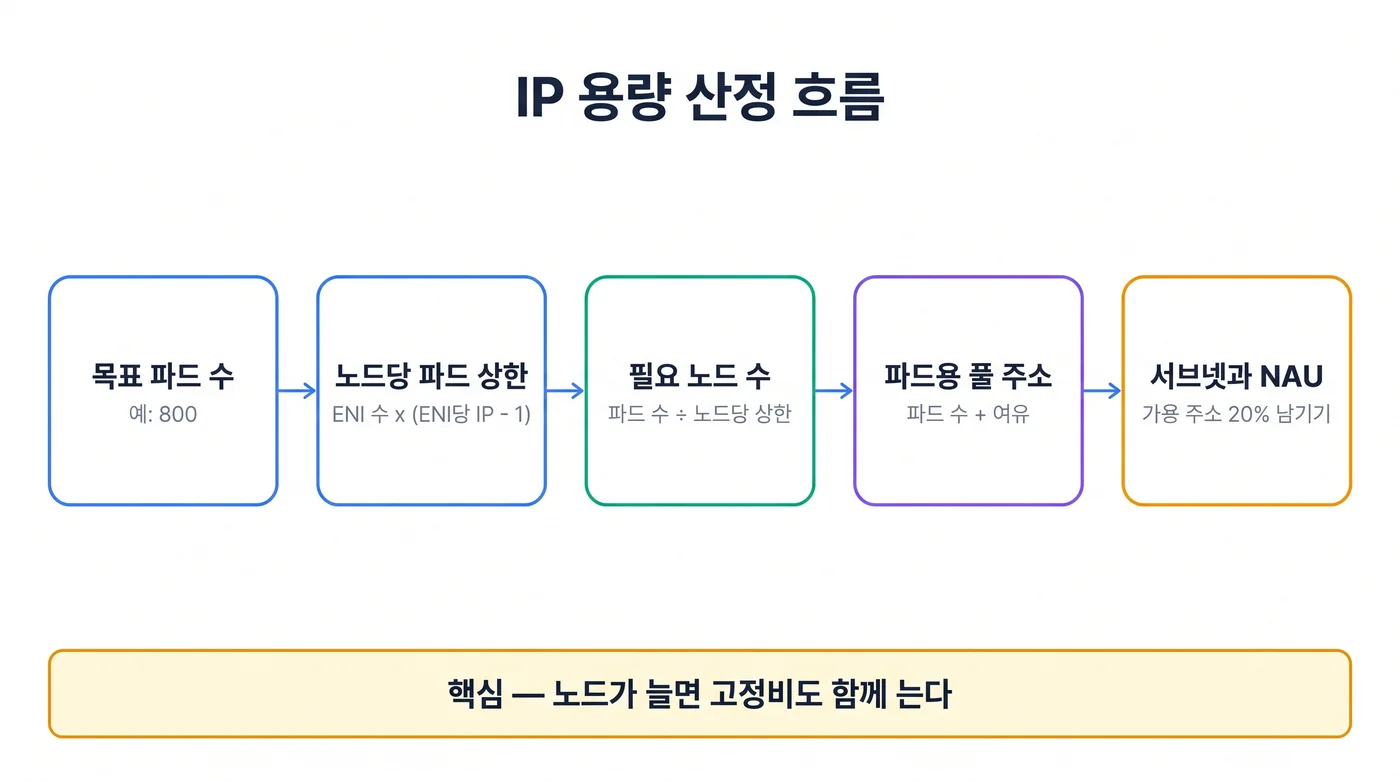
여기서부터는 계산이다. 목표는 “파드 N개를 띄우려면 서브넷에서 주소 몇 개가 나가야 하는가”에 답하는 것이다2.
3.1 노드 한 대가 잡는 주소
먼저 파드용 풀과 노드 전체 소비를 분리한다. IPv4 ENI의 primary 주소는 파드용 보조 주소 풀과 별개로 소비되고, trunk ENI와 branch ENI의 주소도 예산에 들어간다.
노드가 잡는 IPv4 총량 = P_eni + P_pod + 16 × F + P_branch

P_eni    = 일반 ENI와 trunk ENI가 차지하는 primary IPv4 개수
P_pod    = 일반 파드 몫으로 떨어진 개별 secondary IPv4 개수
F        = 노드가 받아 둔 IPv4 /28 프리픽스 개수
P_branch = branch ENI가 가져간 primary IPv4 개수
일반 파드 풀의 정상 상태 목표치는 다음처럼 근사한다.
T = max(MINIMUM_IP_TARGET, P + WARM_IP_TARGET)

P = hostNetwork 파드와 SGP 파드를 뺀, 나머지 파드가 실제로 쓰는 주소 수
개별 IP 모드에서는 P_pod ≈ T, 프리픽스 모드에서는 16 × F ≈ 16 × ceil(T / 16)로 잡되 ENI 한도·할당 지연·쿨다운을 따로 본다. 이 목표식은 파드 풀만 다루는 식이므로 node·trunk·branch 주소를 포함한 총량이 아니라는 점을 기억해야 한다. warm IP 타깃을 두지 않았다면 모드에 맞는 ENI 또는 프리픽스 warm 타깃도 함께 확인한다2.
3.2 인스턴스 크기에 따른 차이
아래 표는 파드 2,000개를 띄울 때 파드용 secondary IP 풀만 비교한 가정이다. 모든 파드가 hostNetwork·SGP를 쓰지 않고 WARM_IP_TARGET=2이며, MINIMUM_IP_TARGET은 각 행의 최대 파드 수에 맞췄다. 표의 수치에 node·추가 ENI의 primary 주소는 더해야 한다2.
| 인스턴스 크기 | 파드 배치 | 노드 수 | 풀 주소 | 유휴 주소 |
|---|---|---|---|---|
| 4xlarge | 125 × 16 = 2,000 | 125 | 2,250 | 250 |
| 8xlarge | 48 × 33 + 13 × 32 = 2,000 | 61 | 2,122 | 122 |
| 24xlarge | 20 × 100 = 2,000 | 20 | 2,040 | 40 |
같은 파드 수인데도 노드가 많아질수록 warm IP와 ENI primary 주소라는 고정비가 노드마다 붙어 총소비가 커진다. 배치가 달라지면 minimum 타깃에 묶여 남는 유휴량도 달라진다. 예를 들어 60대에 33개씩, 마지막 한 대에 20개를 배치하면 마지막 노드의 풀은 최소 33개를 유지하므로 파드 풀 합계는 2,133개가 된다. 이 비교는 크기별로 타깃을 다르게 둔 가정이라는 점도 짚어 둔다. 실제로는 하나의 aws-node DaemonSet에 공통 환경 변수가 적용되므로 크기별로 다른 warm 타깃을 줄 수 없다2.
3.3 NAU는 서브넷과 다른 카운터다
NAU(Network Address Usage)는 VPC에 붙은 주소 자원을 세는 별도 단위다. IP, 프리픽스, ENI가 각각 정해진 값으로 집계되고, Amazon EKS 파드도 1 NAU 항목으로 잡힌다. 그래서 “프리픽스 하나가 1 NAU”라는 사실만 보고 클러스터 전체를 “파드 16개당 1 NAU”로 환산하면 안 된다. 실제 자원 구성을 공식 NAU 표와 대조하고 VPC의 관측 NAU로 확인해야 한다2.
쿼터는 VPC당 기본 64,000이고 256,000까지 올릴 수 있다. 같은 리전에서 peered VPC를 합산하는 쿼터는 기본 128,000, 최대 512,000이며 cross-Region peering은 합산 대상이 아니다2. 클러스터 수십 개가 VPC 하나를 나눠 쓰는 환경에서는 서브넷에 주소가 남아 있어도 NAU 쿼터에 먼저 걸릴 수 있다. 서브넷 크기와 NAU를 같은 표에 놓고 계산해야 하는 이유가 여기다.
4. 함정: 소형 인스턴스 fallback과 SG for Pods
계산식은 맞게 세웠는데도 서브넷이 비는 상황이 있다. 원인은 대개 두 가지다2.
4.1 소형 인스턴스로 fallback할 때의 과다 예약
VPC CNI의 환경 변수는 aws-node DaemonSet 한 곳에 클러스터 공통으로 들어간다. NodePool별로 다른 값을 줄 방법이 없다. 24xlarge에서 파드 100개가 뜰 것을 예상해 MINIMUM_IP_TARGET을 100으로 뒀다고 하자. 대형 인스턴스를 확보하지 못해 4xlarge로 fallback한 노드도 똑같이 주소 100개를 먼저 잡는다. 그 노드에 파드는 16개밖에 못 뜨니 84개가 놀게 된다.
MINIMUM_IP_TARGET − 그 크기의 노드당 파드 수 = 노드 1대의 유휴 주소
  100 − 16 = 84

4xlarge가 500대 뜨면  84 × 500 ≈ 42,000
  → /17 서브넷의 가용 주소 32,763개(문서 기준)를 넘어선다
낭비가 무서운 이유는 평시에 드러나지 않는다는 점이다. 대형 인스턴스가 정상적으로 확보되는 동안에는 예약한 주소가 대부분 파드에 쓰인다. DR 훈련이나 대규모 재배포처럼 리전 용량이 모자라 fallback이 한꺼번에 터지는 순간, 소형 노드 수백 대가 동시에 올라오면서 서브넷을 말려 버린다. 삭제된 파드의 주소는 기본 30초의 쿨다운이 지나야 재사용되므로, 대규모 재배포에서는 이 대기분까지 순간 소비에 더해진다2.
대응은 warm 타깃을 예상 밀도와 생성 속도에 맞춰 조정하는 것에서 시작한다. NodePool을 크기별로 나누면 후보와 선호도를 관리하기 쉽지만, weight만으로 24xlarge → 8~16xlarge → 4xlarge의 엄격한 순서를 보장하지는 않는다. 반드시 제외할 크기는 requirements로 잘라 내고, 작은 노드의 증가량과 서브넷 여유는 따로 관측한다2.
4.2 Security Groups for Pods는 별도 주소를 쓴다
ENABLE_POD_ENI=true를 켜면 SecurityGroupPolicy에 걸린 파드가 branch ENI의 primary 주소를 하나씩 받는다. 컨트롤 플레인의 VPC Resource Controller가 노드에 trunk ENI(aws-k8s-trunk-eni)를 붙이고, 정책에 매칭된 파드마다 branch ENI(aws-k8s-branch-eni)를 만들어 trunk에 연결하는 구조다. 이 파드들은 앞 절의 보조 주소 풀을 쓰지 않고 branch ENI라는 별도 경로로 주소를 받는다. 그래서 branch ENI 수용량은 보조 IP 한도와 따로 계산해야 한다12.
branch ENI 한도는 인스턴스 타입마다 고정돼 있다. 공개된 vpc-resource-controller 한도에는 c5.4xlarge의 경우 ENI 8개, ENI당 IPv4 30개, branch ENI 54개가 적혀 있다. ENI당 primary IP 하나를 빼면 계산상 secondary 주소 상한은 8 × (30 − 1) = 232이고, CNI README의 234 secondary IPs 예시와 어긋나므로 둘 중 하나를 용량 보장값으로 그대로 쓰면 안 된다. 실제 파드 한도를 확정하려면 인터페이스를 다른 용도로 쓰는 몫(trunk ENI, 커스텀 네트워킹)과 CNI 버전, kubelet maxPods를 함께 봐야 한다2.
SGP 비중이 높은 클러스터에서 IP 계획을 어렵게 만드는 특성은 세 가지다.
ENABLE_PREFIX_DELEGATION=true를 켜도 branch ENI 파드의 밀도는 올라가지 않는다. branch ENI는 primary 주소 하나만 받으므로 프리픽스 이점이 없다.- branch ENI 파드 수는
WARM_*타깃과 무관하다. warm 타깃은 비-SGP 파드 수만 보고 낮게 잡는 편이 낭비가 적다. POD_SECURITY_GROUP_ENFORCING_MODE는strict(기본)와standard중 하나다.standard로 두면 같은 호스트에서 오가는 kubelet·NodeLocal DNS 트래픽이 SG 규칙 평가에서 빠지는데, kube-proxy를ipvs모드로 쓸 때 이 값이 필요하다. SGP와 trunk/branch ENI는 Nitro 인스턴스에서만 동작한다.
4.3 EKS Auto Mode에서는 변수 자체가 없다
EKS Auto Mode 클러스터는 노드 네트워킹(ENI 수명주기 포함)을 AWS가 관리하므로 WARM_*이나 MINIMUM_IP_TARGET 같은 환경 변수가 없다. 대신 NodeClass가 IP 할당을 조절한다. advancedNetworking.ipv4PrefixSize는 기본값 Auto(프리픽스 위임, 노드마다 /28을 먼저 잡고 부족하면 추가)와 "32"(secondary IP 모드, 파드당 1개, 여유 주소는 1개만 유지) 중 하나이고, advancedNetworking.networkInterfaces의 secondaryIPv4Count·secondaryIPv4PrefixCount는 런치 시점에 ENI별 주소 수를 고정하므로 이후에는 주소·프리픽스·ENI가 늘지 않는다. 파드 서브넷은 podSubnetSelectorTerms로 노드와 분리한다2.
Auto Mode에서 SGP는 지원되지 않는다. podSubnetSelectorTerms와 podSecurityGroupSelectorTerms는 함께 설정하고, 같은 NodeClass를 쓰는 노드의 모든 파드가 같은 파드 보안 그룹을 공유한다. 파드별 SecurityGroupPolicy와는 적용 범위가 다르므로, 정책을 달리 가져가야 하는 워크로드는 별도 NodeClass·NodePool과 배치 조건으로 갈라 놓는다. 노드 하나에 담기는 파드 수는 세 값 중 가장 작은 것으로 정해진다. 사용자가 지정한 maxPods, 그 인스턴스가 낼 수 있는 IP 용량, 그리고 Auto Mode가 두는 110이라는 상한이다. 노드 밀도가 낮은 Auto Mode에서는 ipv4PrefixSize: "32"로 프리픽스 최소 예약량을 줄일 수 있다2.
5. 서브넷 설계와 Karpenter 선택
5.1 서브넷 확장 경로
서브넷 주소가 부족해졌을 때는 변경 범위가 작은 순서로 검토한다12.
| 순서 | 방법 | 하는 일 | 주의 |
|---|---|---|---|
| 1 | Enhanced Subnet Discovery | VPC에 CIDR 블록을 붙이고 새 서브넷에 kubernetes.io/role/cni=1 태그를 달면, ENABLE_SUBNET_DISCOVERY=true(v1.18.0+ 기본값)인 노드가 새 secondary ENI를 그 서브넷에 만든다 |
VPC CNI가 ec2:DescribeSubnets를 호출할 IAM 권한이 필요하다 |
| 2 | secondary CIDR | VPC에 RFC 6598 공유 대역(예: 100.64.0.0/16)을 붙여 파드 주소 공간을 넓히고, 사내에서 쓰는 RFC 1918 대역은 남겨 둔다 |
라우팅·피어링 설계를 함께 손봐야 한다 |
| 3 | 커스텀 네트워킹 | AWS_VPC_K8S_CNI_CUSTOM_NETWORK_CFG=true와 ENIConfig CRD로 파드를 노드와 다른 서브넷에 배치한다 |
노드 자신이 쓸 primary ENI를 파드에 돌려줄 수 없어 노드당 파드 상한이 낮아진다 |
| 4 | IPv6 | 신규 클러스터라면 IPv4 소진 문제 자체가 사라진다 | IPv6는 프리픽스 위임 모드와 Nitro 인스턴스를 전제로 한다 |
VPC 쪽 쿼터도 같은 표에서 확인한다. 한 VPC에 붙일 수 있는 IPv4 CIDR 블록은 기본 5개(최대 50개), 서브넷 수는 기본 200개이므로 모자라면 상향을 요청한다. 참고로 eksctl이 만드는 기본 VPC는 192.168.0.0/16을 /19 서브넷 8개로 쪼개고, 서브넷마다 주소 8,192개가 들어간다2.
warm 타깃을 계속 만지고 애드온 설정이 틀어지는지 감시하는 대신, 노드 네트워킹 운영 자체를 넘기는 선택지도 있다. IP가 자주 마르는 워크로드를 Auto Mode NodePool로 옮기면 예약 단위를 ipv4PrefixSize로 고르는 것 외에는 ENI 수명주기와 CNI 업데이트를 AWS가 가져간다. 그 대가로 SGP를 못 쓰고, 노드당 파드가 110개로 묶이고, warm 타깃을 세밀하게 조정할 수 없다. 한 클러스터 안에서 Auto Mode 노드와 직접 관리하는 노드를 섞어 워크로드별로 갈라 두는 것도 가능하다2.
5.2 Karpenter는 IP 예산을 능동적으로 관리하지 않는다
Karpenter v1(karpenter.sh/v1)은 IP 여유를 보고 노드를 옮기는 기능을 갖고 있지 않다. EC2NodeClass의 subnetSelectorTerms가 후보로 잡은 서브넷 가운데 노드가 뜰 AZ에 속한 것이 둘 이상이면, 그중 남은 주소가 제일 많은 쪽을 고른다. status.subnets 목록도 같은 기준의 내림차순으로 나열된다. 이 선택은 같은 AZ 안에서 순위를 가리는 용도일 뿐, IP가 넉넉한 다른 AZ로 노드를 보내는 기능이 아니다2.
그래서 실패 양상이 두 갈래로 갈린다.
| 시점 | 현상 | Karpenter 인지 여부 |
|---|---|---|
| 노드 런치 | 서브넷에 주소가 없으면 EC2 런치가 InsufficientFreeAddressesInSubnet으로 실패하고 NodeClaim 이벤트에 남는다 |
인지한다 |
| 노드 기동 후 | ipamd가 주소를 더 못 받아 파드가 ContainerCreating에 머문다 |
인지하지 못한다 |
두 번째 줄이 핵심이다. 이미 떠 있는 노드에서 벌어지는 IP 고갈은 Karpenter의 시야 밖이므로, IP 예산은 NodePool 설계와 서브넷 크기 단계에서 미리 반영해야 한다2.
5.3 노드 크기 fallback을 다루는 구성
크기와 패밀리를 나눈 NodePool 여러 개에 weight를 두어 선호를 표현할 수 있다. 다만 배치·bin-packing과 기존 노드 사용 상황 때문에 낮은 weight의 풀이 선택될 수 있으므로, 단계별 fallback 보장으로 해석하면 안 된다2.
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
  name: np-large
spec:
  weight: 200
  template:
    spec:
      requirements:
        - key: karpenter.k8s.aws/instance-family
          operator: In
          values: ["m7i", "r7i"]
        - key: karpenter.k8s.aws/instance-size
          operator: In
          values: ["24xlarge"]
      nodeClassRef:
        group: karpenter.k8s.aws
        kind: EC2NodeClass
        name: eks-default
  disruption:
    consolidationPolicy: WhenEmptyOrUnderutilized
    consolidateAfter: 2m
    budgets:
      - nodes: "15%"
  limits:
    cpu: "12000"
중간 단계 풀은 weight: 50에 instance-size In ["8xlarge","12xlarge","16xlarge"]를 걸고, 마지막 4xlarge 풀에는 더 낮은 weight와 limits를 준다. limits는 eventual consistency로 확인되므로 확장이 빠른 구간에서는 잠깐 넘길 수 있다. 서브넷 주소의 안전장치로 믿지 말고 따로 여유를 계산해 둔다2.
DR 상황에서 대형 인스턴스 확보에 실패할 때의 선택지는 세 가지다. 단일 타입을 고정하지 않고 여러 패밀리·크기를 requirements에 허용하고, EC2NodeClass의 capacityReservationSelectorTerms로 On-Demand Capacity Reservation을 먼저 소비하며(문서 기준 2026년 9월 Beta, karpenter.sh/capacity-type: reserved와 ec2:DescribeCapacityReservations 권한 필요), static NodePool의 replicas나 overprovisioning으로 노드를 미리 띄워 둔다2.
6. Nitro 세대별 성능 특성
앞의 IP 계획이 “얼마나 담을 수 있는가”라면, 이 절은 “담은 뒤 얼마나 빠른가”다. 파드가 배치될 인스턴스의 Nitro(System) 세대가 네트워크 대역폭과 TCP 동작, 필요한 드라이버 버전을 결정한다3.
6.1 세대별 네트워크 변경 사항
Nitro 세대의 기능은 누적된다. 상위 버전은 하위 버전 기능을 모두 포함한다(명시적 예외 제외). 노드로 쓸 인스턴스의 Nitro 버전은 그 패밀리 스펙 페이지에서 Platform summary 표의 Hypervisor 항목을 보면 알 수 있다3.
| 세대 | 주요 변경 | 대표 인스턴스 |
|---|---|---|
| v6 | 카드당 대역폭 최대 400Gbps. 유휴 TCP established 타임아웃이 432,000초에서 350초로 줄었다. 트래픽 미러링은 쓰지 못한다 | M8i·C8i·R8i, M8g, P6-B200, G7 |
| v5 | 카드당 대역폭 최대 200Gbps. 트래픽 미러링 없음 | M8g·C8g·R8g, Trn2, P5en, P6e-GB200 |
| v4 | GPU·Trainium 계열은 100Gbps, 나머지는 최대 170Gbps. ENA Express와 일부 타입의 RDMA(EFA)를 지원하며 트래픽 미러링이 가능하다 | M7i·C7i·R7i, M7g, Inf2, Trn1, P5, G6 |
| v3 | 카드당 대역폭 최대 100Gbps. 전송 중 암호화(encryption in transit)를 쓴다. 트래픽 미러링 가능 | C5n, R5n, P4d, G4dn, Inf1 |
| v2 | ENA 기반 향상된 네트워킹(enhanced networking)을 처음 들여왔다. 트래픽 미러링 가능 | M5·C5·R5, M6g·C6g, T3·T4g |
6.2 v6의 TCP 타임아웃 단축은 워크로드에 영향을 준다
Nitro v6에서 유휴 TCP 연결의 기본 established 타임아웃이 432,000초에서 350초로 크게 줄었다. 커넥션 풀, gRPC keepalive, 장시간 유휴 상태로 두는 DB 연결처럼 long-lived 연결을 유지하는 워크로드는 예상치 못한 연결 종료를 겪을 수 있다. 애플리케이션과 커널의 keepalive 설정(net.ipv4.tcp_keepalive_time 등)을 이 타임아웃보다 짧게 잡아야 연결이 유지된다3.
# 유휴 연결 유지 — 350초보다 짧게 잡는다
sysctl -w net.ipv4.tcp_keepalive_time=300
sysctl -w net.ipv4.tcp_keepalive_intvl=30
sysctl -w net.ipv4.tcp_keepalive_probes=5
6.3 드라이버·커널 요구사항
Nitro 인스턴스는 향상된 네트워킹에 ENA(Elastic Network Adapter)를, 스토리지 볼륨에 NVMe 블록 디바이스를 쓴다. 세대가 올라갈수록 요구사항이 엄격해지고, 이는 성능만이 아니라 ENI attach 성공 여부에 직결된다3.
- ENA Linux 드라이버 2.2.9 이상은 v4에서 권장, v5 이상에서 필수다. v5에서 2.2.9 미만, v5 이전 세대에서 1.2.0 미만이면 ENI attach 실패가 난다.
- 가속 경로(accelerated path) 기능은 최신 ENA 드라이버(2.2.9 이상)에서만 동작한다. 구버전 드라이버는 가속 경로를 지원하지 않아 PPS 성능이 떨어진다. 그래서 드라이버 최신화가 사실상 1순위 튜닝 항목이다.
| 배포판 | 요구 커널 |
|---|---|
| Amazon Linux 2 | 4.14.186 |
| RHEL | 8.4 (4.18.0-305) |
| Ubuntu | 20.04 (5.4.0-1025-aws) |
| Debian | 11 (5.10.0) |
| Linux upstream | 5.9 |
Amazon Linux 2023과 Bottlerocket은 Nitro v4 이상에 필요한 ENA 기능을 이미 갖추고 나오므로 커널을 따로 손볼 필요가 없다. EKS 노드는 가능하면 이 두 AMI를 쓰는 것이 드라이버·커널 관리 부담을 줄이는 방법이다. Graviton(arm64) 인스턴스는 조건이 하나 더 붙는다. 64-bit ARM용 AMI여야 하고, ACPI 테이블과 PCI 디바이스 ACPI 핫플러그를 다루는 UEFI 부팅이 필요하며, 운영체제는 Linux만 된다3.
6.4 PPS와 CPS를 함께 본다
모든 현세대 EC2 인스턴스는 패킷 처리를 Nitro 카드가 맡는다. 카드는 새 플로우의 첫 패킷에 대해 보안 그룹·ACL·라우팅을 평가하고, 같은 플로우의 후속 패킷에는 캐시된 정보를 재사용한다. 플로우는 출발·목적지 IP와 포트, 프로토콜로 이루어진 5-tuple로 식별된다3.
그래서 신규 연결률(CPS)은 5-tuple 전체 평가가 필요해 비싸고, 연결이 맺어진 뒤의 패킷(PPS)만 가속 경로의 이점을 받는다. DNS·방화벽·가상 라우터처럼 새 연결이 많이 생기는 워크로드는 가속 이점이 적으므로, 애플리케이션 차원에서 연결을 재사용하도록 설계해야 한다3.
주요 튜닝 포인트는 네 가지다.
- ENA 드라이버 최신화 — 가속 경로 활성화의 전제 조건이다.
- 비대칭 라우팅 회피 — 들어오는 인터페이스와 나가는 인터페이스가 다르면 보안 그룹의 conntrack 추적이 끼어들어 피크 성능이 깎인다. conntrack allowance가 바닥나면 새 연결이 throttle된다.
- 동일 AZ 통신 선호 — 장거리 연결은 TCP windowing과 RTT 증가로 PPS가 낮아진다.
- BQL(Byte Queue Limit) — ENA 드라이버와 대부분의 배포판에서 기본으로 꺼져 있다. fragment proxy override와 함께 켜면 성능이 제한될 수 있다.
MTU를 넘겨 조각내는 패킷이 많은 워크로드라면 fragment proxy mode를 검토한다. 나가는 fragment에 걸린 PPS 상한(1024)을 피해 가는 드라이버 옵션으로, 아래처럼 모듈을 올릴 때 켜고, 위에서 말한 BQL과는 같이 쓰지 않는다3.
# 큐(채널) 수 확인·조정
ethtool -l eth0
ethtool -L eth0 combined <N>

# 링 버퍼 확인·조정 — 드롭이 보이면 키운다
ethtool -g eth0
ethtool -G eth0 rx <SIZE> tx <SIZE>

# fragment proxy mode (BQL과 동시 사용 금지)
sudo insmod ena.ko enable_frag_bypass=1
워크로드별 일반 커널 파라미터는 AWS가 단일 권장값을 주지 않는다. 노드 모니터링 에이전트가 내는 커널 이벤트나 ethtool 드롭 메트릭이 관찰될 때 워크로드에 맞춰 올린다3.
| 파라미터 | 조정 계기 |
|---|---|
net.netfilter.nf_conntrack_max |
ConntrackExceededKernel — 커널 conntrack 테이블이 가득 참 |
kernel.pid_max |
ApproachingKernelPidMax — PID가 바닥나기 직전 |
fs.file-max / fs.nr_open |
ApproachingMaxOpenFiles — 열 수 있는 파일 수 한계 근접 |
net.core.somaxconn, net.ipv4.tcp_max_syn_backlog |
새 연결을 받아 두는 큐가 포화된 고CPS 서비스 |
net.core.rmem_max / net.core.wmem_max |
100Gbps 이상을 쏟을 때 소켓 버퍼가 부족 |
EKS 노드에서 이 값을 영구 적용할 때는 노드 OS를 직접 고치지 않고 부트스트랩 계층에서 넣는다. 관리형 노드그룹·self-managed는 launch template user data 또는 Bottlerocket의 [settings.kernel.sysctl], 파드 단위는 securityContext.sysctls(namespaced), 노드 전역은 부팅 시 도는 node-tuning DaemonSet을 쓴다. net.core.*나 net.ipv4.tcp_* 같은 노드 전역 파라미터는 파드 securityContext로는 못 넣는다는 점을 기억한다3.
성능 신호는 두 갈래로 본다. ENA 드라이버가 노출하는 ethtool 메트릭(bw_in/out_allowance_exceeded, pps_allowance_exceeded, conntrack_allowance_exceeded, conntrack_allowance_available)이 0이 아니면 해당 allowance가 한계에 닿았다는 뜻이다. EKS Node Monitoring Agent는 BandwidthInExceeded·BandwidthOutExceeded·PPSExceeded·ConntrackExceeded·LinkLocalExceeded·NetworkSysctl 같은 노드 이벤트로 한계 초과를 알린다. 이들은 Event 심각도라 Auto Repair를 트리거하지 않으므로 노드 자동 교체로 해결되지 않는다. 반복된다면 인스턴스 타입 상향이나 워크로드 분산 같은 설계 대응이 필요하다3.
실무 적용: IP 용량 산정표와 확장 절차
산정 워크시트
아래 입력값을 채우면 서브넷 예산이 나온다. Azure CNI를 오버레이 없이 쓰는 클러스터도 파드 IP가 VNet 서브넷 주소를 직접 소비한다는 점이 같으므로, 사내 AI 플랫폼에서 AWS·Azure 클러스터를 함께 굴릴 때 같은 표를 쓸 수 있다.
| 구분 | 항목 | 값(예) | 비고 |
|---|---|---|---|
| 입력 | 목표 파드 수 P |
800 | hostNetwork·SGP 파드 제외 |
| 입력 | 주력 인스턴스 (n × m) | 4 × 15 | ENI 수 × ENI당 IPv4 |
| 입력 | 노드당 파드 상한 | 56 | n × (m − 1) |
| 입력 | 여유 주소 WARM_IP_TARGET |
2 | churn 높으면 단독 사용 금지 |
| 입력 | 하한 MINIMUM_IP_TARGET |
16 | 주력 크기의 파드 수에 맞춤 |
| 입력 | 프리픽스 모드 여부 | Y/N | /28 = 16주소 단위 |
| 입력 | SGP 파드 수 | 0 | branch ENI 1개당 1주소 |
| 입력 | AZ·서브넷 수 | 3 | AZ 단위로 여유를 나눔 |
| 계산 | 노드 수 | ceil(P / 56) = 15 |
크기 fallback 여유 별도 |
| 계산 | 파드 풀 목표 T |
max(16, 800 + 2) |
개별 IP 모드면 P_pod ≈ T |
| 계산 | 프리픽스 수 F |
ceil(T / 16) |
프리픽스 모드 |
| 계산 | 노드 총소비 | P_eni + P_pod + 16F + P_branch |
node·trunk·branch 포함 |
| 계산 | 클러스터 총소비 | 노드 수 × 노드 총소비 + DR 여유 | 서브넷별로 다시 나눔 |
워크시트를 채운 뒤에는 세 가지를 교차 확인한다. 서브넷별 가용 주소가 목표의 20% 이상 남는지, NAU 쿼터(기본 64,000)에 여유가 있는지, DR 시 소형 노드 수백 대가 동시에 뜨는 시나리오에서도 서브넷이 버티는지를 본다2.
확장 런북
주소 부족이 확인됐을 때의 절차다. 앞 단계가 끝난 것을 확인한 뒤 다음 단계로 간다.
# 1) 병목 위치 확인 — 서브넷별 가용 주소
aws ec2 describe-subnets --subnet-ids subnet-0def \
  --query 'Subnets[].AvailableIpAddressCount'

# 2) 보조 CIDR을 VPC에 연결한다 (RFC 6598 공유 대역)
aws ec2 associate-vpc-cidr-block --vpc-id vpc-0abc --cidr-block 100.64.0.0/16

# 3) AZ별 서브넷 생성 후 CNI 발견용 태그 부여
aws ec2 create-tags --resources subnet-0def \
  --tags Key=kubernetes.io/role/cni,Value=1

# 4) warm 타깃은 애드온 configuration으로 관리 (기존 설정에 병합해 검토)
aws eks update-addon --cluster-name my-cluster --addon-name vpc-cni \
  --configuration-values file://reviewed-vpc-cni-config.json \
  --resolve-conflicts PRESERVE
| 단계 | 하는 일 | 완료 확인 |
|---|---|---|
| 1 | describe-subnets로 AZ별 가용 주소 확인 |
어느 AZ가 먼저 마르는지 식별 |
| 2 | IAM에 ec2:DescribeSubnets 권한 확인 |
노드 역할에 권한 존재 |
| 3 | CIDR 추가 → 서브넷 생성 → kubernetes.io/role/cni=1 태그 |
태그가 새 서브넷에 붙음 |
| 4 | 새 서브넷에서 secondary ENI가 만들어지는지 확인 | 기존 파드 무중단 |
| 5 | warm 타깃을 애드온 configuration으로 반영 | describe-addon의 configurationValues와 실제 DaemonSet 비교 |
| 6 | 서브넷 사용률·NAU 지표 재확인 | 80% 아래로 회복 |
warm 타깃을 바꿀 때는 현재 configurationValues와 실제 aws-node 설정을 먼저 저장하고, 설치된 애드온 버전의 schema를 확인한 뒤, 기존 설정 전체에 새 값을 병합한 파일을 검토한다. kubectl set env로 바꾼 값이 애드온 업데이트 뒤에도 남는지는 충돌 처리 방식에 따라 다르다. PRESERVE는 기존 수정을 보존할 수 있고 OVERWRITE는 관리 대상 필드를 덮어쓴다. 애드온 API를 써도 새 configuration-values에서 빠진 기존 고급 설정은 기본값으로 돌아갈 수 있으므로, PRESERVE를 썼다고 해서 요청한 새 값이 모두 반영됐다고 단정하면 안 된다. 업데이트 후에는 반환된 업데이트 ID로 describe-update의 Successful 여부와 describe-addon의 상태·health issue·configurationValues를 확인한다2.
모니터링 지표
| 지표 | 보는 곳 | 경보 기준(예) |
|---|---|---|
| 서브넷 가용 주소 | describe-subnets의 AvailableIpAddressCount |
사용률 80% 이상(가용 비율 20% 이하) |
| NAU 사용률 | CloudWatch | 80% 이상 |
| 파드용 ENI·IP 할당량 | 애드온 메트릭(DISABLE_METRICS=false 기본) → CNI Metrics Helper 또는 aws-node 61678 스크레이프 |
total 대비 assigned 격차 축소 |
| 노드별 assigned/total IP | CNI 메트릭 | 급증 시 fallback 의심 |
| branch ENI 소비 | 노드 allocatable pod-eni |
Insufficient vpc.amazonaws.com/pod-eni 발생 |
| 노드 네트워크 한계 초과 | NMA 이벤트 | 반복 시 타입 상향 |
| 런치 실패 | NodeClaim 이벤트 | InsufficientFreeAddressesInSubnet |
쿼터를 넘으면 RunInstances, AssignPrivateIpAddresses 같은 호출이 NetworkAddressUsageLimitExceeded로 실패하므로, 쿼터에 닿기 전에 상향을 요청한다. 소진 뒤에 CIDR을 추가해도 ENI가 실제로 할당되기까지 시간이 걸린다는 점도 감안한다2.
판단표: 상황별 선택
| 상황 | 먼저 볼 것 | 선택지 | 조건 |
|---|---|---|---|
| 서브넷 가용 주소 부족 | AZ별 가용 주소 | ESD + secondary CIDR | ec2:DescribeSubnets 권한 |
| ENI 슬롯 소진(밀도 한계) | ENI당 IP 수 | Prefix Delegation | 단편화 없는 전용 서브넷·CIDR reservation |
| 노드당 파드 상한을 늘려야 함 | kubelet max-pods |
프리픽스 모드 재계산 | in-place보다 신규 NodePool 롤아웃 |
| 특정 파드만 SG 필요 | SGP 대상 목록 | SGP 축소 + Network Policy 대체 | branch ENI 한도·Nitro 타입 |
| SGP 다수 필요 | branch ENI 상한 | 별도 NodePool·커스텀 네트워킹 | primary ENI 포기 → 파드 수 감소 |
| 소형 노드에 IP 유휴 | 노드별 assigned/total | NodePool 크기 상향·Pod 최소 크기 정책 | 클러스터 전역 warm 타깃 한계 인지 |
| 반복되는 IP 고갈 | 애드온 드리프트 | Auto Mode NodePool 이관 | SGP 미지원·110 상한 수용 |
롤백 기준
애드온이나 NodePool을 바꾼 뒤 아래 신호가 나오면 되돌린다.
| 신호 | 판단 | 되돌리기 |
|---|---|---|
| 애드온 업데이트 후 IP 고갈 재발 | 새 configuration-values에서 기존 설정이 빠졌다 |
백업한 이전 설정과 병합해 다시 반영, 충돌 시 추가 반영 중단 |
파드가 다수 ContainerCreating |
warm 타깃을 너무 낮게 잡아 EC2 API 스로틀링 | WARM_IP_TARGET 상향, MINIMUM_IP_TARGET과 함께 재설정 |
프리픽스 모드에서 InsufficientCidrBlocks |
서브넷 단편화 | CIDR reservation 확보 전까지 프리픽스 비활성 |
InsufficientFreeAddressesInSubnet 반복 |
특정 AZ 서브넷 고갈 | 새 서브넷·ESD 태그 우선, NodePool 크기 재조정 |
| 소형 노드 IP 유휴율 급증 | MINIMUM_IP_TARGET이 대형 노드 기준 |
fallback 크기 상향 또는 값 하향 |
도입 순서 체크리스트
- 주력 인스턴스의 ENI 수 × ENI당 IP를 확인하고 노드당 파드 상한을 계산했다.
- 목표 파드 수·여유·하한으로
T를 산정하고 개별 IP/프리픽스 모드를 정했다. MINIMUM_IP_TARGET과WARM_IP_TARGET을 함께 설정했다(하한 단독 사용 금지).WARM_IP_TARGET을 작게 잡을 경우 EC2 API 스로틀링 위험을 검토했다.- 파드 churn × 쿨다운(기본 30초)만큼의 상시 예약분을 반영했다.
- SGP 파드 비중과 branch ENI 한도를 별도 예산으로 계산했다.
- AZ별 서브넷 용량과 NAU 쿼터를 같은 표에 놓고 확인했다.
- DR 시나리오(소형 노드 다수 동시 기동)로 서브넷이 버티는지 검증했다.
- warm 타깃을 애드온 configuration으로 관리하고 이전 값을 백업했다.
- 서브넷 사용률·NAU 80% 경보와 런치 실패 이벤트 알림을 붙였다.
- 노드 세대별 ENA 드라이버 버전과 커널 요구사항을 확인했다(v5 이상 2.2.9 필수).
- Nitro v6 노드의 keepalive 설정이 350초 타임아웃보다 짧은지 확인했다.
정리하면, EKS의 IP 문제는 CNI 내부 동작과 서브넷 용량이라는 두 층에서 동시에 관리해야 한다. 데이터패스와 ipamd의 풀 관리 방식을 알고 있으면 파드가 멈춘 이유를 후보군으로 좁힐 수 있고, 노드 한 대의 소비량을 계산할 수 있으면 서브넷과 NodePool을 미리 설계할 수 있다. 계산에서 빠뜨리기 쉬운 것은 소형 인스턴스 fallback의 과다 예약과 branch ENI라는 별도 축이고, Karpenter는 이미 떠 있는 노드의 IP 고갈을 알려 주지 않는다는 점도 전제로 깔아 둬야 한다.
References
이 글은 다음 공개 매뉴얼 문서를 참고해 필자의 운영 맥락으로 재구성했다. 수치·플래그·명령은 해당 문서에 실린 범위에서만 사용했다.
-
Engineering Playbook —
docs/eks-best-practices/networking-performance/vpc-cni-deep-dive.md(https://devfloor9.github.io/engineering-playbook/) — VPC CNI 데이터패스, ipamd 풀 관리, NetworkPolicy 2계층 구조 ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7 ↩8 ↩9 ↩10 ↩11 ↩12 ↩13 ↩14 ↩15 ↩16 ↩17 ↩18 ↩19 ↩20 ↩21 -
Engineering Playbook —
docs/eks-best-practices/networking-performance/ip-capacity-planning-karpenter.md(https://devfloor9.github.io/engineering-playbook/) — IP 소비 계산식, NAU, SGP 한도, 서브넷 확장 경로, Karpenter 서브넷 선택 ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7 ↩8 ↩9 ↩10 ↩11 ↩12 ↩13 ↩14 ↩15 ↩16 ↩17 ↩18 ↩19 ↩20 ↩21 ↩22 ↩23 ↩24 ↩25 ↩26 ↩27 ↩28 ↩29 ↩30 ↩31 -
Engineering Playbook —
docs/eks-best-practices/networking-performance/nitro-architecture-performance-tuning.md(https://devfloor9.github.io/engineering-playbook/) — Nitro 세대별 네트워크 변경, ENA 드라이버·커널 요구사항, PPS/CPS 튜닝 ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7 ↩8 ↩9 ↩10 ↩11 ↩12
댓글남기기