
EKS 노드·GPU·네트워킹 장애 디버깅 실전 가이드: NodeNotReady부터 NCCL 타임아웃까지
EKS 운영에서 시간을 가장 많이 잡아먹는 일은 “무엇이 고장 났는지”보다 “어느 계층이 고장 났는지”를 찾는 과정이다. 파드가 Pending인지, 노드가 NotReady인지, 응답이 503인지에 따라 봐야 할 곳이 완전히 달라지는데, 신호를 잘못 읽으면 엉뚱한 계층에서 몇 시간을 태운다. 이 글은 AWS EKS 운영 매뉴얼의 디버깅 장1을 다시 정리하면서, 온콜 상황에서 실제로 손이 가는 순서대로 계층을 재배열한 기록이다. GPU 워크로드처럼 실패 원인이 하드웨어·네트워크·런타임에 걸쳐 있는 경우까지 같은 골격으로 따라갈 수 있게 묶었다.
1. 디버깅의 공통 골격: 계층별 신호
장애 대응이 느려지는 이유는 도구가 부족해서가 아니라 확인 순서가 매번 달라지기 때문이다.
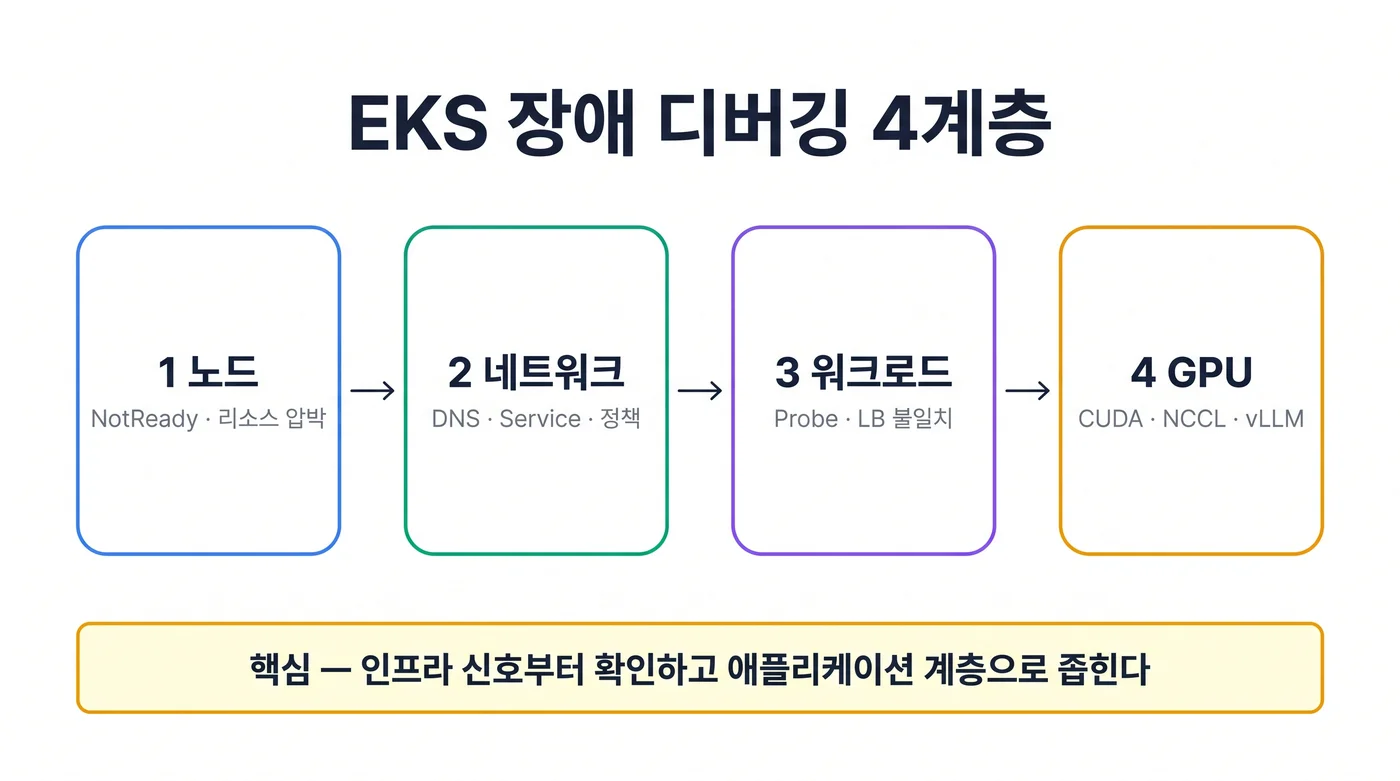
1.1 아래에서 위로 좁힌다
디버깅은 항상 물리 인프라에 가까운 쪽에서 시작한다. 노드가 Ready가 아니면 그 위의 파드 상태는 결과일 뿐 원인이 아니다.
- 노드: 인스턴스 생존, kubelet/containerd, 리소스 압박, 프로비저닝 컨트롤러
- 네트워크: VPC CNI의 IP 할당, DNS 해석, Service 엔드포인트, NetworkPolicy, Ingress/LB
- 워크로드: Probe 설정과 라이프사이클, 종료 시퀀스, 로드밸런서 헬스체크 불일치
- 가속기: GPU 드라이버·디바이스 플러그인, XID/NCCL 오류, 추론 서버 메모리 배분
1.2 신호를 읽는 네 개의 창
| 창 | 무엇을 보는가 | 대표 명령 |
|---|---|---|
| Kubernetes API | 오브젝트 상태·조건·이벤트 | kubectl describe node/pod |
| 노드 내부 | 커널·런타임·드라이버 로그 | journalctl -u kubelet, dmesg |
| AWS 컨트롤 플레인 | ENI·서브넷·보안그룹·노드그룹 헬스 | aws ec2 describe-* |
| 컨트롤러 로그 | 프로비저닝·LB 조정 실패 이유 | Karpenter·LBC 로그 |
1.3 사고 현장에서 가장 먼저 수집할 것
원인을 모르는 상태에서도 먼저 긁어모으면 나중에 시간을 아낀다. 노드가 살아 있는 동안에만 얻을 수 있는 정보도 있다.
kubectl describe node <node-name>        # 조건·taint·이벤트·할당량
kubectl get pods -A --field-selector=status.phase!=Running
sudo journalctl -u kubelet --no-pager | tail -100   # SSM 접속 후
sudo df -h && sudo free -m && sudo crictl ps -a
SSM으로 노드에 들어가려면 노드 IAM Role에 AmazonSSMManagedInstanceCore 정책이 있어야 한다. 관리형 노드 그룹(MNG)은 기본 포함이지만, 커스텀 AMI는 SSM Agent 설치를 따로 확인해야 한다.
2. 노드 레벨: NodeNotReady와 리소스 압박
노드 문제는 클러스터에 조인하지 못하는 경우와 조인은 했는데 Ready가 되지 못하거나 압박에 빠지는 경우로 나뉜다.
2.1 노드가 조인하지 못하는 여덟 가지 원인
조인 실패는 원인이 정형화되어 있다. 아래는 문서 기준으로 빈도 높은 순서대로 정리한 것이다.2
| 원인 | 확인 방법 |
|---|---|
| aws-auth에 노드 IAM Role 미등록(Access Entry 미생성) | aws-auth 매핑·액세스 엔트리 목록 대조 |
| 부트스트랩 ClusterName 불일치 | cloud-init 로그의 클러스터명 |
| 노드 보안그룹이 컨트롤 플레인 통신 차단 | TCP 443(API)·10250(kubelet) 허용 여부 |
| 퍼블릭 서브넷 auto-assign public IP 비활성 | 서브넷 속성 |
| VPC DNS 설정 비활성 | enableDnsHostnames, enableDnsSupport |
| STS 리전 엔드포인트 비활성 | 리전 엔드포인트 설정 |
| 인스턴스 프로파일 ARN을 Role ARN 대신 등록 | arn:...:role/... 형태인지 |
| 자체관리형 노드의 클러스터 태그 누락 | eks:kubernetes.io/cluster-name 태그 |
sudo journalctl -u kubelet --no-pager | tail -50
sudo cat /var/log/cloud-init-output.log | tail -50
aws ec2 describe-security-groups --group-ids $CLUSTER_SG --query 'SecurityGroups[].IpPermissions'
여기서 가장 흔한 실수는 인스턴스 프로파일 ARN을 등록하는 것이다. aws-auth와 액세스 엔트리에는 IAM Role ARN만 들어간다.
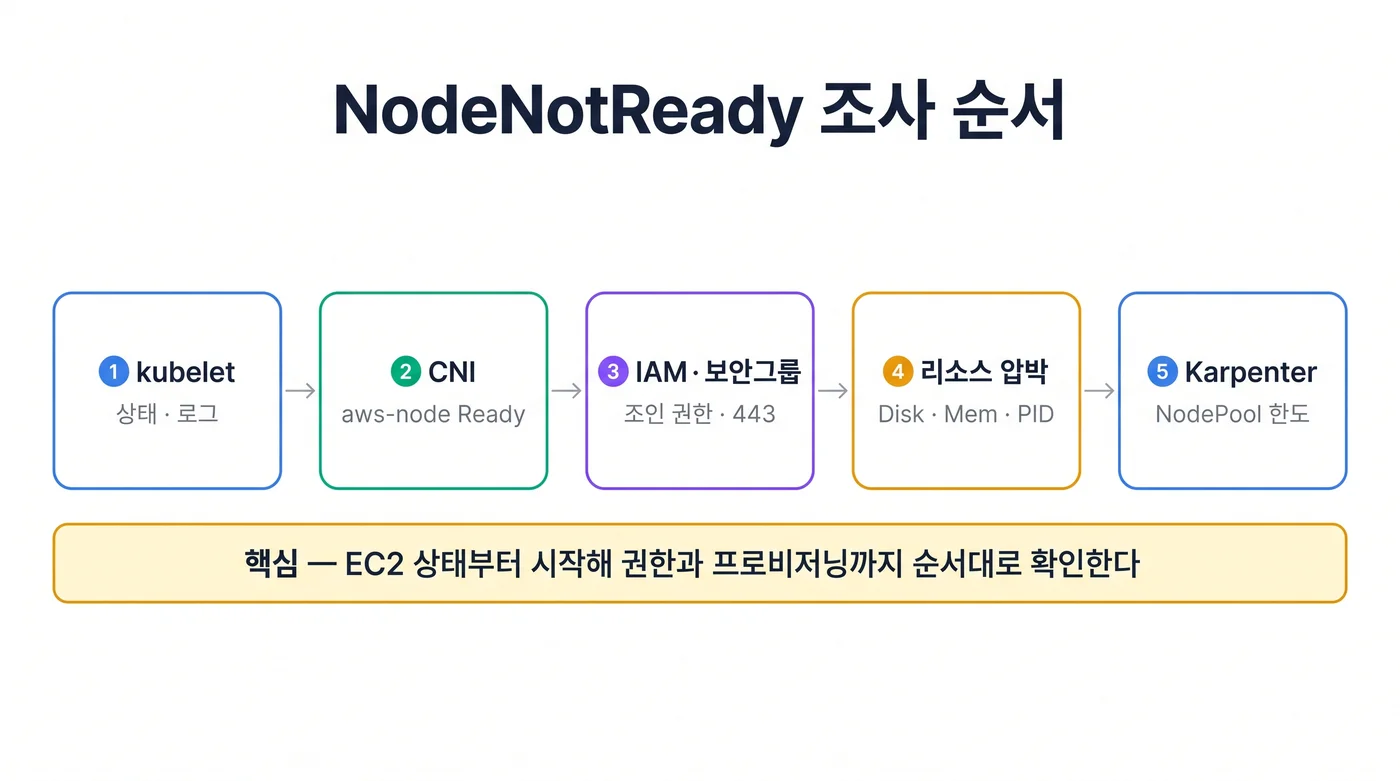
2.2 NodeNotReady 조사 순서
인스턴스가 살아 있는데도 NotReady라면 아래 순서로 내려가면 거의 항상 원인이 나온다.
Node NotReady
   +-- EC2 인스턴스 상태 ?  Stopped/Terminated -> 재시작 또는 새 노드 프로비저닝
   +-- kubelet 프로세스 ?   Not Running -> systemctl restart kubelet
   +-- containerd ?         Not Running -> systemctl restart containerd
   +-- 리소스 압박 조건 ?    DiskPressure   -> 이미지·컨테이너 정리
   |                        MemoryPressure -> 저우선순위 파드 축출/노드 교체
   |                        PIDPressure    -> pid_max 상향, 누수 컨테이너 식별
   +-- 노드 네트워크 ?       보안그룹 / NACL / VPC 라우팅 점검
2.3 kubelet과 containerd를 직접 본다
kubelet이나 containerd가 죽어 있으면 결과는 언제나 NotReady다. 재시작이 임시방편인지, 반복되는지까지 봐야 한다.
aws ssm start-session --target <instance-id>
systemctl status kubelet && journalctl -u kubelet -n 100 -f
systemctl status containerd && crictl pods && crictl ps -a
2.4 리소스 압박 세 가지와 해소
노드 컨디션이 임계값을 넘으면 kubelet이 파드를 축출하기 시작한다. 임계값과 대응을 세트로 외워두면 판단이 빨라진다.2
| Condition | 임계값(문서 기준) | 진단 | 해소 |
|---|---|---|---|
| DiskPressure | 사용 가능 디스크 < 10% | df -h |
crictl rmi --prune, crictl rm |
| MemoryPressure | 사용 가능 메모리 < 100Mi | free -m |
파드 축출, requests/limits 조정, 노드 교체 |
| PIDPressure | 사용 가능 PID < 5% | ps aux \| wc -l |
kernel.pid_max 상향, 누수 컨테이너 재시작 |
디스크 압박은 대부분 이미지 누적에서 온다. 오래 남은 큰 이미지를 지우는 것만으로 즉시 회복되는 경우가 많다.
2.5 노드그룹 헬스와 AccessDenied
관리형 노드 그룹은 프로비저닝 실패 이유를 헬스 상태로 노출한다.
aws eks describe-nodegroup --cluster-name $C --nodegroup-name $N --query 'nodegroup.health'
kubectl get clusterrole eks:node-manager && kubectl get clusterrolebinding eks:node-manager
AccessDenied 계열 오류는 대개 eks:node-manager ClusterRole 또는 ClusterRoleBinding이 삭제·변경된 탓이다. 핵심은 EKS 전용 RBAC가 자동 복원되지 않는다는 점이다.2 Kubernetes 기본 시스템 롤(system:*)은 API 서버가 다시 맞춰주지만 eks:* 계열은 그 대상이 아니다. 복구는 수동 재생성(kubectl auth reconcile -f <file>, 권장), 노드 그룹 재생성, 노드 그룹 업그레이드 순으로 시도한다. RBAC 오브젝트를 손대기 전에 백업을 남기는 습관이 필요하다.
2.6 Karpenter 프로비저닝이 안 될 때
Karpenter는 노드가 안 생기는 형태로 조용히 실패한다. 컨트롤러 로그와 NodePool/EC2NodeClass를 세트로 본다.
kubectl logs -f deployment/karpenter -n kube-system
kubectl describe nodepool <nodepool-name> && kubectl describe ec2nodeclass <nodeclass-name>
확인할 지점은 네 가지다. NodePool limits 초과 여부, EC2NodeClass의 서브넷·보안그룹 셀렉터 정확성, 인스턴스 타입 Service Quotas 여유, 파드의 nodeSelector/affinity와 NodePool requirements 매칭이다. Karpenter v1.0(v1 API)부터 Provisioner는 NodePool, AWSNodeTemplate은 EC2NodeClass로 바뀌었고 API 그룹도 karpenter.sh/v1이다. v0.x 설정이 남아 있으면 마이그레이션이 필요하다.2
2.7 Ready인데 파드가 안 올라올 때
노드는 Ready인데 스케줄링이 멈춘 경우는 준비 시점을 늦추는 장치가 걸려 있을 때다. 노드 쪽은 Node Readiness Controller(커스텀 taint를 선언적으로 관리, 2026.02 공개)가, 파드 쪽은 Pod Scheduling Readiness(schedulingGates, K8s 1.30 GA)와 Pod Readiness Gates(AWS LB Controller가 타겟 등록 완료까지 Ready 전환을 지연)가 담당한다.2 GPU 드라이버·CNI·CSI 초기화가 끝나기 전에 워크로드가 붙어 실패하는 문제를, taint가 해제될 때까지 기다리게 만드는 방식으로 풀 수 있다.
3. 네트워크 레벨: DNS·Service·NetworkPolicy
노드가 정상인데 통신이 안 되면 다음은 파드 네트워크다. 순서는 IP 할당 → 이름 해석 → Service 엔드포인트 → 정책 차단 → LB/Ingress다.
3.1 VPC CNI와 IP 고갈
EKS의 파드 IP는 VPC CNI(aws-node DaemonSet)가 ENI에 붙인 보조 IP에서 나온다. 따라서 서브넷 IP 고갈 = 파드 Pending으로 직결된다.
kubectl logs -n kube-system -l k8s-app=aws-node --tail=50
aws ec2 describe-subnets --subnet-ids <subnet-id> \
  --query 'Subnets[].{AZ:AvailabilityZone,Free:AvailableIpAddressCount}'
kubectl set env daemonset aws-node -n kube-system ENABLE_PREFIX_DELEGATION=true
완화책으로 Prefix Delegation을 켠다. ENI에 개별 IP 대신 /28 프리픽스(16개 IP)를 붙여 같은 ENI로 더 많은 파드를 수용하는 방식이다. 문서가 드는 c5.xlarge 예시는 기본 모드 최대 58개 파드(4 ENI × 15 IP − 1), Prefix Delegation 적용 시 최대 110개 파드다.3
kubectl set env로 바꾼 값은 애드온 업데이트 시 충돌 처리 방식에 따라 유지되거나 덮어써질 수 있으므로, 애드온 API의 configurationValues로 이관할 때는 현재 전체 설정에 변경을 병합해야 한다.
| 오류 메시지 | 먼저 볼 것 |
|---|---|
NetworkAddressUsageLimitExceeded |
VPC NAU(네트워크 주소 사용량) 한도 |
InsufficientFreeAddressesInSubnet |
실제 선택된 AZ·서브넷의 여유 IP |
다른 서브넷에 IP가 남아 있어도, 스케줄러가 고른 서브넷에 여유가 없으면 실패한다. AZ 단위로 봐야 한다.3
3.2 DNS: CoreDNS와 ndots
DNS가 흔들리면 클러스터 전체가 아프다. CoreDNS가 OOMKilled되면 이름 해석 자체가 멈춘다.
kubectl logs -n kube-system -l k8s-app=kube-dns --tail=50
kubectl set resources deployment coredns -n kube-system --limits=memory=300Mi --requests=memory=100Mi
성능 문제로 자주 지목되는 것이 ndots:5다. 파드 resolv.conf의 search 목록 때문에 외부 도메인 한 번 조회에 쿼리가 다섯 번까지 나간다. api.example.com을 찾을 때 .default.svc.cluster.local부터 차례로 실패하고 마지막에 성공하는 식이다.
해결은 세 갈래다. 파드 스펙의 dnsConfig.options에서 ndots를 2로 낮추거나, 외부 호출에 trailing dot을 붙여 FQDN으로 즉시 질의하거나, 노드별 캐시(NodeLocal DNSCache)를 깔아 CoreDNS와 VPC DNS 호출을 줄이는 것이다. VPC DNS resolver에는 ENI당 1,024 packets/sec 제한이 있다.3 규모가 커지면 캐시 계층 없이는 한계에 부딪힌다.
3.3 Service 연결이 안 되는 세 가지 패턴
Service 문제는 대부분 엔드포인트가 비어 있느냐로 갈린다.
| 패턴 | 확인 | 해결 |
|---|---|---|
| selector 라벨 불일치 | kubectl get endpoints <svc>가 <none> |
selector 또는 파드 라벨 정합 |
| port/targetPort 불일치 | 파드가 실제 리스닝하는 포트 | targetPort 수정 |
| 파드가 NotReady | 엔드포인트에서 제외되는지 | Probe 점검 |
NodePort가 안 열리면 보안그룹에서 30000–32767 대역 허용 여부를, LoadBalancer가 계속 Pending이면 AWS Load Balancer Controller 설치와 IAM 권한을 확인한다.
kubectl get endpoints <service-name>
kubectl get svc <service-name> -o jsonpath='{.spec.selector}' && kubectl get pods --show-labels
3.4 NetworkPolicy의 AND와 OR
NetworkPolicy에서 가장 위험한 실수는 들여쓰기 한 단계로 정책 의미가 완전히 달라지는 것이다.3 같은 - from 항목 안에 namespaceSelector와 podSelector를 함께 두면 AND, 별도 항목으로 나누면 OR다.
# AND: namespaceSelector와 podSelector가 같은 from 항목 안에 있다
  ingress:
    - from:
        - namespaceSelector:
            matchLabels: {user: alice}
          podSelector:
            matchLabels: {role: client}
# OR: 별도 from 항목으로 분리한다
  ingress:
    - from:
        - namespaceSelector:
            matchLabels: {user: alice}
        - podSelector:
            matchLabels: {role: client}
Default Deny는 명시적으로 허용하지 않은 트래픽을 전부 막는다. 프로덕션 적용 전에 Allow 규칙을 먼저 작성하고 검증 환경에서 순서를 확인해야 한다.
3.5 netshoot으로 경로를 따라간다
도구가 모자라서 진단이 멈추는 상황을 없애려면 디버깅 이미지를 표준처럼 쓴다. netshoot에는 dig, curl, tcpdump, ss, traceroute, iperf3가 들어 있다.3
kubectl run tmp-shell --rm -i --tty --image nicolaka/netshoot -- bash
dig <service-name>.<namespace>.svc.cluster.local
tcpdump -i any host <pod-ip> -n && ss -tunap
4. GPU/AI 워크로드: CUDA·NCCL·vLLM
GPU 계층은 실패 신호가 하드웨어와 소프트웨어에 걸쳐 나온다. 드라이버 → 디바이스 플러그인 → 메트릭 → 워크로드 순으로 좁히면 원인 계층이 분리된다.4
4.1 GPU 진단 순서
GPU 문제 발생
   +-- nvidia-smi 실행 불가? -> 드라이버 설치/GPU Operator ClusterPolicy 확인
   +-- GPU 미인식?          -> Driver DaemonSet Ready 확인
   +-- Device Plugin 이상?  -> Device Plugin 로그
   +-- DCGM 메트릭 이상?    -> DCGM Exporter 로그
   +-- 모두 정상            -> 워크로드(CUDA/NCCL/vLLM) 디버깅
노드에서는 kubectl debug node/<gpu-node-name> -it --image=nvidia/cuda:12.2.0-base-ubuntu22.04로 진입해 nvidia-smi -q를 확인하고, kubectl describe node <gpu-node-name> | grep nvidia.com/gpu로 노드가 노출하는 GPU 개수를 본다.
4.2 XID 코드 읽기
GPU 하드웨어 오류는 커널 로그의 XID 코드로 드러난다.4 코드에 따라 재시작으로 넘어갈 일과 노드를 교체해야 할 일이 갈린다.
| XID | 의미 | 조치 |
|---|---|---|
| 13 | 그래픽 엔진 예외 | 드라이버 업데이트, CUDA 버전 확인 |
| 31 | GPU 메모리 페이지 폴트 | 드라이버 업데이트, 메모리 할당 검증 |
| 43 | GPU 응답 없음 | 노드 재시작 |
| 45 | 컨텍스트 전환 오류 | 드라이버 업데이트 |
| 48 | Double bit ECC 오류 | 하드웨어 결함, 노드 교체 |
| 62 | 내부 마이크로컨트롤러 오류 | 드라이버 재설치, 노드 재시작 |
| 74 | NVLink 오류 | NVLink 토폴로지·케이블 점검 |
| 79 | 버스에서 이탈 | 하드웨어 결함, 노드 교체 |
| 94 | 메모리 무결성 오류 | ECC 모드 확인, 교체 검토 |
48과 79는 재시작으로 해결되지 않는다. 해당 노드를 풀에서 빼고 교체하는 쪽이 빠르다.
4.3 NCCL 타임아웃
멀티 GPU·멀티 노드 학습에서 가장 흔한 실패는 NCCL 통신 타임아웃이다. 로그 가시성을 먼저 올린다.
env:
  - {name: NCCL_DEBUG, value: "INFO"}
  - {name: NCCL_SOCKET_IFNAME, value: "eth0"}
  - {name: NCCL_IB_DISABLE, value: "1"}
원인은 세 갈래다. 같은 보안그룹 내 노드 간 트래픽 허용 여부(nc -zv <pod-ip> 12345로 확인), p4d·p5 계열의 EFA Device Plugin 설치와 vpc.amazonaws.com/efa 요청, 그리고 vLLM --tensor-parallel-size가 파드 GPU 수와·PyTorch DDP WORLD_SIZE가 실제 GPU 수와 일치하는지다. 분산 초기화만 따로 검증하려면 torch.distributed.init_process_group(backend='nccl') 후 torch.ones(1).cuda()에 all_reduce를 걸어 성공 여부를 본다.
4.4 vLLM 메모리 부족을 구분한다
vLLM에서 메모리 부족은 두 가지다. 모델 가중치가 안 들어가는 경우와 KV Cache 공간이 부족한 경우다.
| 증상 | 원인 | 조치 |
|---|---|---|
| 모델 로드 시 OOM | 모델이 GPU 메모리보다 큼 | 더 큰 GPU, AWQ/GPTQ 양자화 |
추론 중 No available blocks |
KV Cache 공간 부족 | gpu_memory_utilization 상향(0.9→0.95) |
| 짧은 요청만 성공 | KV Cache 부족 | max_model_len, max_num_batched_tokens 하향 |
| 재현 어려운 랜덤 OOM | 파편화 | 서버 재시작, swap_space 증가 |
args:
  - --model=/models/llama-3.1-70b
  - --tensor-parallel-size=4     # GPU 수와 일치
  - --gpu-memory-utilization=0.85
  - --max-model-len=8192
튜닝은 한 방향으로 움직인다.4 OOM이면 gpu_memory_utilization을 0.9 → 0.85 → 0.8로 내리고 max_model_len을 16k → 8k → 4k로 줄인다. GPU 활용률이 낮으면 max_num_batched_tokens를 올린다. Tensor Parallel은 모델 hidden dimension의 약수(2, 4, 8)일 때 최적이다. 문서 예시로 H100 80GB 8장은 70B 모델에 8, A100 80GB 4장은 양자화 모델에 4를 쓴다.
4.5 GPU Operator와 Auto Mode
GPU Operator는 ClusterPolicy 하나로 드라이버부터 메트릭까지 관리한다. 문제가 생기면 kubectl describe clusterpolicy gpu-cluster-policy로 조건을 확인하고 드라이버·디바이스 플러그인 파드 로그를 나눠 본다.
드라이버 파드 실패 시 대표 메시지는 세 가지다. Kernel headers not found는 노드 AMI에 kernel-devel 패키지가 없다는 뜻이고, Driver compilation failed는 커널과 드라이버 호환성, nouveau driver is loaded는 AMI 빌드 시 nouveau 블랙리스트 누락이다.
EKS Auto Mode에서는 GPU 드라이버를 AWS가 관리하므로 GPU Operator를 그대로 깔면 충돌한다.4 하이브리드 구성에서는 GPU 노드 쪽에만 Operator를 설치하고 디바이스 플러그인을 끈다.
spec:
  driver: {enabled: true}
  devicePlugin: {enabled: false}   # Auto Mode와의 충돌 방지
GPU 노드는 taint(nvidia.com/gpu=true:NoSchedule)로 분리해 일반 워크로드가 올라가지 않게 한다.
5. 헬스체크 불일치: Probe와 로드밸런서
인프라가 전부 정상인데 502/503/504가 나는 상황의 상당수는 Kubernetes Probe와 로드밸런서 헬스체크가 서로 다른 시계로 돌아가기 때문이다.5
5.1 두 메커니즘 비교
| 항목 | K8s Probe | ALB/NLB Target Group HC | Ingress-NGINX |
|---|---|---|---|
| 실행 주체 | kubelet | ALB/NLB | nginx 프로세스 |
| 체크 위치 | 노드 내부에서 컨테이너로 | 외부에서 파드 IP로 | L7 프록시 레벨 |
| 실패 시 동작 | Endpoints 제거/재시작 | Target deregister | upstream 제거 후 재시도 |
| 설정 위치 | Pod spec | Service annotation | Ingress annotation |
Probe는 노드 내부에서 돌기 때문에 노드 보안그룹이나 라우팅 문제에 영향을 받지 않는다.6 반대로 LB는 파드 IP로 외부 요청을 보내므로, 보안그룹이 막히면 Probe만 통과하고 LB는 실패하는 비대칭이 생긴다.
5.2 타이밍 기본값 비교
| 설정 | K8s Probe | ALB HC | NLB HC | Ingress-NGINX |
|---|---|---|---|---|
| 기본 interval | 10s | 15s | 30s | 실제 트래픽 |
| 기본 timeout | 1s | 5s | 6s | 60s(proxy_read_timeout) |
| 실패 threshold | 3 | 2(unhealthy) | 3 | 없음 |
여기서 사고가 난다. LB는 Probe보다 느리게, 더 길게 기다린다.5 Probe가 실패로 판정하는 시점과 LB가 unhealthy로 넘기는 시점이 어긋나면서, 한쪽만 트래픽을 보내거나 보내지 않는 구간이 생긴다.
5.3 패턴 1: 파드는 Ready인데 503
가장 흔한 조합이다. 파드는 Running 1/1, 엔드포인트도 채워져 있는데 요청은 503이다. 원인은 세 가지로 좁혀진다.
- 경로 불일치: readinessProbe는
/healthz(200), ALB HC는/(404) - 타임아웃 불일치: Probe timeout 1초 안에 응답하지만 ALB HC가 기대하는 5초 안에 못 끝남
- 보안그룹 불일치: ALB → 파드 CIDR 차단. kubelet은 내부라 통과, ALB는 외부라 실패
TargetHealth.Reason은 원인을 요약해 준다.5 Target.FailedHealthChecks는 헬스체크 실패, Elb.RegistrationInProgress·Target.DeregistrationInProgress는 등록·해제 진행 중, Target.InvalidState는 파드 IP 도달 불가(보안그룹 문제)다. 확인은 kubectl get endpoints <service-name> -o yaml과 aws elbv2 describe-target-health --target-group-arn <tg-arn> --output table로 한다. 경로를 통일하는 것이 가장 빠른 해결이다.7
metadata:
  annotations:
    alb.ingress.kubernetes.io/healthcheck-path: /healthz
    alb.ingress.kubernetes.io/healthcheck-timeout-seconds: "5"
    alb.ingress.kubernetes.io/healthy-threshold-count: "2"
5.4 패턴 2: 종료 중 502
배포나 스케일 인 시점에 간헐적으로 502가 나면 종료 시퀀스 불일치다. 파드는 SIGTERM을 받고 즉시 죽는데, LB는 아직 deregistration 대기 중이라 죽은 파드로 요청을 보낸다.
T+0s   Pod Terminating, preStop 실행 / ALB deregistration 시작(기본 300초 대기)
T+0s   SIGTERM -> 앱이 즉시 종료 시작 / T+1s~ ALB는 아직 draining 중 -> 502
T+30s  terminationGracePeriodSeconds 도달 -> SIGKILL / T+300s deregistration 완료
핵심 공식은 terminationGracePeriodSeconds > deregistration_delay + preStop_sleep + app_shutdown_buffer다.5 deregistration_delay=15s, preStop=10s, app_shutdown=5s라면 40초 이상으로 잡는다.
spec:
  template:
    spec:
      terminationGracePeriodSeconds: 40
      containers:
        - name: app
          lifecycle:
            preStop: {exec: {command: ["/bin/sh", "-c", "sleep 15"]}}
# Service: deregistration_delay.timeout_seconds=15 (기본 300초 → 15초)
앱에도 SIGTERM 핸들러가 있어야 한다. 신호를 잡아 새 요청을 503으로 거절하고, 진행 중 요청을 마친 뒤 스스로 종료하는 코드가 필요하다.
5.5 패턴 3: 롤링 업데이트 중 503
새 파드가 Ready가 되는 즉시 트래픽을 받으면, LB가 healthy로 판정하기 전 구간에 요청이 들어간다.
T+10s  readinessProbe 성공, Endpoints 추가 -> T+15s ALB 첫 Health Check
T+30s  ALB healthy 판정 -> 트래픽 전송 시작 (T+10s~T+30s 구간 요청은 실패 가능)
minReadySeconds를 ALB HC 주기 × threshold 이상으로 두면 이 구간을 덮는다.
spec:
  minReadySeconds: 30        # ALB HC interval(15s) x threshold(2)
  strategy: {rollingUpdate: {maxUnavailable: 1, maxSurge: 1}}
워크로드 성격별로 값을 이렇게 잡는다(문서 기준).5
| 워크로드 유형 | readinessProbe period | ALB HC interval | minReadySeconds | terminationGracePeriodSeconds |
|---|---|---|---|---|
| Stateless API | 5s | 15s | 30s | 40s |
| 배치 워커 | 10s | 30s | 60s | 120s |
| 롱리브드 연결 | 10s | 30s | 60s | 300s |
| gRPC 서비스 | 5s | 15s | 30s | 40s |
PodDisruptionBudget(minAvailable: 50% 등)도 같이 걸어 자발적 중단 중 가용 파드 수를 지킨다.
5.6 패턴 4·5: NLB 정책과 Ingress 타임아웃
externalTrafficPolicy는 클라이언트 IP 보존과 균등 분배를 맞바꾼다.
| 값 | 클라이언트 IP | 헬스체크 | 분배 |
|---|---|---|---|
| Cluster (기본) | SNAT으로 소실 | 모든 노드 healthy | 균등, 노드 간 hop 발생 |
| Local | 보존 | 파드가 있는 노드만 healthy | 파드 수에 비례해 불균등 |
Local을 쓰면 파드가 없는 노드는 Target Group에서 빠지므로 노드당 파드가 최소 1개는 있어야 한다. 균등 분배가 우선이면 Cluster를 쓰고 X-Forwarded-For로 클라이언트 IP를 읽는다.
Ingress-NGINX의 504는 대개 proxy-read-timeout(기본 60초)이 백엔드 처리 시간보다 짧아서 생긴다.8 업로드 실패는 proxy-body-size(기본 1m) 초과로 413이 된다. 배치 API는 Ingress를 분리해 proxy-read-timeout: "1800", proxy-body-size: "1g"처럼 타임아웃과 바디 크기를 따로 잡는 편이 안전하다.
6. 장애 유형별 명령 치트시트
증상에서 바로 명령으로 점프할 수 있게 계층별로 묶어둔다.
| 계층 | 대표 명령 |
|---|---|
| 노드 | kubectl describe node, aws eks describe-nodegroup --query 'nodegroup.health', eks-node-viewer --resources cpu,memory |
| 네트워크 | kubectl get pods -n kube-system -l k8s-app=aws-node, kubectl get endpoints, aws elbv2 describe-target-health |
| GPU | kubectl get pods -n gpu-operator -o wide, kubectl logs -l app=nvidia-device-plugin-daemonset, kubectl logs <vllm-pod> \| grep NCCL |
| 헬스체크 | kubectl describe targetgroupbindings -A, kubectl describe ingress <ingress-name> |
실무 적용: 온콜 런북과 디버깅 체크리스트
여기까지가 무엇을 볼 수 있는가라면, 실무에서 필요한 것은 누가 언제 무엇을 보고 언제 넘기는가다. 온콜 런북을 계층 고정 순서로 만들어두면 대응 시간이 크게 줄어든다.
온콜 대응 런북
| 단계 | 목적 | 명령·판단 기준 | 에스컬레이션 조건 |
|---|---|---|---|
| 1. 영향 범위 확정 | 전체/부분/단일 노드 구분 | kubectl get nodes, get pods -A |
컨트롤 플레인 접근 불가 시 즉시 AWS Support |
| 2. 계층 분류 | 노드/네트워크/워크로드/GPU 중 하나로 좁힘 | NotReady → 2장, 통신 실패 → 3장, 5xx → 5장 | 15분 내 분류 실패 시 2인 검증 투입 |
| 3. 로그·이벤트 수집 | 원인 판단 전 증거 확보 | describe, journalctl -u kubelet, dmesg |
노드 교체 예상 시 교체 전 스냅샷 |
| 4. 완화 조치 | 서비스 복구 우선 | cordon·drain, 파드 재시작, 트래픽 우회 | 완화 후 5분 지속 시 상위 에스컬레이션 |
| 5. 원인 확정 | 재발 방지 근거 확보 | XID 코드, TargetHealth.Reason, CNI 로그 |
XID 48/79는 노드 격리 |
| 6. 사후 조치 | 재발 방지 항목 등록 | 설정 이관, 임계값 조정, 런북 갱신 | 동일 원인 3회 반복 시 설계 재검토 |
사전 예방 점검 체크리스트
디버깅 비용은 사전 점검으로 대부분 줄일 수 있다.
- 노드 IAM Role이 aws-auth/Access Entry에 Role ARN으로 등록되어 있는가
- 노드 보안그룹이 TCP 443(API)·10250(kubelet)을 허용하는가
- 서브넷 여유 IP를 AZ별로 모니터링하는가(IP 고갈 = 파드 Pending)
- Prefix Delegation, NodeLocal DNSCache 같은 용량·캐시 계층을 검토했는가
- CoreDNS 메모리 한도와
ndots가 워크로드 특성에 맞는가 - NetworkPolicy Default Deny 전에 Allow 규칙을 모두 검증했는가
- readinessProbe 경로·포트가 LB 헬스체크와 문자 그대로 일치하는가
terminationGracePeriodSeconds > deregistration_delay + preStop + shutdown인가minReadySeconds ≥ LB HC interval × threshold인가- GPU 노드에 XID/ECC 모니터링과 드라이버 버전 고정 정책이 있는가
eks:*RBAC 오브젝트 백업이 있는가(자동 복원 안 됨)- Karpenter NodePool
limits와 인스턴스 타입 Service Quotas에 여유가 있는가
판단표: 완화와 롤백
장애 중에는 고칠 것인가, 되돌릴 것인가를 빠르게 정해야 한다.
| 상황 | 1차 완화 | 롤백·교체 기준 |
|---|---|---|
| 단일 노드 NotReady | cordon 후 drain, 파드 재스케줄 | kubelet/containerd 반복 재시작 실패 시 노드 교체 |
| 다수 노드 동시 NotReady | 노드그룹 헬스·RBAC·SG 순 점검 | 설정 오류면 신규 노드그룹으로 우회 |
| 파드 Pending(IP 고갈) | 서브넷 여유 확인, Prefix Delegation 적용 | AZ 단위 고갈이면 서브넷 추가 후 재배포 |
| DNS 전면 실패 | CoreDNS 재시작, 메모리 상향 | 캐시 미설치 대규모 클러스터면 NodeLocal DNSCache 도입 |
| GPU XID 48/79 | 노드 cordon·drain | 노드 교체 필수(재시작으로 복구 불가) |
| NCCL 타임아웃 | 보안그룹·EFA·병렬 설정 점검 | 재현 지속 시 병렬 차원 축소 후 재시도 |
| 배포 중 502/503 | 롤아웃 일시 중지, 이전 버전 유지 | 헬스체크·종료 시퀀스 수정 전 재배포 금지 |
Azure/K8s 환경으로 옮길 때
같은 골격은 다른 관리형 쿠버네티스에도 그대로 통한다. AKS에서도 노드 NotReady는 kubelet → CNI → 권한 → 리소스 압박 순으로 좁히면 되고, IP 고갈은 VPC CNI 대신 Azure CNI의 서브넷 IP 소진으로 형태만 바뀌어 나타난다. 로드밸런서 계층도 Application Gateway나 Load Balancer의 헬스 프로브가 kubelet Probe와 별개 시계로 돈다는 점은 동일하므로, 프로브 경로와 타임아웃을 맞추는 원칙은 그대로 적용된다.
References
-
Engineering Playbook — EKS 디버깅 가이드 인덱스:
docs/eks-best-practices/operations-reliability/eks-debugging/index.md(devfloor9.github.io/engineering-playbook) ↩ -
Engineering Playbook — 노드 레벨 디버깅:
docs/eks-best-practices/operations-reliability/eks-debugging/node.md(devfloor9.github.io/engineering-playbook) ↩ ↩2 ↩3 ↩4 ↩5 -
Engineering Playbook — 네트워킹 디버깅:
docs/eks-best-practices/operations-reliability/eks-debugging/networking.md(devfloor9.github.io/engineering-playbook) ↩ ↩2 ↩3 ↩4 ↩5 -
Engineering Playbook — GPU/AI 워크로드 디버깅:
docs/eks-best-practices/operations-reliability/eks-debugging/gpu-ai-workload.md(devfloor9.github.io/engineering-playbook) ↩ ↩2 ↩3 ↩4 -
Engineering Playbook — Probe vs Health Check 불일치 디버깅:
docs/eks-best-practices/operations-reliability/eks-debugging/health-check-mismatch.md(devfloor9.github.io/engineering-playbook) ↩ ↩2 ↩3 ↩4 ↩5 -
Kubernetes — Configure Liveness, Readiness and Startup Probes (kubernetes.io) ↩
-
AWS Load Balancer Controller — Ingress/Service Annotations (kubernetes-sigs.github.io/aws-load-balancer-controller) ↩
-
Ingress-NGINX — Configuration Annotations (kubernetes.github.io/ingress-nginx) ↩
댓글남기기