
MCP 기반 에이전트 아키텍처 패턴: LLMOps 진화·안전한 페일오버·자가 개선 사례에서 뽑은 설계 원칙
MCP(Model Context Protocol) 서버를 하나 띄우는 일 자체는 어렵지 않다. 도구 몇 개를 스키마와 함께 노출하면 에이전트가 그것을 호출한다. 문제는 그다음부터다. 에이전트가 호출할 수 있는 행동의 범위가 넓어질수록 추론 오류 하나가 곧바로 프로덕션 인프라 변경이 되고, 도구가 늘어날수록 모델은 더 자주 엉뚱한 도구를 고르며, 배포 후에는 무엇이 왜 실패했는지 추적할 수 없다.
이 글은 그 “그다음”을 다룬다. 사내 AI 플랫폼에 MCP 서버와 에이전트 도구를 들이는 과정에서 되풀이해 마주치는 질문 — 얼마나 많은 권한을 줄 것인가, 언제 실행을 맡길 것인가, 무엇을 도구로 만들 것인가 — 을 설계 패턴의 언어로 정리해 보려 한다. 2026년 8월 MCP Dev Summit Seoul 2026에서 공개된 발표 자료들을 참고해 재구성했고1, 특정 세션의 요약이 아니라 그 안에서 반복적으로 등장한 설계 원칙을 필자의 언어로 다시 엮은 독립 문서다. 기존 MCP 글(Host–Client–Server 토폴로지·JSON-RPC 핸드셰이크·3대 프리미티브)이 프로토콜의 “무엇”을 다뤘다면, 여기서는 그 위에 얹히는 “어떻게”를 다룬다.
1. 에이전트에게 실행 권한을 그냥 주면 안 되는 이유
1.1 확률적 추론과 결정적 인프라의 충돌
에이전트와 인프라 자동화는 근본적으로 다른 성질의 시스템이다.
| 구분 | AI 에이전트 | 쿠버네티스 오퍼레이터 |
|---|---|---|
| 동작 방식 | 맥락 의존적·적응적 | 선언적·정책 기반 |
| 결과의 성질 | 확률적 (틀릴 수 있음) | 결정적 실행 |
| 실패 모드 | 그럴듯한 오답 | 상태 불일치 후 재조정 |
| 책임 소재 | 프롬프트·모델·도구 경계 | 컨트롤러 로직 |
핵심은 “에이전트가 자주 틀린다”가 아니라, 에이전트가 틀리는 방식과 인프라가 요구하는 정확성이 서로 맞지 않는다는 점이다. 확률적 추론의 출력을 결정적 실행 계층에 직결하면, 오류가 곧 상태 변경이 된다.
1.2 kubectl을 그냥 주면 무슨 일이 생기는가
에이전트에 쿠버네티스 API 접근 권한을 주면, 관찰과 변경이 같은 행동 표면(action surface)에 섞인다.
에이전트가 직접 kubectl/RBAC를 받은 경우:

  조회 (상대적으로 안전)          변경 (되돌리기 어려움)
  ├─ get pods                     ├─ patch resources
  ├─ get logs                     ├─ delete resources
  └─ describe                     └─ exec commands

  → 추론 오류가 즉시 인프라 변경으로 이어진다
  → 실행 절차(재시도·검증·복구)가 에이전트 안으로 새어 들어온다
이 상황을 한 문장으로 요약하면 이렇다. “에이전트에게 쿠버네티스 접근을 주는 것은 쉽다. 그냥 kubectl을 주고 행동하게 두면 된다. 문제는 그 다음이다.”2 관찰 도구와 파괴적 도구가 같은 권한을 공유하는 순간, 검증된 컨트롤 루프를 우회하는 경로가 열린다.
1.3 실행이 아니라 결정 공간에 참여시킨다
방향 전환은 단순하다. 에이전트가 실행을 대체하게 하지 않고, 결정(추천)에만 참여하게 한다. 사람이 판단하던 “어디로 페일오버할까” 같은 결정 공간은 맥락이 많고 경우의 수가 넓어 에이전트가 가치를 더할 수 있는 영역이다. 반대로 “실제로 그 전환을 수행하는 절차”는 검증되고 반복 가능해야 하므로 기존 컨트롤러에 남겨 둔다.
에이전트가 잘하는 것            컨트롤러가 잘하는 것
─────────────────────           ─────────────────────
여러 신호를 종합해 판단          정해진 절차를 정확히 수행
맥락에 따라 적응                 정책·권한을 일관되게 강제
추천·설명 생성                   상태를 추적하고 재조정
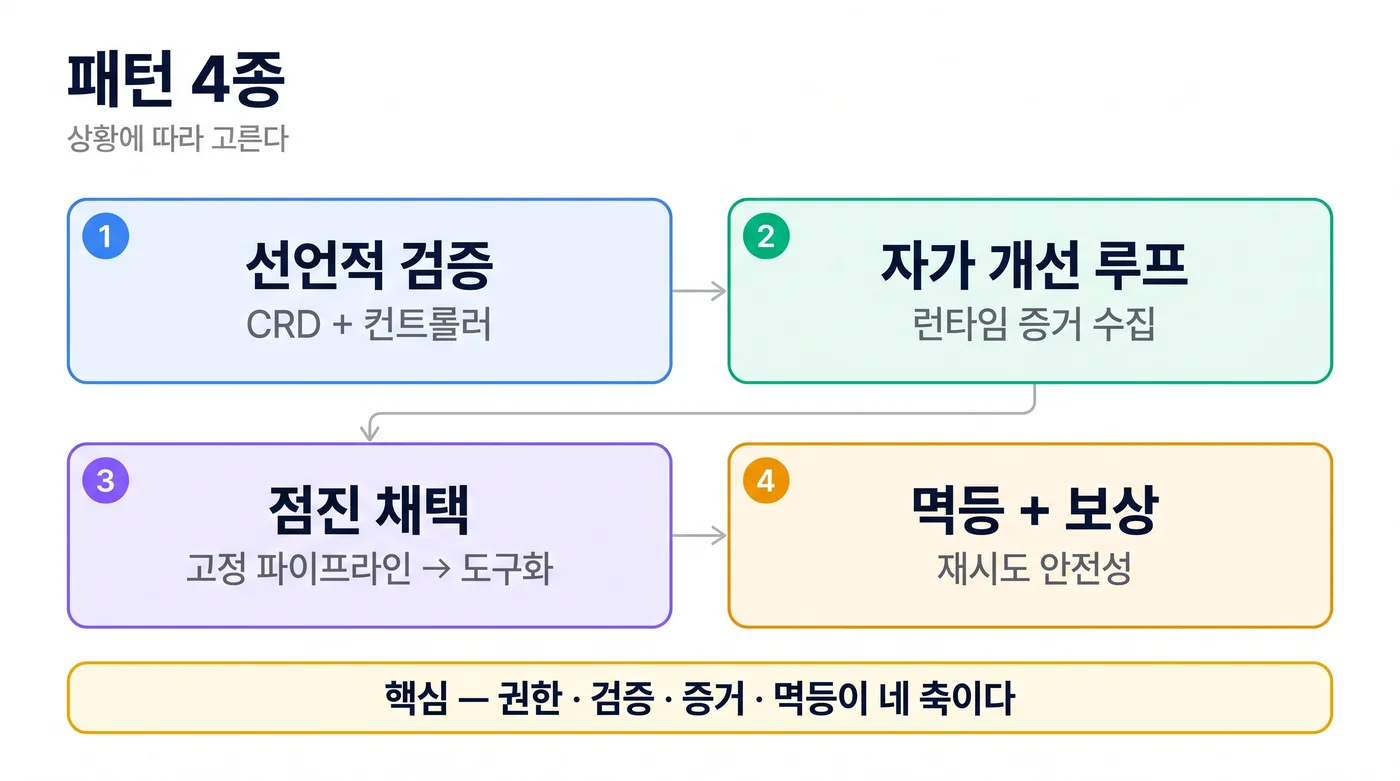
2. 패턴 A: 선언적 의도 + 컨트롤러 검증
2.1 쿠버네티스가 이미 갖고 있던 답
쿠버네티스 생태계는 “의도와 실행의 분리”를 이미 오래전에 해결했다.
사용자/자동화 ──의도──> CRD ──> Controller/Operator ──> 상태
   (원하는 모습)      (선언적)   (검증·재조정)         (실제 리소스)
- CRD(Custom Resource Definition, 사용자 정의 리소스): “이렇게 되어야 한다”는 의도를 저장하는 선언적 객체다.
- Controller/Operator: 그 의도를 검증(validate)하고, 현재 상태와 맞춰 나가며(reconcile), 진행 상황을 상태(status)로 노출한다.
여기서 중요한 성질은 의도를 기록하는 것과 그것을 실행하는 것이 서로 다른 컴포넌트라는 점이다. 에이전트를 이 구조에 끼워 넣으면, 에이전트의 출력은 “명령”이 아니라 “의도 기록”이 된다.
2.2 에이전트용 계약과 컨트롤러용 계약의 분리
페일오버 사례2는 이 분리를 MCP 도구로 구현한다.
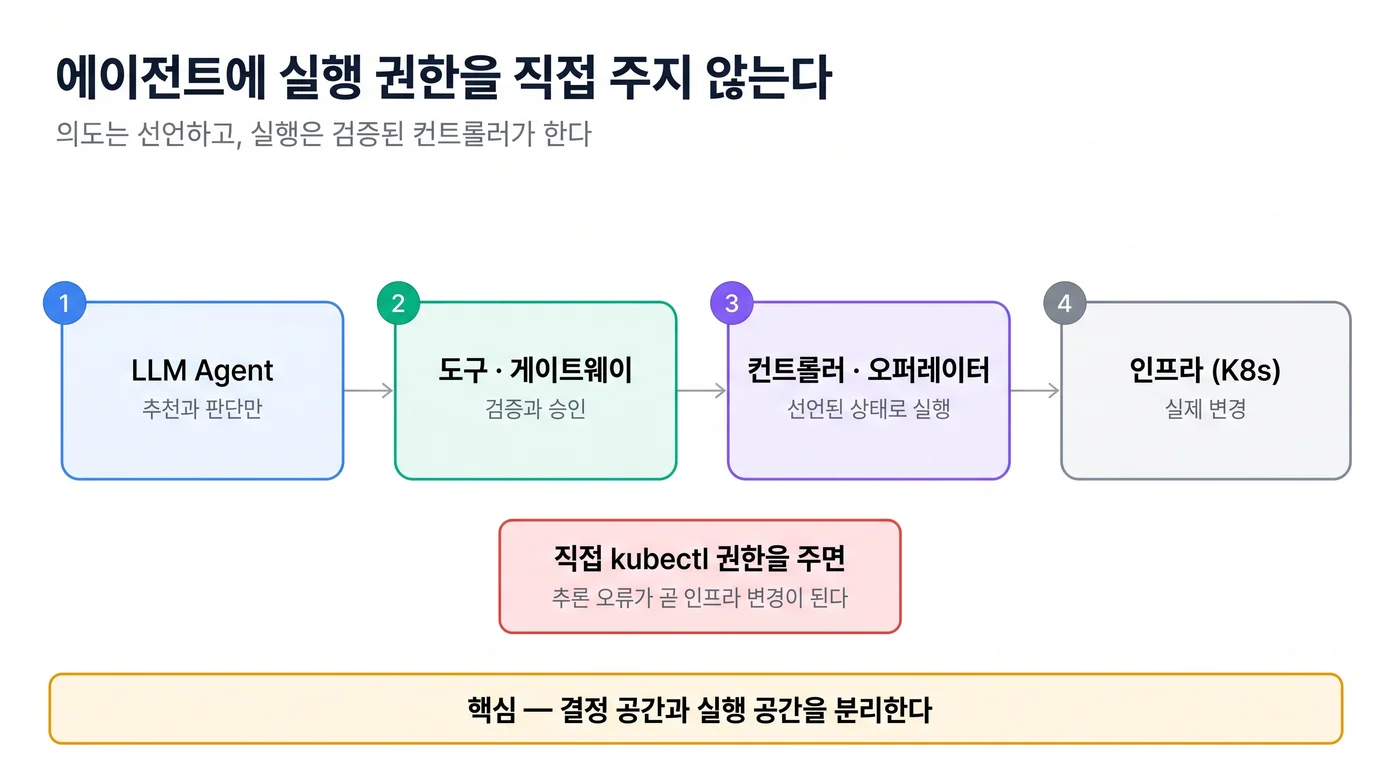
[AI 에이전트]  Observe · Reason · Recommend
      │  (에이전트 대면 계약: 도구 이름 + 타입 지정 파라미터)
      ▼
[Failover MCP Server]
  ├─ get_cluster_health()          ← 관찰
  ├─ get_checkpoint_status()       ← 관찰
  ├─ get_transition_candidates()   ← 관찰
  └─ propose_failover()            ← 통제된 행동: 전환을 "실행"하지 않고 "기록"
      │  (컨트롤러 대면 계약: CRD 스펙/상태)
      ▼
[ClusterPolicy CRD]  phase: AwaitingApproval, recommendedTargetCluster, reason
      │
      ▼
[Transition Operator]  Validate → Reconcile → Execute  (기존 결정적 로직 그대로)
두 계약의 차이가 설계의 핵심이다. propose_failover()는 전환 명령이 아니라 타입이 지정된 추천 기록이다. 파라미터는 clusterPolicy, targetCluster, reason 정도로 좁게 묶이고, 도구는 클러스터 자격 증명을 갖지 않는다. 실제 전환 절차는 손대지 않은 기존 오퍼레이터가 담당한다. 결과적으로 MCP는 “모델의 추천을 경계가 분명한 요청으로 바꾸는” 역할만 하고, “그 요청을 지속 상태로 바꾸는” 일은 CRD가 맡는다.
2.3 세 개의 독립 경계
에이전트가 일으킬 수 있는 일은 서로 독립적인 세 경계에서 좁혀진다. 하나가 뚫려도 나머지가 남는다.
| 경계 | 질문 | 강제 지점 |
|---|---|---|
| 에이전트 허용 목록 | 무엇을 호출할 수 있는가 | 에이전트 설정의 tool allowlist |
| MCP 서버 RBAC | 서버가 무엇을 건드릴 수 있는가 | 쿠버네티스 Role/ClusterRole |
| 오퍼레이터 시맨틱 | 실제로 무엇이 실행될 수 있는가 | 컨트롤러의 검증·정책 |
이 구조에서는 MCP 서버의 RBAC를 “관찰은 넓게, 쓰기는 CRD 하나에만” 같은 식으로 조여 둘 수 있다. 도구 이름과 스키마가 곧 모델이 이해하는 행동 표면이 되므로, “임의 명령 채널”이 아니라 “이름 붙은 운영 역량”만 노출된다.
2.4 사람의 승인을 컨트롤 플레인 상태로 표현하기
승인 게이트도 대화창의 “정말 진행할까요?”로 끝내지 않는다. 승인은 추적 가능한 상태 전이로 모델링한다.
ClusterPolicy phase 전이:
  Recommended → Validated → AwaitingApproval → Approved → Transitioning → Completed

사람의 승인 (예시):
  kubectl patch clusterpolicy clusterpolicy \
    --type=merge --subresource=status \
    -p '{"status":{"phase":"Approved"}}'
phase = AwaitingApproval인 동안 오퍼레이터는 워크로드를 전환하지 않는다. 승인은 컨트롤 플레인 객체의 상태로 남으므로, 누가·언제·무엇을 승인했는지가 감사 로그와 함께 영속된다. 이것이 “대화형 확인”과 “제어 평면 상태”의 차이다.
3. 패턴 B: 런타임 증거 기반 자가 개선 루프
3.1 의도와 도구 호출 사이의 격차
사용자는 “프로덕션 장애를 고쳐줘”라고 말하지만, 모델의 손에 쥐어지는 것은 read_logs(), search_documents(), create_ticket() 같은 낱개의 도구다. 의도와 호출 사이의 이 격차 때문에 경계가 흐려지고, “어떤 API가 호출됐는지, 왜 그 행동을 골랐는지, 프롬프트 문제인지 통합 문제인지”가 사후에 분간되지 않는다3.
3.2 런타임 증거 수집
자가 개선(Self-Improving)은 멋진 루프가 아니라 증거 수집에서 시작한다. 운영 중에 다음을 계속 관찰한다.
- 어떤 도구가 가장 자주 실패하는가 (관찰 실패율)
- 어떤 도구가 비싼가 (토큰·비용·지연)
- 어떤 도구가 사람 개입을 필요로 하는가 (휴먼 리뷰 빈도)
- 어떤 도구들이 함께 쓰이는 경향이 있는가 (동시 사용 패턴)
이 증거가 쌓이면 도구 메타데이터를 런타임에 적응시킬 수 있다.
tool:
  name: deploy_service
insights:
  preferred_model: <모델 식별자>
  often_used_with:
    - read_logs
  human_review_frequency: 82%
  observed_failure_rate: 12%
라우팅·오케스트레이션·의도 승인 같은 계층은 이 통계를 입력으로 받아 “이 도구는 사람 검토를 먼저 붙인다”, “이 두 도구는 함께 노출한다” 같은 결정을 조정한다.
3.3 미들웨어에서의 지속적 적응
개선 지점은 프롬프트가 아니라 미들웨어다. 요청/응답이 오가는 지점에서 샘플링 파라미터(예: temperature, top_p)를 조정하고, 기술적 실행력(도구 호출이 성공했는가)과 사람 만족도(결과가 유용했는가)를 함께 점수화한다. 이 두 축을 분리해서 보는 것이 중요하다. 도구 호출이 “성공”했어도 사용자가 만족하지 못했다면 그것은 통합 문제가 아니라 의도 해석의 문제다.
3.4 정적 추상화의 한계
많은 MCP 설계가 운영체제 프리미티브 수준(파일·프로세스·네트워크)에 머문다. 이런 추상화는 한 번 고정되면 스스로 개선하기 어렵다. 애플리케이션 수준의 프리미티브(배포·티켓·문서)까지 올라와야 “이 도구가 이 맥락에서 자주 실패한다”는 신호를 실제 개선으로 연결할 수 있다. 즉 적응형 설계의 초점은 정적 스키마가 아니라 런타임이다.
4. 패턴 C: 고정 파이프라인을 MCP 도구로 점진 진화
4.1 오운완 커뮤니티에서 시작한 LLMOps 파이프라인
실제 사례는 운동 인증 커뮤니티 “오운완”에서 출발한다. 회원 133명이 약 5개월(2024년 5월~11월) 동안 올린 741개 게시물에 대해, LLM이 개인화된 피드백을 생성하는 LLMOps 시스템을 만들었다. 원래 파이프라인은 네 단계로 고정돼 있었다4.
1 · 데이터 수집  →  2 · 운동 분석  →  3 · 추천 생성  →  4 · 피드백 발행
(커뮤니티 게시물)   (운동 지표/패턴)   (개인화 피드백)    (커뮤니티 게시)
당시 잘 동작한 이유는 명확했다. 단계 경계가 뚜렷했고, 단계별로 독립 배포가 가능했으며, 배치 실행이 예측 가능했다. 워크플로가 안정적으로 유지되는 동안에는 좋은 설계였다.
4.2 고정 그래프가 무너지는 지점
문제는 기능이 늘어날 때 터진다.
- 단계 간 결합: 새 역량은 매번 그래프에 배선해야 하고, 의존성이 기능보다 빠르게 늘어난다.
- 숨은 상태: 단계 출력이 암묵적 계약이 되어, 디버깅은 전체 실행을 가로지르는 추적이 된다.
- 위험한 변경: 한 단계를 바꾸면 전체 워크플로를 다시 검증해야 하고, 실패 하나가 전체 재실행을 강제한다.
4.3 상태를 1급 계약으로
에이전트 + MCP 도구로 재구성하면서 가장 먼저 바뀐 것은 상태의 지위다.
- 하나의 사용자 요청이 여러 도구 호출에 걸치므로, 파이프라인이 맥락을 나르지 않는다.
- 대신
run_id로 키가 잡힌 외부 상태 저장소에 모든 도구가 명시적으로 읽고 쓴다. - 도구는 스키마로 정의된 구조적 결과를 돌려주고, 그 결과가 다음 호출로 직접 흘러간다.
- 도구를 멱등(idempotent)하게 만들어, 에이전트의 재계획·재호출이 안전하게 재시도되도록 한다.
교훈은 한 줄로 요약된다. “상태는 파이프라인 순서의 부산물이 아니라 1급 계약이어야 한다.”
4.4 실패 경계로서의 도구 경계
도구 경계는 곧 실패 경계가 된다. 호출 하나가 실패해도 전체 실행이 죽지 않는다.
- 재시도는 에이전트 프롬프트 안이 아니라 도구 계층의 멱등성 키로 처리한다.
- 부작용이 있는 도구에는 보상 행동(예: 발행 취소, 추천 롤백)을 둔다.
- 부분 결과와 오류 맥락을 에이전트에 돌려주어, 중단 대신 재계획하게 한다.
이때의 사고방식은 명확하다. “에이전트가 이 도구를 두 번 호출할 것이라고 가정하고 설계한다.”
4.5 관측성은 동적 오케스트레이션의 대가
파이프라인 로그는 선형적 이야기를 들려주지만, 에이전트 실행은 요청마다 경로가 달라지므로 그렇지 않다. 그래서 도구 호출마다 인자·결과·지연·토큰·비용을 run_id로 상관시켜 추적해야 하고, 평가의 초점도 “파이프라인이 끝났는가”에서 “에이전트가 올바르게 행동했는가”로 옮겨간다.
한 번의 에이전트 실행 (run_id 기준 추적 예시)
  ├─ ingest_data        0.9s
  ├─ analyze_exercise   2.3s
  ├─ generate_recs      4.1s
  └─ deliver_feedback   1.2s   + 인자·결과·지연, 모델 호출 토큰/비용
정리하면, 에이전트는 복잡성을 제거하지 않고 상태·실패·관측성·보안으로 복잡성을 옮긴다. 동적 오케스트레이션을 택했다면 그 비용을 처음부터 예산에 넣어야 한다.
5. 패턴 D: MCP 서버를 만들기 전에 자문할 질문
5.1 잘못된 동기 다섯 가지
“왜 MCP 서버를 만들면 안 되는가”를 먼저 묻는 편이 낫다.5 2026년의 AI 수요는 최고조이고, 그 압력이 성급한 결정을 만든다.
- FOMO(소외 불안): “에이전트 IDE” 생태계가 매주 새 도구와 약속을 쏟아낸다. 그래서 만든다.
- 생태계 규모에 대한 오해: 중앙 레지스트리에 수천 개의 커뮤니티 MCP 서버가 올라와 있다. 혁신은 대단하지만 품질·보안·신뢰는 들쭉날쭉하다. “남들이 다 있으니”는 근거가 되지 못한다.
- 조직 압박: “모든 사내 API를 AI로 감싸라”는 요구. 이때 모든 API가 LLM 래퍼(wrapper) 후보가 된다.
- 표준화 = 아키텍처 건전성이라는 착각: 공통 인터페이스가 좋은 시스템을 보장하지 않는다.
- 망치 증후군: 모든 문제를 못으로 보는 것. 모든 문제가 AI 문제는 아니고, 모든 API에 에이전트가 필요한 것도 아니다.
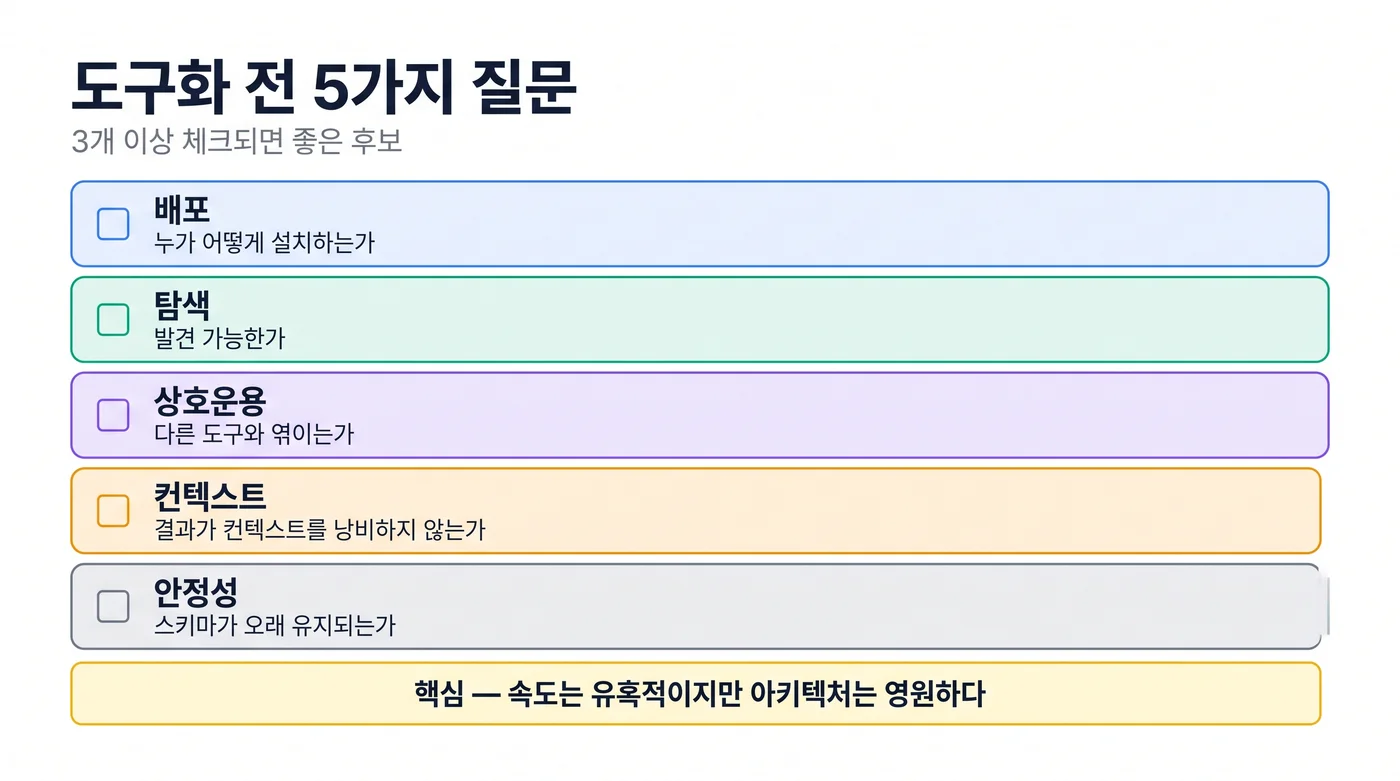
이 지점을 찌르는 문장이 있다. “속도는 유혹적이지만, 아키텍처는 영원하다.” 성과는 AI 도입 자체가 아니라 의도된 설계에서 나온다.
5.2 도구화 대상 결정 기준
무엇을 MCP 도구로 노출할지는 취향이 아니라 기준의 문제다. 멀티클라우드 오픈소스 프로젝트(Cloud-Barista)에 MCP를 채택한 사례6는 운영 경험에서 나온 세 가지 장치를 제시한다.
- 필수 리뷰 게이트: 인프라 생성 전에 가용성·스펙-이미지 적합성·비용을 검토하는 호출(
review_infra_dynamic_request)을 강제한다. 이 게이트 없이 생성하는 것은 거부된다. “시행착오 루프는 API가 이미 알고 있던 것을 배우는 가장 비싼 방법”이기 때문이다. - 다음 단계를 담은 오류: 오류 코드가 다음 행동을 함께 전달한다. 예를 들어
_ERROR_NEXT_STEPS가 “이 구역은 위임되지 않음 → 사용 가능한 도메인 목록을 조회하는 도구를 호출하라”처럼 복구 경로를 알려주면, 에이전트가 스스로 회복한다. - 실패 기억: 이전에 실패한 조합을 다음 시도 전에 알려주고 대안을 제시한다(
get_provisioning_risk).
여기에 더해, “무엇을 도구로 만들 것인가”를 판단하는 실용적 기준은 이렇다.
| 기준 | 도구로 노출하기 좋은 대상 |
|---|---|
| 반복성 | 사람이 매번 같은 절차를 밟는 작업 |
| 검증 가능성 | 결과의 성공/실패를 기계적으로 확인할 수 있는 작업 |
| 경계 명확성 | 입력 스키마를 좁게 고정할 수 있는 작업 |
| 위험도 | 되돌리기 가능하거나 승인 게이트를 붙일 수 있는 작업 |
반대로, 되돌리기 어렵고 입력 경계가 모호한 작업을 서둘러 도구화하면 위험만 키운다.
5.3 안티패턴: God Server와 도구 과부하
가장 흔한 실패는 모든 도구를 하나의 서버에 몰아넣는 God Server(만능 서버)다. 케이스 스터디5는 그 결과를 숫자로 보여준다.
- 도구가 많아질수록 모델의 결정 피로(decision fatigue)가 커져 엉뚱한 도구를 고른다.
- 도구 목록 자체가 세션 시작마다 토큰으로 지불된다.
- 그래서 “하나의 god server”보다 여러 개의 마이크로 서버 + 스마트 탐색이 대체로 낫다.
토큰 경제 관점의 개선도 같은 방향이다6.
적용 전 → 적용 후
  도구 수        88개 → 66개      (거의 같은 도구 12개를 종류+행동 파라미터로 통합)
  응답 크기      1.17MB → 43,812B (서버에서 필터링해 매칭 라인만 반환)
  한 턴 총량     145,000 tok → 21,000 tok
  깊이 제어      detail = minimal | summary | full  (호출자가 필요한 만큼만 지불)
핵심은 기본은 요약, 전체는 요청 시라는 원칙이다. 모델에게 도구 전체 목록(=창고)을 주는 대신, 필요한 것을 집어낼 손전등과 “얼마나 자세히 볼지”를 정하는 다이얼을 준다.
5.4 MCP가 나쁜 API 설계를 대신 고쳐주지 않는다
MCP는 문서화의 대체물이 아니다. 잘못 설계되고 문서화되지 않은 API는 MCP를 씌워도 여전히 나쁘다. 도구 설명(description)은 주석이 아니라 코드이며, 낡은 카탈로그 항목 하나가 에이전트로 하여금 헛된 프로비저닝 시도를 하게 만든다.
- 카탈로그(사용 가능한 스펙·이미지·리전 등)는 지속적으로 재검증한다.
- 서버가 스키마·설명·버전을 관리하고, 낡은 항목을 정리한다.
- “무엇을 제공할 수 있는가”와 “그것이 아직도 유효한가”를 분리해서 다룬다.
5.5 도구 호출 전 5점 체크리스트
도구화 판단 프레임워크는 다음 다섯 항목이다.5
| # | 항목 | 질문 |
|---|---|---|
| 1 | 배포 (Distribution) | 소비자가 2개 이상인가? |
| 2 | 탐색 (Discovery) | 계층적 데이터를 탐색해야 하는가? |
| 3 | 상호운용 (Interop) | 언어·팀을 넘나드는 호출인가? |
| 4 | 컨텍스트 (Context) | 고밀도 정보를 모델에 넘겨야 하는가? |
| 5 | 안정성 (Stability) | API 스키마가 이미 안정됐는가? |
3개 이상 체크되면 MCP가 좋은 적합이다. 1~2개면 신중히 검토하고, 0개면 만들지 않는다. “아니오”가 정답인 경우가 많다는 것이 이 프레임워크의 요점이다.
6. 패턴 선택 매트릭스
6.1 언제 어떤 패턴인가
| 상황 | 1순위 패턴 | 이유 |
|---|---|---|
| 운영 자동화(페일오버·스케일링) | A: 선언적 의도 + 컨트롤러 | 되돌리기 어려운 변경이므로 실행을 검증된 컨트롤 루프에 남긴다 |
| 데이터 파이프라인(수집→분석→발행) | C: 고정 파이프라인 → 도구화 | 단계별 도구로 쪼개면 부분 실패와 재시도가 국소화된다 |
| 사내 도구 노출(조회·티켓·문서) | D: 도구화 판단 + 마이크로 서버 | 소비자·탐색·상호운용 기준을 먼저 통과시킨다 |
| 개인화·라우팅이 중요한 에이전트 | B: 런타임 증거 기반 자가 개선 | 맥락이 자주 바뀌므로 정적 스키마로는 부족하다 |
6.2 조합해 쓰는 법
패턴은 배타적이지 않다. 실제 시스템은 대개 겹쳐 쓴다.
[관찰·추천]        → 패턴 B (증거 수집·적응형 메타데이터)
[위험한 변경]      → 패턴 A (의도 기록 + 컨트롤러 검증 + 승인 게이트)
[반복 워크플로]    → 패턴 C (단계별 도구화 + 멱등성 키)
[노출 대상 결정]   → 패턴 D (체크리스트 + 마이크로 서버)
6.3 공통 설계 원칙: 도구를 제품처럼 다룬다
네 패턴을 관통하는 원칙은 하나다. 도구를 제품(product)처럼 설계한다.
- 명시적 계약: 이름·설명·스키마가 곧 모델이 이해하는 행동 표면이다.
- 멱등성: 두 번 호출해도 안전하게 만든다.
- 텔레메트리: 호출마다 인자·결과·지연·비용을 남긴다.
- 보안은 프롬프트가 아니라 도구 경계에서: 도구마다 최소 권한 자격 증명을 두고, 인자는 신뢰할 수 없는 입력처럼 검증한다.
실무 적용: 사내 MCP 플랫폼 도입 로드맵
한국 엔지니어가 사내 MCP 서버와 에이전트 도구를 운영한다는 전제(Azure/Kubernetes 기반 배포, LLM/RAG 서비스 운영)에서, 위 패턴을 어떻게 도입할지 단계로 정리한다.
상황별 패턴 선택 표
| 대상 업무 | 권장 패턴 | 필수 통제 | 측정 지표 |
|---|---|---|---|
| 장애 대응·페일오버 | A | 승인 게이트, 도구별 최소 RBAC, 감사 로그 | 승인 후 전환 성공률, 사람 개입 빈도 |
| 데이터 파이프라인(수집·정제·발행) | C | 도구 멱등성 키, 보상 행동, run_id 추적 | 도구 경계 재시도 성공률, 부분 실패 복구율 |
| 조회·티켓·문서 검색 | D | 스키마 고정, 리뷰 게이트 없음(읽기 전용) | 도구 선택 정확도, 응답 토큰량 |
| 라우팅·개인화 에이전트 | B | 미들웨어 텔레메트리, 만족도 수집 | 실패율 상위 도구, 휴먼 리뷰 빈도 |
도입 로드맵 3단계
1단계 — 파일럿 (2~4주): 읽기 전용으로 시작한다.
- 기존 시스템을 새로 만들지 말고, 이미 있는 단계를 도구로 감싼다(wrap first).
- 관찰 도구만 노출한다(
get_*,list_*,search_*). 쓰기 도구는 아직 만들지 않는다. - 도구 계약(이름·설명·스키마)을 코드 변경 전에 문서로 먼저 확정한다.
2단계 — 확장 (1~2분기): 쓰기 도구에 통제를 붙인다.
- 파괴적 도구에는 승인 게이트와
confirm플래그를 붙인다. 예:terminate_infra(confirm=True)처럼 명시적 확인이 없으면 거부한다. - 멱등성 키를 도구 계층에 넣는다. 재시도는 프롬프트가 아니라 도구가 처리한다.
- 예산 상한을 서버 설정에 둔다. 모델은 상한을 읽고 협상할 수 있지만 스스로 올릴 수는 없다. 상한 초과 호출은 요청 ID와 함께 거부되고, 사람이 모델이 닿을 수 없는 채널로 승인한다.
- 도구 수를 정리한다. 거의 같은 도구는 종류+행동 파라미터로 합친다(예: 12개 → 4개).
- 응답은 기본 요약,
detail다이얼로 전체를 제공한다.
3단계 — 거버넌스 (지속): 운영 표준으로 굳힌다.
- 제로 트러스트(Zero Trust) 경계: 시크릿은 기본 마스킹, 전송 구간 암호화, 호출 주체 인증(예: 게이트웨이에서 JWT 검증)을 표준으로 삼는다.
- 세션 연속성: 변이 도구는 저널링하고,
idempotency_key를 모든 변이 호출에 붙이고,resume_session으로 약 1KB의 재개 정보를 남긴다. “모델에게 기억을 부탁하지 말고, 대신 기록한다.” - 도구 인벤토리를 주기적으로 감사한다. 살아 있는 도구, 죽은 도구, 낡은 카탈로그를 정리한다.
위험 관리·롤백 설계
- 결정적 폴백 유지: 핵심 흐름은 에이전트가 실패해도 기존 파이프라인으로 떨어질 수 있어야 한다. 에이전트를 없애도 시스템이 돌아가게 설계한다.
- 되돌리기 우선: 부작용 도구마다 보상 행동(발행 취소·롤백)을 함께 만든다.
- 점진적 권한 확대: 읽기 → 검증된 쓰기 → 승인 게이트 쓰기 순으로만 넓힌다. 한 번에 넓히지 않는다.
- 카나리 노출: 새 도구는 소수 워크로드에만 허용 목록으로 열고, 실패율을 본 뒤 확대한다.
측정 지표
| 계층 | 지표 | 목표 감각 |
|---|---|---|
| 도구 | 호출 실패율, 응답 크기, 지연 | 실패율 상위 도구를 매주 리뷰 |
| 에이전트 | 잘못된 도구 선택률, 재계획 횟수 | “성공”이 아니라 “행동”을 평가 |
| 비용 | 턴당 토큰, 세션 시작 토큰 | 도구 목록·응답 크기를 상시 감시 |
| 안전 | 승인 우회 시도, 마스킹 누락 | 0건 유지 |
안티패턴 자가 진단 체크리스트
배포 전에 다음을 확인한다.
- 도구 목록이 세션 시작 시 감당 가능한 토큰인가?
- 거의 같은 도구가 중복 노출되지 않는가?
- 파괴적 도구에 승인·확인 장치가 있는가?
- 변이 도구가 멱등성 키를 쓰는가(에이전트가 두 번 호출해도 안전한가)?
- 시크릿이 응답·로그·트랜스크립트로 새지 않는가?
- 상태가
run_id같은 명시적 키로 외부화됐는가? - 에이전트가 없어도 핵심 흐름이 도는가(결정적 폴백)?
- 도구 스키마가 문서로 먼저 확정됐는가?
References
-
MCP Dev Summit Seoul 2026 (The Linux Foundation / AAIF), 행사 페이지: https://events.linuxfoundation.org/mcp-dev-summit-seoul/ · 전체 스케줄: https://mcpseoul2026.sched.com/ ↩
-
Phuong Bac Ta, Vitumbiko Mafeni (CNLab.ai – IISTRC / Research Center for Distributed Cloud and Networking, SSU), “Who Watches the Watchmen? Safe AI-Agent Failover Via MCP and CRDs”, MCP Dev Summit Seoul 2026 (2026-08-13). 세션: https://mcpseoul2026.sched.com/event/2PYeZ/who-watches-the-watchmen-safe-ai-agent-failover-via-mcp-and-crds-phuong-bac-ta-research-center-for-distributed-cloud-and-networking-ssu-south-korea-vitumbiko-mafeni-cnlab-ssu-iistrc ↩ ↩2
-
Kemal Elmizan (GoTo Company), “Self-Improving MCP Agents”, MCP Dev Summit Seoul 2026 (2026-08-14). 세션: https://mcpseoul2026.sched.com/event/2PYdz/self-improving-mcp-agents-kemal-elmizan-goto-company ↩
-
Ian Y. Choi (AWS, Containers Specialist), Taeyoung Kim (AIFactory, CEO), “Evolving an LLMOps Feedback System Into an MCP-Based Agent Architecture”, MCP Dev Summit Seoul 2026 (2026-08-13). 세션: https://mcpseoul2026.sched.com/event/2PYcy/evolving-an-llmops-feedback-system-into-an-mcp-based-agent-architecture-ian-y-choi-aws-taeyoung-kim-aifactory ↩
-
Daniel Oh (Red Hat), “The 5 Wrong Reasons to Build an MCP Server (And What to Do Instead)”, MCP Dev Summit Seoul 2026 (2026-08-14). 세션: https://mcpseoul2026.sched.com/event/2Rfp5/the-5-wrong-reasons-to-build-an-mcp-server-and-what-to-do-instead-daniel-oh-red-hat ↩ ↩2 ↩3
-
Seokho Son (ETRI, CNCF Ambassador), “Building and Taming an MCP Server for Multi-Cloud Vibe Computing”, MCP Dev Summit Seoul 2026 (2026-08-13). 세션: https://mcpseoul2026.sched.com/event/2PYcm/building-and-taming-an-mcp-server-for-multi-cloud-vibe-computing-seokho-son-etri ↩ ↩2
댓글남기기